
详细讲解在 JavaScript 中利用 replace 与正则表达式清理 HTML 标签、提取纯文本摘要以及格式化手机号、数字、日期的实用方法,深入剖析捕获组与替换函数机制及适用边界。

当前位置:首页 > JavaScript 基础 > 正文
JS利用字符串替换清理HTML标签或格式化数据
作者:小圆点
时间:2026-11-03
浏览:605
文章目录
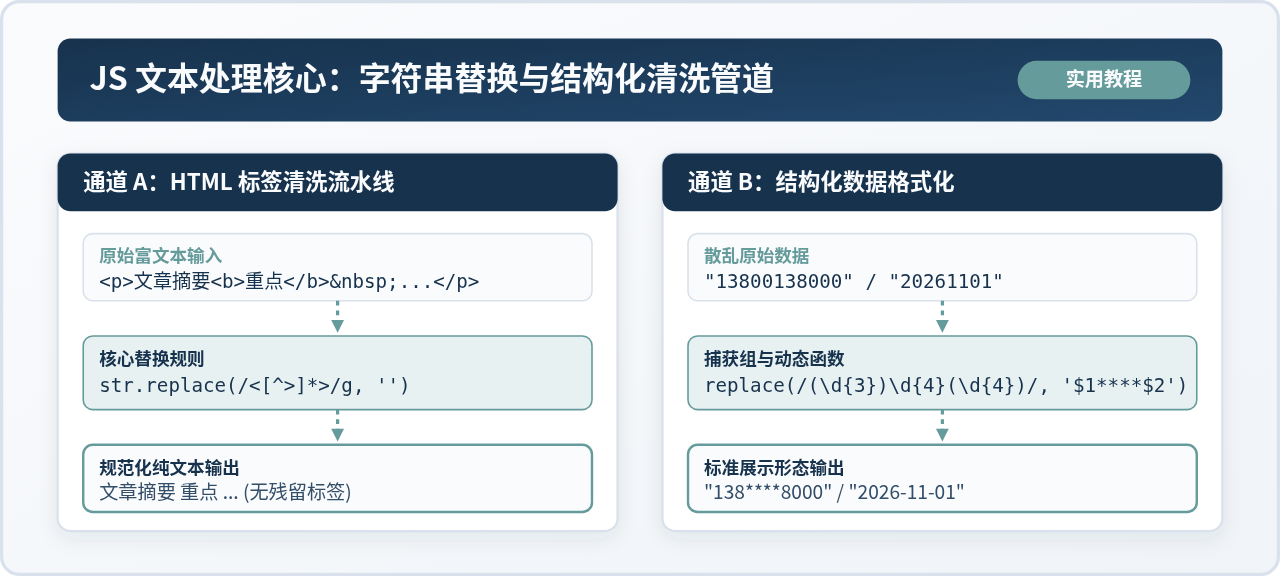
在前端与服务端(如 Node.js)数据交互中,我们经常需要处理包含富文本标签的字符串以提取列表摘要,或者将散乱的手机号、日期、占位符模板转换成统一的标准展示格式。完成这些任务最轻量直接的方案,就是使用 JavaScript 原生的 replace() 或 replaceAll() 方法配合正则表达式。本文将具体介绍清理 HTML 标签的流水线写法、利用捕获组与动态替换函数格式化常见数据,并明确指出纯正则方案的适用边界与安全底线。
一、利用正则替换清理 HTML 标签
在博客摘要生成、消息通知卡片或纯文本导出的开发场景中,接口传来的正文通常包含 <p>、<span>、<strong> 等排版标记。如果直接把这些内容渲染到需要纯文本的地方,标签不仅会破坏界面版式,还会干扰字数统计和搜索分词。
1. 基础剥离与回溯陷阱
初学者尝试清理标签时,往往会随手写出 str.replace(/<.*>/g, '')。这种写法存在严重隐患:.* 是贪婪匹配,它会从字符串中的第一个 < 一路匹配到全文本中最后一个 >,导致首尾标签中间的所有正常内容被一次性吞噬干净。
稳妥且高效的做法是使用字符排除集 <[^>]*>。在这个表达式中,[^>]* 明确限制了匹配内容不能包含大于号,引擎遇到第一个闭合符号就会立即结束当前标签的匹配。相比非贪婪模式 <.*?>,字符排除集在底层能够避免不必要的分支回溯,处理长篇大文本时性能更稳定。
// 错误示范:贪婪匹配导致内容全部丢失
const raw = '<p>核心观点一</p><p>核心观点二</p>';
console.log(raw.replace(/<.*>/g, '')); // 输出:""(整段内容被吞噬)

// 推荐做法:排除型字符集安全剥除
console.log(raw.replace(/<[^>]*>/g, '')); // 输出:"核心观点一核心观点二"
2. 保留换行意图与消除文字粘连
从上面的输出可以看到,单纯把所有标签直接替换为空字符串,会导致原属于不同段落的文字紧紧粘在一起。为了保留文章原本的排版节奏,我们应当先识别具有块级换行含义的标签(例如 </p>、</div>、<br>、</li>),将其预先替换为换行符
,随后再统一剥除剩余标签。
3. 危险与冗余标签整块剔除
如果富文本中夹带了 <script> 脚本或 <style> 样式表,若仅剥离外层尖括号标签,其内部的 JavaScript 代码语句或 CSS 选择器内容依然会变成普通纯文本散落在正文中。因此,在流水线的第一步必须先将这些块级元素连同其内部所有内容整块移除。
4. 实体还原与多余空白规整
剥离标签之后,HTML 字符串里常见的字符实体(如 、&、<、>)仍会保留为实体代码。我们需要建立一个简单的映射表将其转为常规字符,最后压缩连续换行与多余空格,并执行 trim() 去除首尾空白。
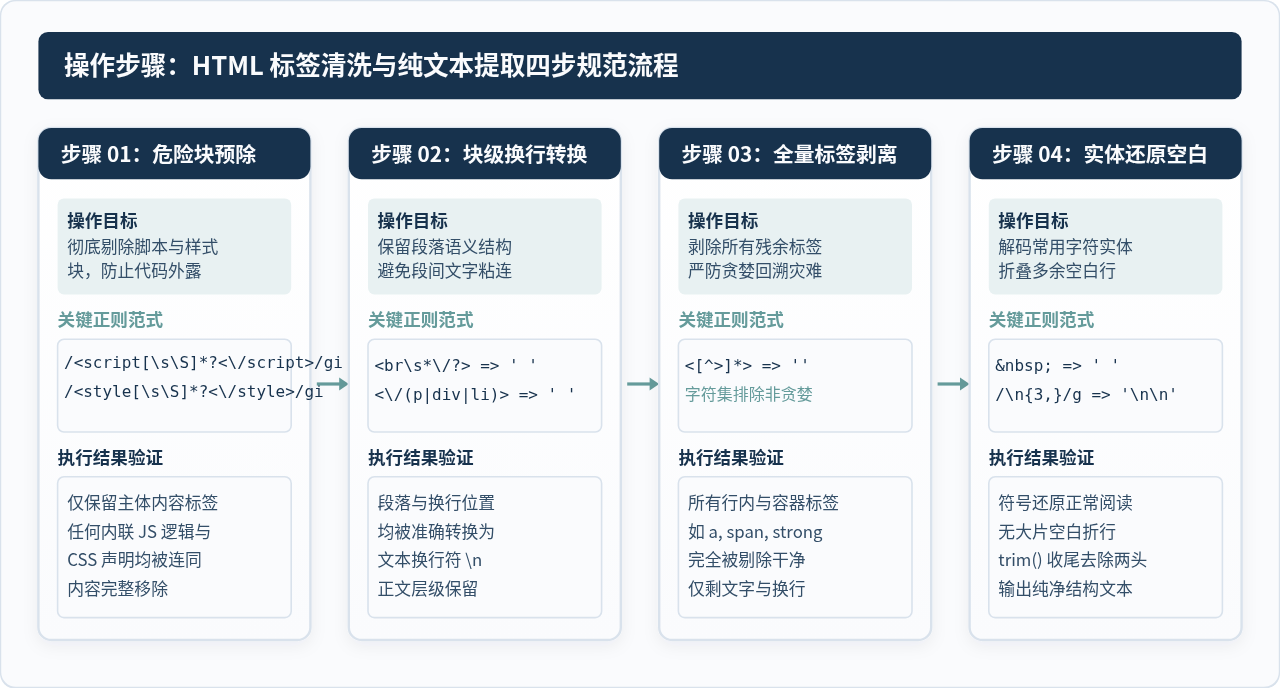
根据上述四个处理阶段,我们可以封装一个可复用的纯文本提取函数:
/**
* 安全剥离 HTML 标签并提取规范纯文本
* @param {string} html 原始富文本字符串
* @returns {string} 规整纯文本
*/
function stripHtmlTags(html) {
if (!html || typeof html !== 'string') return '';
return html
// 步骤 1:整块剔除 script 与 style 及其包含的所有内容
.replace(/<script[\s\S]*?<\/script>/gi, '')
.replace(/<style[\s\S]*?<\/style>/gi, '')
// 步骤 2:将块级结尾标签与换行标签转换为换行符,防止文字粘连
.replace(/<br\s*\/>/gi, '
')
.replace(/<\/(p|div|li|h[1-6]|tr)>/gi, '
')
// 步骤 3:剥离其余所有残留标签
.replace(/<[^>]*>/g, '')
// 步骤 4:还原常见实体并规整空行
.replace(/ /gi, ' ')
.replace(/&/gi, '&')
.replace(/</gi, '<')
.replace(/>/gi, '>')
.replace(/"/gi, '"')
.replace(/'/gi, "'")
// 折叠 3 个及以上的连续空行为双空行,去除行首尾多余空格
.replace(/
{3,}/g, '
')
.trim();
}
// 验证效果
const sampleHtml = `
<style>.hide { display: none; }</style>
<p>欢迎阅读<strong>技术专栏</strong>! 这里是首段。</p>
<p>第二段内容,带有一个<a href="#">链接</a>。<br/>换行测试。</p>
<script>console.log("敏感执行逻辑");</script>
`;
console.log(stripHtmlTags(sampleHtml));
/*
输出结果:
欢迎阅读技术专栏! 这里是首段。
第二段内容,带有一个链接。
换行测试。
*/二、利用字符串替换格式化结构化数据
除清理 HTML 标签外,replace() 在业务数据展现格式化中同样扮演着核心角色。通过正则表达式的捕获组(Capture Groups)和替换函数(Replacer Function),可以优雅地解决脱敏、排版、数字分割及轻量模板渲染问题。
1. 正则捕获组与静态编号替换
在正则表达式中使用圆括号 () 可以建立捕获组。当替换目标是固定模式时,可以在第二个参数中使用 $1、$2 引用这些被捕获的分组,从而高效重组文本结构。
// 场景 1:手机号中间 4 位脱敏
function maskPhone(phone) {
  return String(phone).replace(/(\d{3})\d{4}(\d{4})/, '$1****$2');
}
console.log(maskPhone('13800138000')); // 输出:"138****8000"

// 场景 2:标准日期格式统一重排
function formatIsoDate(dateStr) {
  // 将 "20261101" 转换为 "2026-11-01"
  return String(dateStr).replace(/^(\d{4})(\d{2})(\d{2})$/, '$1-$2-$3');
}
console.log(formatIsoDate('20261101')); // 输出:"2026-11-01"
2. 前瞻断言:数字金额千分位格式化
对于长数字或金额字符串,业务上经常要求每隔三位添加一个逗号(例如 1,000,000)。利用正则的正向前瞻断言 (?=...) 和非单词边界 \B,一行代码即可实现千分位转换,且不会在最前面误加逗号。
function formatThousands(num) {
  const parts = String(num).split('.');
  // 针对整数部分进行千分位正则匹配
  parts[0] = parts[0].replace(/\B(?=(\d{3})+(?!\d))/g, ',');
  return parts.join('.');
}

console.log(formatThousands(12345678.95)); // 输出:"12,345,678.95"
3. 动态替换函数(Replacer Function)的妙用
当替换逻辑需要条件判断、数据查表或动态计算时,静态的 $1 字符串就无法满足需求了。此时,可以将一个回调函数作为 replace() 的第二个参数。引擎在每次匹配命中时都会调用该函数,并传入匹配文本、各个捕获组、匹配偏移量及原字符串。
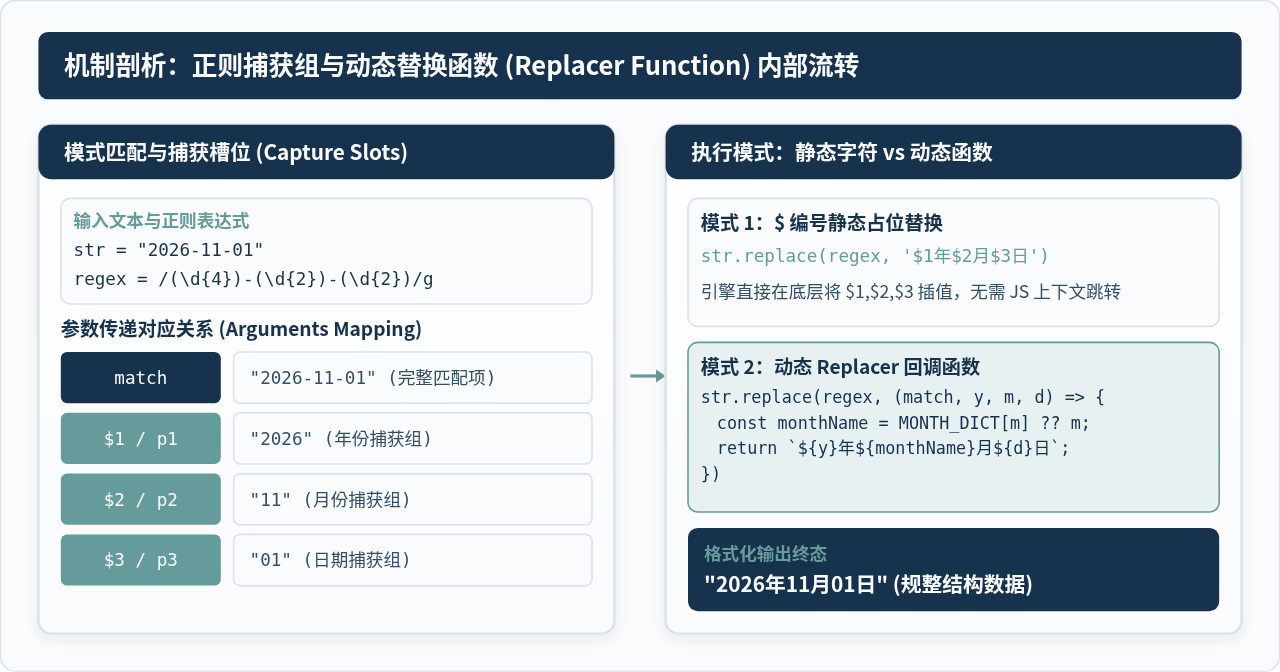
下面是一个使用动态替换函数实现的轻量占位符模板引擎:
/**
 * 模板数据插值格式化
 * @param {string} template 包含 {key} 的模板字符串
 * @param {Record<string, any>} data 替换数据源
 * @returns {string} 格式化结果
 */
function interpolate(template, data) {
  return template.replace(/\{(\w+)\}/g, (match, key) => {
    // 如果数据对象中存在该键,则返回对应值;否则保留空或原占位符
    if (key in data) {
      return data[key] ?? '';
    }
    return match; // 未提供对应变量时保持现状
  });
}

const tpl = "尊敬的{username},您于{date}提交的工单状态已更新为:{status}。";
const payload = {
  username: "李工程师",
  date: "2026-11-01",
  status: "处理中"
};

console.log(interpolate(tpl, payload));
// 输出:"尊敬的李工程师,您于2026-11-01提交的工单状态已更新为:处理中。"
三、技术选型与适用边界:为什么不能用正则做 XSS 防护
在实际工程中,开发者必须严格厘清“数据清洗展示”与“网络安全防御”的边界。使用正则替换清理 HTML 标签非常适合生成列表纯文本摘要、提取搜索引擎分词或截断字数,但绝对不能依赖正则表达式来对用户输入的富文本进行 XSS 防御。
安全警示:HTML 是一门非上下文无关语法(Context-Free Grammar),支持复杂的属性嵌套、残缺标签自动容错、十六进制与十进制实体编码、以及各种内联事件属性(如
<img src=x onerror=...>、<svg onload=...>)。任何基于静态正则表达式的标签黑白名单过滤,都很容易被畸形构造的恶意代码绕过。
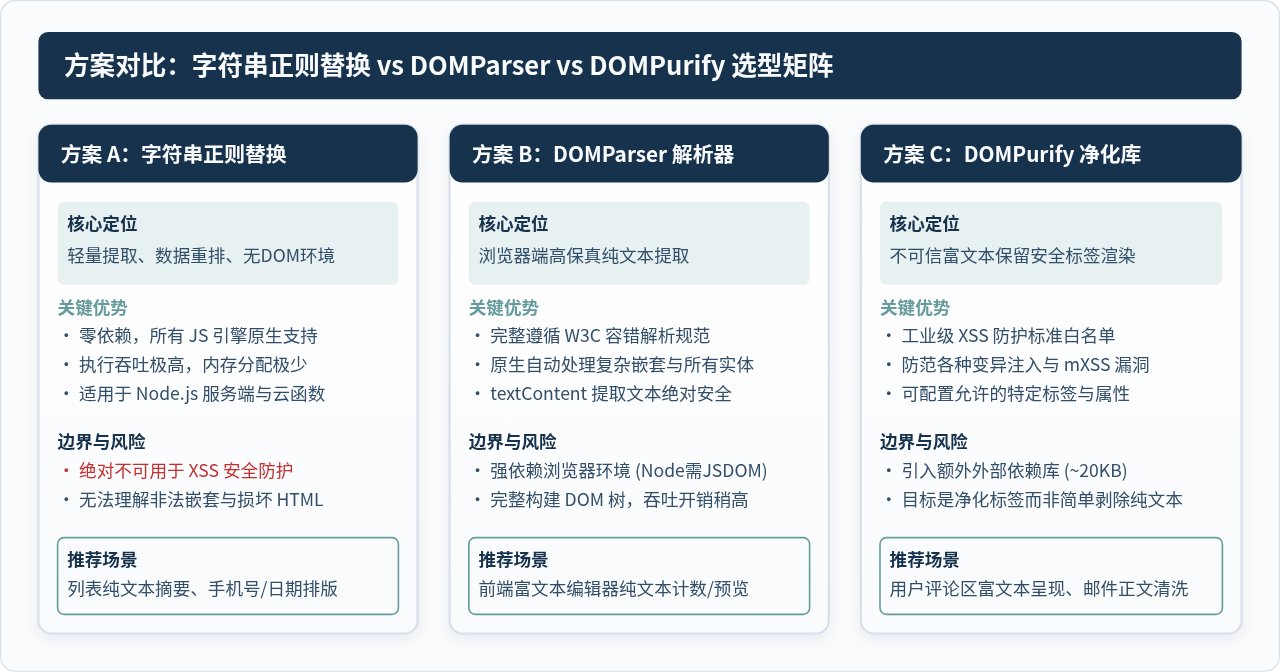
| 方案类型 | 核心原理 | 运行环境要求 | 适用典型场景 | 主要局限 |
|---|---|---|---|---|
| 字符串正则替换 | 基于正则模式扫描并执行线性字符串剔除/重排 | 所有环境 (Node.js/浏览器/Worker) 零依赖 | 列表纯文本摘要、字数统计、手机号/日期排版 | 无法防御 XSS,遇到畸形未闭合标签易误伤 |
| DOMParser 原生解析 | 借助浏览器原生排版引擎构建 DOM 树后提取 textContent | 浏览器环境或 Node.js (需 JSDOM 支持) | 富文本编辑器字数统计、文章本地精确纯文本转化 | 构建整棵 DOM 树开销略大,无法直接在无 DOM 环境运行 |
| DOMPurify 工业级净化 | 白名单驱动的 AST 遍历与不可信属性/协议深度剥除 | 浏览器原生或 Node.js 环境引入 NPM 包 | 允许用户发布富文本并需安全渲染为 HTML 的场景 | 需引入外部第三方依赖(约 20KB 打包体积) |
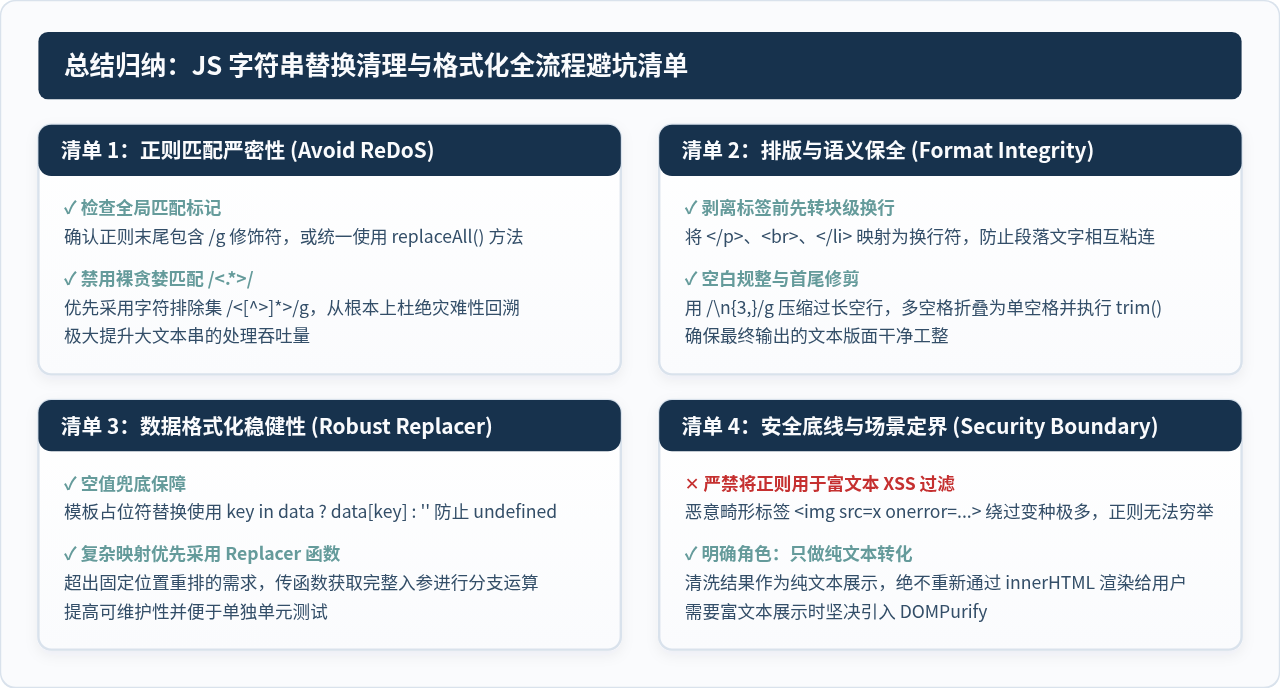
四、避坑指南与全流程总结
为了让字符串替换代码在生产环境中长期稳定运行,建议在开发与 Code Review 中对照以下检查要点:
- 必须检查全局标志
/g:在 JavaScript 中,str.replace(/pattern/, 'newVal')默认只会替换首个匹配项。若要全局替换,必须添加/g标志,或者在现代运行时环境中使用str.replaceAll('target', 'newVal')。 - 杜绝裸贪婪匹配与 ReDoS 隐患:在处理标签剥离时,坚决避免使用
<.*>。在处理大文件富文本时,优先选用字符排除集<[^>]*>,避免引擎因深层嵌套产生巨量回溯消耗 CPU 资源。 - 做好换行与空白的过渡:直接剥离标签会导致多段内容融合为一个长词。务必按照“先转块级为换行、再除全部标签、最后折叠空白与 trim”的顺序操作。
- 动态替换函数的容错防御:在替换函数中读取字典对象时,务必使用可选链
?.或空值合并运算符??提供默认值,防止由于数据源缺失字段导致正文中出现大面积undefined。 - 明确职责,安全入库:正则处理后的字符串只能作为纯文本进行展示(例如通过
textContent赋值);若后续仍需通过innerHTML插入网页,则必须走专业的 DOMPurify 净化流水线。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章