
深入解析JavaScript中String.prototype.replace()的实战应用,聚焦手机号3-4-4分段格式化、动态输入光标恢复、隐私脱敏,以及去除HTML标签的高效正则与DOM解析方案。

当前位置:首页 > JavaScript 基础 > 正文
JS正则替换实战:格式化手机号与去除HTML标签
作者:性能诊所
时间:2026-11-03
浏览:467
文章目录
在 JavaScript 前端交互与数据清洗工作中,字符串的模式匹配与替换是不可或缺的基本功。其中,“手机号码按 3-4-4 分段排版及脱敏”与“富文本中剔除 HTML 标签提取纯文本”是两类高频出现的经典场景。本文紧扣核心 API
String.prototype.replace(),通过拆解捕获组反向引用、前瞻断言以及排除字符集,深入剖析输入框光标补偿机制与 XSS 防护边界,给出可直接复用至生产环境的代码实现。
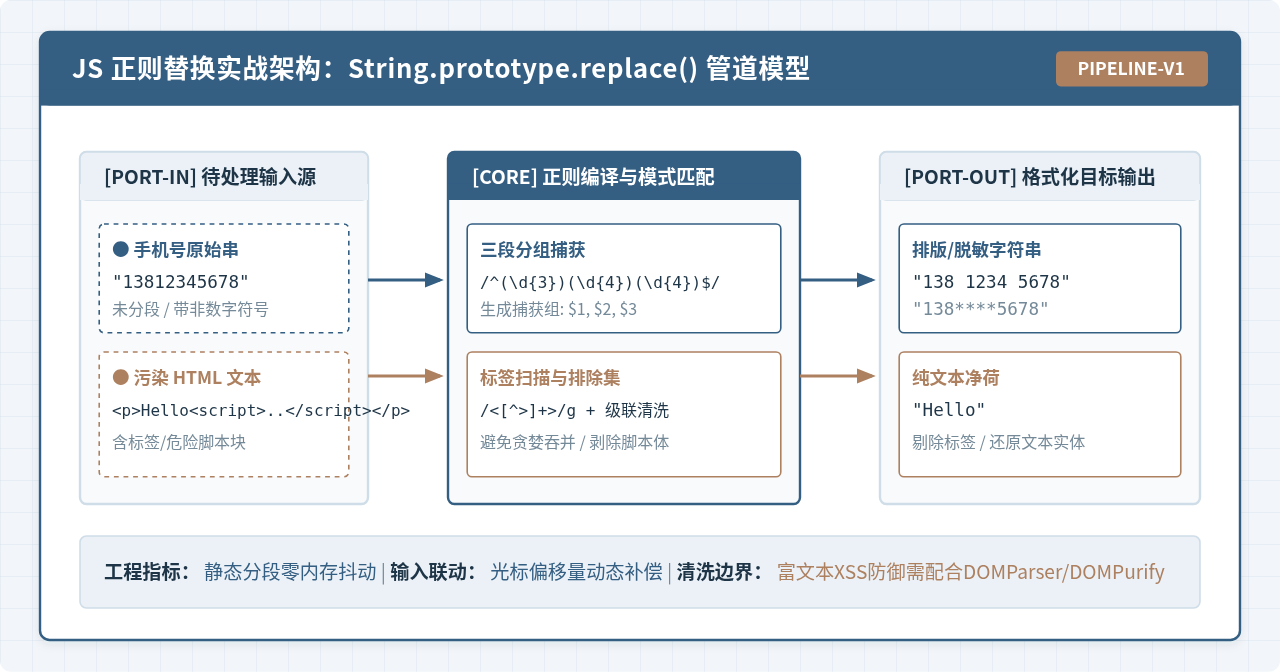
一、String.prototype.replace() 核心机制
JavaScript 提供了 str.replace(regexp|substr, newSubstr|replacer) 方法。当第一个参数是正则表达式时,其替换能力远超普通的子串替换。
理解正则替换的关键在于两个特性:全局匹配标志 /g 与特殊替换变量。若未添加全局修饰符 /g,replace() 仅对首个匹配项执行替换并立刻返回;若添加了 /g,则引擎会在整段字符串中持续推进匹配位置。
在第二个参数提供替换模板字符串时,可以使用以 $ 开头的特殊转义符号:
$1, $2, ... $99:对应正则表达式中从左至右由圆括号()声明的捕获组所捕获的文本。$&:匹配到的完整子串。$`与$':分别表示匹配项左侧及右侧的剩余子串。$$:插入一个纯文本字符$。
若需要更复杂的条件逻辑,第二个参数还可传入回调函数 replacer(match, p1, p2, offset, string),在每次匹配时动态计算返回值。
二、实战一:手机号码格式化与脱敏处理
国内手机号码由 11 位数字组成。未格式化的连续纯数字(例如 13812345678)在人眼扫读时容易造成认知疲劳。常见的视觉优化策略为“3-4-4”结构(即 138 1234 5678 或 138-1234-5678),而在隐私保护要求下,则需掩码隐藏中间四位(138****5678)。
1. 静态手机号的 3-4-4 分段格式化
对于已经校验通过的完整 11 位号码,可以通过声明三个捕获组,一次性将其重构为目标模板。
// 静态完整号码 3-4-4 格式化示例
function formatPhoneNumber(phone, separator = ' ') {
  if (typeof phone !== 'string') phone = String(phone);
  // 清洗非数字干扰字符
  const cleaned = phone.replace(/\D/g, '');
  if (cleaned.length !== 11) {
    return phone; // 长度不符直接原样返回,避免误格式化
  }
  return cleaned.replace(/^(\d{3})(\d{4})(\d{4})$/, `$1${separator}$2${separator}$3`);
}

// 运行测试示例
console.log(formatPhoneNumber('13812345678'));       // 输出: "138 1234 5678"
console.log(formatPhoneNumber('13987654321', '-'));  // 输出: "139-8765-4321"
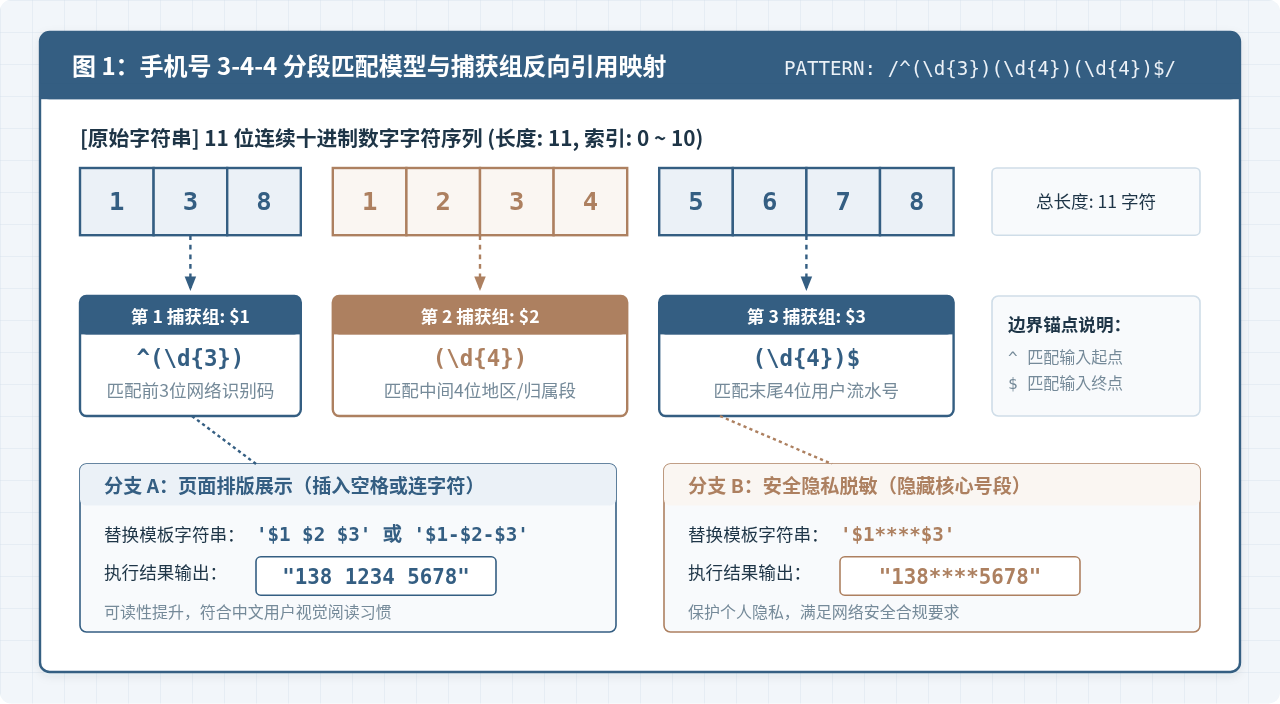
如图 1 所示,正则表达式 /^(\d3)(\d4)(\d4)$/ 采用了边界符 ^ 与 $ 进行严格封顶,保证整个字符串恰好由 11 位数字组成。各捕获组按顺序分别被映射为 $1、$2 和 $3。
2. 用户输入过程中的动态自适应格式化
在表单输入框中,用户是逐位键入数字的。如果仅依赖上述全匹配正则,当数字不足 11 位时页面不会发生任何改变。我们需要在用户键入 4 位时排版为 138 1,键入 8 位时排版为 138 1234 5。
此时可以采用正向前瞻断言(Positive Lookahead) (?=\d):
// 动态输入过程中的自适应格式化
function formatInputPhone(rawVal) {
  // 1. 过滤所有非数字字符并限制最大长度为 11
  const digits = rawVal.replace(/\D/g, '').slice(0, 11);
  // 2. 匹配开头的 3 位或后续的 4 位,且其后方仍紧跟至少一个数字
  return digits.replace(/(^\d{3}|\d{4})(?=\d)/g, '$1 ');
}

// 模拟动态键入效果
console.log(formatInputPhone('138'));          // 输出: "138"
console.log(formatInputPhone('1381'));         // 输出: "138 1"
console.log(formatInputPhone('1381234'));      // 输出: "138 1234"
console.log(formatInputPhone('13812345'));     // 输出: "138 1234 5"
console.log(formatInputPhone('13812345678'));  // 输出: "138 1234 5678"
3. 输入框光标跳动问题与光标位置还原
直接在 <input> 的 input 事件中对 el.value 进行格式化赋值会触发浏览器的一个原生副作用:光标会自动跳到文本最末端。这使得用户在回删或修改中间某位数字时体验极差。
解决此问题的核心算法是:在格式化执行前,先统计“当前光标左侧一共有多少个纯数字”;在完成字符串格式化并重新赋值给输入框后,再遍历格式化后的新字符串,找到第 N 个纯数字所在的新物理索引,并通过 setSelectionRange() 将光标精准复位。
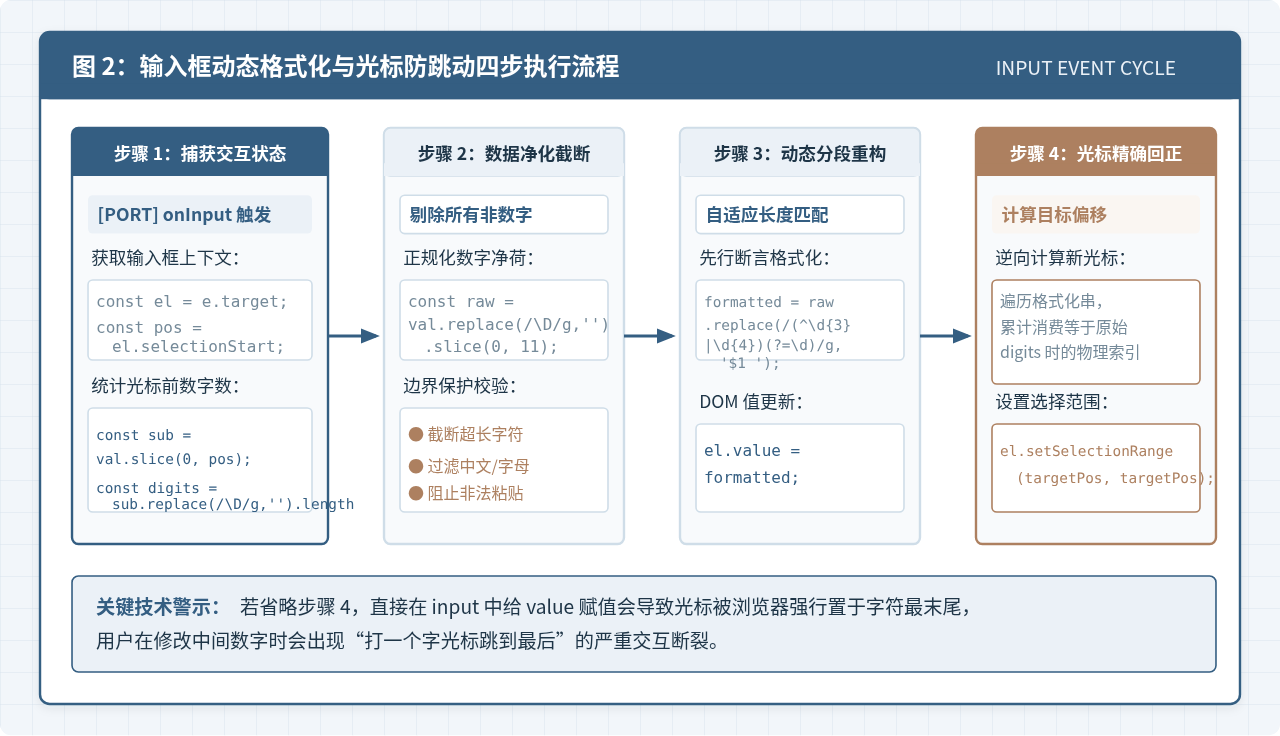
以下为原生 DOM 环境下的完整事件挂载实现:
/**
 * 为手机号输入框绑定自适应格式化与光标保持监听
 * @param {HTMLInputElement} inputEl
 */
function bindPhoneInputWithCursor(inputEl) {
  inputEl.addEventListener('input', (event) => {
    const el = event.target;
    const originalValue = el.value;
    const originalCursor = el.selectionStart;

    // 统计光标前包含的有效纯数字个数
    const digitsBeforeCursor = originalValue
      .slice(0, originalCursor)
      .replace(/\D/g, '').length;

    // 清洗并格式化
    const rawDigits = originalValue.replace(/\D/g, '').slice(0, 11);
    const formatted = rawDigits.replace(/(^\d{3}|\d{4})(?=\d)/g, '$1 ');

    // 重新写回输入框
    el.value = formatted;

    // 逆向计算光标应该定位的新字符索引
    let newCursorPos = 0;
    let digitCount = 0;
    for (let i = 0; i < formatted.length; i++) {
      if (/\d/.test(formatted[i])) {
        digitCount++;
      }
      if (digitCount === digitsBeforeCursor) {
        newCursorPos = i + 1;
        break;
      }
    }

    // 若删除了数字导致剩余总数小于此前计数,光标设在末尾
    if (digitCount < digitsBeforeCursor) {
      newCursorPos = formatted.length;
    }

    // 恢复光标位置
    el.setSelectionRange(newCursorPos, newCursorPos);
  });
}
4. 手机号码隐私脱敏处理
在个人信息保护规范中,展示用户手机号时通常需对中间 4 位进行掩码遮蔽。利用正则替换的语法,我们可以不将中间 4 位放入捕获组,直接替换为 ****:
// 手机号掩码脱敏
function maskPhoneNumber(phone) {
  if (typeof phone !== 'string') phone = String(phone);
  const cleaned = phone.replace(/\D/g, '');
  if (cleaned.length !== 11) {
    return phone; // 长度异常则原样回退,不做盲目裁剪
  }
  // 第1组取前3位,中间4位直接匹配不捕获,第2组取后4位
  return cleaned.replace(/^(\d{3})\d{4}(\d{4})$/, '$1****$2');
}

console.log(maskPhoneNumber('13812345678')); // 输出: "138****5678"
三、实战二:去除字符串中的 HTML 标签
在处理富文本编辑器产生的内容、抓取网页摘要或生成卡片描述时,常常需要剔除其中的 HTML 标签,仅保留纯文字内容。
1. 基础场景:朴素排除集正则
初学者常见的错误是使用贪婪匹配 /<.*>/g。贪婪量词 .* 会一直吞噬字符,直到字符串中最后一个 >,导致首尾两个标签之间的所有正文全部被清空。
正确的朴素写法是采用排除型字符集 <[^>]+>:
// 基础去除 HTML 标签函数
function stripHtmlSimple(html) {
  if (typeof html !== 'string') return '';
  // 匹配以 < 开头,紧随一至多个非 > 字符,并以 > 结尾的子串
  return html.replace(/<[^>]+>/g, '').trim();
}

const sampleHtml = '<div class="content"><p>学习 <strong>JavaScript</strong> 正则替换!</p></div>';
console.log(stripHtmlSimple(sampleHtml));
// 输出: "学习 JavaScript 正则替换!"
⚠️ 朴素正则的隐藏缺陷
<[^>]+> 仅能删除标签本身的“外壳”。如果富文本中包含 <script> 或 <style>,标签外壳虽然被移除了,但里面的脚本代码和样式表规则会作为纯文本裸露在页面上,造成视觉与数据污染。
2. 进阶场景:完整剥除脚本与样式内容块
为解决上述问题,必须采用两步级联清洗:先连同标签体整块剥除 <script> 与 <style>,再去除剩余的普通标签,并顺带完成常用 HTML 实体字符的解码。
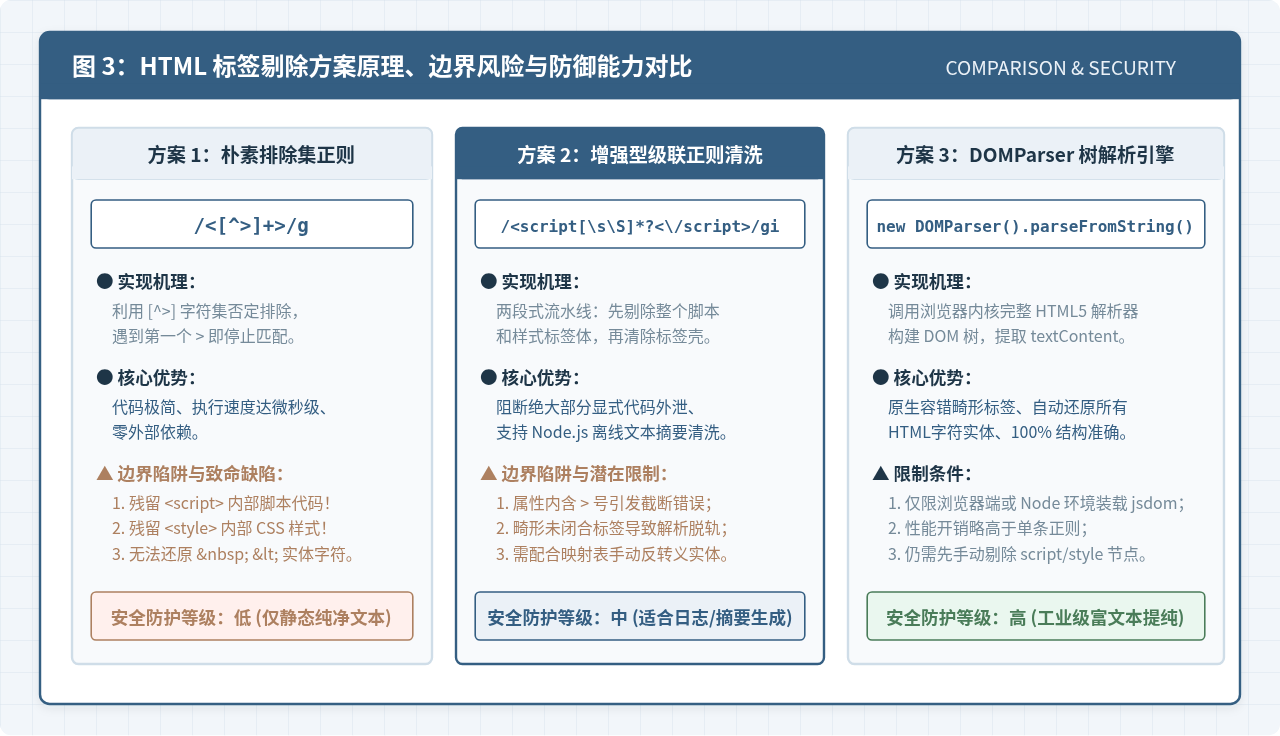
// 增强型 HTML 清洗:支持剥离脚本块、样式块与实体反转义
function stripHtmlAdvanced(html) {
if (typeof html !== 'string') return '';
return html
// 1. 完整移除 <script>...</script> 块及内容
.replace(/<script\b[^<]*(?:(?!<\/script>)<[^<]*)*<\/script>/gi, '')
// 2. 完整移除 <style>...</style> 块及内容
.replace(/<style\b[^<]*(?:(?!<\/style>)<[^<]*)*<\/style>/gi, '')
// 3. 移除普通 HTML 标签壳
.replace(/<[^>]+>/g, '')
// 4. 转换常见 HTML 实体字符
.replace(/ /gi, ' ')
.replace(/</gi, '<')
.replace(/>/gi, '>')
.replace(/&/gi, '&')
.replace(/"/gi, '"')
.replace(/'/gi, "'")
// 5. 将连续空白字符规范为单个空格
.replace(/\s+/g, ' ')
.trim();
}
// 运行测试
const richText = `
<div>
<style>body { color: red; }</style>
<h2>重要公告 >></h2>
<p>请各位开发者注意防护。</p>
<script>window.trackUser();</script>
</div>
`;
console.log(stripHtmlAdvanced(richText));
// 输出: "重要公告 >> 请各位开发者注意防护。"
3. 安全红线与生产级标准
在计算机科学界,有一个被反复证实的共识:不要试图用正则表达式完整解析任意 HTML。因为 HTML 不是正则语言(Regular Language),它包含递归嵌套标签、未闭合容错、属性值内含特殊符号(例如 <input value=">">)等极其复杂的状态机。
在实际生产环境中,请根据具体使用场景划分职责:
- 轻量级静态展示(如在搜索列表、卡片预览中截取纯文本简介):使用上述
stripHtmlAdvanced()即可,速度极快且无环境依赖。 - 浏览器端安全富文本提纯:推荐使用浏览器原生的
DOMParser:// 浏览器环境下基于 DOM 树的安全文本提取 function extractTextByDOM(html) { if (typeof html !== 'string') return ''; const parser = new DOMParser(); const doc = parser.parseFromString(html, 'text/html'); // 移除所有 script 和 style 元素 const scriptsAndStyles = doc.querySelectorAll('script, style'); scriptsAndStyles.forEach(node => node.remove()); // 原生 textContent 会自动递归提取所有文本节点并还原全部实体字符 return (doc.body.textContent || '').replace(/\s+/g, ' ').trim(); } - 防御 XSS 跨站脚本攻击:如果清洗后的内容仍需以 HTML 形式在页面上渲染(例如渲染富文本详情),绝不能只用正则剔除几个标签,必须引入经受过严苛安全考验的开源消毒库,如前端的
DOMPurify或服务端的sanitize-html。
四、生产决策指南与综合对比
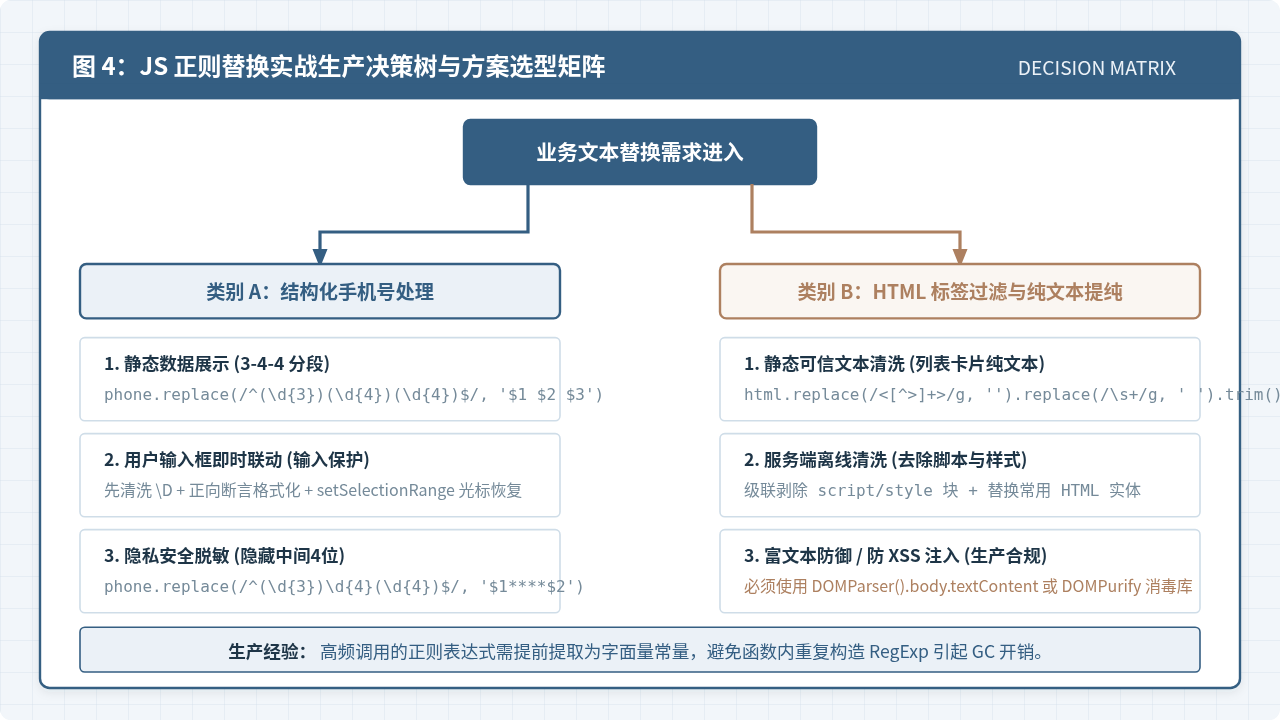
在选型与编写正则替换逻辑时,可参考下表的维度对比与评估:
| 业务场景 | 推荐方案 | 适用环境 | 主要优势与注意要点 |
|---|---|---|---|
| 手机号展示排版 | cleaned.replace(/^(\d3)(\d4)(\d4)$/, '$1 $2 $3') |
全环境 (Node/Web) | 执行耗时 < 0.01ms;需提前校验 length === 11,避免截断或失效。 |
| 输入框即时联动 | 清洗 \D + 前瞻断言 + setSelectionRange |
浏览器 DOM | 解决了用户在输入框中间修改数字时光标跳到末尾的严重交互瑕疵。 |
| 手机号脱敏遮蔽 | phone.replace(/^(\d3)\d4(\d4)$/, '$1****$2') |
全环境 (Node/Web) | 仅捕获两端,中间直接写入掩码;异常号码原样返回以保证健壮性。 |
| 离线纯文本摘要 | 级联正则(去除 script/style + 排除集标签) |
全环境 (Node/Web) | 零外部依赖,极低内存消耗;适合对安全性无绝对要求的离线索引生成。 |
| 高可靠富文本提纯 | DOMParser + 节点剥除 + textContent |
浏览器 / jsdom | 自动修复残缺标签并解码所有 HTML 实体;生产级稳定性最高。 |
💡 性能优化建议
在循环或高频触发的事件(如 input、scroll)中,避免在函数体内通过 new RegExp() 动态创建正则表达式对象。应将正则表达式声明为模块顶层的常量(如 const PHONE_REG = /^(\d3)(\d4)(\d4)$/;),以便 JavaScript 引擎在启动编译阶段完成模式分析与内部优化,避免垃圾回收(GC)频繁抖动。
五、开箱即用工具函数封装
最后,我们将上述方案提炼整理为一组无第三方依赖的纯 JavaScript 工具函数库,可直接引入项目中作为工具模块(Utils)使用:
/**
* 文本处理与正则替换实用工具集
*/
export const StringFormatUtils = {
/**
* 格式化手机号码 (3-4-4 分段)
*/
formatPhone(phone, separator = ' ') {
if (!phone) return '';
const cleaned = String(phone).replace(/\D/g, '');
if (cleaned.length !== 11) return String(phone);
return cleaned.replace(/^(\d{3})(\d{4})(\d{4})$/, `$1${separator}$2${separator}$3`);
},
/**
* 手机号码掩码脱敏 (保留前后,中间4位为 ****)
*/
maskPhone(phone) {
if (!phone) return '';
const cleaned = String(phone).replace(/\D/g, '');
if (cleaned.length !== 11) return String(phone);
return cleaned.replace(/^(\d{3})\d{4}(\d{4})$/, '$1****$2');
},
/**
* 去除字符串中的 HTML 标签并保留纯文本
*/
stripHtml(html, { decodeEntities = true } = {}) {
if (!html || typeof html !== 'string') return '';
let result = html
.replace(/<script\b[^<]*(?:(?!<\/script>)<[^<]*)*<\/script>/gi, '')
.replace(/<style\b[^<]*(?:(?!<\/style>)<[^<]*)*<\/style>/gi, '')
.replace(/<[^>]+>/g, '');
if (decodeEntities) {
result = result
.replace(/ /gi, ' ')
.replace(/</gi, '<')
.replace(/>/gi, '>')
.replace(/&/gi, '&')
.replace(/"/gi, '"')
.replace(/'/gi, "'");
}
return result.replace(/\s+/g, ' ').trim();
}
};
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章