
深入讲解JavaScript中使用递归遍历嵌套JSON对象与DOM树结构的通用原理与落地实现,包含完整代码示例、执行步骤、关键差异对比及避免栈溢出和循环引用的防御实践。

当前位置:首页 > JavaScript 基础 > 正文
JS递归怎么遍历嵌套JSON对象或DOM树结构
作者:交互手记
时间:2026-11-02
浏览:253
文章目录
JavaScript 遍历树形结构(无论是多层嵌套的 JSON 对象还是浏览器的 DOM 树)的核心机制,都是利用函数的自调用——即通过“基线条件(终止条件)”防止无限循环,并在每一层根据节点类型把子元素分解为规模更小的同类问题逐层下钻。本文将拆解递归遍历的核心通用模型,并通过 JSON 对象与 DOM 树两个典型场景,展示可直接复用的完整实现代码、关键差异对比以及避免调用栈溢出或循环引用的防坑要点。
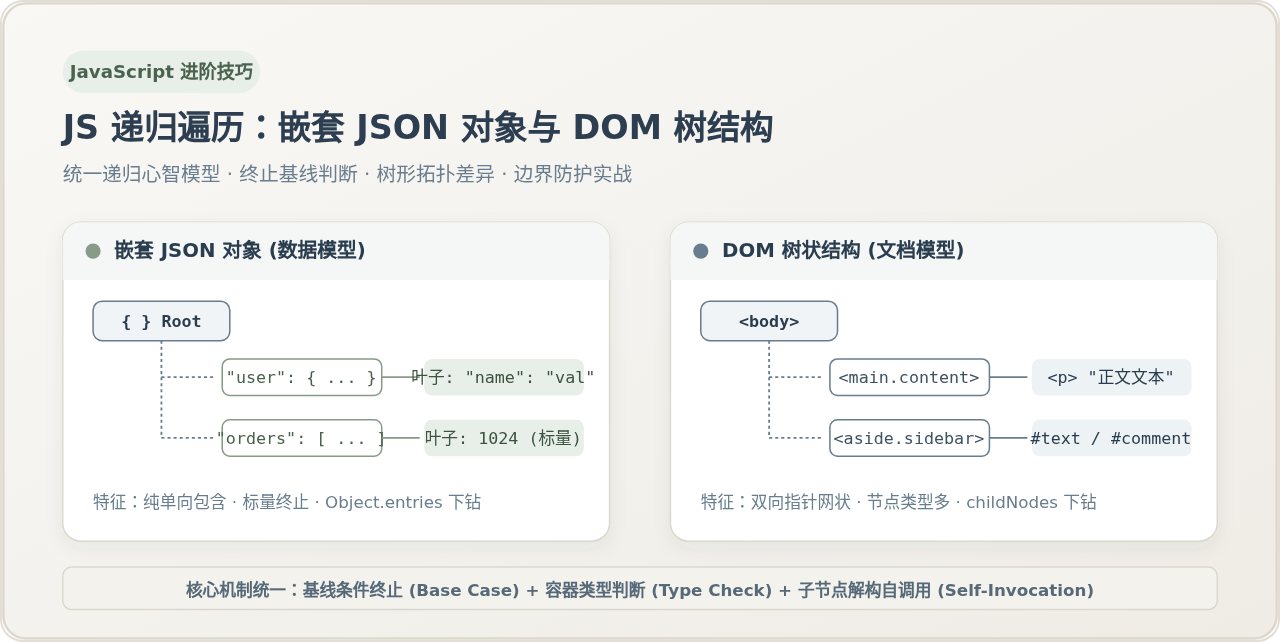
一、递归遍历的核心骨架:基线条件与递推步骤
无论遍历的目标是后端的复杂 JSON 配置,还是前端页面的 DOM 节点,它们在计算机科学中都属于典型的树形结构(Tree)。树形结构由一个根节点开始,每个复合节点包含若干子节点,直到不含子分支的末端节点(叶子节点)。
编写一个安全、可维护的递归遍历函数,必须具备两个最基本的支柱:
- 基线条件(Base Case,终止条件):负责识别何时到达叶子节点,或者何时遇到无法继续展开的值(例如字符串、数字、布尔值,或者无子标签的纯文本节点)。一旦命中基线条件,函数执行具体的业务逻辑(如记录路径、读取数值)并直接返回,不再发起新的自调用。
- 递推步骤(Recursive Step,分解下钻):当传入节点是复合容器(普通对象、数组或拥有子节点的 DOM 元素)时,函数将其拆解为子项列表,对每一个子项再次调用当前函数自身,并将更新后的层级信息(如属性路径或层级深度)传递下去。
理解递归的本质,就是理解函数入栈与出栈的过程。下面的流程图展示了每一次递归调用在处理单节点时的标准推导顺序与安全防御环节。
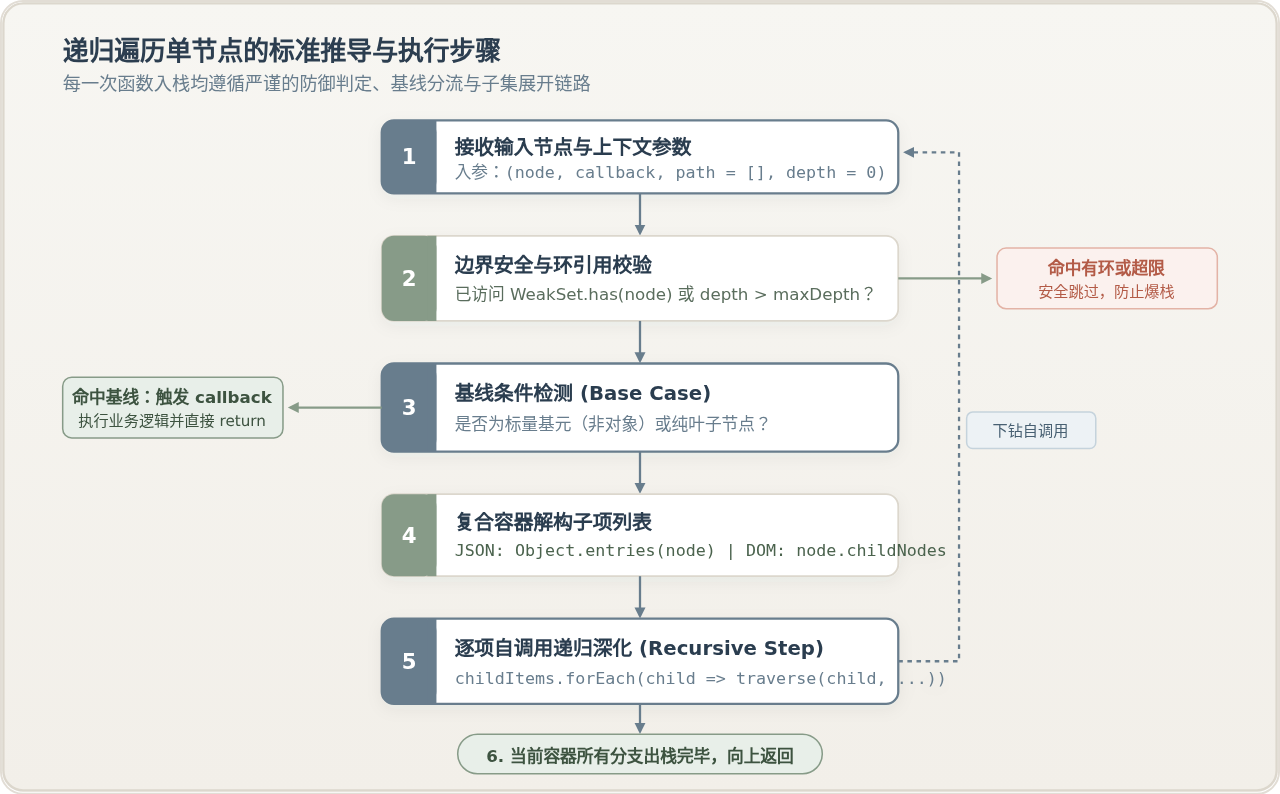
从上图可以看出,一次完备的递归单步执行,不仅包含“判断叶子”和“展开子级”,还前置了安全防御与上下文追踪。只有在防护健全的前提下,自调用下钻才能安全触底回溯。
二、实战场景一:深度遍历任意嵌套 JSON 对象
在实际业务中,我们经常需要处理来自服务端的多层嵌套 JSON,例如多级分类树、权限字典、组织架构或是富文本 AST。这些数据通常混合了普通对象 {}、数组 [] 以及各类基本类型标量。
实现 JSON 遍历的关键,在于精确识别数据类型:在 JavaScript 中,typeof null === 'object' 是一个经典陷阱,必须显式排除;同时,数组需要通过 Array.isArray() 与普通对象区分对待。
通用 JSON 递归遍历实现代码
以下是支持路径追踪与自定义访问回调的通用函数实现。该代码可以在 Node.js 或浏览器控制台中直接运行:
/**
 * 深度优先递归遍历嵌套 JSON 对象或数组
 * @param {*} data - 待遍历的数据(对象、数组或标量)
 * @param {Function} callback - 访问节点时的回调函数: (value, key, path, isLeaf) => void
 * @param {Array} path - 当前遍历到的键名路径,内部递归维护
 */
function traverseJSON(data, callback, path = []) {
  // 1. 基线条件:处理 null 或基本数据类型(非对象/非数组)
  if (data === null || typeof data !== 'object') {
    callback(data, path[path.length - 1], path, true);
    return;
  }

  // 2. 容器节点:触发当前容器的访问回调(标记为非叶子节点)
  if (path.length > 0) {
    callback(data, path[path.length - 1], path, false);
  }

  // 3. 递推步骤:根据数组或普通对象展开子分支
  if (Array.isArray(data)) {
    // 遍历数组元素,键名记录为数字索引
    data.forEach((item, index) => {
      traverseJSON(item, callback, [...path, index]);
    });
  } else {
    // 遍历对象自身的键值对
    Object.entries(data).forEach(([key, value]) => {
      traverseJSON(value, callback, [...path, key]);
    });
  }
}
场景示例:扁平化提取所有叶子节点路径与取值
我们构造一份常见的用户配置数据,利用上述递归函数快速提取所有配置项的完整访问路径:
// 待遍历的嵌套 JSON 数据
const userProfile = {
  id: 1001,
  name: "张三",
  roles: ["developer", "admin"],
  contact: {
    email: "zhangsan@example.com",
    address: {
      city: "北京",
      zipCode: "100000"
    }
  }
};

// 收集所有叶子节点的路径与值
const leafResults = [];

traverseJSON(userProfile, (value, key, path, isLeaf) => {
  if (isLeaf) {
    leafResults.push({
      path: path.join('.'),
      value: value
    });
  }
});

console.log(leafResults);
示例输出:
[
  { path: 'id', value: 1001 },
  { path: 'name', value: '张三' },
  { path: 'roles.0', value: 'developer' },
  { path: 'roles.1', value: 'admin' },
  { path: 'contact.email', value: 'zhangsan@example.com' },
  { path: 'contact.address.city', value: '北京' },
  { path: 'contact.address.zipCode', value: '100000' }
]
三、实战场景二:深度遍历浏览器 DOM 树结构
浏览器页面中的 HTML 文档在解析后,会生成一棵由 Node 对象组成的文档对象模型(DOM)树。DOM 树的递归遍历常用于自动化测试、高亮关键字、敏感词脱敏、自定义富文本序列化或统计页面标签分布。
与 JSON 遍历不同,DOM 节点的子元素访问存在两种不同属性:
element.children:仅包含元素节点(HTML 标签,nodeType === 1),自动忽略空格和换行。node.childNodes:包含所有类型的子节点,包括标签元素、文本节点(nodeType === 3)及注释节点(nodeType === 8)。
通用 DOM 递归遍历实现代码
下面的实现提供了深度优先遍历 DOM 树的通用方法,支持通过参数控制是否访问文本节点,并传递深度参数以方便做层级缩进:
/**
 * 递归深度优先遍历 DOM 树
 * @param {Node} node - 当前 DOM 节点
 * @param {Function} callback - 访问节点的回调函数: (node, depth) => void
 * @param {number} depth - 当前层级深度
 * @param {boolean} includeText - 是否包含纯文本节点
 */
function traverseDOM(node, callback, depth = 0, includeText = false) {
  if (!node) return;

  // 1. 过滤:如果不包含文本节点,且当前节点非元素节点(nodeType !== 1),则直接返回
  if (!includeText && node.nodeType !== Node.ELEMENT_NODE) {
    return;
  }

  // 2. 访问当前节点
  callback(node, depth);

  // 3. 基线与递推:选择遍历集合
  // 若需要纯文本则遍历 childNodes,若仅操作 HTML 标签推荐直接使用 children
  const children = includeText ? node.childNodes : node.children;

  // 对每一个子节点递归调用
  for (let i = 0; i < children.length; i++) {
    traverseDOM(children[i], callback, depth + 1, includeText);
  }
}
场景示例:打印页面 DOM 树的层级结构
假设我们有如下简短的 HTML 片段:
<div id="root">
  <header>
    <h1 class="title">文章标题</h1>
  </header>
  <main>
    <p>段落一内容</p>
    <p>段落二内容</p>
  </main>
</div>
执行带有层级打印的递归遍历:
const rootElement = document.getElementById('root');

traverseDOM(rootElement, (element, depth) => {
  const indent = '  '.repeat(depth);
  const tag = element.tagName.toLowerCase();
  const idStr = element.id ? `#${element.id}` : '';
  const classStr = element.className ? `.${element.className}` : '';
  console.log(`${indent}<${tag}${idStr}${classStr}>`);
});
示例输出:
<div#root>
  <header>
    <h1.title>
  <main>
    <p>
    <p>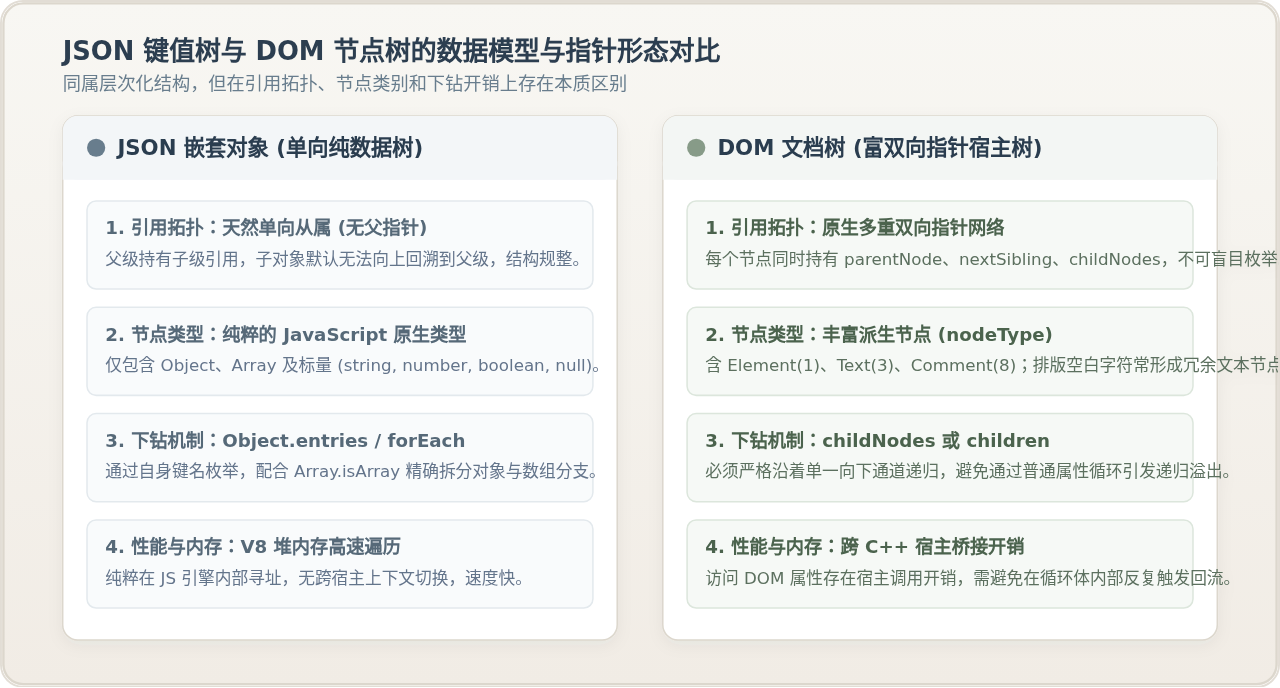
四、关键差异对比:JSON 对象遍历 vs DOM 树遍历
虽然 JSON 对象与 DOM 树在形式上都可以抽象为树形结构,并在逻辑上采用相同的深度优先递归模板,但在 JavaScript 运行时中,二者受宿主环境与底层设计的影响,存在着非常关键的差异。了解这些差异,是避免代码产生隐蔽 Bug 的关键前提。
| 对比维度 | 嵌套 JSON 对象遍历 | DOM 树结构遍历 | 关键影响与应对要求 |
|---|---|---|---|
| 数据宿主与引用拓扑 | 纯 JS 堆内存对象。单向从属,默认无父级引用指针(天然 DAG 树)。 | 浏览器 C++ 宿主派生对象。双向紧密连接,每个节点自带 parentNode、nextSibling。 |
JSON 只需沿键展开;DOM 遍历切忌随意遍历自身所有属性,否则顺着 parentNode 会瞬间陷入双向死循环。 |
| 节点类型的纯净度 | 类型单一明确:只有普通 Object、Array 和基本类型。 | 派生节点繁多:Element(1)、Text(3)、Comment(8) 等,且排版换行会形成空白文本节点。 | JSON 仅需区分数组与对象;DOM 需在 children 与 childNodes 之间明确选择,否则容易被空白换行干扰。 |
| 执行开销与边界交互 | 纯 V8 引擎内部内存寻址,读写成本极低。 | 跨 JavaScript 与 C++ 宿主边界调用,频繁访问可能带来更高开销。 | DOM 遍历中尽量避免在回调内连续读取引发强制重排(Reflow)的几何属性(如 offsetWidth)。 |
| 属性枚举安全性 | 若误用 for...in 可能会访问到原型链上的扩展属性。 |
节点属性固定为 WebIDL 定义的规范属性,通过专用接口访问子集。 | JSON 遍历中务必使用 Object.entries() 或 Object.hasOwn() 过滤继承属性。 |
五、生产环境中的边界陷阱与避坑方案
在简单的示例数据中,递归代码往往运行良好;但一旦将代码部署至处理海量外部数据或复杂界面的生产环境中,必须对以下三大边界陷阱做好防御措施。
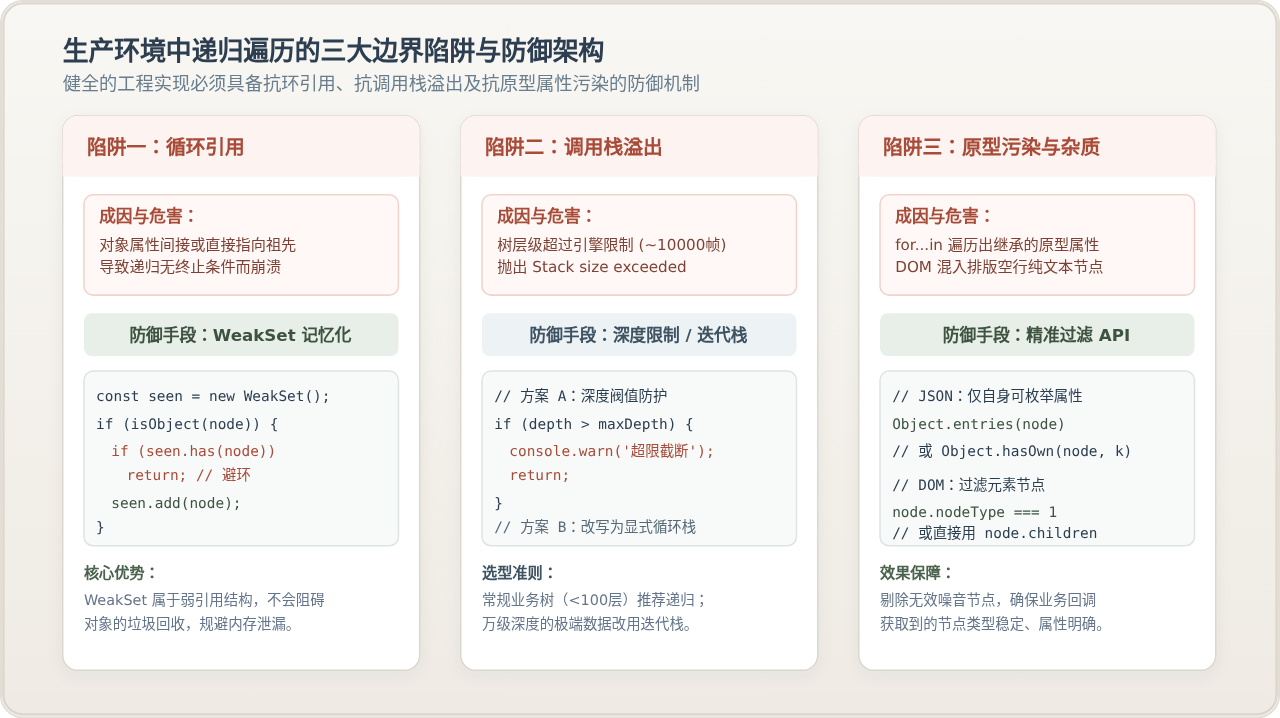
1. 陷阱一:循环引用(Circular References)导致爆栈
虽然合法的标准 JSON 字符串(通过 JSON.parse 获得)不存在循环引用,但在复杂的复杂业务内存对象中,两个对象相互引用的情况极为普遍。例如用户对象与订单对象双向关联:
const a = { name: "节点A" };
const b = { name: "节点B" };
a.link = b;
b.link = a; // 形成循环引用环路
如果对对象 a 直接执行普通递归,函数将在 a -> b -> a -> b 之间无止境地下钻,直到抛出 Uncaught RangeError: Maximum call stack size exceeded。
防御方案:引入 WeakSet 记录已访问对象
WeakSet 仅持有对象的弱引用,既能够以 $O(1)$ 的时间复杂度快速判断某个对象是否已经遍历过,又不会阻止引擎对废弃对象的垃圾回收。在递归进入容器前进行 seen.has(node) 判断,如果存在直接返回跳过。
2. 陷阱二:超深嵌套导致的调用栈溢出(Stack Overflow)
主流浏览器与 Node.js 对调用栈的深度有着严格限制(通常在 10,000 层左右)。当面临链表式或海量递归结构的深层数据时,传统的递归调用会直接突破栈上限。
针对此类极端场景,有两种落地保护策略:
-
设置安全深度阀值:传入
depth与maxDepth = 200,超过阀值时主动终止递归并记录告警,保护整个应用不至于崩溃。 -
改写为显式工作栈(迭代模式):如果必须处理万级超深层次数据,应放弃递归自调用,改用
while循环并在堆内存中维护一个自定义数组(Stack),以空间换调用栈安全性。
3. 陷阱三:原型链污染与非自身属性干扰
有些早期代码习惯使用 for (const key in obj) 遍历对象。如果第三方库或运行环境中有人在 Object.prototype 上挂载了自定义方法,这些原型方法也会被循环枚举出来,造成多余甚至错误的递归。
推荐统一采用 Object.entries(node)、Object.keys(node),或者在使用 for...in 时严格配合 Object.hasOwn(node, key) 进行保护。
综合防御的健壮 JSON 遍历封装
将上述三项防御集成到一起,便能得到可直接用于生产环境的健壮函数:
/**
 * 工业级安全的 JSON 深度遍历工具
 */
function safeTraverseJSON(data, callback, options = {}) {
  const {
    maxDepth = 100,
    seen = new WeakSet()
  } = options;

  function walk(node, path, depth) {
    // 防御一:调用栈深度熔断
    if (depth > maxDepth) {
      console.warn(`[safeTraverseJSON] 超过最大递归深度限制 ${maxDepth},路径: ${path.join('.')}`);
      return;
    }

    // 基线条件:基本数据类型与 null
    if (node === null || typeof node !== 'object') {
      callback(node, path[path.length - 1], path, true);
      return;
    }

    // 防御二:循环引用跳过
    if (seen.has(node)) {
      return;
    }
    seen.add(node);

    // 触发非叶子容器节点回调
    if (path.length > 0) {
      callback(node, path[path.length - 1], path, false);
    }

    // 递推步骤:精准分解
    if (Array.isArray(node)) {
      for (let i = 0; i < node.length; i++) {
        walk(node[i], [...path, i], depth + 1);
      }
    } else {
      // 防御三:Object.entries 仅枚举自身可枚举属性
      const entries = Object.entries(node);
      for (let i = 0; i < entries.length; i++) {
        const [k, v] = entries[i];
        walk(v, [...path, k], depth + 1);
      }
    }
  }

  walk(data, [], 0);
}
六、全景总结与方案选型决策
掌握 JavaScript 递归遍历,关键在于建立起结构化的解题习惯:
- 明确基线:先想清楚递归在什么条件下必须立刻 return(标量值、叶子元素、已访问节点)。
- 识别拓扑:区分是数据树(JSON)还是双向宿主树(DOM),针对 DOM 严守单向
children下钻通道。 - 构建防御:根据数据源可信度,适时装配
WeakSet记忆化和深度阀值保护。
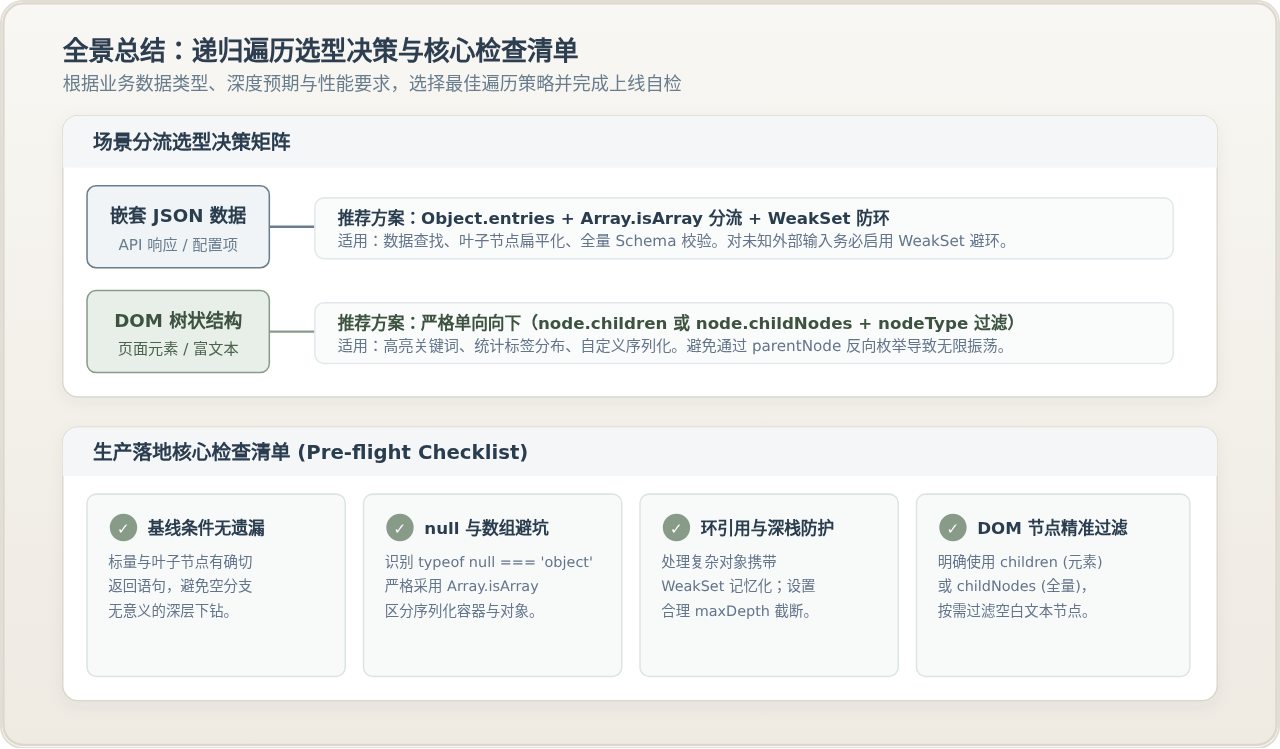
只要遵循上述模型,在面对多层级的组织架构列表、动态表单生成、富文本渲染或 DOM 高亮提取等各类实际开发任务时,就能写出清晰、安全且高性能的树形遍历代码。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章