
深入剖析现代 JavaScript 中超越传统方法链式调用的四种核心数据流处理范式:纯函数管道与转换器、迭代器与异步生成器、原生 Web Streams API 及响应式流,提供完整代码实现、性能机制与选型依据。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
除了链式调用,JS 中还有哪些现代数据流处理方式
作者:纸飞机
时间:2026-11-02
浏览:359
文章目录
在 JavaScript 中,基于数组方法(如
.map().filter().reduce())或 Promise 的链式调用是最熟悉的数据处理方式,但面对大规模数据集、异步分块传输、无限序列或跨模块函数组合时,链式调用会暴露出全量内存分配、中间数组堆积以及方法硬绑定的局限。现代 JavaScript 及 Web 标准提供了四种核心替代方案:管道化与纯函数组合(Pipeline & Transducers)、迭代器与异步生成器(Iterators & Async Generators)、原生 Web Streams API(Readable / Transform / Writable Streams),以及响应式推模式流(Reactive Streams)。本文将逐一拆解这些方案的运作机制、核心代码实现、性能差异与选型依据。
一、为什么链式调用在某些场景下会遇到瓶颈?
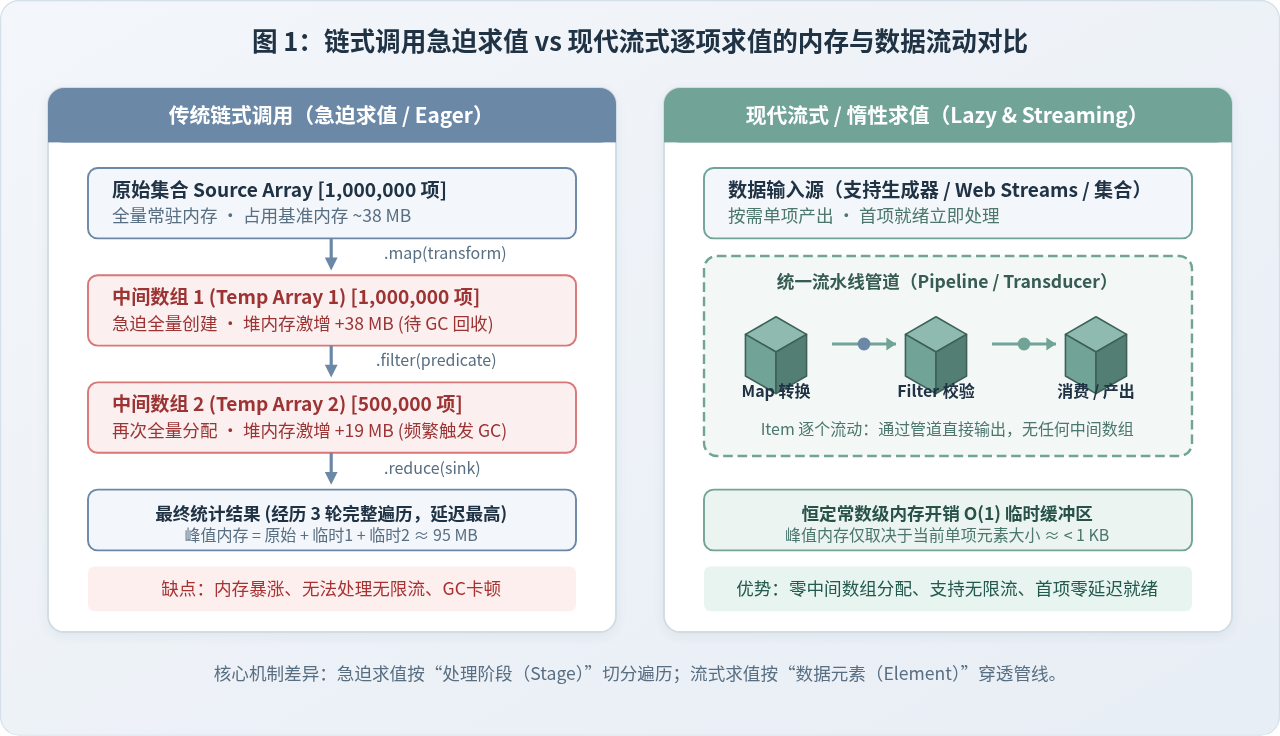
数组链式调用的核心执行逻辑属于急迫求值(Eager Evaluation)。在急迫求值模式下,每一个操作步骤都必须先全量遍历整个数据集,生成一个完整的中间数组,后续步骤才能在此基础上继续执行。这种设计在日常处理几十到几百条内存数据的业务逻辑中直观且易读,但一旦进入高吞吐、海量数据或实时 I/O 场景,其底层机制就会暴露出不可忽视的缺陷。
为了直观理解这种损耗,可以考虑一个包含 100 万条订单数据的数组清洗需求:我们希望筛选出金额大于 100 的订单,将其换算为含税价格,并求出总和。若使用链式调用:
const rawOrders = new Array(1000000).fill(0).map((_, i) => ({ id: i, amount: (i % 200) + 1 }));

// 链式调用产生全量中间分配
const total = rawOrders
  .filter(order => order.amount > 100)    // 分配中间数组 1:约 50 万个对象引用
  .map(order => order.amount * 1.13)       // 分配中间数组 2:50 万个浮点数
  .reduce((acc, val) => acc + val, 0);   // 最终求和
在上述代码执行过程中,V8 引擎必须在堆内存中额外分配两次大型数组空间。由于中间数组在完成计算后立即变为无用垃圾,这会直接加剧 V8 的新生代与老生代垃圾回收负担,引发垃圾回收暂停(GC Stop-the-world),在浏览器端直接表现为页面交互卡顿与掉帧,在 Node.js 服务端则会导致接口 P99 延迟陡增。
除此之外,链式调用还存在另外两重固有限制:
- 原型方法硬绑定:链式调用依赖于方法挂载在
Array.prototype上。外部编写的自定义清洗逻辑若要链入,要么污染原型链,要么必须中断链条。同时这也限制了代码打包器的 Tree-shaking 优化。 - 无法应对异步分块与无限流:数组链式调用假设全部数据已经一次性驻留在内存中。如果数据来自持续到来的 HTTP 分块(Chunked Stream)或潜在无限的序列,链式调用便无从下手。
二、方案一:管道化与纯函数组合(Pipeline & Transducers)
当数据仍处于同步内存中、但步骤繁多且需要消除方法硬绑定时,最直接的现代改进方式是管道化(Pipeline)与函数组合(Composition)。这种方式将每个数据操作抽离为独立的、可单独测试的纯函数,再通过管道机制组合在一起。
1. 通用 Pipe 函数的实现与流式串联
在管道模型中,数据作为初始值传入,像流水线一样依次流过一系列单参数纯函数。我们可以使用极其精简的高阶函数实现工业级的 pipe 工具:
// 同步管道组合器:左至右依次执行
const pipe = (...fns) => (initialValue) =>
  fns.reduce((acc, fn) => fn(acc), initialValue);

// 异步管道组合器:支持包含 Promise 的异步函数流
const pipeAsync = (...fns) => (initialValue) =>
  fns.reduce(async (accPromise, fn) => fn(await accPromise), Promise.resolve(initialValue));

// 独立的转换原子函数
const trimString = str => str.trim();
const toLower = str => str.toLowerCase();
const removeSpecialChars = str => str.replace(/[^a-z0-9 ]/g, "");
const splitWords = str => str.split(" ").filter(Boolean);

// 组合成完整的数据清洗管道
const sanitizeInput = pipe(
  trimString,
  toLower,
  removeSpecialChars,
  splitWords
);

const tokens = sanitizeInput("  Hello, Modern JavaScript DataFlow! #2026 ");
// 输出示例: ['hello', 'modern', 'javascript', 'dataflow', '2026']
2. 转换器(Transducers):在一次迭代中完成多重转换
普通的 pipe 虽然解耦了函数,但若内部依然针对数组调用 map 和 filter,中间数组依然存在。为了彻底消除中间数组,函数式编程中引入了转换器(Transducers)。
Transducer 的核心哲学是:将“映射(Mapping)”和“过滤(Filtering)”的算法逻辑与“如何收集结果(Reducing)”彻底解耦。通过将多个操作转换为单一的 reducer 变形器,只需单次遍历即可完成全部操作,临时中间数组的数量降为 0。
// 1. 定义 map 转换器工厂
const mapping = (mapper) => (step) => (acc, current) =>
  step(acc, mapper(current));

// 2. 定义 filter 转换器工厂
const filtering = (predicate) => (step) => (acc, current) =>
  predicate(current) ? step(acc, current) : acc;

// 3. 基础累加消费器:将项追加到数组
const pushReducer = (acc, item) => {
  acc.push(item);
  return acc;
};

// 4. 组合 Transducer
const processOrders = pipe(
  filtering(order => order.amount > 100),
  mapping(order => ({ ...order, taxAmount: Number((order.amount * 1.13).toFixed(2)) }))
);

// 5. 执行单次遍历求值:仅迭代一次,0 中间数组
const dataset = [
  { id: 1, amount: 80 },
  { id: 2, amount: 150 },
  { id: 3, amount: 220 }
];
const finalResult = dataset.reduce(processOrders(pushReducer), []);
// 输出示例: [ { id: 2, amount: 150, taxAmount: 169.5 }, { id: 3, amount: 220, taxAmount: 248.6 } ]
适用条件与注意事项
Transducers 非常适合在内存中执行密集运算的大数组处理。但其缺点在于抽象层次较高、调试时调用栈深。对于只有几百项的小规模数据,其运行效率与简单链式调用差异极小,无需刻意引入过重的转换器抽象。
三、方案二:迭代器与异步生成器(Iterators & Async Generators)
如果说 Transducers 解决的是“如何在一趟遍历中消除中间数组”,那么迭代器与生成器解决的则是“我是否真的需要一次性把所有数据都计算出来?”
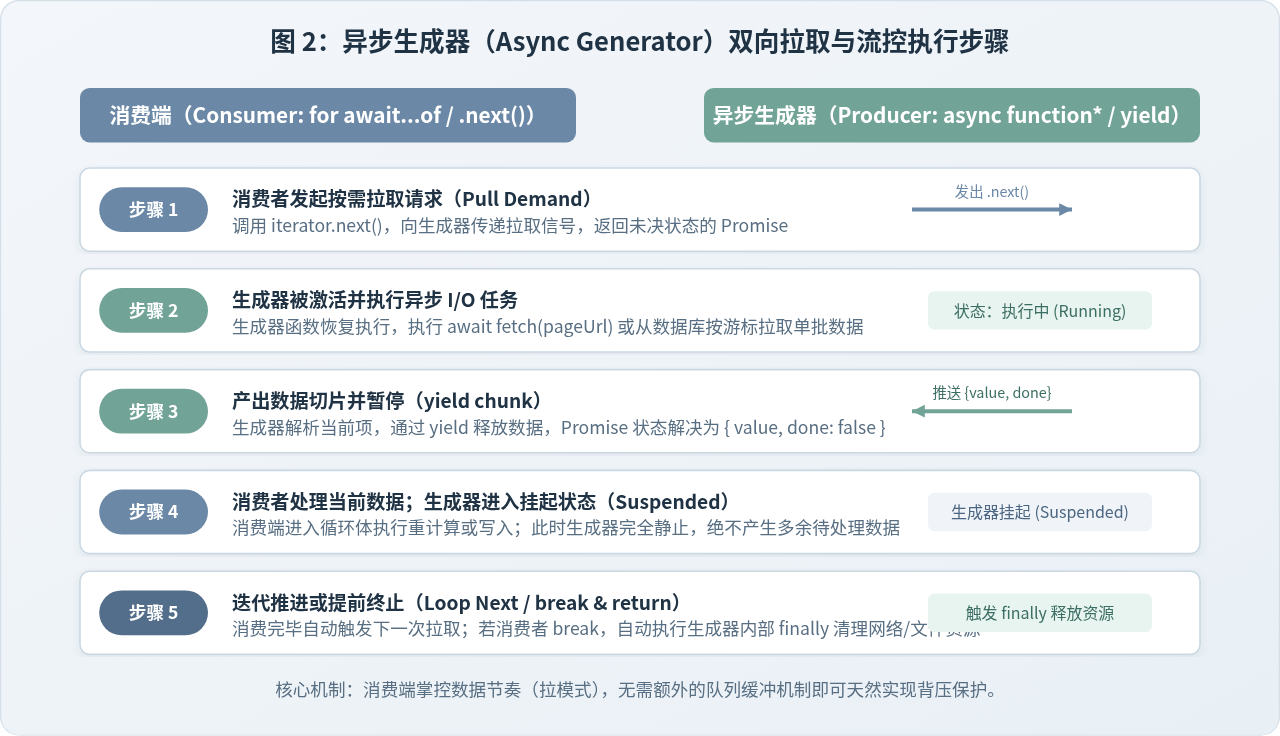
在链式调用中,数据处理由生产者主导,强制全量推送(Push)。而通过 迭代器协议(Iteration Protocols) 和 生成器函数(function* / async function*),数据流动转变为由消费者按需拉取(Pull-based Demand)的惰性求值模式。
1. 同步生成器与惰性求值
在生成器中,代码执行到 yield 语句时会立即暂停,保留当前执行上下文,只有当外部调用 .next() 时才会恢复。这种特性使得我们能够轻松处理无限数据流或巨大的文件游标,并在达到退出条件(如 break)时立即终止计算,避免无谓消耗。
// 惰性无限整数流发生器
function* infiniteCounter(start = 0) {
  let current = start;
  while (true) {
    yield current++;
  }
}

// 惰性过滤器:只在拉取时逐个检查
function* lazyFilter(iterable, predicate) {
  for (const item of iterable) {
    if (predicate(item)) {
      yield item;
    }
  }
}

// 惰性截取器:只取前 n 项,随后主动停止
function* lazyTake(iterable, count) {
  let taken = 0;
  for (const item of iterable) {
    if (taken++ >= count) return;
    yield item;
  }
}

// 使用消费:计算前 3 个能被 7 整除的大于 100 的数
const stream = lazyTake(
  lazyFilter(infiniteCounter(101), n => n % 7 === 0),
  3
);

for (const val of stream) {
  console.log(val); // 输出示例: 105, 112, 119
}
2. 异步生成器与 for await...of 处理异步分页数据
在实际工程中,数据通常不是一次性以数组形式返回,而是分布在带有翻页标识(Page Cursor)的 RESTful API 中。如果用常规 Promise 链式调用,代码往往陷入递归拉取或将所有页面的数据拼接进一个巨型数组再集中处理的模式。
使用异步生成器(Async Generator),我们可以把分页请求优雅地抽象为一个平滑的数据流。消费端只需使用 for await...of 语法,无需感知翻页细节,并且在任意时刻 break 都能立即停止后续网络请求。
// 模拟通过游标逐页拉取日志的异步流
async function* fetchPaginatedLogs(endpoint, maxPages = 5) {
  let cursor = null;
  let pageIndex = 0;

  try {
    while (pageIndex < maxPages) {
      // 模拟网络请求延迟
      await new Promise(r => setTimeout(r, 100));
      const mockResponse = {
        records: [`Log_${pageIndex}_A`, `Log_${pageIndex}_B`],
        nextCursor: pageIndex + 1 < maxPages ? `cursor_${pageIndex + 1}` : null
      };

      // 逐条产出数据项给消费端
      for (const record of mockResponse.records) {
        yield record;
      }

      if (!mockResponse.nextCursor) break;
      cursor = mockResponse.nextCursor;
      pageIndex++;
    }
  } finally {
    // 关键:无论正常结束还是消费者提前 break,都会触发资源回收
    console.log("[AsyncGenerator] 连接已关闭,底层资源释放完成");
  }
}

// 消费端按需消费:若找到特定记录则提前退出
async function runConsumer() {
  for await (const logItem of fetchPaginatedLogs("/api/logs")) {
    console.log("消费数据:", logItem);
    if (logItem === "Log_1_A") {
      console.log("满足条件,提前终止拉取");
      break; // 立即终止,后续页面的网络请求根本不会触发!
    }
  }
}
四、方案三:原生 Web Streams API(标准分块流与背压控制)
当数据流涉及网络大文件传输、音频视频解码或服务端渲染(SSR)时,内存管理的挑战上升为:如果上游产生数据的速度远远快于下游处理数据的速度,中间缓冲区如何防止内存溢出?
这正是现代 Web Streams API(已全面被主流浏览器以及 Node.js 18+、Deno、Bun 原生支持)的核心使命。它通过 ReadableStream、TransformStream 和 WritableStream 构筑了工业级的流传输标准,且天生具备背压反馈(Backpressure)机制。
1. 核心三元组与管道编排
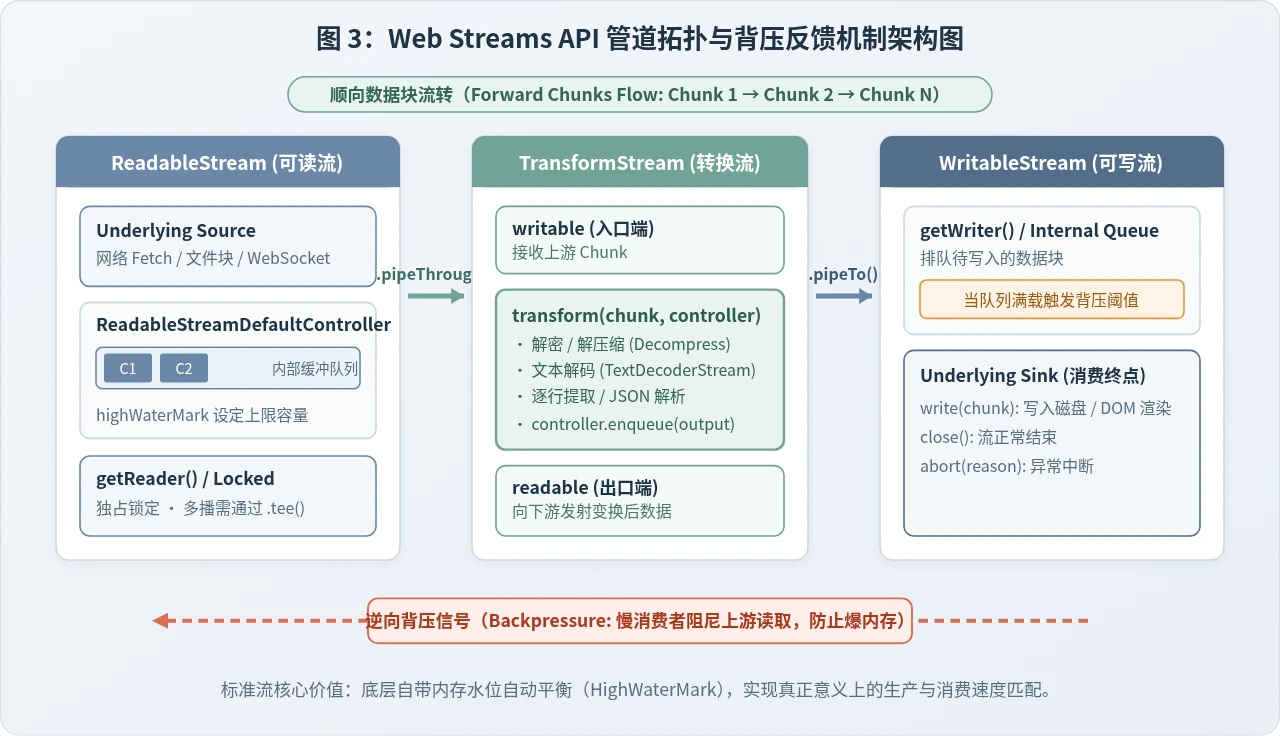
Web Streams 将流动的数据抽象为一系列数据块(Chunks)。数据通过 .pipeThrough() 传递给转换流,最终通过 .pipeTo() 汇入终端:
ReadableStream:数据的源头,封装了底层数据拉取逻辑。内部配备队列和控制器(Controller)。TransformStream:包含成对的writable和readable端,负责在流动的过程中对 Chunk 执行解密、转码或过滤。WritableStream:数据的消费终点,例如将分块写入磁盘、写入 DOM 或发送给第三方网关。
2. 为什么背压(Backpressure)是链式调用根本无法企及的能力?
在链式调用或普通的 Promise 回调中,一旦上游触发数据读取,所有数据就会如开闸洪水般涌入内存堆栈。若下级消费端正在进行耗时较长的磁盘写盘或复杂的加密计算,未经节制的数据块就会在内存中疯狂积压,直至发生 Out of Memory(OOM)崩溃。
Web Streams 的每个节点都设有一个 highWaterMark(高水位阈值)。当下游 WritableStream 的内部写入队列达到该阈值时,管道会自动向上游传递一个负向背压信号。此时 ReadableStream 会自动暂停执行底层数据源的 pull() 方法,让生产速率严格咬合消费速率。当消费端队列排空后,背压解除,生产恢复。
3. 完整示例:分块文本流实时解码与逐行 JSON 提取
以下代码演示如何使用原生 Web Streams 对持续到达的 Uint8Array 二进制网络流进行实时解码,并通过自定义 TransformStream 实现逐行切割与 JSON 结构化流式解析:
// 1. 自定义分行 TransformStream:处理跨 Chunk 截断的文本行
function createLineSplitterStream() {
  let buffer = "";
  return new TransformStream({
    transform(chunk, controller) {
      buffer += chunk;
      const lines = buffer.split("
");
      // 缓冲区最后一段可能尚未完整,留待下个 Chunk
      buffer = lines.pop() || "";
      for (const line of lines) {
        if (line.trim()) {
          controller.enqueue(line);
        }
      }
    },
    flush(controller) {
      // 流结束时冲刷剩余残存内容
      if (buffer.trim()) {
        controller.enqueue(buffer);
      }
    }
  });
}

// 2. 自定义 JSON 解析 TransformStream
function createJsonParserStream() {
  return new TransformStream({
    transform(line, controller) {
      try {
        const parsed = JSON.parse(line);
        controller.enqueue(parsed);
      } catch (err) {
        console.warn("跳过畸变行:", line);
      }
    }
  });
}

// 3. 组装整条流水线并接入消费端
async function processStreamingEndpoint(responseStream) {
  const pipeline = responseStream
    .pipeThrough(new TextDecoderStream())         // 原生二进制转字符串流
    .pipeThrough(createLineSplitterStream())      // 逐行切分转换流
    .pipeThrough(createJsonParserStream());       // 转换为 JSON 对象流

  // 汇入消费端:逐项处理,天然带背压
  await pipeline.pipeTo(new WritableStream({
    async write(record) {
      // 模拟耗时消费:若此处处理需要 50ms,上游读取速率将自动降低
      await new Promise(r => setTimeout(r, 50));
      console.log("成功消费结构化事件:", record.id);
    }
  }));
  console.log("流式管道完整执行完毕");
}
五、方案四:响应式推模式数据流(Reactive Streams)
上述迭代器与 Web Streams 主要是基于“拉取”或“控制受限的块式推送”。但在前端用户界面交互、实时音视频控制或 WebSocket 实时长连接中,数据通常是由外部不确定事件源主动触发的推模式(Push-based Stream)。
在不引入巨型三方库(如完整版 RxJS)的前提下,现代 JavaScript 可以借助原生的 EventTarget、AbortController 以及异步可迭代器桥接,轻松构建具备防抖、节流与取消能力的轻量响应式流:
// 将 DOM 或 EventTarget 事件转换为带有背压与取消支持的异步流
function fromEventStream(target, eventName, { signal } = {}) {
  return new ReadableStream({
    start(controller) {
      const handler = (event) => {
        controller.enqueue(event);
      };
      target.addEventListener(eventName, handler);

      // 响应 AbortSignal 取消信号
      signal?.addEventListener("abort", () => {
        target.removeEventListener(eventName, handler);
        controller.close();
      });
    }
  });
}

// 消费高频滚动事件流并实施限流保护
const abortCtrl = new AbortController();
const clickStream = fromEventStream(window, "click", { signal: abortCtrl.signal });

// 5 秒后主动解绑销毁
setTimeout(() => abortCtrl.abort(), 5000);
六、技术选型矩阵与工程实践指南
面对多样化的数据处理方式,实际工程决策的核心依据并非“哪个技术更新”,而是数据规模、产生时序、I/O 边界与背压需求之间的匹配度。
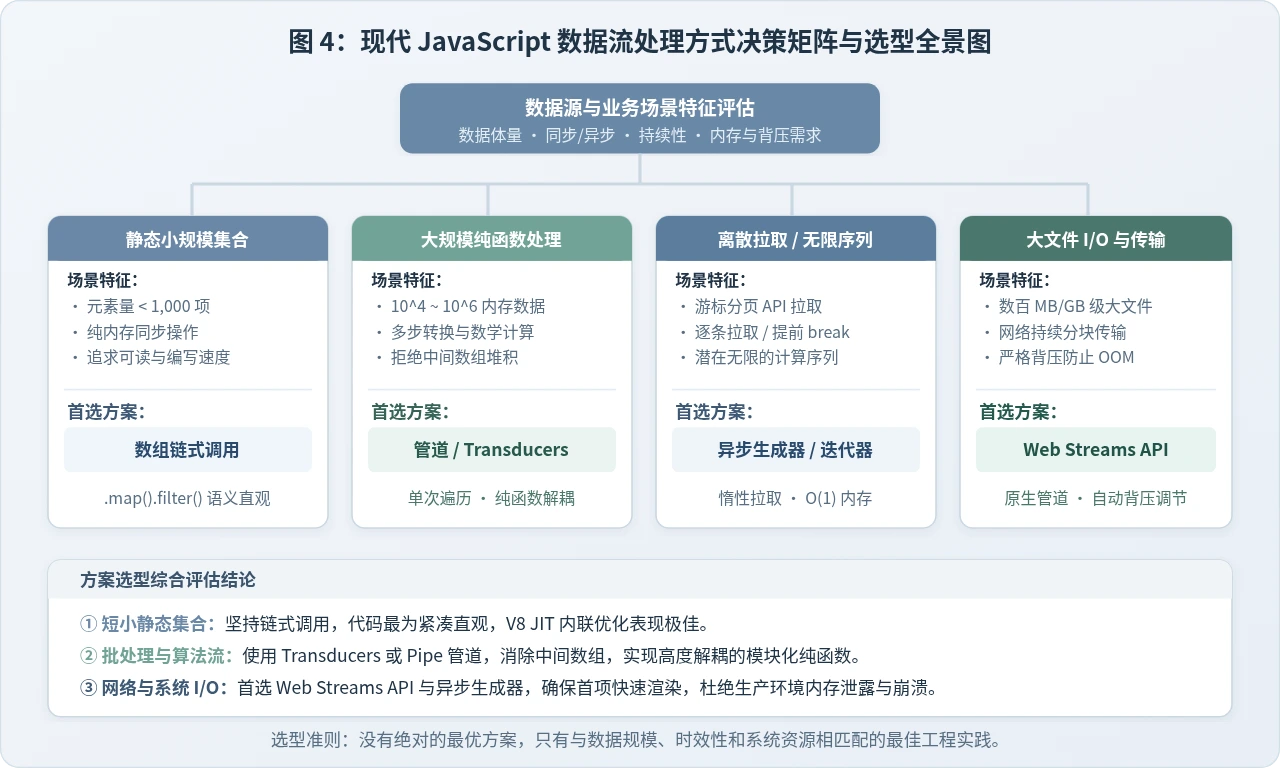
1. 核心维度横向对比表
| 处理范式 | 求值时机 | 中间内存开销 | 异步与 I/O 适配 | 原生背压支持 | 最佳适用场景 |
|---|---|---|---|---|---|
| 传统数组链式 | 急迫求值 (Eager) | 高(产生多轮临时数组) | 差(仅限静态同步数据) | 无 | 数据量 < 1,000 项的纯内存快速业务清洗 |
| 管道与 Transducers | 急迫或折叠求值 | 极低(单次遍历,0 中间数组) | 良(可包装异步管道) | 无 | 十万级以上静态内存数据的高性能多步计算 |
| 迭代器与生成器 | 惰性求值 (Pull-based) | 极低(单项按需产出) | 优(async function*) |
天然具备(拉模式按需消费) | 分页 API 拉取、游标遍历、无限序列、可中断任务 |
| Web Streams API | 分块传输 (Chunk-based) | 恒定(由队列水位控制) | 原生支持(面向标准 I/O 设计) | 强(内建高水位背压闭环) | 大文件传输、二进制编解码、高并发服务端流式响应 |
| 响应式推模式流 | 事件驱动 (Push-based) | 由时间窗口与算子决定 | 极高(实时事件源) | 需配合队列 / 取消器 | 用户交互事件处理、WebSocket 实时推送、高频时序组合 |
2. 生产环境关键避坑清单
-
警惕 Web Streams 的锁定机制(Locked Stream):
一个
ReadableStream一旦被附着了 Reader(例如调用了getReader()或执行了pipeTo()),该流就会进入锁定状态。如果需要将同一份网络响应分流给多个消费者(例如一个用于屏幕渲染、一个用于本地 IndexedDB 缓存),必须在锁定前使用readable.tee()分裂成两个独立的互不干扰的支流。 -
异步生成器必须编写
try...finally兜底: 当使用for await...of消费异步生成器时,如果消费端中途发生throw异常或执行了break,引擎会调用生成器的return()方法。若生成器内部持有数据库连接池或文件描述符句柄,必须将关闭逻辑放置在finally块中,否则会导致严重的句柄泄露。 -
警惕防抖与节流中的内存积压:
在构建高频响应式推模式流时,若生产者速度极高且每个事件对象体积庞大,未加限流的闭包累积容易引发堆内存缓慢上升。务必配合
AbortSignal实现组件卸载时的彻底断流与事件解绑。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章