
深入对比JavaScript中Math.floor、parseInt与位运算(如~~与|0)向下取整的底层规范、数轴方向分歧、科学计数法陷阱与32位溢出边界,提供严谨的技术选型指南。

当前位置:首页 > JavaScript 基础 > 正文
JS中Math.floor、parseInt与位运算向下取整的区别对比
作者:代码拾荒
时间:2026-11-02
浏览:614
文章目录
在 JavaScript 中,处理浮点数取整时,
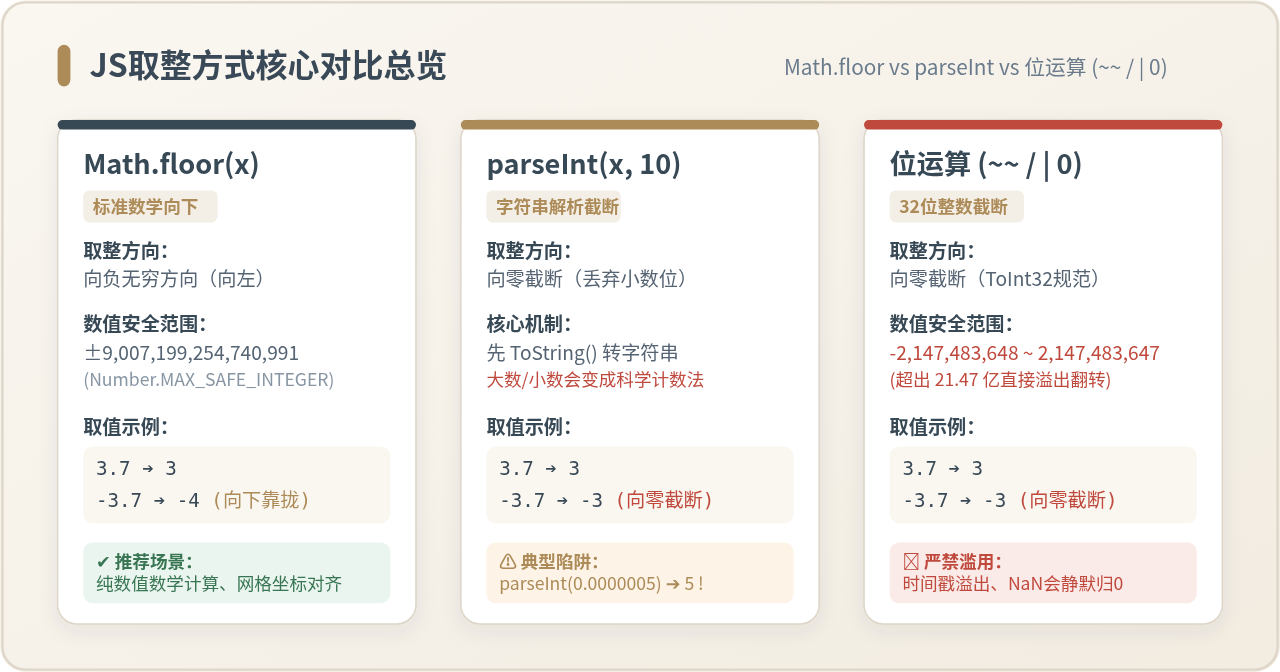
Math.floor、parseInt 与位运算(如 ~~x、x | 0)常被用来快速消除小数部分。在正数场景下,三者往往给出完全相同的数值,容易让人误以为它们可以无条件互换。然而,它们在 ECMAScript 规范层面的设计目标截然不同:Math.floor 是纯粹的数学向下取整;parseInt 本质是字符解析器;而位运算则受制于 32 位整数规范。本文将剖析三者在数轴移动方向、数值安全边界、隐式类型转换及性能认知上的核心区别,并给出清晰的选型标准。
一、快速总览:三大取整方式的本质属性对比
许多初学者之所以混淆这三者,是因为在处理像 3.14 这样的正浮点数时,Math.floor(3.14)、parseInt(3.14, 10) 与 ~~3.14 均返回 3。但一旦输入进入负数区间、数值超出 32 位整型范围、或者出现科学计数法表示时,三者的执行结果将彻底分化。
在深入细节前,我们先通过下表全面比对三者在底层规范、语义目标和边界行为上的核心差异:
| 对比维度 | Math.floor(x) | parseInt(x, radix) | 位运算 (~~x / x | 0) |
|---|---|---|---|
| 核心设计定位 | IEEE 754 标准数学向下取整函数 | 从字符串开头解析整数的词法工具 | 底层 32 位整数位操作副作用 |
| 取整几何方向 | 向下取整(向负无穷靠近) | 向零截断(丢弃小数部分) | 向零截断(丢弃小数部分) |
| 正数取整 (3.7) | 3 |
3 |
3 |
| 负数取整 (-3.7) | -4(向更小的负数靠拢) |
-3(抹去小数向原点靠近) |
-3(抹去小数向原点靠近) |
| 数值安全范围 | ±9,007,199,254,740,991 (253 - 1) | 受限于有效字符串解析位数 | 仅限 32 位有符号整数 [-231, 231 - 1] |
| 极大数 (3000000000) | 3000000000(正常支持) |
3000000000(正常支持) |
-1294967296(溢出反转为负) |
| 极小数 (0.0000005) | 0(正常计算) |
5(严重陷阱:科学计数法) |
0(正常转为整数 0) |
| 特殊值 (NaN / Infinity) | 保持 NaN / Infinity 语义 |
返回 NaN |
强制归零:0(静默吞噬异常) |
二、方向之争:向下取整 (Floor) 与 向零截断 (Truncate)
理解这三者差异的第一道分水岭在于:“向下取整”与“丢弃小数位”并不是同一概念。
在数学定义中,“向下取整(Floor,符号为 $\lfloor x floor$)”指寻找不超过 $x$ 的最大整数。无论 $x$ 是正数还是负数,取整的方向始终朝向数轴的左侧(即负无穷大 $-\infty$ 方向)。因此:
- 对于正数
3.7,不超过它的最大整数是3。 - 对于负数
-3.7,不超过它的最大整数是-4(因为 $-4 < -3.7 < -3$)。
而 parseInt 和位运算所执行的操作,严格来说被称为向零截断(Truncation,或 Round towards zero)。它的逻辑是单纯将小数点后的数字全部抹掉,其移动方向始终朝向原点 0 收缩。
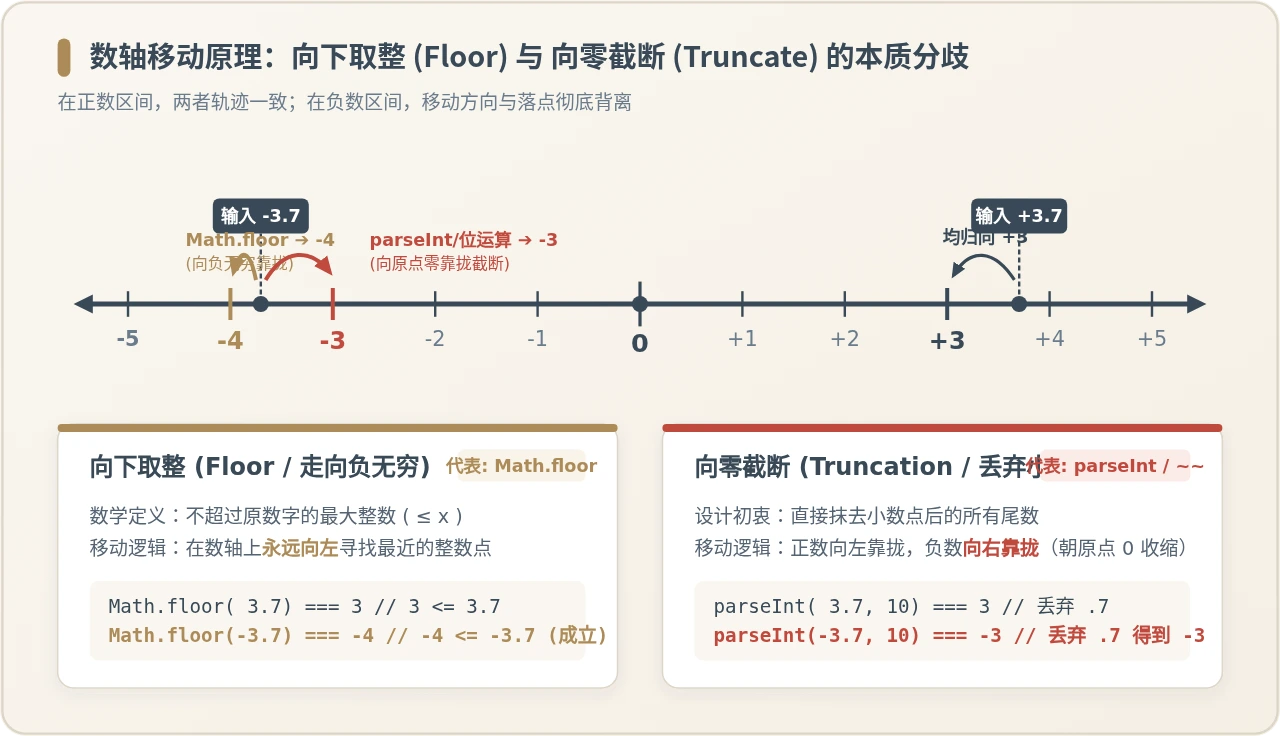
以下代码直观展示了正负数区间下三者的执行表现:
// 1. 正数区间:表现完全一致
Math.floor(3.7);       // 输出: 3
parseInt(3.7, 10);    // 输出: 3
~~3.7;                 // 输出: 3

// 2. 负数区间:核心分歧爆发
Math.floor(-3.7);      // 输出: -4 (真正的数学向下取整:-4 <= -3.7)
parseInt(-3.7, 10);   // 输出: -3 (向零截断:抹去小数位)
~~(-3.7);              // 输出: -3 (向零截断:抹去小数位)
关键注意:如果你的业务逻辑依赖严格的数学单调性(例如分页计算、时间区间整除对齐、几何网格索引),在处理可能包含负坐标或负差值的数据时,如果误用了
parseInt 或位运算,原本应该归入前一个区间的负数会被错误截断到后一个区间,造成逻辑偏离。
三、Math.floor:标准数学向下取整的实现与特性
Math.floor() 是 JavaScript 语言标准库(ECMAScript 规范)中定义的内置数学函数。它直接操作双精度浮点数(IEEE 754 格式),具备以下核心特性:
1. 完整的安全数值范围
在 JavaScript 中,能够精确表示的最大安全整数是 Number.MAX_SAFE_INTEGER(即 $2^53 - 1 = 9,007,199,254,740,991$)。Math.floor 完全在双精度浮点计算单元内执行,只要输入数值在这个安全范围内,计算结果都是百分之百精确的。它不会像位运算那样被强行截断为 32 位。
2. 异常值与非数字语义保留
当传入非有效数值或无穷大时,Math.floor 忠实遵循 IEEE 754 规则:
Math.floor(NaN);        // NaN(保留错误上下文)
Math.floor(Infinity);   // Infinity
Math.floor(-Infinity);  // -Infinity
保持 NaN 和 Infinity 的语义非常关键,因为它们能在调用栈中把“前置计算异常”暴露出来,便于开发者排查定位。
四、parseInt:字符串解析器在处理数值时的隐患
在很多遗留代码中,经常能看到用 parseInt(num) 来“取整”的写法。这种用法不仅存在不必要的性能损耗,更潜藏着破坏业务数据的严重安全漏洞。
1. 执行流程:先转字符串,再逐字解析
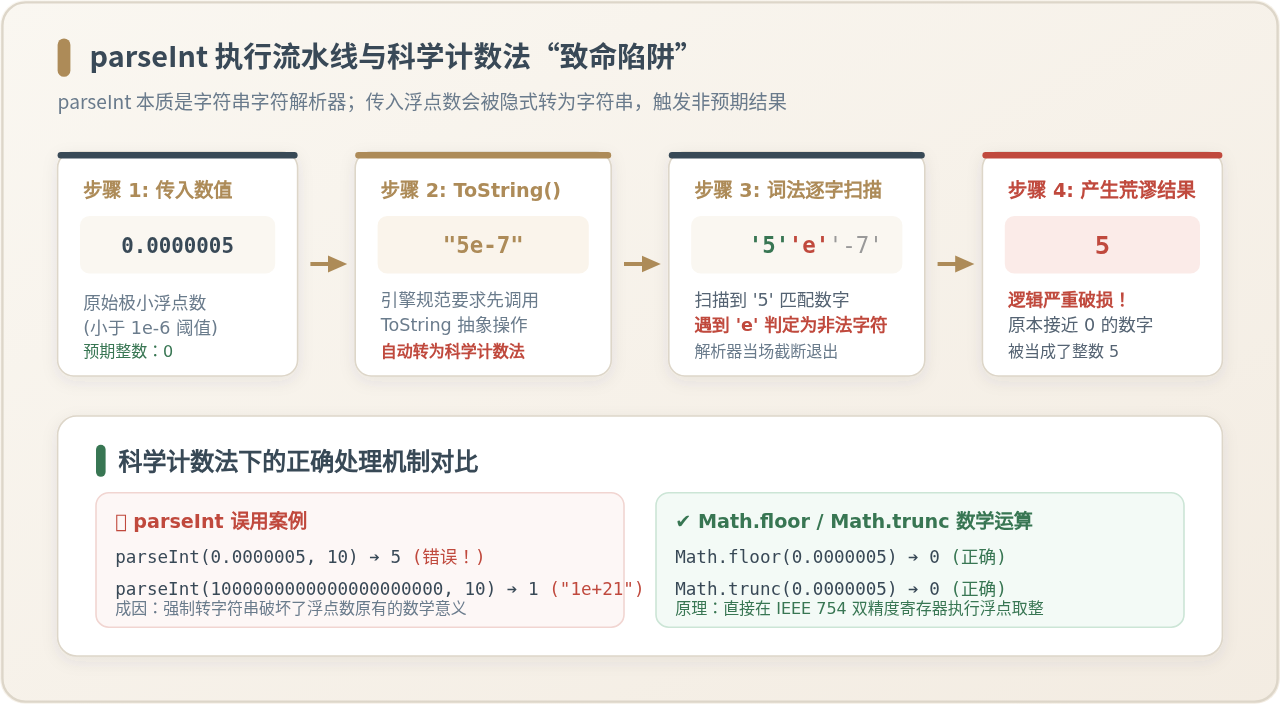
ECMAScript 规范明确规定,parseInt(string, radix) 的第一步是对输入参数调用抽象操作 ToString()。
这意味着:如果你传入一个数字 12.34,JavaScript 引擎并非直接对寄存器中的数字取模或截断,而是先执行 "12.34" 的字符串序列化,然后再启动一个词法扫描器,从左至右扫描字符,当遇到第一个非法字符(小数点 .)时停止解析,将已扫描到的数字字符按指定进制转换回整数。
2. 致命陷阱:科学计数法导致的荒谬结果
当一个浮点数的绝对值小于 $10^-6$ 时,JavaScript 的 ToString() 会自动采用指数记法(科学计数法):
String(0.0000005); // 结果是 "5e-7"
此时如果使用 parseInt 处理这个数值:
parseInt(0.0000005, 10); // 相当于 parseInt("5e-7", 10) ➔ 结果是 5!
parseInt 扫描到字符 '5' 后,遇到字母 'e' 便认为到达非数字字符而终止解析,最终返回了数字 5!原本一个极其微小、极其接近 0 的数字,经过 parseInt 取整后竟变成了 5,误差高达千万倍!
类似的问题同样会出现在大数上:
String(1000000000000000000000); // 结果是 "1e+21"
parseInt(1000000000000000000000, 10); // 结果是 1!
工程警示:永远不要将
parseInt 用于单纯的数值取整。它的合法应用场景只有一个:从包含单位或非数字后缀的字符串中提取前缀整数(例如 parseInt("120px", 10))。
五、位运算取整:32位有符号整数的魔术与危险边界
在 JavaScript 中,常见的位运算取整写法包括双按位非 ~~x、按位或零 x | 0、以及有符号右移零位 x >> 0。这些写法曾经常见于旧式游戏脚本或性能敏感库中,但其副作用十分隐蔽。
1. ToInt32 抽象操作的硬性限制
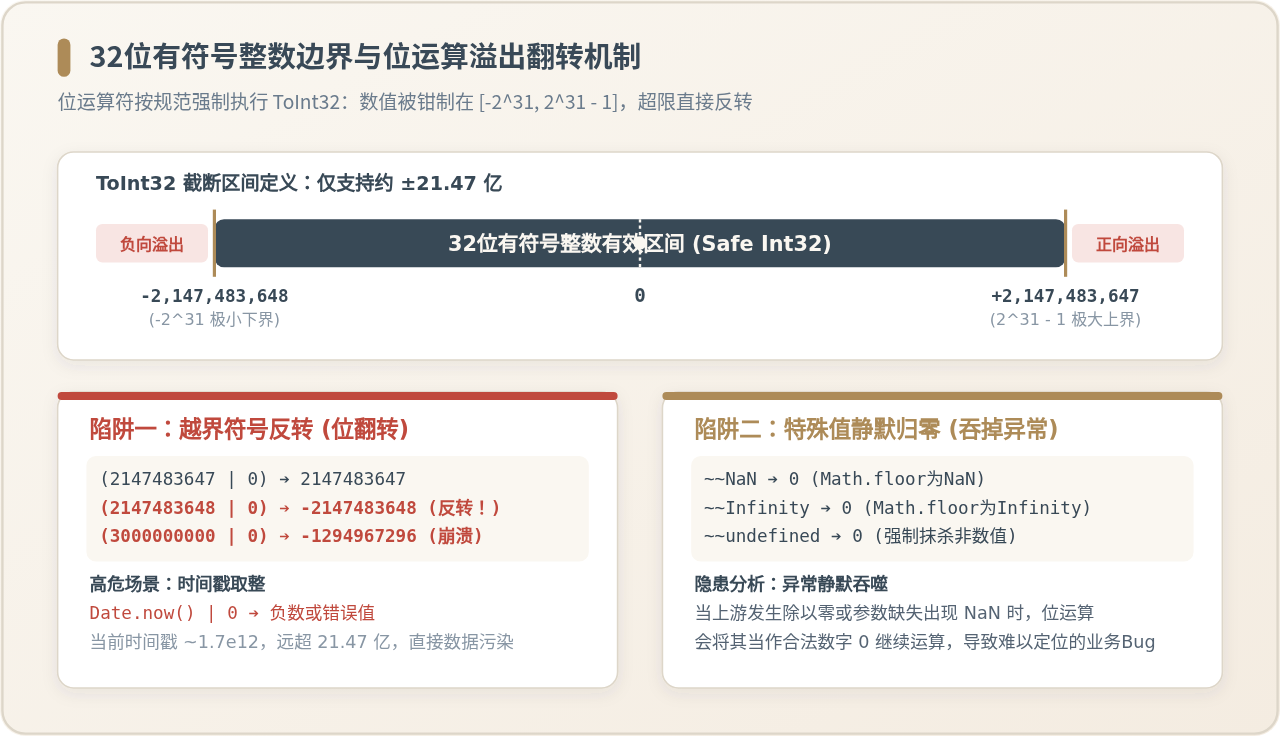
JavaScript 中的所有位操作符都遵循 ECMAScript 的 ToInt32 抽象规范。这意味着:无论输入原本是什么类型的数值,引擎都会首先将其强制压缩转换为一个 32 位有符号二进制补码整数。
32 位有符号整数的有效数值范围是 $[-2^31, 2^31 - 1]$,即:
-2,147,483,648 到 +2,147,483,647 (约 ±21.47 亿)
2. 致命隐患一:超出 21.47 亿直接发生符号翻转
当操作数超过 $2^31-1$ 时,第 32 位(最高位)会被解释为负数符号位,从而导致数值瞬间发生不可预测的翻转:
2147483647 | 0;   // 2147483647 (位于边界内,正常)
2147483648 | 0;   // -2147483648 (正数瞬间翻转为负数!)
3000000000 | 0;   // -1294967296 (高位截断,完全损坏)
最常见翻车现场是处理时间戳或大整数 ID。例如当前的毫秒级时间戳 Date.now() 约为 $1.73 imes 10^12$,远超 21 亿。若在时间计算中随手写出 Date.now() | 0,程序将直接得到负数,引发灾难性 Bug。
3. 致命隐患二:静默吞噬 NaN 与 Infinity
根据 ToInt32 规范,如果输入值为 NaN、+Infinity、-Infinity 或 undefined,它会被一律强制返回为数字 0:
~~NaN;             // 输出: 0
~~Infinity;        // 输出: 0
undefined | 0;     // 输出: 0
这看似“容错好”,但在大型复杂系统架构中,这属于极其危险的静默吞噬。原本由于除以零、入参缺失产生的严重逻辑错误,被位运算悄悄粉饰成了正常数字 0,使得问题在上游被掩盖,最终在极深的数据链路中爆发。
4. 性能迷思:位运算在现代引擎中真的更快吗?
在十多年前的早期 JavaScript 引擎中,调用 Math.floor 存在一定的函数调用开销,而位运算符可以直接映射到 CPU 指令,因此存在可测量的微小差异。
但在现代 V8、JavaScriptCore 或 SpiderMonkey 引擎中,JIT 编译器(如 TurboFan)会将 Math.floor 和 Math.trunc 直接内联为底层的浮点截断或 SSE/AVX 汇编指令。现代测试表明,两者的执行性能差异已经完全可以忽略不计。盲目追求位运算不仅无法带来实质的性能飞跃,反而牺牲了代码的可读性、可维护性与数值安全性。
六、选型决策指南与代码实践
为了在项目开发中写出既语义清晰又稳健安全的代码,我们可以根据数据源形态与业务目标,遵循清晰的决策路径:
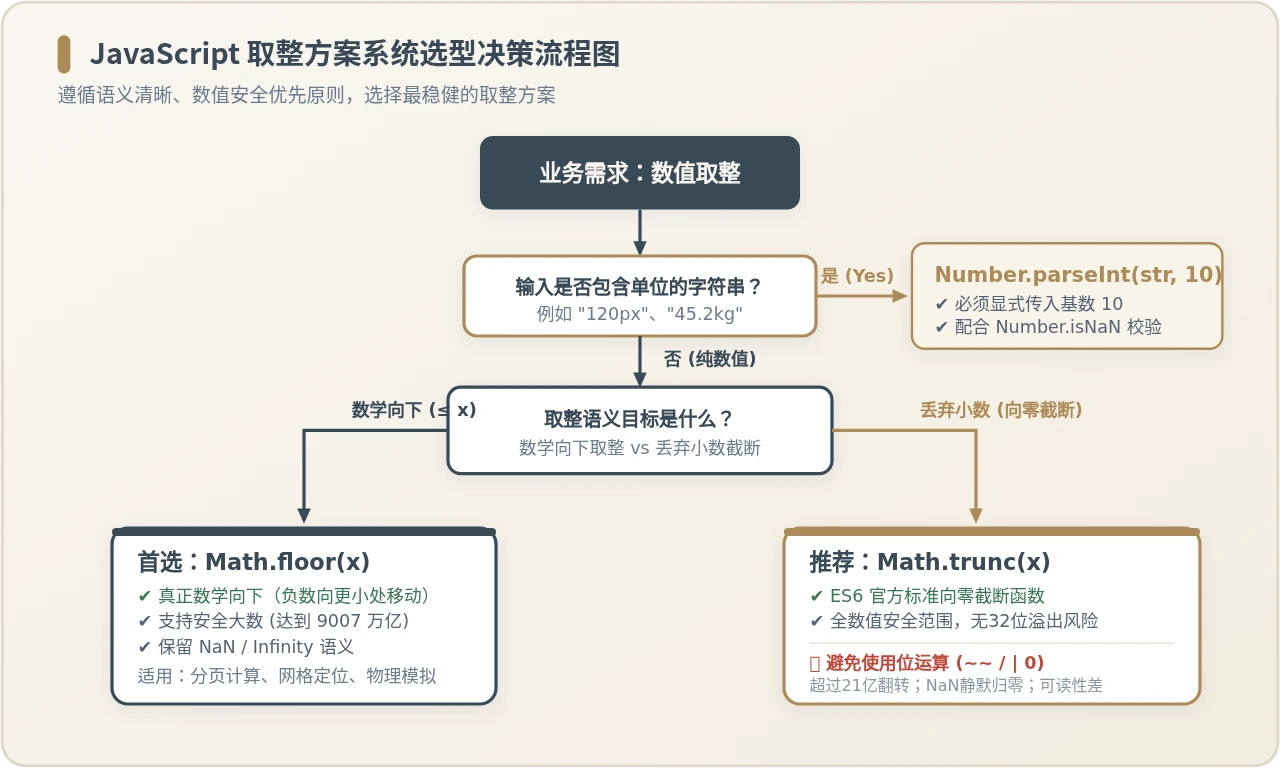
实战选型推荐准则:
-
需要纯数学向下取整时:首选
Math.floor(x)
适用于分页计算(如计算总页数对应位置)、游戏物理坐标网格对齐、负数度量区间计算。无论输入数值正负,都能保证数学递增的一致性。 -
需要直接抹掉小数位(向零截断)时:首选
Math.trunc(x)
ES6 引入的标准函数,明确表达“向零截断”的语义。支持完整的双精度安全整数区间(达到 9007 万亿),不存在 32 位溢出陷阱,语义明确且现代引擎性能极致。 -
输入数据是包含格式的字符串时:使用
Number.parseInt(str, 10)
用于解析类似"100px"、"42rem"等带有单位的字符串。请务必显式声明第二个参数radix = 10,并配合Number.isNaN()验证有效性。 -
在团队业务代码中,全面禁止使用
~~和| 0
除非是在极度受限的图形着色算法、像素缓冲区操作中,且完全确认数据处于 $[-2^31, 2^31-1]$ 范围内并配有详尽的注释;否则绝不应为了代码简写而引入不可预测的边界风险。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章