
全面讲解在原生JavaScript中获取和修改HTML元素内容的方法与最佳实践,对比querySelector与getElementById、textContent与innerHTML的机制差异,并提供详尽的安全防范与错误排查指南。

当前位置:首页 > JavaScript DOM 与事件 > 正文
JavaScript DOM操作基础:怎么获取和修改HTML元素内容
作者:像素漫游
时间:2026-11-02
浏览:212
文章目录
前端工程实践 · DOM核心API
1. 通过唯一 ID 精准获取:
2. 使用 CSS 选择器语法获取首个元素:
3. 批量获取匹配的所有元素:
1.
2.
3.
1. 报错
2. 为什么用
难度:基础入门
技术规范:W3C DOM Level 4
推荐运行环境:现代浏览器 / 原生 ECMAScript
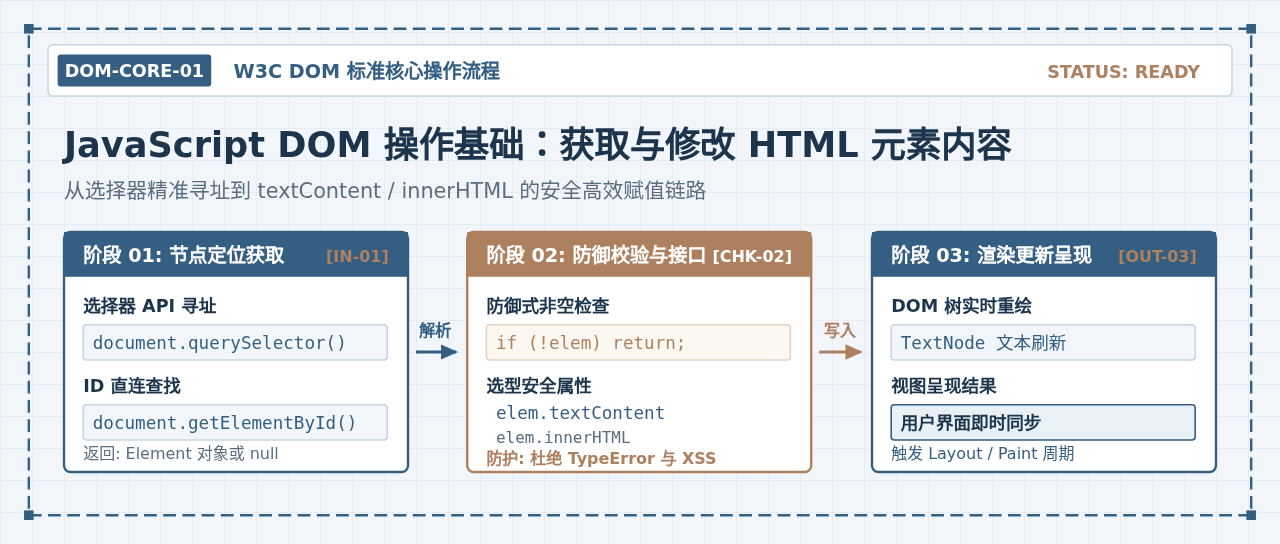
缩略图概览:JavaScript DOM 操作的标准流水线(从元素选择寻址到安全内容赋值呈现)
在 JavaScript 开发中,操作网页内容的核心机制是 DOM(文档对象模型)。要改变页面显示的内容,基本工作流分为两步:首先通过选择器定位并获取到目标 HTML 元素对象,然后通过元素对象的属性(如
textContent 或 innerHTML)读取或赋予新的值。本文将详细讲解原生 JavaScript 中定位元素的方法、修改内容属性的内部工作原理与关键差异,以及在实际开发中必须掌握的非空检查与安全防范。
一、理解 DOM 树与元素节点本质
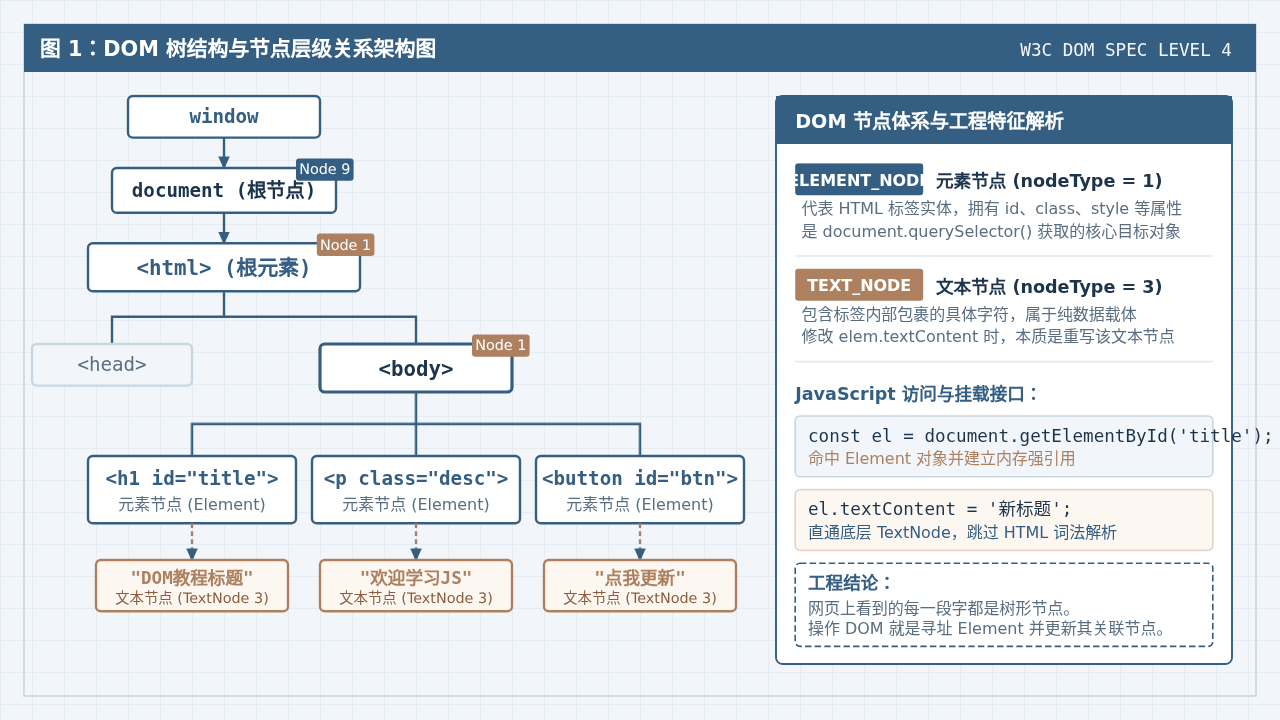
当浏览器加载 HTML 文档时,排版引擎会逐行解析标记代码,并在内存中构建一个树状对象模型,即 DOM 树(Document Object Model Tree)。在这个结构中,HTML 文档中的每个标签、属性和文字都被转换为不同类型的节点对象(Node)。
在日常开发中,我们绝大部分操作都是在与元素节点(Element Node)和文本节点(Text Node)打交道:
- 元素节点(nodeType = 1):对应 HTML 中的具体标签(例如
<div>、<p>、<h1>)。它拥有标签名、属性集合、样式对象以及组织下级子节点的能力。通过选择器 API 获取到的直接对象就是元素节点。 - 文本节点(nodeType = 3):对应包裹在标签内部的纯字符内容。文本节点位于 DOM 树的最末梢(叶子节点),没有子节点,也没有样式和属性。
图 1:DOM 树结构与节点层级架构图,直观展现从 document 根节点向下延伸到 Element 与 TextNode 的依附关系。
当我们在屏幕上看到某个标题或段落的内容改变时,在底层的内存模型中,实质上是 JavaScript 找到了对应的元素节点,并对其内部所维系的文本节点进行了重写或替换。
二、怎么在 JavaScript 中获取 HTML 元素
要修改任何元素的内容,第一步必须在 JavaScript 中建立指向该元素的引用。现代浏览器提供了成熟且高效的原生查询接口,开发者应根据场景需求选择合适的方法。
1. 通过唯一 ID 精准获取:document.getElementById()
如果目标 HTML 元素拥有唯一的 id 属性,使用 getElementById 是最高效的选择。浏览器在底层为 ID 维护了专用的哈希索引表,查询复杂度为 O(1)。
// 获取 ID 为 page-title 的元素
const titleElement = document.getElementById('page-title');

console.log(titleElement); // 成功命中时输出对应的 DOM 元素对象,未找到时输出 null
需要注意:参数字符串仅需传入 ID 名称本身,切勿添加 # 前缀。
2. 使用 CSS 选择器语法获取首个元素:document.querySelector()
querySelector 接收任何合法的 CSS 选择器字符串(如类选择器、属性选择器、层级后代选择器等),并返回文档中第一个匹配到的元素。其灵活性最高,适用于复杂的定位场景。
// 通过类选择器获取元素
const descElement = document.querySelector('.article-desc');

// 通过属性选择器获取
const submitBtn = document.querySelector('button[type="submit"]');

// 通过层级选择器获取
const firstLink = document.querySelector('.nav-list > li > a');
3. 批量获取匹配的所有元素:document.querySelectorAll()
当页面上存在多个相同类名或标签需要同时处理时,应使用 querySelectorAll。该方法返回一个静态的 NodeList 集合。
const allBadges = document.querySelectorAll('.status-badge');

// NodeList 原生支持 forEach 遍历
allBadges.forEach((badge, index) => {
  console.log(`第 ${index + 1} 个标签:`, badge);
});
⚠️ 必须养成的习惯:防御性非空检查
如果选择器书写错误,或者页面尚未完全渲染,查询方法将返回 null。如果直接访问 null.textContent,控制台会抛出致命错误:TypeError: Cannot set property 'textContent' of null,导致后续的所有脚本中断执行。
因此,在获取元素后,执行操作前必须先进行非空判断:
const target = document.querySelector('#user-status');
if (!target) {
  console.warn('未能找到 #user-status 元素,请检查 HTML 结构或加载时机!');
  return;
}
// 安全执行后续操作
target.textContent = '在线';
三、获取与修改内容的标准操作步骤
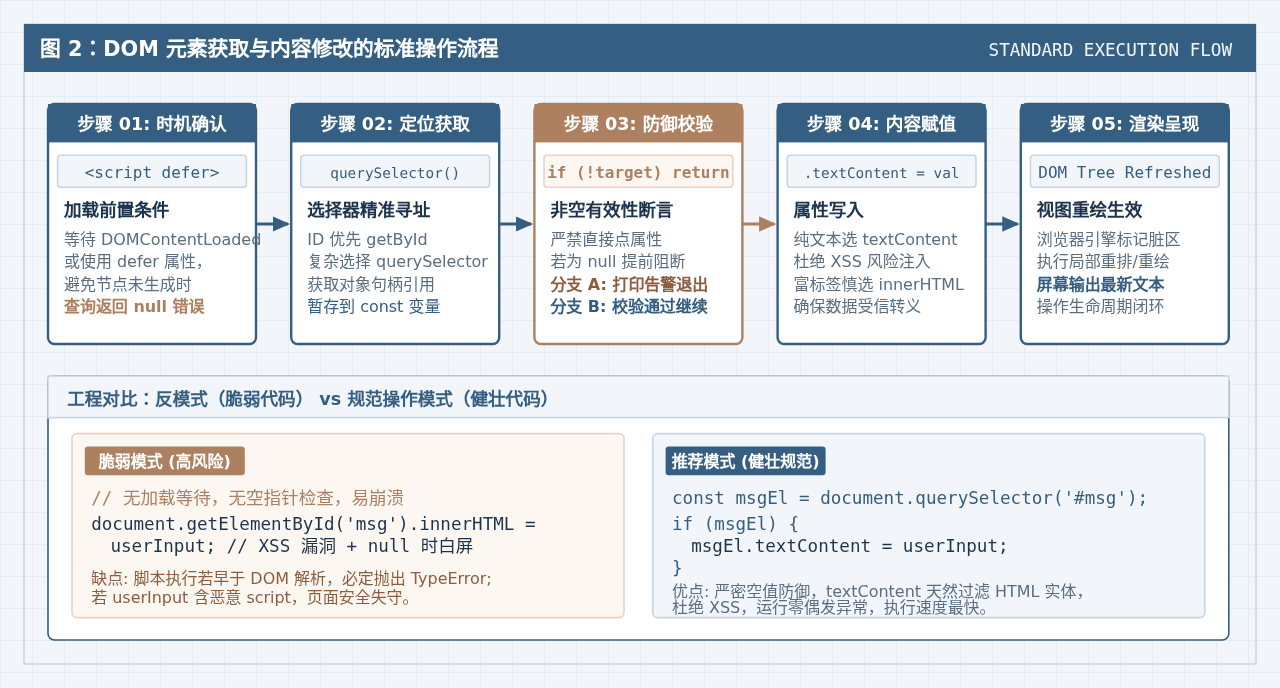
在实际工程项目中,规范的操作不仅仅是一行赋值语句,而是包含“时机确认、精准寻址、非空断言、执行变更、视图闭环”的完整周期。
图 2:DOM 元素获取与内容修改的标准操作流程,包含关键控制节点与健壮性对比。
-
确认脚本加载时机(Timing)
浏览器在解析 HTML 时是自上而下进行的。若将
<script>标签放置在<head>区域且未加任何属性,当 JavaScript 执行时下方的 DOM 树尚未构建,获取元素必定返回null。推荐方案:为
<script>标签添加defer属性,或者将脚本放在</body>标签正上方,确保 DOM 解析完毕后再执行代码。 -
选择最优 API 检索元素(Locating)
明确标识的单节点优先采用
getElementById;结构复杂的卡片或嵌套内容采用querySelector。尽量使用语义明确的 ID 或专用的类名作为查询钩子。 -
进行非空断言(Assertion)
通过简单的
if (element)条件分支进行拦截。在大型应用或模块化开发中,这一步能有效拦截 90% 以上的偶发性控制台报错。 -
根据数据特性选择属性赋值(Updating)
根据数据是“纯文本”还是“富 HTML 片段”,决定使用
textContent还是innerHTML。纯文本一律使用textContent。 -
验证界面渲染与控制台状态(Verification)
观察页面视觉更新情况,打开开发者工具(DevTools)确认无相关报错或多余的重排开销。
四、修改内容的核心属性:textContent、innerHTML 与 innerText 的深度对比
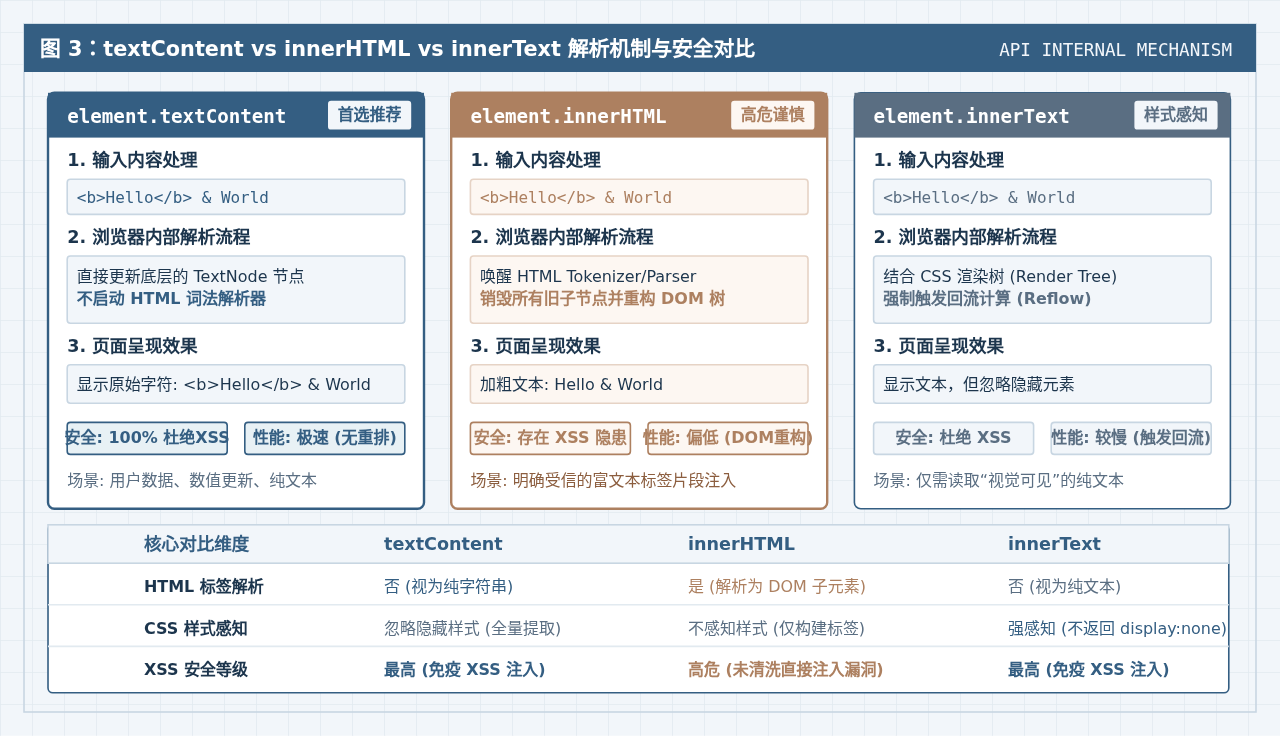
初学者常常困惑:textContent、innerHTML 和 innerText 都能改变页面上的文字,究竟该在什么场合选用哪一个?深入浏览器内核的解析流程,三者有着截然不同的底层机制。
图 3:textContent vs innerHTML vs innerText 机制对比图,展示文本直写、HTML 语法分析器调用及渲染树样式感知的区别。
1. element.textContent:纯文本读写(首选推荐)
textContent 属性表示节点及其后代的文本内容。它的核心特征如下:
- 直通文本节点:当给
textContent赋值时,浏览器直接将其视为纯文字字符串更新内部的 TextNode,完全不会启动 HTML 词法解析器。 - 免疫 XSS 攻击:即使字符串中包含
<script>alert(1)</script>或<img onerror=...>,浏览器也只会把它们当作无害的普通符号原样显示在页面上,天然杜绝跨站脚本攻击。 - 极佳的性能:无需分析标签层级,无需重建子 DOM 节点,执行效率极高。
2. element.innerHTML:HTML 代码片段解析与渲染(慎重使用)
innerHTML 允许以 HTML 字符串的形式读取或设置元素内部的所有子节点:
- 解析标签:写入
innerHTML = '<strong>重点</strong>'时,浏览器会唤醒 HTML 解析器,动态生成<strong>元素节点并挂载到树上,文字呈现加粗效果。 - 安全高危陷阱:绝对不能将未经过滤的用户输入(如表单填写内容、URL 参数)直接传入 innerHTML。恶意用户可以构造带有攻击代码的标签注入页面,造成凭据泄露等严重安全事故。
- DOM 重构损耗:赋值会彻底销毁旧的所有子节点并重新构建,原本在子元素上绑定的事件监听器会全部失效。
3. element.innerText:样式感知文本(特定场景使用)
innerText 表现出与页面视觉排版紧密耦合的特性:
- 感知 CSS 渲染:它依赖浏览器的渲染树(Render Tree)。如果某个子元素设置了
display: none,innerText读取时会忽略该元素,只返回眼睛看得见的文字。 - 性能损耗较高:由于要考虑样式和布局,读取或修改
innerText常常会强制触发浏览器的回流(Reflow/Layout),在复杂页面中频繁调用会导致掉帧。
| 对比维度 | textContent | innerHTML | innerText |
|---|---|---|---|
| 标签解析能力 | 否(全部当作纯文本) | 是(解析为真实 DOM 标签) | 否(全部当作纯文本) |
| CSS 样式感知 | 不感知(返回全部节点字符) | 不感知(返回完整 HTML 源码) | 强感知(忽略 display:none) |
| XSS 安全风险 | 完全免疫(安全首选) | 高危(拼接外部输入易受攻击) | 完全免疫(安全) |
| 内部开销 / 性能 | 极高(仅修改 TextNode) | 中等(重构子 DOM 树) | 偏低(触发浏览器回流重排) |
| 推荐使用场景 | 更新数字、状态、标题、正文等绝大多数纯文本内容 | 仅在需要动态注入受信富文本结构时使用 | 仅在需要获取用户实际视觉可见文本时使用 |
五、实战综合示例:构建安全的用户状态通知卡片
下面通过一个完整的、可运行的实战案例,演示如何将元素获取、非空检查、安全文本更新与动态标签样式切换结合在一起。
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>用户状态更新示例</title>
  <style>
    .card { width: 320px; padding: 20px; border: 1px solid #C8D6E2; border-radius: 6px; font-family: sans-serif; }
    .badge { display: inline-block; padding: 2px 8px; border-radius: 4px; font-size: 12px; }
    .badge-offline { background: #E2E8F0; color: #475569; }
    .badge-online { background: #DCFCE7; color: #166534; }
    .action-btn { margin-top: 15px; padding: 6px 12px; background: #345E82; color: #fff; border: none; border-radius: 4px; cursor: pointer; }
  </style>
</head>
<body>
  <div class="card">
    <h3 id="card-username">未登录访客</h3>
    <p>当前状态:<span id="status-tag" class="badge badge-offline">离线</span></p>
    <button id="refresh-btn" class="action-btn">登录并刷新数据</button>
  </div>

  <script>
    // 等待 DOM 准备完毕(通过放置在 body 底部天然保证)
    const refreshBtn = document.getElementById('refresh-btn');
    const usernameEl = document.getElementById('card-username');
    const statusTag = document.getElementById('status-tag');

    // 绑定点击事件监听器
    if (refreshBtn) {
      refreshBtn.addEventListener('click', () => {
        // 模拟从后端接口返回的用户数据(即使包含特殊符号也能安全处理)
        const mockUserData = {
          name: '<工程师小李> & "全栈团队"',
          isOnline: true
        };

        // 步骤 1: 防御性校验
        if (!usernameEl || !statusTag) {
          console.error('DOM 节点不存在,无法更新');
          return;
        }

        // 步骤 2: 使用 textContent 安全设置纯文本,无惧 HTML 特殊字符
        usernameEl.textContent = mockUserData.name;

        // 步骤 3: 依据逻辑更新状态与样式
        if (mockUserData.isOnline) {
          statusTag.textContent = '在线活跃';
          statusTag.className = 'badge badge-online';
        }
      });
    }
  </script>
</body>
</html>在这个示例中,mockUserData.name 包含了 <、> 和 & 等 HTML 保留字符。由于严格使用了 textContent 赋值,浏览器不会把它们当作标签解析,也不会破坏页面布局,完整体现了“数据呈现安全第一”的工程准则。
六、常见错误排查与避坑指南
1. 报错 TypeError: Cannot set properties of null
这是 DOM 操作中出现频率最高的错误。排查步骤如下:
- 检查脚本位置:确认
<script>是否放在了目标 HTML 标签的前面。如果是,请为脚本添加defer属性,或者将脚本移至</body>之前。 - 核对选择器拼写:使用
querySelector时是否遗漏了点号.(类名)或井号#(ID);使用getElementById时是否误加了#。 - 检查动态加载内容:若元素是由 Ajax 或 Vue/React 等框架异步渲染生成的,原生脚本在初始运行时该元素尚不存在,需要把操作挂载在数据渲染完成的回调函数中。
2. 为什么用 innerHTML += '...' 追加内容会导致点击事件失效?
许多开发者习惯使用 container.innerHTML += '<p>新项</p>' 追加列表项。然而,+= 本质上是:
// 底层等价于:
container.innerHTML = container.innerHTML + '<p>新项</p>';
这意味着容器内原有的所有 DOM 元素都会被全部销毁,再重新解析创建。原先子元素上通过 addEventListener 绑定的所有事件监听器都会随着旧节点的销毁而彻底丢失!
正确解法:追加子元素时,推荐使用 insertAdjacentHTML('beforeend', html) 或通过 document.createElement() 配合 appendChild(),这样不会触碰已经存在的兄弟节点及其事件。
七、核心总结与 API 选型速查
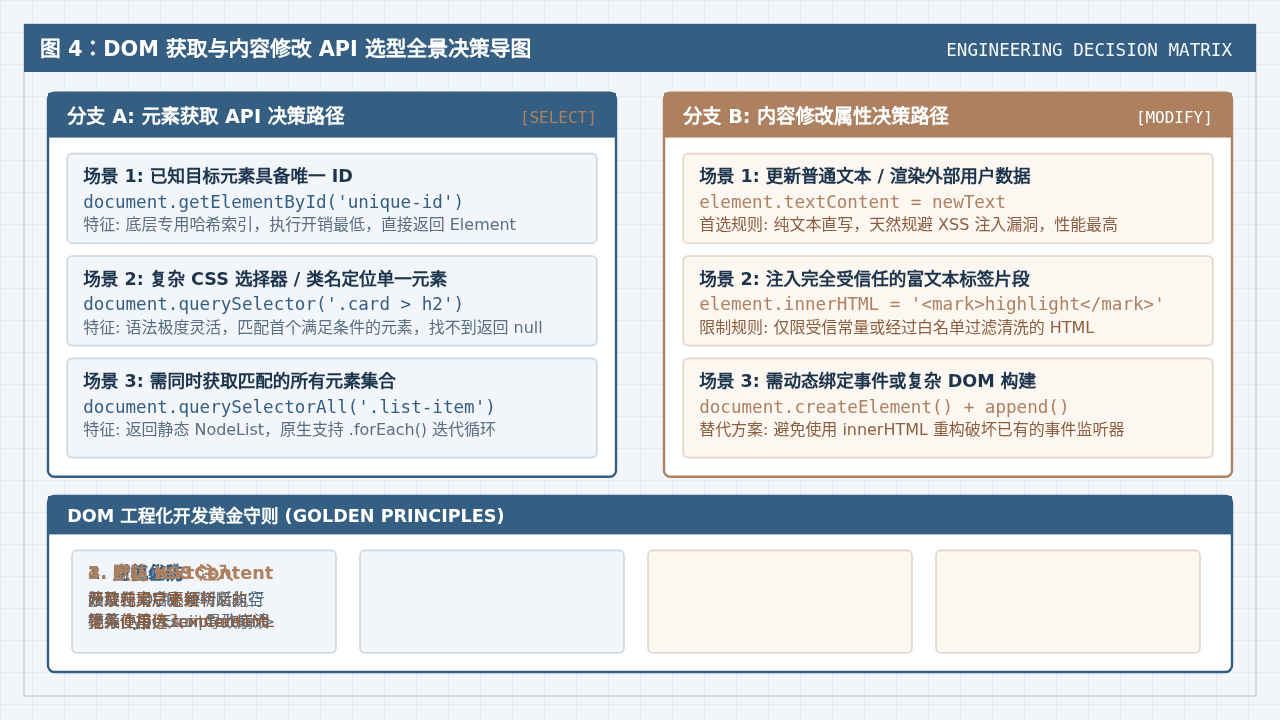
掌握 DOM 基础操作,核心在于掌握“选型匹配度”与“安全性控制”。牢记以下决策矩阵:
图 4:DOM 获取与修改 API 选型全景决策导图,提供从选择器定位到属性选型的全流程工程决策支持。
📌 关键要点速查口诀
- 查单个 ID:首选
getElementById('id'),速度快、语法纯粹。 - 查类与复杂选择器:使用
querySelector('.class'),通用灵活。 - 改普通文字:无条件首选
textContent = '内容',防注入、极速高效。 - 改富文本结构:在数据绝对受信任时选用
innerHTML,防范 XSS。 - 写健壮代码:拿完节点先判空,脚本加载加
defer。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章