
全面解析 JavaScript 中常见的各类空格字符及其 Unicode 编码,涵盖普通空格、制表符、不换行空格 NBSP、CJK全角空格、零宽空格 ZWSP 及 BOM 标记,深入剖析 ECMAScript 规范中 \s 与 trim() 的匹配边界,并提供安全检测与规范化清洗的工程方案。

当前位置:首页 > JavaScript 基础 > 正文
JavaScript中常见的空格字符有哪些及其Unicode编码
作者:像素猫
时间:2026-11-02
浏览:424
文章目录
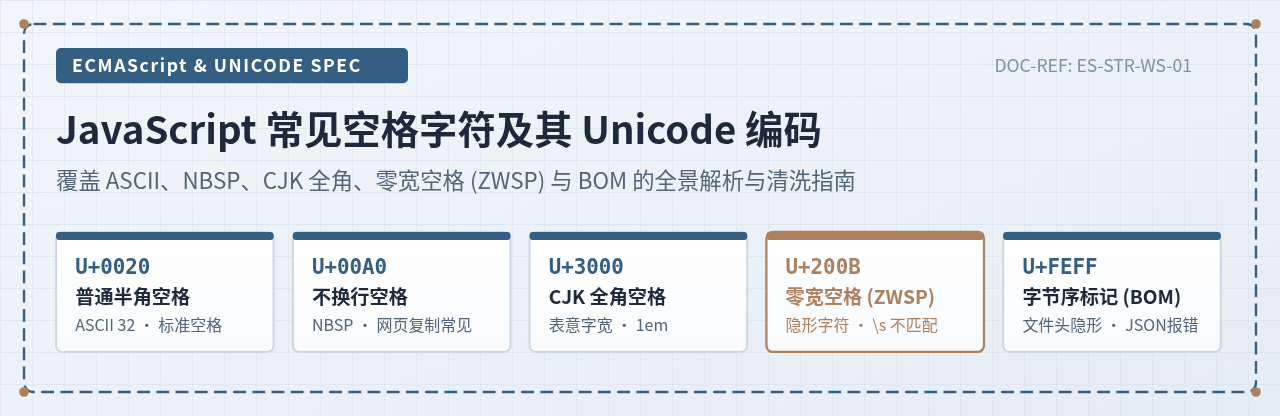
在 JavaScript 开发中,空格远不仅是敲击键盘 Space 键所产生的半角普通空格(
U+0020)。从网页富文本复制带来的不换行空格(U+00A0)、输入法全角模式下的 CJK 全角空格(U+3000),到肉眼完全无法辨识却会影响字符串长度的零宽空格(U+200B)与文件头 BOM(U+FEFF),它们在不同字符集、排版规范以及 ECMAScript 原生方法(如 \s 正则、trim())中的处理行为差异巨大。掌握这些空格字符的 Unicode 编码与特性,是解决字符串校验异常、Token 解析报错及数据清洗问题的关键前提。
一、常见空格字符一览:分类与 Unicode 码位速查
Unicode 字符集为了满足全球文字排版、控制格式和数据交换的需求,定义了数十种具有“空白”属性的字符。在前端与 Node.js 服务端开发中,最常遇到的空格可以归纳为五大核心类别:ASCII 基础空白、Latin-1 补充排版空格、CJK 表意文字空格、通用标点排版空格以及隐形控制符。
| 分类类别 | 字符名称 (英文缩写) | Unicode 码位 | 转义表示 | 主要用途与产生场景 |
|---|---|---|---|---|
| ASCII 基础空白 | 普通空格 (Space / SP) | U+0020 (32) |
\u0020 或 ' ' |
英文单词分隔、通用编程代码间隙 |
| ASCII 控制符 | 水平制表符 (Tab / HT) | U+0009 (9) |
\t 或 \u0009 |
代码缩进、表格对齐、TSV 文本分隔 |
| ASCII 控制符 | 换行符 (LF) / 回车符 (CR) | U+000A / U+000D |
\n / \r |
文本换行;Windows 为 CRLF,Unix 为 LF |
| Latin-1 补充 | 不换行空格 (NBSP) | U+00A0 (160) |
\u00A0 |
HTML 中 渲染结果,富文本复制高频引入 |
| CJK 专用符号 | 表意文字空格 (Ideographic Space) | U+3000 (12288) |
\u3000 |
中文/日文全角空格,占一个全角汉字宽度 (1em) |
| 通用排版标点 | 半角空格 (En Space) / 全角空格 (Em Space) | U+2002 / U+2003 |
\u2002 / \u2003 |
专业数字印刷排版,宽度分别为 0.5em 与 1em |
| 通用排版标点 | 细空格 (Thin Space) / 窄不换行空格 (NNBSP) | U+2009 / U+202F |
\u2009 / \u202F |
标点与数字间微距调整、千位分隔符 |
| 隐形格式控制 | 零宽空格 (Zero-Width Space / ZWSP) | U+200B (8203) |
\u200B |
不可见断行提示;常用于网页水印、隐形标记 |
| 隐形格式控制 | 字节顺序标记 (BOM / ZWNBSP) | U+FEFF (65279) |
\uFEFF |
UTF-8/UTF-16 文件头标识;极易导致 JSON 解析报错 |
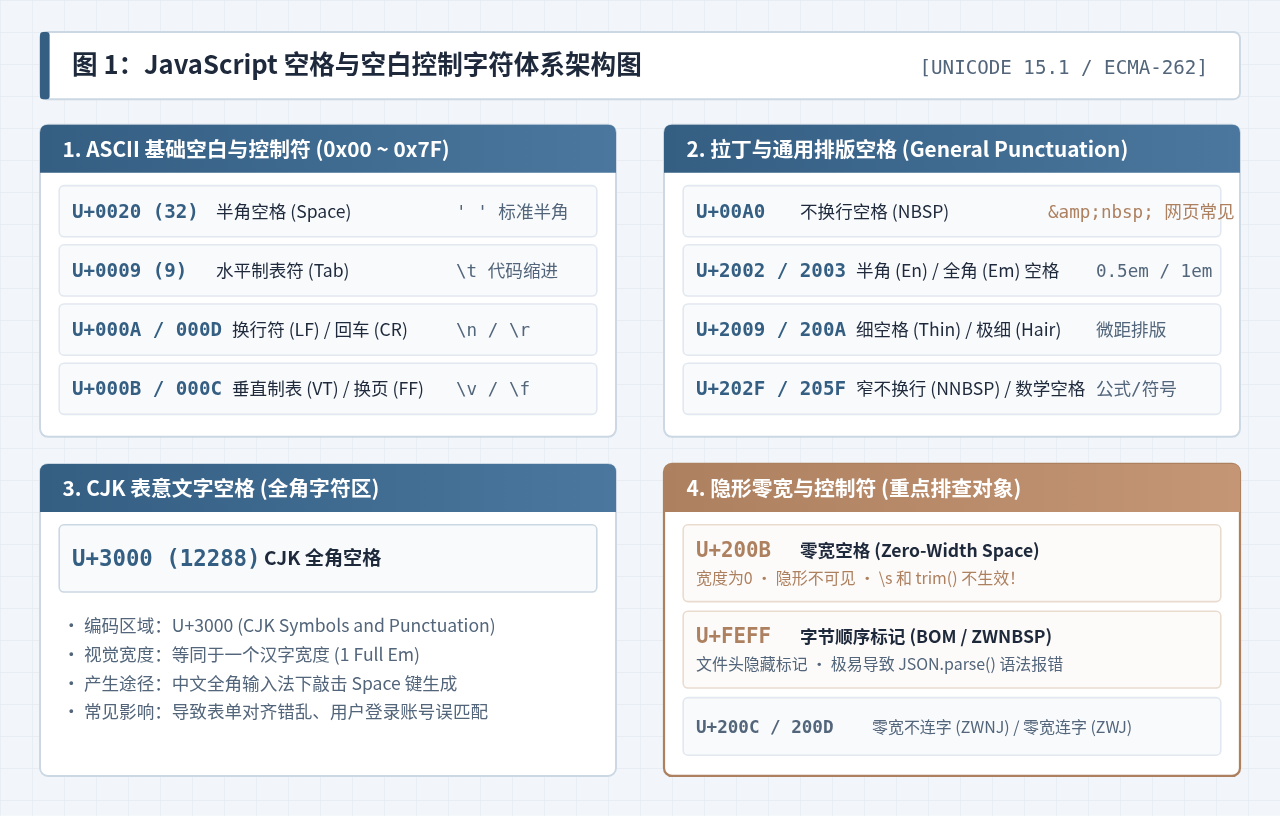
二、核心空格字符的特性与典型踩坑场景
1. 不换行空格 NBSP (U+00A0)
不换行空格源于 Latin-1 编码字符集,在 HTML 中对应实体 。它的设计初衷是在浏览器渲染换行排版时,防止特定短语(如单位符号与数字之间 100 km)在中间被断开。
然而在 JavaScript 中,U+00A0 与普通半角空格 U+0020 在内存中是完全不同的二进制表示。从浏览器网页、富文本编辑器(如 Word、Notion)复制包含 的代码或文本到编辑器或控制台时,经常会发生以下两种问题:
- 字符串比对不相等:用户输入看似相同的字符串,但由于其中夹杂了 NBSP,导致
'hello world' === 'hello world'的结果为false。 - 代码解析语法错误:在某些环境或早期的构建打包工具中,代码缩进或变量间的 NBSP 无法被解析为合法语法分隔符,从而抛出
SyntaxError: Invalid or unexpected token。
// 验证 NBSP 与普通空格的比对差异
const strA = "user name";       // 包含普通空格 U+0020
const strB = "user name";   // 包含不换行空格 U+00A0

console.log("视觉显示 A:", strA);
console.log("视觉显示 B:", strB);
console.log("全等比对结果:", strA === strB);
console.log("字符A码位:", strA.codePointAt(4).toString(16));
console.log("字符B码位:", strB.codePointAt(4).toString(16));
[示例输出 / Sample Output]
视觉显示 A: user name视觉显示 B: user name
全等比对结果: false
字符A码位: 20
字符B码位: a0
2. CJK 全角空格 (U+3000)
全角空格主要产生于中文、日文、韩文输入法环境下。当用户在中文全角输入状态下敲击空格键时,输入法会输出码位为 U+3000 的表意文字空格。它的显示宽度等于一个完整的汉字方块(1em),在中文文章排版中常用作段落首行缩进。
在用户注册、表单提交等业务场景中,用户在姓名前后或手机号中间可能无意敲入全角空格。如果不做规范化转换,直接入库会导致检索困难或短信接口发送失败。
3. 排版宽度空格系列 (U+2000 ~ U+200A)
这组字符由 Unicode 通用标点符号区定义,具有严格的印刷学宽度度量:
U+2002(En Space):半倍字宽,宽度为 0.5em;U+2003(Em Space):等倍字宽,宽度为 1.0em;U+2004~U+2006:分别对应三分之一字宽、四分之一字宽与六分之一字宽;U+2007(Figure Space):与等宽字体中阿拉伯数字等宽;U+2009(Thin Space) 与U+200A(Hair Space):细空格与发丝细空格,常用于公式符号与数字之间的紧凑微调。
三、“隐形刺客”:零宽空格 (ZWSP) 与 BOM 的机制与危害
高危排查重点:零宽空格(
U+200B)在视觉上完全透明,宽度为 0,并且它不属于 ECMAScript 规范的 WhiteSpace 类别,因此常规的 \s 正则与 trim() 函数均对其无效!
1. 零宽空格 ZWSP (U+200B)
零宽空格的原本用途是告知渲染引擎“此处可以换行,但不需要显示任何间距”。它广泛用于长 URL 换行或电子排版。近年来,它也常被用于添加不可见文本水印或防复制追踪。
当零宽空格被用户复制到登录表单、搜索框或订单号时,会造成极具迷惑性的 Bug:
- 视觉上看到的是
"admin",但"admin".length的结果却是6; - 后端数据库按字符串匹配查询不到该用户;
- 前端对输入框做非空校验
if (!username.trim())时,包含纯零宽空格的输入串无法被清空,校验被绕过。
2. 字节顺序标记 BOM (U+FEFF)
U+FEFF 早期被用作“零宽不换行空格”(Zero Width No-Break Space),但在 Unicode 规范演进中,它主要作为 UTF 编码的字节顺序标记(Byte Order Mark)。Windows 记事本等编辑器保存 UTF-8 文本时,常默认在文件最开始写入 3 个字节的 BOM 头(0xEF 0xBB 0xBF)。
在 Node.js 中使用 fs.readFileSync() 读取包含 BOM 的 JSON 配置文件时,由于文件起始位置带有不可见字符 ,执行 JSON.parse() 会直接抛出语法解析异常:
// 演示 BOM 字符引发 JSON 解析崩溃
const badJsonString = "{"status": 200}";

try {
  JSON.parse(badJsonString);
} catch (err) {
  console.log("解析失败报错信息:", err.message);
}
[示例输出 / Sample Output]
解析失败报错信息: Unexpected token '', "{"status": 200}" is not valid JSON
四、ECMAScript 规范中 \s 与 trim() 的匹配边界
许多开发者误以为 JavaScript 正则表达式中的 \s 元字符匹配所有看起来像空格或不可见的字符。实际上,ECMAScript 标准(ECMA-262)对空白符(WhiteSpace)与行终止符(LineTerminator)有非常严格的定义。
根据 ECMAScript 规范:
- WhiteSpace 集合明确包含:
U+0009(Tab)、U+000B(VT)、U+000C(FF)、U+0020(SP)、U+00A0(NBSP)、U+FEFF(BOM),以及 Unicode 通用类别为 Space_Separator (Zs) 的所有字符(包括U+2000~U+200A、U+202F、U+205F、U+3000)。 - LineTerminator 集合包含:
U+000A(LF)、U+000D(CR)、U+2028(行分隔符)、U+2029(段落分隔符)。 - 正则
\s的匹配范围:等价于 WhiteSpace + LineTerminator。 String.prototype.trim()的清洗范围:移除字符串首尾处符合 WhiteSpace 或 LineTerminator 定义的所有字符。
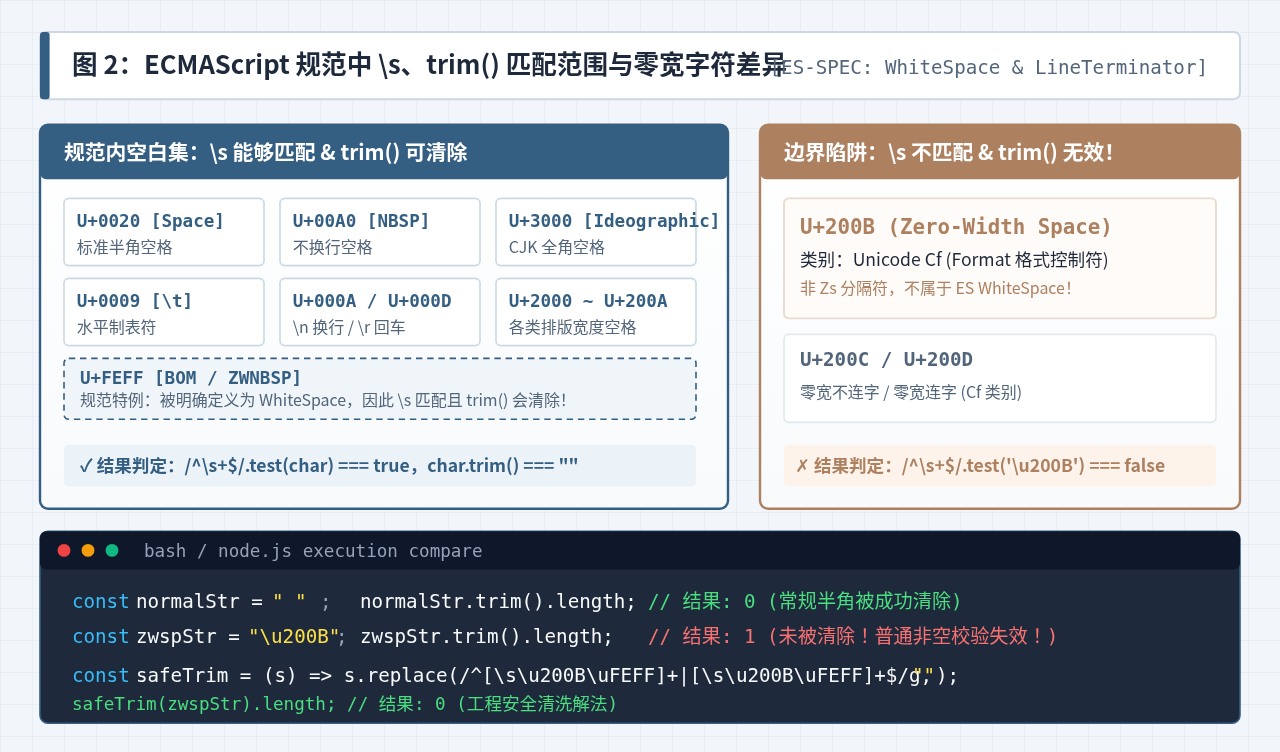
为什么
因为在 Unicode 规范中,零宽空格(
\s 与 trim() 漏掉了 U+200B?因为在 Unicode 规范中,零宽空格(
U+200B)被划分为 Format (Cf) 格式控制类别,而非 Space_Separator (Zs) 分隔符类别。ECMAScript 规范制定时并未将其列入 WhiteSpace。因此,/\s/.test('\u200B') 返回 false,并且 '\u200B'.trim() 原封不动返回 '\u200B'。
五、实战排查:在 JavaScript 中检测与识别隐形字符
当遇到接口参数比对不匹配、字符串长度超出预期或 JSON 解析报错时,不能仅凭控制台 console.log() 的字面打印进行判断。编写一个通用的字符码位诊断函数,是定位非常规空格与隐形字符的最直接手段。
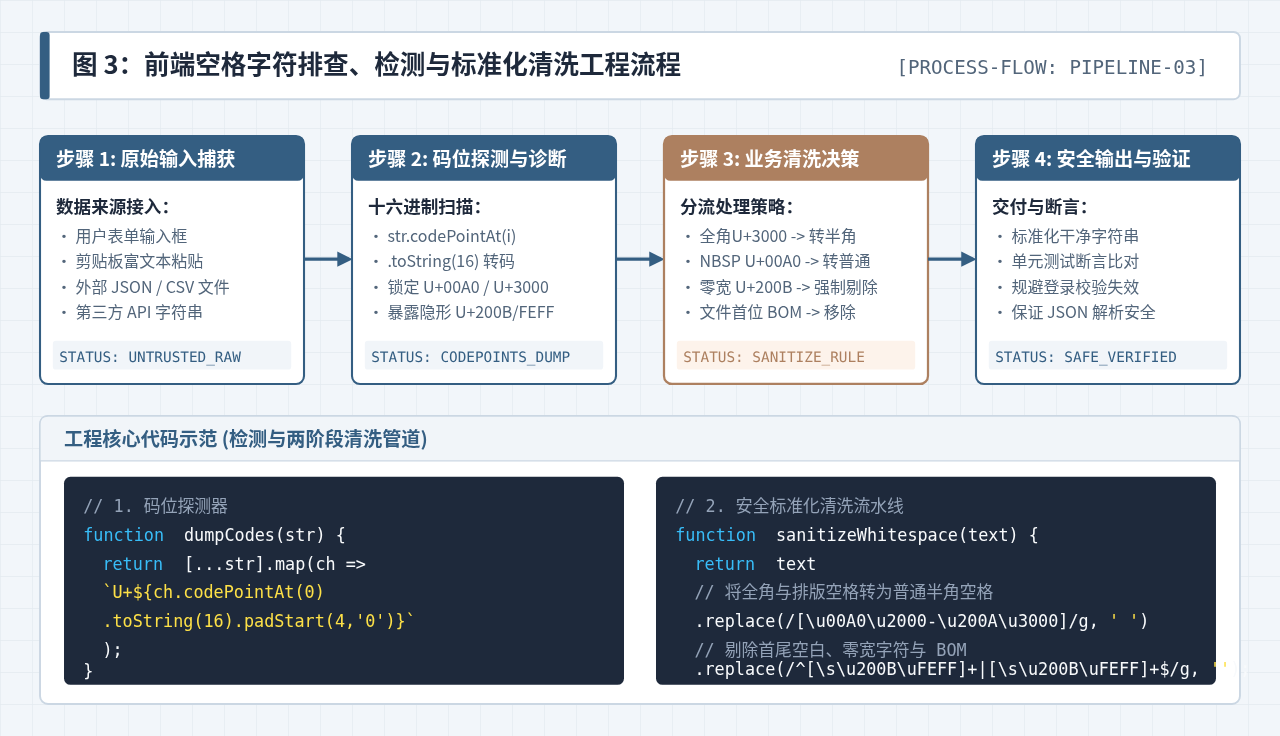
以下代码提供了一个用于诊断字符串真实字符组成的工程函数 inspectString(),它利用 codePointAt() 解析码位并以十六进制打印,能瞬间让隐藏在字符串中的各类空格与控制字符无所遁形:
/**
* 诊断字符串中的每一个字符及其 Unicode 码位
* @param {string} input 待诊断的字符串
*/
function inspectString(input) {
const details = [...input].map((char, index) => {
const codePoint = char.codePointAt(0);
const hex = "U+" + codePoint.toString(16).toUpperCase().padStart(4, "0");
let label = "常规字符";
if (codePoint === 0x0020) label = "普通空格 (Space)";
else if (codePoint === 0x00A0) label = "不换行空格 (NBSP)";
else if (codePoint === 0x3000) label = "CJK全角空格 (Ideographic)";
else if (codePoint === 0x200B) label = "零宽空格 (ZWSP - 隐形)";
else if (codePoint === 0xFEFF) label = "字节顺序标记 (BOM - 隐形)";
else if (codePoint >= 0x2000 && codePoint <= 0x200A) label = "排版宽度空格";
return { index, char: codePoint < 32 || codePoint === 0x200B || codePoint === 0xFEFF ? "不可见" : char, hex, label };
});
console.table(details);
}
// 诊断一个混入多种空格的复合字符串
inspectString("A B C DE");[控制台输出矩阵示例 / Console Output Sample]
┌───────┬────────┬────────┬─────────┬──────────────────────────┐│ index │ char │ hex │ label │
├───────┼────────┼────────┼─────────┼──────────────────────────┤
│ 0 │ 'A' │ U+0041 │ 常规字符 │
│ 1 │ ' ' │ U+0020 │ 普通空格 (Space) │
│ 2 │ 'B' │ U+0042 │ 常规字符 │
│ 3 │ ' ' │ U+00A0 │ 不换行空格 (NBSP) │
│ 4 │ 'C' │ U+0043 │ 常规字符 │
│ 5 │ ' ' │ U+3000 │ CJK全角空格 (Ideographic)│
│ 6 │ 'D' │ U+0044 │ 常规字符 │
│ 7 │ 不可见 │ U+200B │ 零宽空格 (ZWSP - 隐形) │
│ 8 │ 'E' │ U+0045 │ 常规字符 │
└───────┴────────┴────────┴─────────┴──────────────────────────┘
六、安全清洗方案与工程标准化实践
在实际项目中,针对空格的处理应当根据业务场景区分策略。常见的清洗需求包括:表单安全修剪(防绕过)、全角与特殊排版空格标准化为半角空格、以及从文件流中清除 BOM 标记。
1. 安全首尾修剪函数(替代原生 trim)
为了解决 U+200B(零宽空格)和 U+FEFF(BOM)绕过原生 trim() 的问题,表单录入或登录校验时推荐使用扩展正则:
/**
* 彻底清除字符串首尾的空白符,包括标准空白、零宽空格与 BOM
* @param {string} str
* @returns {string}
*/
function safeTrim(str) {
if (typeof str !== "string") return "";
// 匹配所有标准空白 \s 以及 U+200B (ZWSP)、U+FEFF (BOM)
return str.replace(/^[\s\u200B\uFEFF]+|[\s\u200B\uFEFF]+$/g, "");
}
const dirtyInput = " hello world ";
console.log("原生 trim 长度:", dirtyInput.trim().length); // 仍然残留
console.log("safeTrim 结果:", safeTrim(dirtyInput));
console.log("safeTrim 长度:", safeTrim(dirtyInput).length);[示例输出 / Sample Output]
原生 trim 长度: 13safeTrim 结果: hello world
safeTrim 长度: 11
2. 非常规空格标准化为普通半角空格
在全文检索、文本分析或自然语言处理中,通常希望把用户从各种富文本软件中粘贴带入的 NBSP、CJK 全角空格以及各类微排版空格统一转换为单一的标准 ASCII 空格 U+0020,并折叠连续空格:
/**
* 将所有类型的异构空格统一转换为单个半角 ASCII 空格
* @param {string} text
* @returns {string}
*/
function normalizeSpaces(text) {
if (!text) return "";
return text
// 1. 将不换行空格、全角空格、通用排版空格替换为 ASCII 半角空格
.replace(/[\u00A0\u1680\u2000-\u200A\u202F\u205F\u3000]/g, " ")
// 2. 彻底抹除零宽空格及隐形格式控制符 (U+200B ~ U+200D, U+FEFF)
.replace(/[\u200B-\u200D\uFEFF]/g, "")
// 3. 将连续的多个半角空格折叠为单个空格
.replace(/ +/g, " ")
// 4. 清除两端多余空格
.trim();
}
const rawPastedText = "中文 全角 与 排版空格";
console.log("标准化结果:", normalizeSpaces(rawPastedText));[示例输出 / Sample Output]
标准化结果: 中文 全角 与 排版空格
3. 现代正则:Unicode 属性转义匹配 \p{White_Space}
在 ES2018 及更高版本的 JavaScript 引擎中,可以通过启用 u(Unicode)标志并使用 Unicode 属性转义类 \p{...}。例如,\p{White_Space} 能够严格匹配 Unicode 规范定义的所有空白属性字符:
// 使用 Unicode 属性转义清洗标准空白
const unicodeText = "数据 清洗 测试";
const stripped = unicodeText.replace(/\p{White_Space}+/gu, "_");
console.log("Unicode 属性替换结果:", stripped);
[示例输出 / Sample Output]
Unicode 属性替换结果: 数据_清洗_测试
4. 移除文件首位 UTF-8 BOM 标记
针对 Node.js 后端在处理上传文件或读取本地 JSON 文件时的 BOM 隐患,应在解析前执行专用的剥离操作:
function stripBOM(content) {
  if (typeof content === "string" && content.charCodeAt(0) === 0xFEFF) {
    return content.slice(1);
  }
  return content;
}

// 安全读取并解析可能带 BOM 的 JSON 文本
function safeParseJSON(jsonString) {
  return JSON.parse(stripBOM(jsonString));
}
七、常见空格字符速查决策表与开发总结
为了便于在日常架构设计、代码评审和缺陷排查中快速查询与决策,下表与决策图汇总了核心空格字符的关键属性与推荐应对策略。
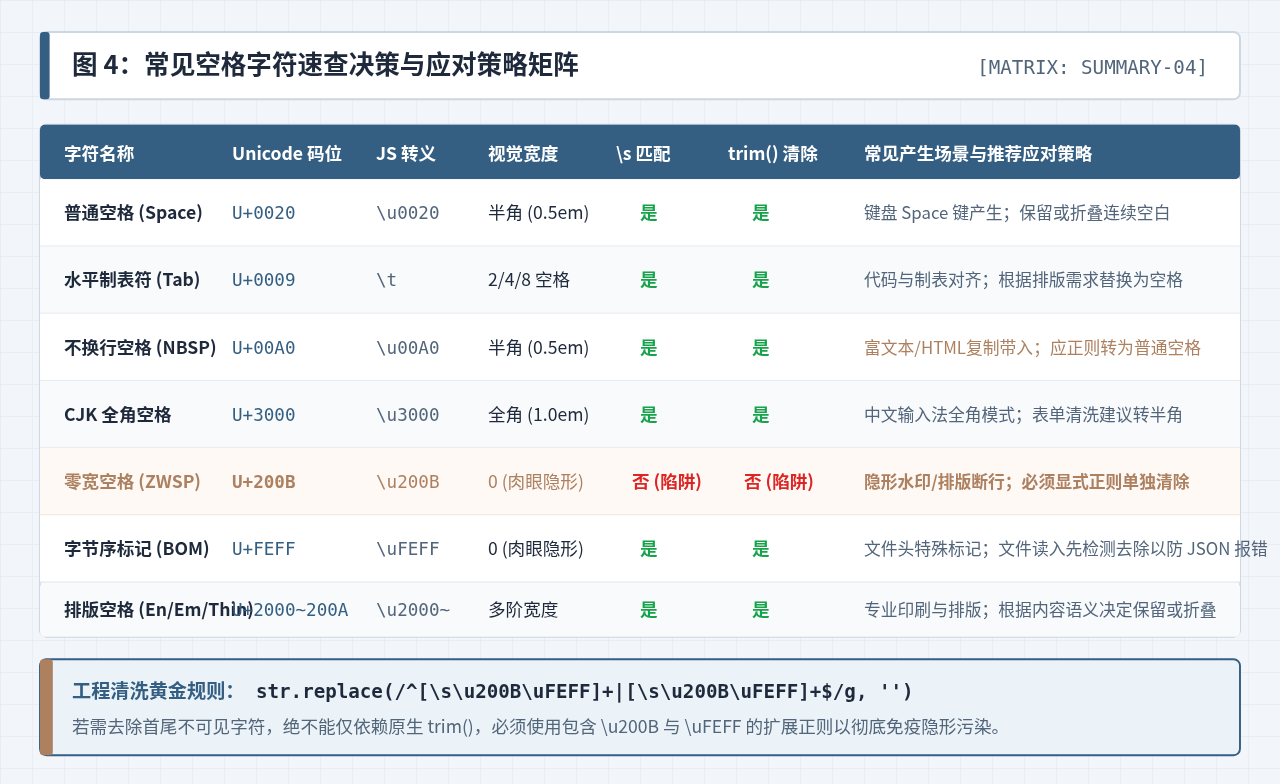
开发与维护守则总结
- 不要盲目信任视觉:页面上看起来一模一样的两个字符串,其内部可能隐藏着
U+00A0或U+200B。遇到任何离奇的比对失败或校验不通过时,第一步使用codePointAt()输出十六进制编码进行核对。 - 表单清洗防范零宽空格:原生
trim()无法去除U+200B。在用户注册、重要账号或唯一标识(如身份证号、卡号)的处理环节,采用/^[\s\u200B\uFEFF]+|[\s\u200B\uFEFF]+$/g进行强校验。 - 输入法全角空格需适配:在中文业务系统中,主动将
U+3000转为标准空格U+0020可以大幅提升用户体验,避免因输入法全角误触导致表单提交失败。 - 文件流解析预先去除 BOM:处理第三方导入的 CSV、JSON 文件时,务必先对文件首位可能存在的
U+FEFF进行过滤,防止底层解析器抛出不必要的语法异常。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章