
深入讲解如何使用 marked.js 官方提供的 Extensions API 扩展自定义 Markdown 语法。通过行内高亮标记与块级提示框两个完整实战案例,详解 tokenizer 词法分析、renderer 渲染、递归子解析与性能优化实践。

当前位置:首页 > JavaScript 项目实战 > 正文
通过 marked.js Extensions API 添加自定义 Markdown 语法解析
作者:木棉
时间:2026-11-02
浏览:400
文章目录
技术教程
Marked.js 官方规范
AST 编译与分词
阅读时长约 8 分钟
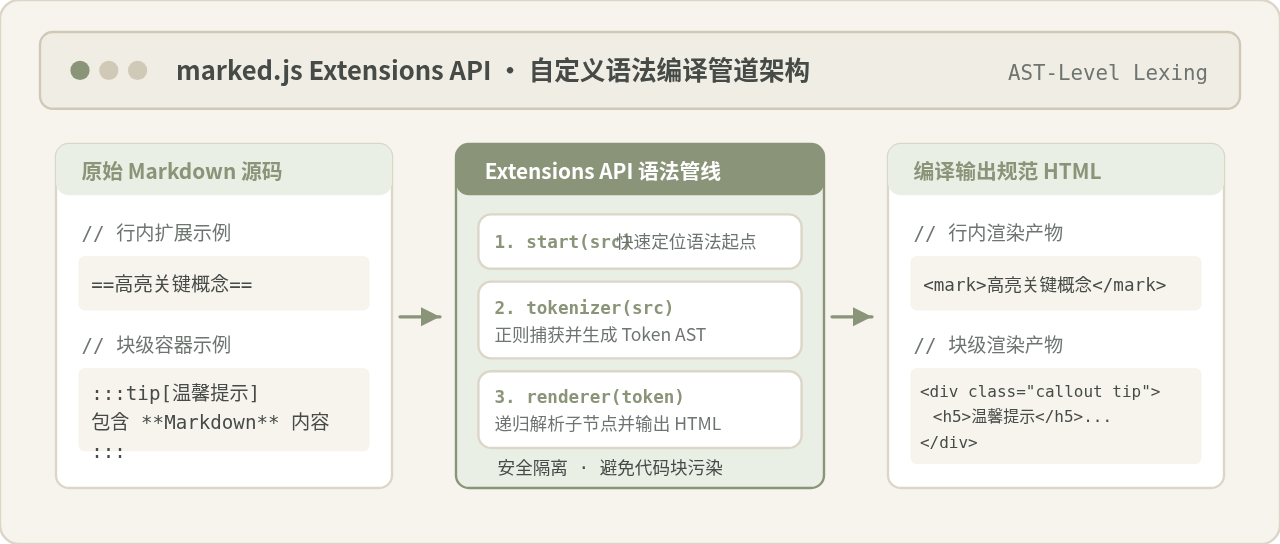
在文档系统、知识库与静态博客开发中,标准 Markdown 往往难以覆盖文本高亮(==text==)、自定义告警提示框(:::tip...:::)或数学公式等业务需求。marked.js 官方提供了 Extensions API,允许开发者以一等公民的身份介入编译器的词法分词(Tokenizer)与语法树渲染(Renderer)生命周期。本文将通过行内扩展与块级扩展两个完整可运行案例,系统梳理扩展的注册规格、子语法递归解析机制与避坑要点,帮助你在不污染代码块与核心解析逻辑的前提下,构建健壮的自定义 Markdown 语法。
一、为什么需要 Extensions API 而非字符串正则替换
在遇到自定义语法需求时,不少初学者最直观的想法往往是:“既然 Markdown 最终编译为 HTML,那在 marked 解析前直接跑一遍正则把自定义标记替换为 HTML 标签,或者在解析完成后再替换一遍不就行了吗?”
这种基于纯字符串正则替换的“预处理 / 后处理”思路在极度单一的孤立文本段落中确实能起效,比如将简单的独立行内 @username 替换成链接。但在完整的技术文档或包含复合格式的 Markdown 文档中,盲目的正则替换会引发严重的副作用:
- 破坏代码块与行内反引号:如果文档中的代码块(
```js)或行内代码(`...`)刚好包含了形如==text==或:::的字符,预处理正则会强行将其替换为 HTML 标签,导致展示给读者的代码示例被破坏。 - 破坏 Markdown 转义机制:标准 Markdown 支持反斜杠转义(如
\==不是高亮\==)。正则预处理通常无法感知转义上下文,会将应当原样显示的字符强行转为标签。 - 无法进行子语法递归解析:如果自定义块级容器内部包含了常规的 Markdown 粗体、列表或链接,预处理只能把外层替换为
<div>,而内层文本一旦混入标准 Markdown 解析流,极易导致段落闭合错误或标签逃逸。 - XSS 与安全性失控:无视 AST 语境的字符串拼接容易导致未闭合标签或恶意代码注入,无法借助 Markdown 编译管线的安全防护。
marked.js 的 Extensions API 正是为了解决这些矛盾而设计的。它将自定义语法无缝集成到 marked 的标准词法扫描器中。当扫描器遍历字符流遇到代码块时,会自动跳过你的自定义规则;而当遇到自定义语法时,又能结构化地生成 Token,并调用子解析器递归处理内部标记。
二、Extensions API 的核心结构与生命周期
通过 Extensions API 自定义语法时,我们向 marked.use({ extensions: [...] }) 注册的是一个包含固定钩子函数的配置对象。该对象定义了从“探测字符”到“消费分词”再到“输出 HTML”的完整契约。
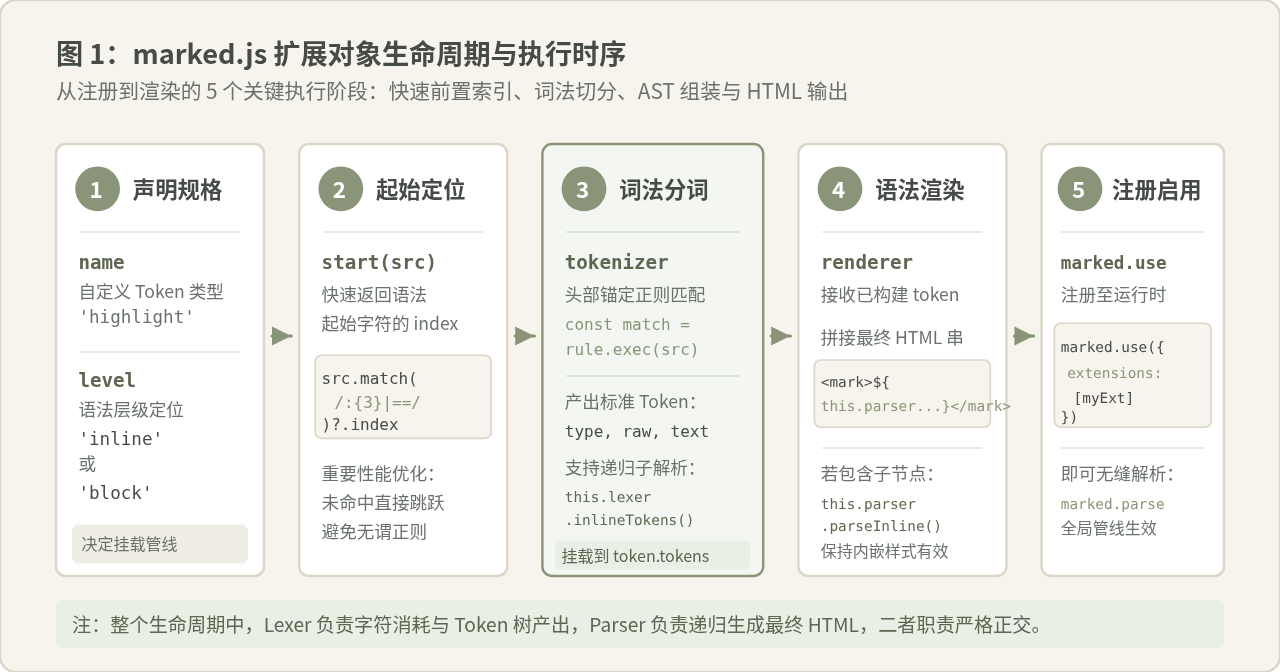
一个标准的扩展配置对象通常包含以下 6 个核心属性:
name(String, 必填):自定义 Token 的唯一类型名称。例如'highlight'或'callout'。Marked 会将其作为token.type存储在语法树中。level(String, 必填):决定语法挂载的处理管线。只有两个可选值:'inline'(行内级别,如强调、文字着色)或'block'(块级别,如段落、标题、容器块)。start(src)(Function, 可选但强烈建议配置):接收当前未扫描的源字符串src,返回可能触发该语法的字符在src中的第一个索引下标。Marked 用它跳过不匹配的文本,极大减轻主解析循环的正则执行压力。tokenizer(src, tokens)(Function, 必填):词法分词器。当解析位置到达潜在起始点时调用。如果成功匹配,必须返回一个标准 Token 对象(包含type、raw及自定义字段);若不匹配,则返回undefined。注意:正则必须以^锚定开头。renderer(token)(Function, 必填):语法渲染器。接收当前 Token 对象,返回编译后的 HTML 字符串。对于包含嵌套语法的 Token,可以在这里调用解析器递归输出子 HTML。childTokens(Array<String>, 可选):指定当前 Token 中包含子 Token 数组的属性名称(如['tokens']),便于第三方插件或walkTokens钩子深层遍历 AST。
三、实战一:开发行内扩展(实现高亮标记 ==text==)
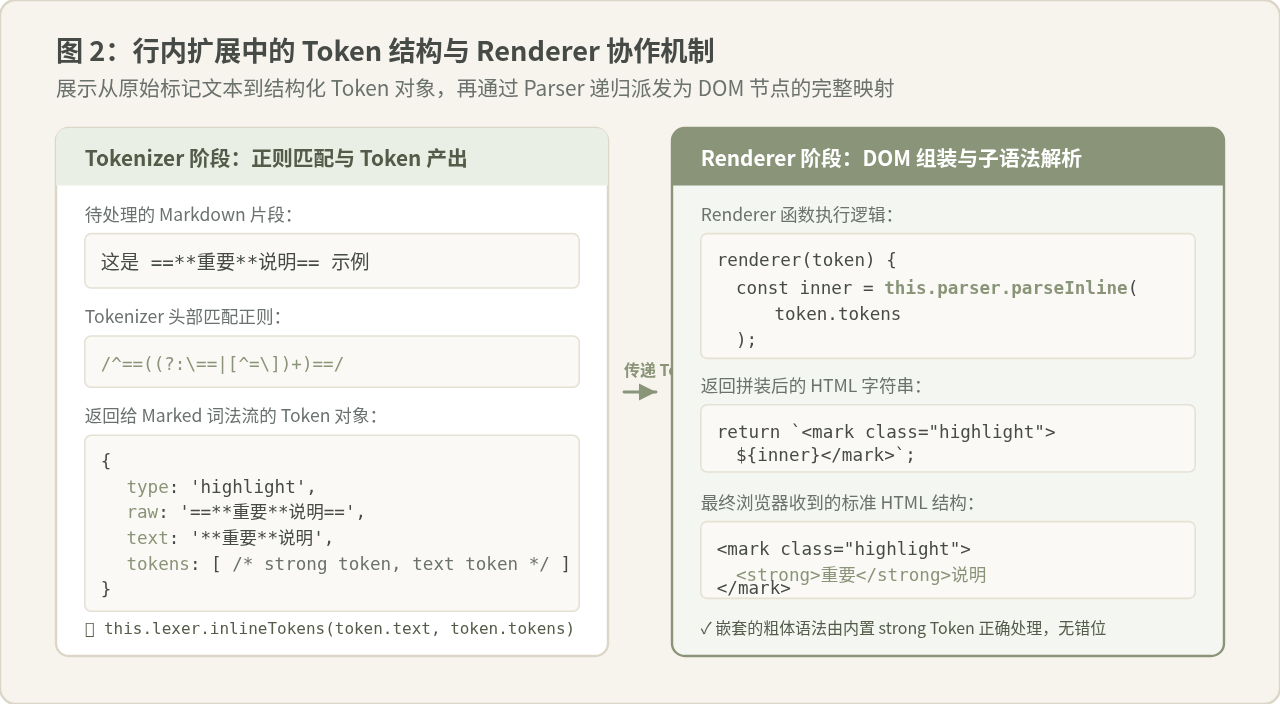
现在通过一个具体需求落地第一个扩展:支持 Obsidian 与 Typora 常用的双等号高亮语法 ==高亮内容==,将其编译为带有特定样式的 <mark class="marked-highlight">高亮内容</mark>。并且要求:高亮内部支持常规的行内格式,如 ==**重要加粗内容**==。
1. 编写扩展定义
我们需要创建 highlightExtension 对象,指明 level: 'inline',并通过 this.lexer.inlineTokens 实现子语法向下递归分词:
const highlightExtension = {
  name: 'highlight',
  level: 'inline',

  // 1. start 钩子:快速定位第一个 '==' 出现的索引位置
  start(src) {
    return src.indexOf('==');
  },

  // 2. tokenizer 钩子:消费字符串并构建 Token
  tokenizer(src, tokens) {
    // 头部锚定正则:匹配 ==内容==,支持转义等号
    const rule = /^==((?:\==|[^=\])+)==/;
    const match = rule.exec(src);

    if (match) {
      const token = {
        type: 'highlight',
        raw: match[0],           // 消费的完整原始字符串,如 "==文本=="
        text: match[1].trim(),   // 提取的纯文本内容
        tokens: []               // 存放内嵌子语法的 Token 数组
      };

      // 递归调用 Marked 内置 Lexer 解析内部的行内 Markdown(如加粗、斜体等)
      this.lexer.inlineTokens(token.text, token.tokens);

      return token;
    }
  },

  // 3. renderer 钩子:将 Token 转换为 HTML
  renderer(token) {
    // 递归调用 Parser 将子 Token 解析为内嵌 HTML
    const innerContent = this.parser.parseInline(token.tokens);
    return `<mark class="marked-highlight">${innerContent}</mark>`;
  }
};
2. 注册并验证运行效果
使用 marked.use 注册该扩展后,直接调用 marked.parse 即可生效:
import { marked } from 'marked';

// 注册扩展
marked.use({
  extensions: [highlightExtension]
});

// 输入包含代码块与转义符号的复合 Markdown
const markdownSource = `
这是一段普通文本,其中包含 ==高亮并且带 **粗体** 的核心概念==。

代码块中的语法不会被错误破坏:
\`\`\`javascript
const test = "==这里保留原样==";
\`\`\`
`;

const htmlOutput = marked.parse(markdownSource);
console.log(htmlOutput);
输入 Markdown
包含 ==高亮并且带 **粗体**==`==代码内不解析==`
实际输出 HTML (示例)
<p>包含 <mark class="marked-highlight">高亮并且带 <strong>粗体</strong></mark></p><p><code>==代码内不解析==</code></p>
四、实战二:开发块级扩展(实现 Callout 提示框)
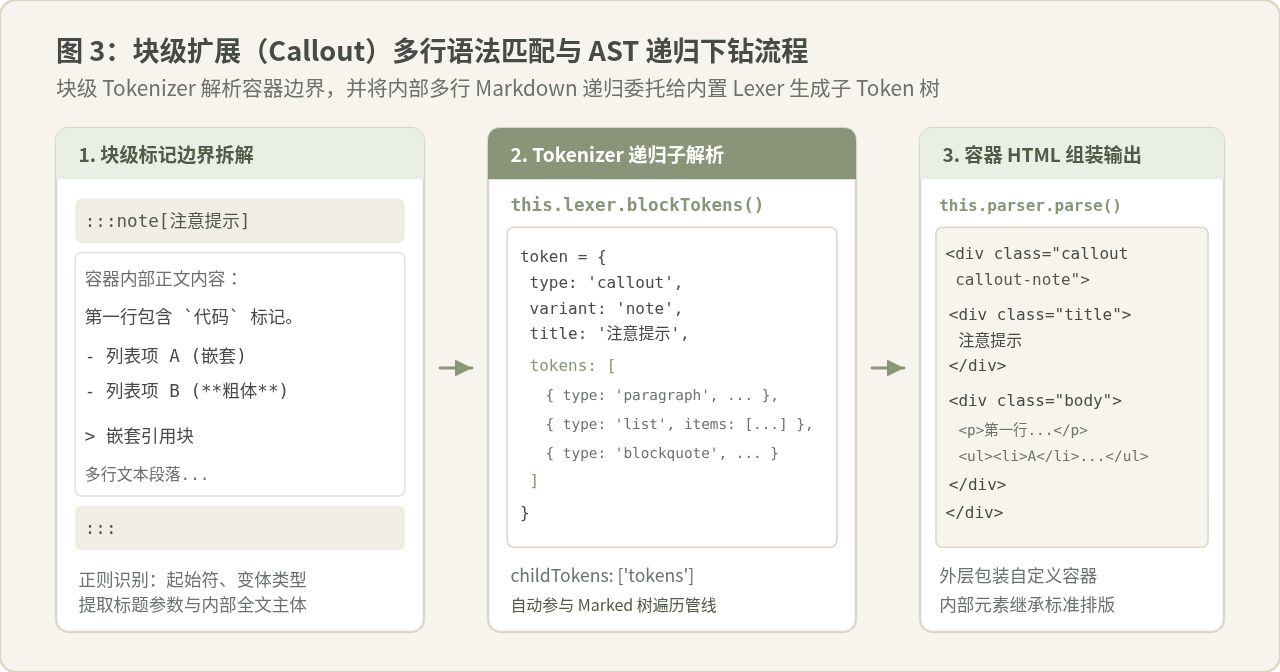
相较于行内扩展,块级扩展(level: 'block')往往需要跨越多行文本,并且容器内部可能包含段落、列表、代码块甚至嵌套引用。下面我们实现许多现代文档框架常用的 :::tip[标题] 容器语法。
1. 编写块级扩展定义
实现块级语法的关键在于:正则需要捕获起始行标记、闭合行标记以及两者之间的多行主体;分词阶段通过 this.lexer.blockTokens 递归处理内部段落;渲染阶段通过 this.parser.parse 输出复合节点。
const calloutExtension = {
  name: 'callout',
  level: 'block',

  // 1. 快速探测起始位置:寻找以 ':::' 开头的可能行
  start(src) {
    return src.match(/^:::/m)?.index;
  },

  // 2. 块级词法解析器
  tokenizer(src, tokens) {
    // 匹配形如::::tip[可选标题]
内部多行内容
:::
    const rule = /^:::([a-z]+)(?:\[(.*?)\])?
([\s\S]*?)
:::(?:
|$)/;
    const match = rule.exec(src);

    if (match) {
      const variant = match[1].toLowerCase(); // 如 tip, warning, note
      const title = match[2] ? match[2].trim() : '';
      const bodyContent = match[3];

      const token = {
        type: 'callout',
        raw: match[0],
        variant: variant,
        title: title,
        tokens: []
      };

      // 重点:调用 blockTokens 解析容器内部的所有块级元素(列表、段落、代码块等)
      this.lexer.blockTokens(bodyContent, token.tokens);

      return token;
    }
  },

  // 3. 块级 HTML 结构渲染
  renderer(token) {
    // 递归编译容器内部的子 AST 为完整 HTML
    const innerHtml = this.parser.parse(token.tokens);

    // 拼装标题结构(如果有标题)
    const titleHtml = token.title
      ? `<div class="callout-header"><span class="callout-title">${token.title}</span></div>`
      : '';

    return `<section class="callout-container callout-${token.variant}">
  ${titleHtml}
  <div class="callout-body">${innerHtml}</div>
</section>
`;
  },

  // 4. 声明子节点属性,方便遍历 AST
  childTokens: ['tokens']
};
2. 运行验证多层嵌套场景
测试一段包含多行正文、代码块与无序列表的 Callout 输入:
marked.use({ extensions: [calloutExtension] });

const sample = `
:::tip[生产部署安全建议]
请在正式发布前核实以下配置清单:
- 关闭调试模式与详细堆栈输出
- 检查密钥环境依赖注入
:::
`;

console.log(marked.parse(sample));
由于我们使用了 this.lexer.blockTokens,列表语法会被自动交给 Marked 内置的 List 分词器解析,渲染器得到的 innerHtml 会包含标准的 <p> 和 <ul><li> 标签,完全保持了 Markdown 原生特性的连贯性。
五、关键细节与避坑指南
在开发 marked.js 扩展的过程中,由于解析器内部是基于字符指针逐段切分(chunk-based slicing)的,有几个极其容易犯错的技术细节需要特别注意:
1. Tokenizer 内部的正则必须以 ^ 锚定开头
传递给 tokenizer(src) 的参数 src,是当前解析轮次尚未消费的剩余字符串。Marked 期望你的分词器只匹配当前游标最头部的内容。如果不加 ^(例如写成了 /==(.*?)==/),正则会匹配到文本深处的后续内容,导致指针未前进、字符被重复截取,最终引发浏览器主线程卡死或无限循环。
2. start(src) 的索引计算规则与兜底策略
start(src) 是一个加速器。如果定义了 start,Marked 会先将源字符串指针快速前进到 start 返回的位置,再调用 tokenizer。
- 切勿返回过大的索引:如果
start返回的位置跳过了语法的真实起点,该语法将永远不会被解析。 - 未匹配时必须返回 undefined 或 -1:当当前文本片段不包含该语法时,不能返回 0。
- 复杂语法宁缺毋滥:如果你的语法起始条件极其复杂,难以用简单
indexOf或轻量正则定位,可以不写 start 方法。不写 start 只会退回到常规逐字符探测,性能略有损耗但绝对不会漏掉匹配。
3. 纯文本渲染时的 XSS 转义防御
如果你的自定义语法内部不调用 this.lexer.inlineTokens(例如纯数学公式 $E=mc^2$ 或占位符),在 renderer 拼接 HTML 时,必须手动对 token.text 进行 HTML 转义(将 <、>、& 等替换为字符实体),防止读者输入的文本被浏览器直接作为 DOM 执行。
六、全文总结与开发决策清单
通过 marked.js Extensions API 扩展语法,本质上是在 AST 词法分析与 HTML 生成阶段建立了一套声明式的契约。比起脆弱的全局正则文本替换,Extensions API 保证了语法的结构隔离与上下文安全。
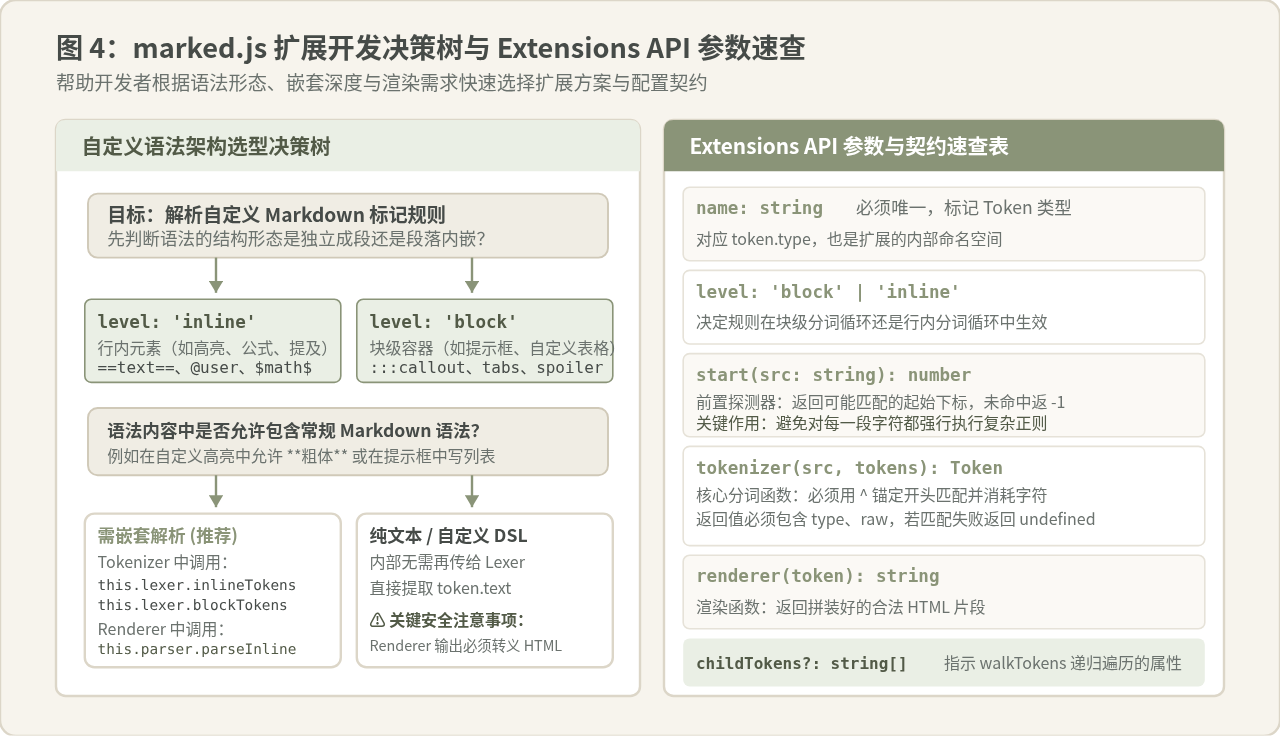
在设计任何自定义 Markdown 语法前,可以按照以下三个步骤做出决策:
- 形态判定:行内修饰选择
level: 'inline';跨行容器或段落结构选择level: 'block'。 - 递归判定:如果自定义内容里需要支持粗体、链接或列表等原生语法,分词阶段务必通过
this.lexer.inlineTokens或this.lexer.blockTokens生成子树,并在渲染阶段通过this.parser递归回放。 - 性能与安全核验:为扩展配置准确的
start钩子提升运行效率;确保分词正则带有^前缀;未进行递归解析的纯文本在renderer中做好 HTML 转义。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章