
深入解析文档对象模型(DOM)的本质、树状层次结构、核心节点类型与浏览器的解析机制,结合JavaScript操作DOM的实际步骤与关键避坑要点,帮助初学者建立扎实的前端交互基础。

当前位置:首页 > JavaScript DOM 与事件 > 正文
JavaScript DOM基础:什么是文档对象模型及核心概念
作者:流萤
时间:2026-10-30
浏览:383
文章目录
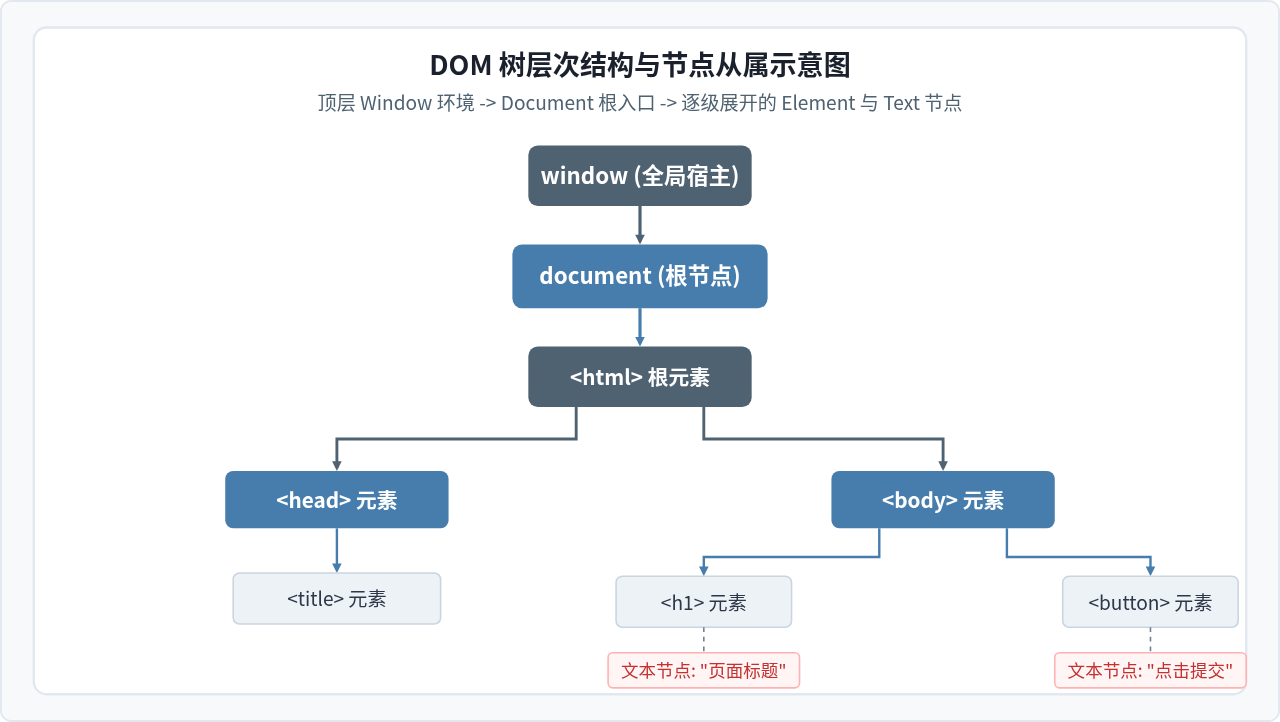
文档对象模型(Document Object Model,简称 DOM)是浏览器为 HTML 文档建立的标准编程接口。当我们在浏览器中打开一个网页时,浏览器并不是把一段纯文本代码直接展示给用户,而是先将 HTML 标签解析成由可编程对象组成的层次树状结构。通过这个对象模型,JavaScript 获得了访问、增加、修改和删除页面内容、结构与样式的完整能力,从而将静止的文档转变成具有交互能力的动态网页。
一、什么是文档对象模型:从 HTML 文本到内存对象
很多初学者在编写 HTML 时,习惯于将网页视为标签的平铺堆叠。例如在编辑器中写下一个 <button> 标签,它在硬盘文件里只是一串 ASCII 或 UTF-8 字符。但对网页引擎而言,必须把这行文本转换成内存中可寻址、可交互的实体对象,DOM 充当的正是这一桥梁。
需要明确的是,DOM 并不是 ECMAScript 语法规范本身的一部分,而是由 W3C 制定、各浏览器厂商遵循实现的 Web API。JavaScript 作为一门脚本语言,其核心语法只定义了变量、函数、循环和基础数据类型等规范;当它运行在浏览器宿主环境中时,浏览器将代表当前网页文档的全局宿主对象 document 暴露给 JavaScript,开发者才得以通过标准的属性和方法去操控页面。
二、浏览器构建 DOM 的四个核心阶段
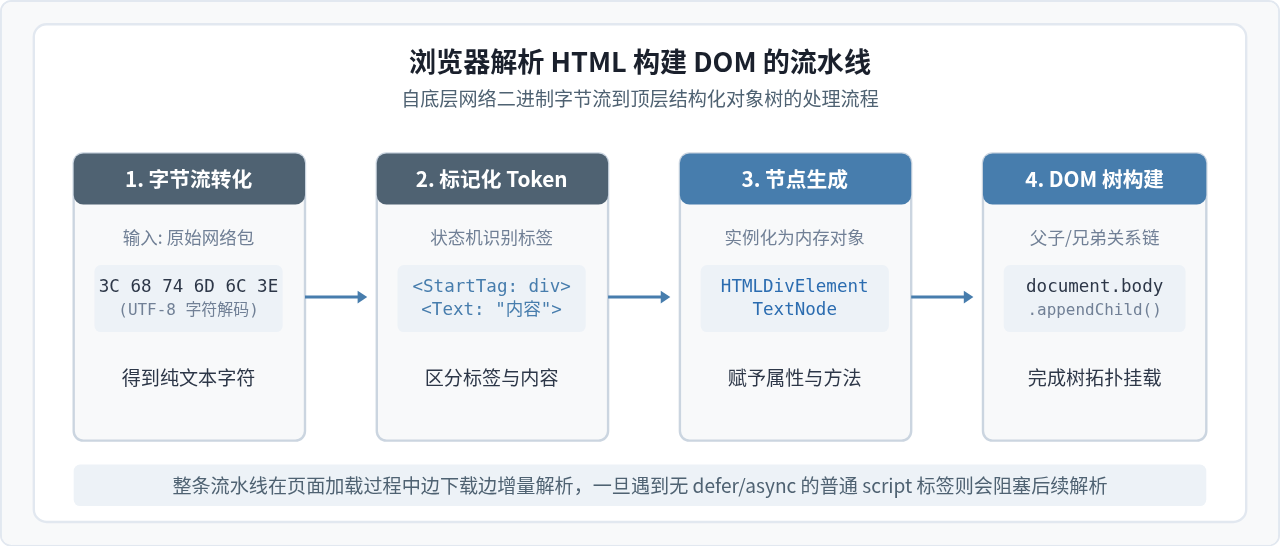
当浏览器向服务器发起请求并开始接收 HTML 时,它并不是等待完整文档下载完成后才一次性转换,而是随着网络字节流的抵达流式处理。从网络底层的原始字节流到最终可被脚本操作的 DOM 树,内部经历了严格的四步流水线:
- 字节转化(Conversion):浏览器根据响应头中的字符编码(如 UTF-8)将网络中读取的二进制数据流转化为人类可读的字符串字符。
- 词法分析与标记化(Tokenization):状态机扫描字符序列,按照 W3C 规范识别出起始标签(如
<p>)、结束标签(如</p>)、属性键值对及文本内容,将其分割成标准化的词法标记(Tokens)。 - 节点对象生成(Node Creation):每个标记都会实例化为一个具备特定属性和方法的 JavaScript 对应节点对象(例如根据
<div>标记生成一个HTMLDivElement实例)。 - DOM 树构建(Tree Construction):浏览器维护一个解析栈,利用标签的嵌套关系(开标签入栈、闭标签出栈),将各个独立的节点组装建立父子、兄弟等拓扑引用,最终在内存中拼装出完整的 DOM 树。
三、核心节点类型与关键辨析
在 DOM 树中,所有内容都是以“节点”(Node)为基本单位存在的。DOM 规范定义了顶层的 Node 接口,不同角色继承该接口后衍生出多种具体类型。开发中最常见的主要有以下几类:
| 节点类型 | 对应常量 / nodeType | 说明与常见示例 |
|---|---|---|
| 文档节点 (Document) | Node.DOCUMENT_NODE (9) |
整棵树的入口根节点,在脚本中通过全局变量 document 访问。 |
| 元素节点 (Element) | Node.ELEMENT_NODE (1) |
代表页面中的所有标签,如 <div>、<span>、<p>。 |
| 文本节点 (Text) | Node.TEXT_NODE (3) |
标签包裹的实际文本内容,包括代码换行与空格。 |
| 属性节点 (Attr) | Node.ATTRIBUTE_NODE (2) |
标签的属性(如 class、id、href),通常直接由 Element 提供操作方法。 |
| 注释节点 (Comment) | Node.COMMENT_NODE (8) |
代码中的 HTML 注释 <!-- 注释 -->,也会被挂载在 DOM 树上。 |
初学者必知陷阱:Node 与 Element 的区别
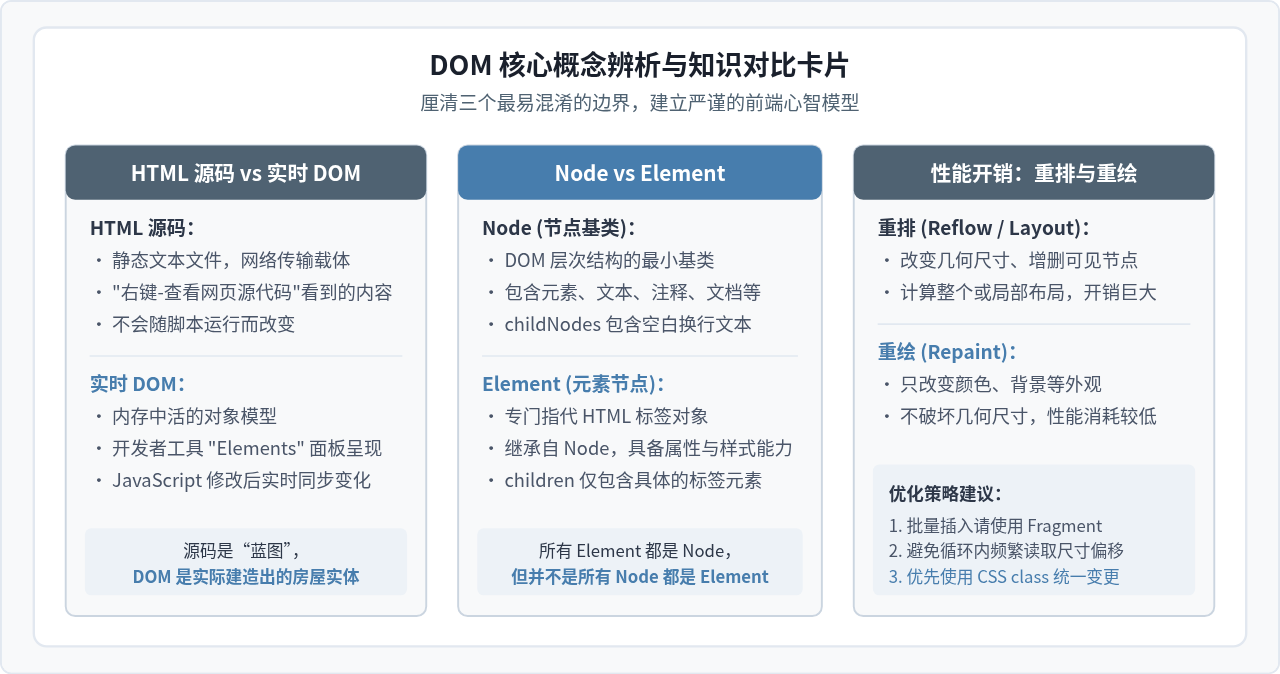
在许多初学者编写脚本时,常误以为 childNodes 获取到的就是子标签,实际上它返回的是所有类型的 Node(包括换行产生的空白文本节点)。如果只想获取子元素标签,应始终优先使用 children 属性;同理,若需查找相邻元素,推荐使用 nextElementSibling 而非 nextSibling。
四、JavaScript 操作 DOM 的核心工作流
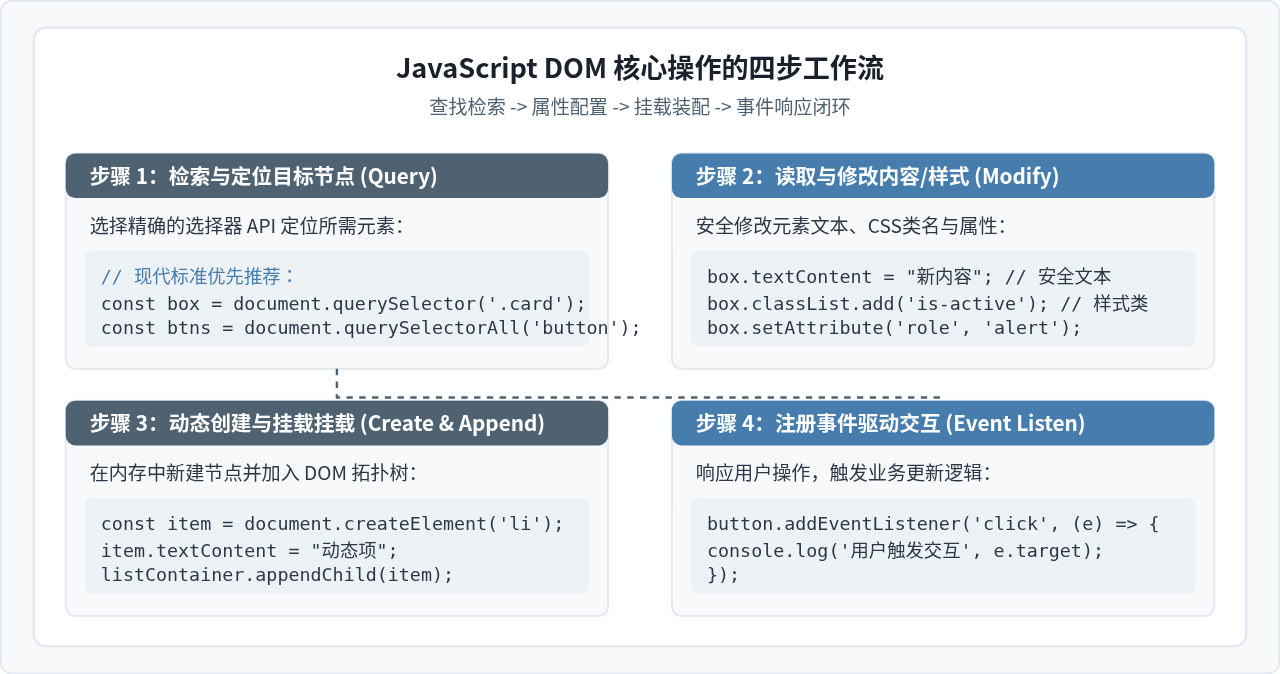
日常前端开发中,使用原生 JavaScript 操作 DOM 可以概括为四个环环相扣的核心动作:选取节点、修改属性与文本、动态增删节点、绑定事件监听。掌握这套标准化流程能够解决绝大多数交互需求。
1. 查询节点:选择最适合的方法
现代标准建议优先使用 querySelector 和 querySelectorAll,它们支持使用完整的 CSS 选择器语法,代码表达力极高:
// 选取首个匹配项(返回 Element 或 null)
const mainTitle = document.querySelector('h1.page-title');

// 选取所有匹配项(返回 NodeList 静态集合)
const actionButtons = document.querySelectorAll('.toolbar .btn');
actionButtons.forEach(btn => {
  console.log(btn.textContent);
});
2. 修改内容与属性:优先注意安全性
在修改元素内容时,初学者常用 innerHTML。虽然它能直接解析 HTML 标签,但如果插入的内容来自不受信的用户输入,极易造成跨站脚本攻击(XSS)。如果只是更新文字,应始终优先使用 textContent:
const noticeEl = document.querySelector('#notice');

// 推荐:安全纯文本赋值,自动转义特殊字符
noticeEl.textContent = '操作已完成,请刷新查看。';

// 控制样式类名:使用 classList 提供的高阶 API
noticeEl.classList.add('active');
noticeEl.classList.remove('loading');
noticeEl.classList.toggle('highlight');
五、DOM 核心概念辨析与避坑指南
理解 DOM 时,有几个概念极易混淆,直接影响编写代码的质量与运行性能。
1. 源代码与真实 DOM 的区别
在浏览器页面上右键选择“查看网页源代码”,查看到的是从服务器原始传输过来的 HTML 文件内容。如果页面在加载后执行了 JavaScript 脚本向 body 中插入了新的列表项,源码中并不会体现这一变动;而在浏览器开发者工具(F12)的“Elements”面板中所看到的,才是当前内存中活跃(Live)的 DOM 树。
2. 避免在循环中频繁操作 DOM
DOM 接口与 JavaScript 引擎之间存在跨模块通信的边界开销。此外,每次修改 DOM 的几何属性都有可能触发浏览器的重排(Reflow)与重绘(Repaint)。如果需要在页面中动态插入 100 个列表项,直接在 for 循环中连续调用 100 次 appendChild 会引发多次不必要的布局计算。推荐使用 DocumentFragment(文档片段)在内存中完成批量组装后再单次挂载:
const list = document.querySelector('#itemList');
const fragment = document.createDocumentFragment();

// 在内存离线节点中组装,不触发实际页面重排
for (let i = 1; i <= 100; i++) {
  const li = document.createElement('li');
  li.textContent = `序号 ${i}`;
  fragment.appendChild(li);
}

// 仅触发一次性挂载与重排
list.appendChild(fragment);
总结
文档对象模型(DOM)是现代前端交互技术的基石。它将扁平的 HTML 标记转化成了树状的面向对象结构,并为 JavaScript 提供了标准操控接口。掌握 DOM 的本质,不仅在于熟悉 querySelector、appendChild 等常用 API,更在于深刻理解从字节流到节点树的构建机理、分清 Node 与 Element 的层级边界,并在实际编程中注重防范 XSS 漏洞与减少不必要的渲染重排。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章