
深入解析 JavaScript DOM 中 Node 与 HTMLElement 接口的核心区别,剖析从 EventTarget、Node 到 Element、HTMLElement 的原型继承链,帮助开发者准确掌握 DOM 树遍历、样式控制与类型判断的最佳实践。

当前位置:首页 > JavaScript DOM 与事件 > 正文
HTMLElement与Node接口有什么区别?JavaScript DOM层级关系解析
作者:岩茶
时间:2026-10-30
浏览:239
文章目录
分类:前端核心知识
主题:DOM 规范与原型链解析
在 JavaScript 的 DOM 编程中,Node 与 HTMLElement 是两个最基础却又极易被混淆的概念。简明而言:Node 是 DOM 树中所有节点的通用基类接口,无论纯文本、HTML 标签、注释还是文档对象本身,都是一个 Node;而 HTMLElement 则是继承自 Element、专属于 HTML 文档标签元素的特化接口。换句话说,所有的 HTMLElement 必然都是 Node,但并非所有 Node 都是 HTMLElement。理解这一区别及其背后的原型链继承体系,是准确控制页面结构、避免类型错误以及高效操作 DOM 的基石。
一、JavaScript DOM 原型继承链层级架构
浏览器在解析网页时,会将 HTML 标记构造成一棵由对象节点构成的树状模型。为了兼顾通用树结构管理与特定 HTML 标记的功能支持,W3C 与 WHATWG DOM 规范采用了经典的面相对象原型继承体系。当我们在页面中获取一个 <div> 或 <input> 时,它表面上是一个普通对象,其原型链实际上向上经过了多层抽象:
- EventTarget:所有具备事件监听能力对象的基类。它提供了
addEventListener()、removeEventListener()与dispatchEvent()方法,让 DOM 节点能够接入浏览器的事件循环与派发机制。 - Node:树状结构的抽象骨架。它负责维护节点在树中的父子、兄弟关系(如
parentNode、childNodes),并定义了节点的类型与基础增删改查方法。 - Element:通用标记语言元素的抽象基类。它不仅面向 HTML,还面向 SVG、MathML 和通用 XML。它引入了属性操作(
getAttribute()、setAttribute())以及子元素查询(querySelector()、children)。 - HTMLElement:专门服务于 HTML 文档的具体元素基类。它提供了内联样式访问(
style)、盒模型尺寸测量(offsetWidth、offsetHeight)、无障碍属性(tabIndex、title)以及交互方法(click()、focus())。 - 具体标签接口:如
HTMLInputElement、HTMLAnchorElement等,赋予特定标签专有的业务属性(如value、checked、href)。
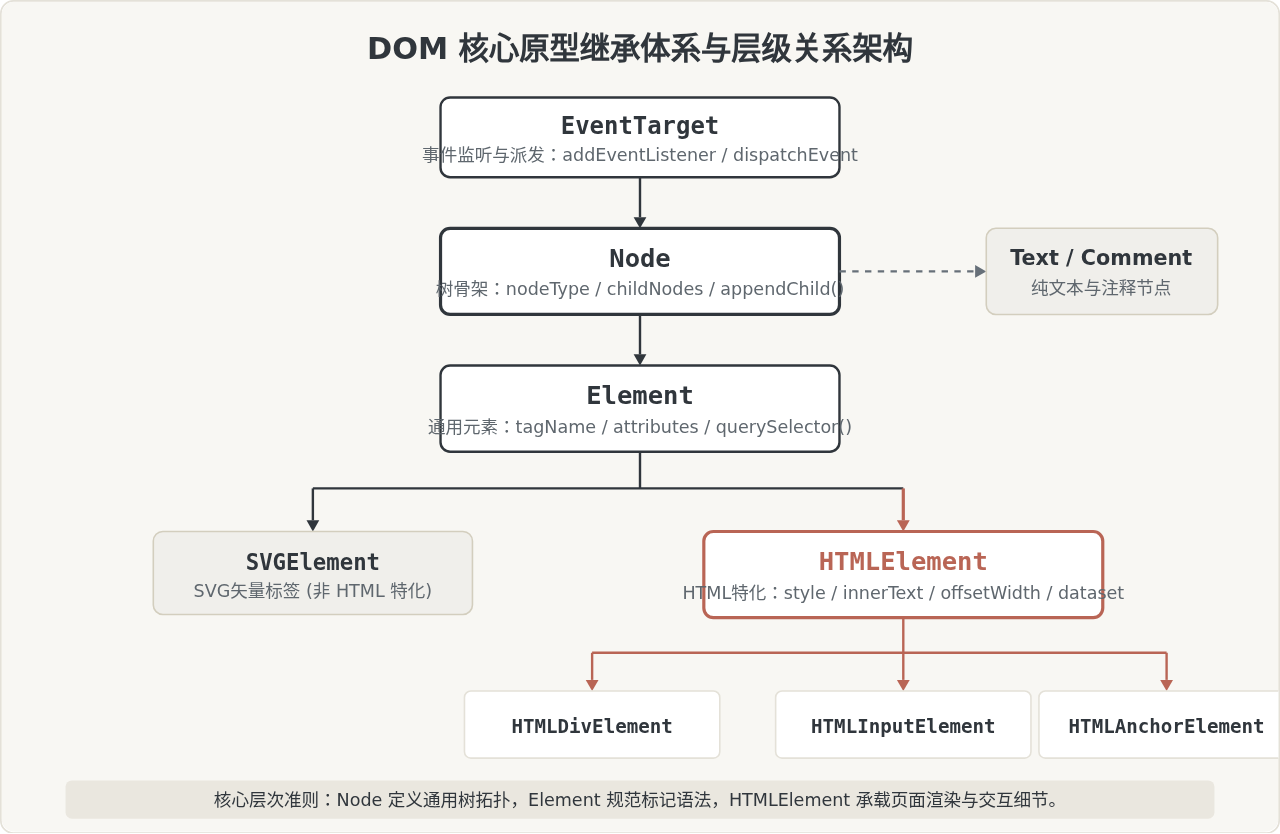
二、关键区别:节点类型与涵盖范围
理解 Node 与 HTMLElement 区别的第一道关卡,是明确它们在“覆盖范围”上的巨大差异。在浏览器解析的树状模型中,节点并不等同于标签:
- 一段文字是一个 Text 节点;
- 一段
<!-- 提示信息 -->是一个 Comment 节点; - 甚至代码中的空格与回车换行,在解析后也会成为独立的 Text 节点;
- 只有被标签包裹的实体,才会成为 Element 节点;而在 HTML 命名空间下的元素,才被具象化为 HTMLElement。
每一个 Node 实例都带有一个只读属性 nodeType,通过数值常量区分节点种类:
| 常量名称 | nodeType 数值 | 对应接口类型 | 是否属于 HTMLElement | 典型示例 |
|---|---|---|---|---|
Node.ELEMENT_NODE |
1 | Element / HTMLElement | 是(HTML标签元素) | <div>、<p>、<button> |
Node.TEXT_NODE |
3 | Text | 否 | 标签内的文字内容、换行空格 |
Node.COMMENT_NODE |
8 | Comment | 否 | <!-- 注释文本 --> |
Node.DOCUMENT_NODE |
9 | Document | 否 | window.document |
Node.DOCUMENT_FRAGMENT_NODE |
11 | DocumentFragment | 否 | document.createDocumentFragment() |
下面通过一段具体的 HTML 结构,观察两种接口在面对同一段代码时的解析差异:
<!-- 示例 HTML 结构 -->
<div id="container">
  <!-- 用户信息卡片 -->
  <span>前端工程师</span>
  Ku-AiFram
</div>
// 获取容器元素
const container = document.getElementById('container');
// 1. 使用 Node 维度的 childNodes 访问(包含所有 Node)
console.log(container.childNodes.length); // 输出: 5
// 索引 0: Text (换行与缩进空格)
// 索引 1: Comment (注释:用户信息卡片)
// 索引 2: Text (换行与缩进空格)
// 索引 3: HTMLSpanElement (span 标签)
// 索引 4: Text (包含 "Ku-AiFram" 与末尾换行)
// 2. 使用 Element/HTMLElement 维度的 children 访问(仅包含元素)
console.log(container.children.length); // 输出: 1
// 索引 0: HTMLSpanElement (仅有 span 标签)这段代码直观展示了 API 维度的根本分野:如果错误地把 childNodes 当作标签子元素遍历,很容易在处理属性时因命中纯文本节点而抛出空指针异常。
三、API 属性与能力边界对比
由于 HTMLElement 处于原型链的下游,它完整继承了 Node 的全部方法,但同时扩展了大量关于渲染、几何排版与交互特性的专用 API。而处于上游的 Node 接口,则被设计为轻量且中立的树结构工具,不包含任何有关 CSS 渲染与盒模型的概念。
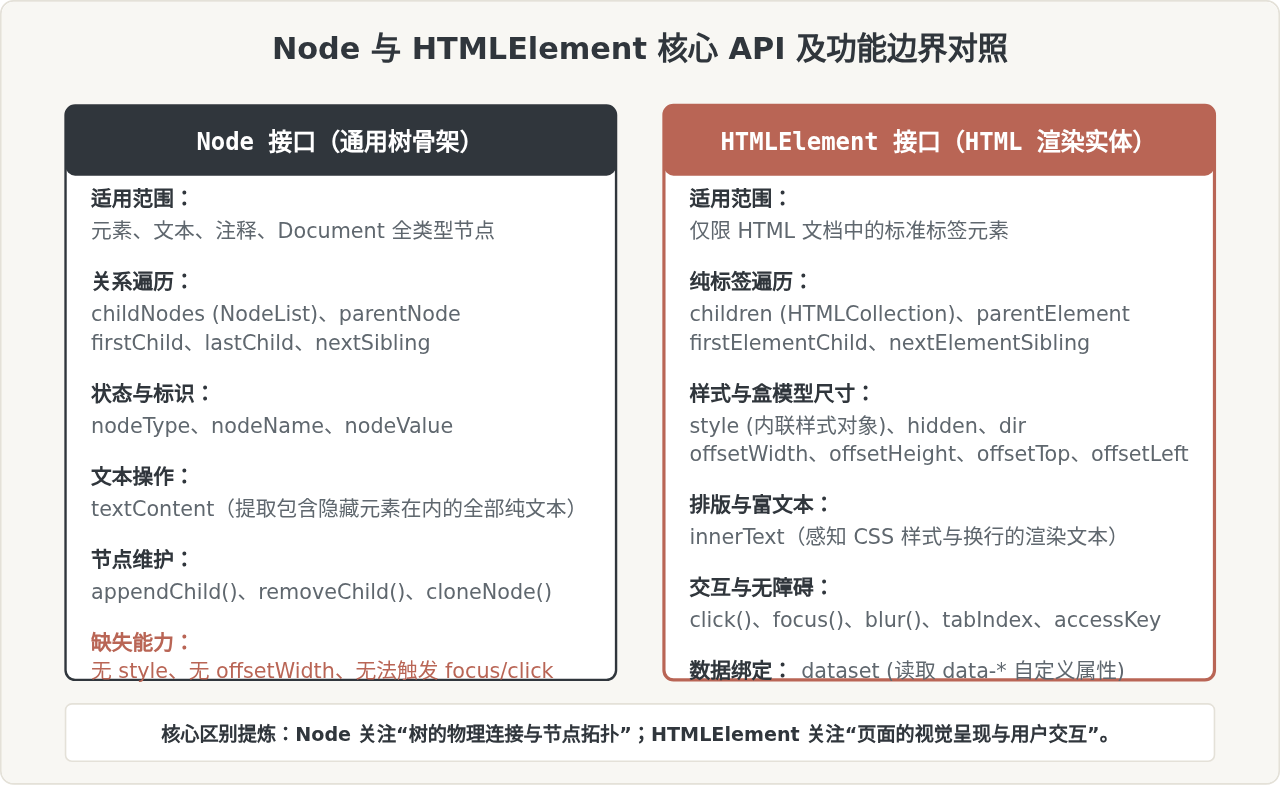
在具体编码中,这种能力边界直接体现在以下三个典型维度:
1. 遍历属性的成对演进
为了摆脱文本空白节点的干扰,DOM 规范在 Element / HTMLElement 层级上提供了一组专门针对“元素节点”的遍历属性,与 Node 的原生属性形成精准对照:
Node.childNodes(返回 NodeList) 对应Element.children(返回 HTMLCollection)。Node.firstChild对应Element.firstElementChild。Node.nextSibling对应Element.nextElementSibling。Node.parentNode对应Node.parentElement(在根节点<html>上,parentNode为Document,而parentElement则返回null)。
2. 样式与尺寸测量的绝对专属权
一个文本节点或注释节点没有宽高的物理概念,也不接受 CSS 渲染规则,因此 Node 接口不存在 style、offsetWidth 等属性。尝试对一个未知 Node 调用 node.style.color = 'red',如果该节点恰好是空白字符生成的 Text 节点,就会直接引发 TypeError: Cannot set properties of undefined (setting 'color')。
3. 文本提取:textContent 与 innerText 的差异
textContent 定义在 Node 上,它会递归提取该节点及其所有后代节点的文本内容,并且完全不触发浏览器的排版与渲染计算,甚至会把 <script>、<style> 以及被 display: none 隐藏的内容一并提取出来。而 innerText 定义在 HTMLElement 上,它是“感知渲染”的:它不仅会忽略被 CSS 隐藏的文本,还会模拟页面呈现中的换行规则,调用时会强制触发浏览器的重排(reflow),性能开销相对更高。
四、实践步骤:DOM 节点安全访问与类型判断
在编写通用的 DOM 工具函数、富文本解析器或第三方 UI 组件时,我们常常需要接收外部传入的 DOM 参数。由于传入的对象可能是任意 Node,建立一套确定性的校验与守卫流程至关重要。
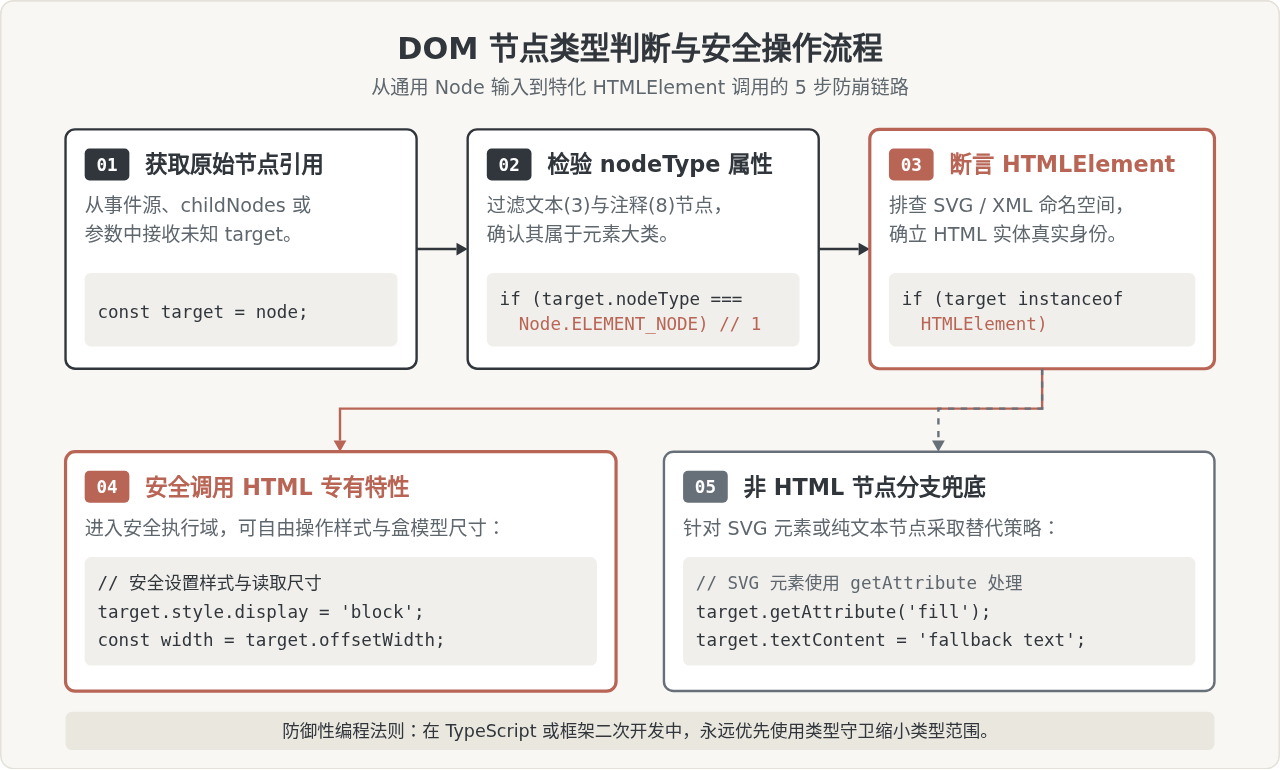
按照图 3 所示的步骤,我们可以编写一个具备工业级健壮性的 DOM 处理函数:
/**
 * 安全地对目标节点应用视觉高亮
 * @param {Node} node 任意传入的 DOM 节点
 * @param {string} highlightColor 高亮背景色
 */
function applyHighlight(node, highlightColor = '#FFF3CD') {
  // 步骤 1 & 2:空值校验与节点大类校验
  if (!node || node.nodeType !== Node.ELEMENT_NODE) {
    console.warn('跳过非元素节点:', node?.nodeName);
    return false;
  }

  // 步骤 3:精确判断是否属于 HTMLElement
  if (node instanceof HTMLElement) {
    // 步骤 4:安全调用 HTMLElement 的专有 API
    node.style.backgroundColor = highlightColor;
    node.style.transition = 'background-color 0.3s ease';
    console.log(`成功高亮元素 <${node.tagName.toLowerCase()}>,尺寸:${node.offsetWidth}px`);
    return true;
  }

  // 步骤 5:处理 SVGElement 等非 HTML 元素的分支场景
  if (node instanceof SVGElement) {
    node.setAttribute('fill', highlightColor);
    console.log('检测到 SVG 元素,改用 fill 属性应用色彩');
    return true;
  }

  return false;
}
五、常见开发误区与避坑指南
误区一:遍历子节点时混用 childNodes 与 children
许多初学者在获取容器下的子项时习惯使用 container.childNodes。在现实编码中,HTML 文件的缩进换行都会被浏览器解析为一个个类型为 3 的 Text 节点。如果你使用 for 循环直接对 childNodes[i] 访问 .style 或 .className,遇到空白换行就会立即报错。除非你需要精确解析文本碎片,否则所有页面级业务逻辑都应当优先使用 children。
误区二:误认为页面中的所有标签都是 HTMLElement
内联在 HTML 中的 <svg>、<path>、<circle> 标签属于 SVGElement,而非 HTMLElement。虽然它们都继承自 Element,但 SVGElement 在历史实现中并没有 innerText 属性,其尺寸读取方式也通常依赖 getBBox() 而非 offsetWidth。如果把所有的页面元素均断言为 HTMLElement,在涉及数据可视化或图标的场景下极易产生隐蔽 Bug。
误区三:以为 parentElement 和 parentNode 完全等价
在 99% 的普通标签树中,它们的返回值是一样的。但在 DOM 树的顶层:document.documentElement(即 <html> 标签)的父节点是 document。因为 document 是一个 Node 但不是一个 Element,所以 document.documentElement.parentNode 会正确返回 document,而 document.documentElement.parentElement 则会返回 null。向上递归遍历树寻找祖先元素时,务必使用 parentElement 来自然终止于根元素。
六、选型指南与全景总结
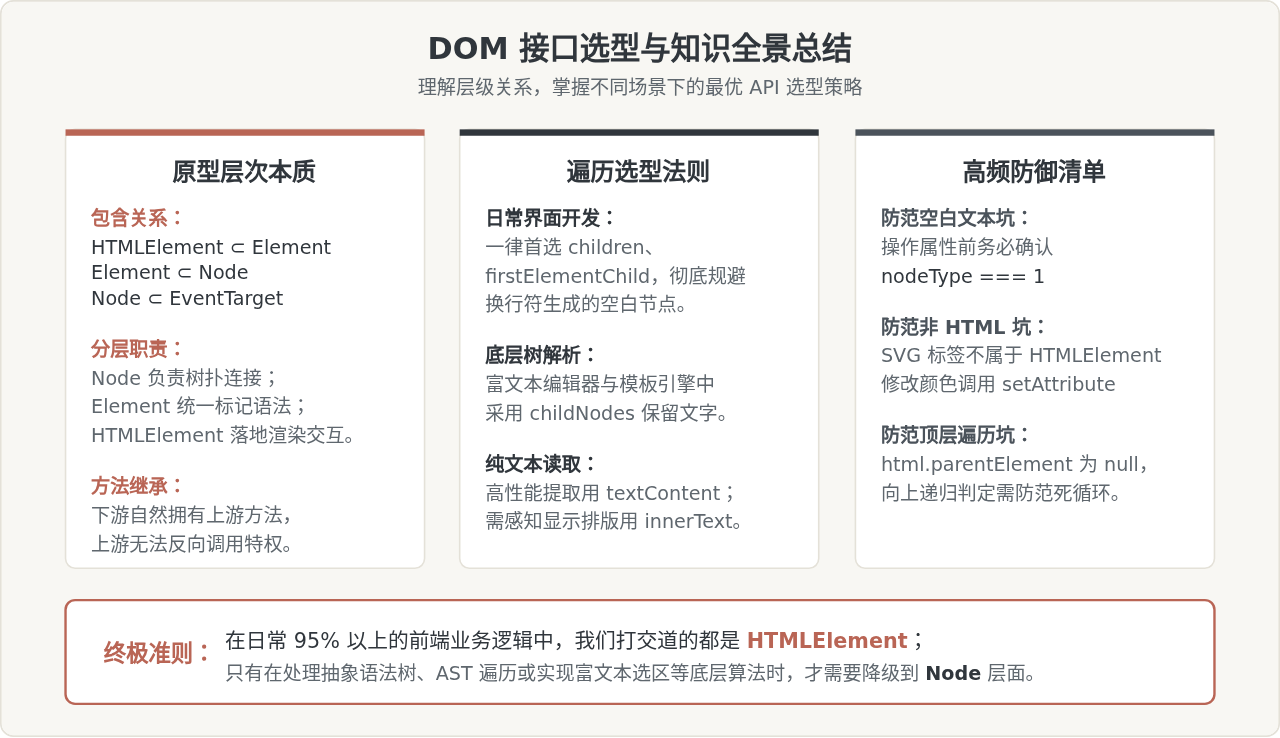
综上所述,Node 与 HTMLElement 绝非并列或互斥的两个概念,而是一套严谨原型链继承中的不同抽象层次。牢记“Node 负责树拓扑,HTMLElement 负责渲染交互”,在编码中按需选择遍历 API 并善用类型守卫,即可写出清晰、安全且高性能的 DOM 交互代码。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章