

本文详细介绍使用wget命令行工具批量下载指定网站目录下所有JavaScript (.js) 脚本文件的方法,包括递归抓取、扩展名过滤、目录层级控制、避免上卷目录及常见实操陷阱排查。
使用wget批量下载网站目录下所有JS脚本的方法
作者:橙子
时间:2026-10-30
浏览:551
文章目录
在进行前端静态资源归档、代码审查或离线分析时,我们经常需要将目标网站某个目录中的所有 JavaScript 脚本批量保存到本地。wget 是一款广泛运行于各类类 Unix 环境与 Windows 终端中的非交互式网络下载器,依靠其内置的递归检索、文件后缀匹配与路径过滤机制,只需一条精心配置的命令,就能精准地抓取所需脚本并避免把整站无关资源拉取下来。
一、核心解决方案与基本命令
要抓取指定 URL 路径下的所有 .js 文件,核心思路是开启递归抓取,设定文件后缀白名单为 js,同时禁止向父级目录回溯。标准的执行命令如下:
wget -r -l 2 -nd -np -A.js -erobots=off "https://example.com/static/js/"这条命令的执行逻辑非常明确:从给定的静态目录根 URL 开始,顺着目录树向下查找最多 2 层子目录,仅筛选出扩展名为 .js 的资源,将它们直接平铺保存在当前工作目录下,且不会顺着链接爬取到上级目录。
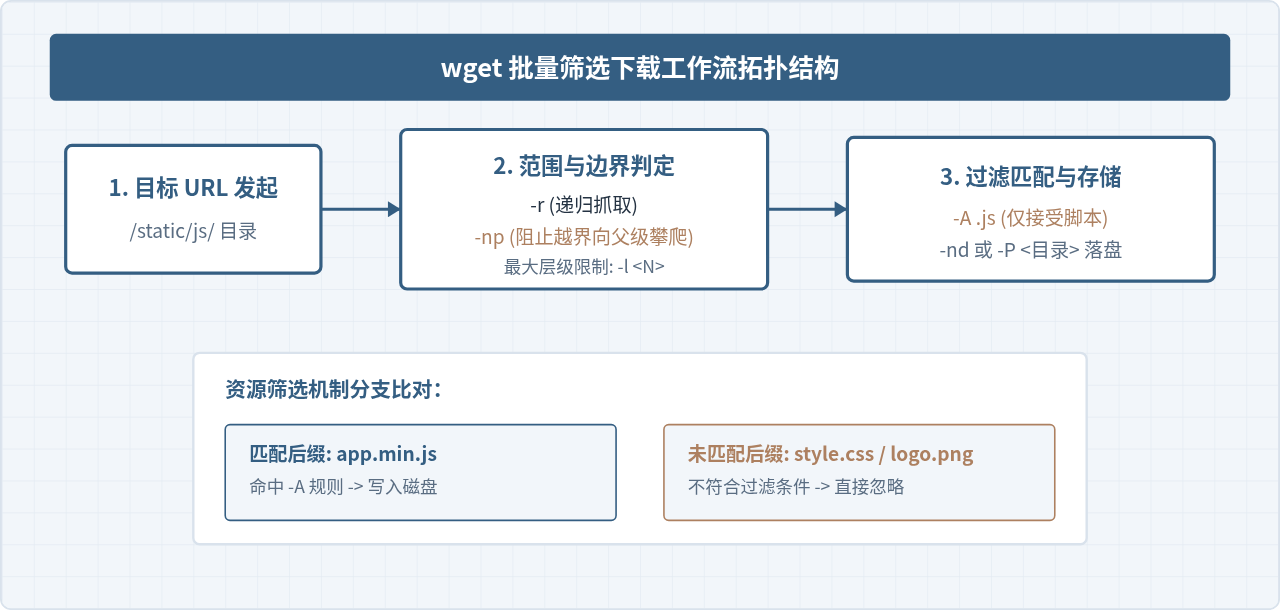
图 1:wget 递归抓取与后缀匹配的执行拓扑流程
二、关键参数详解与功能拆解
为了让下载任务受控并符合预期,理解每一个参数在网络交互与文件系统中的实际作用至关重要:
-r(或--recursive):开启递归下载。wget 会自动解析页面中的超链接,沿着树形结构持续跟进下载。-np(或--no-parent):极其关键的边界约束选项。严格禁止 wget 沿相对路径中的../回溯到当前目录的上级目录。若缺少此参数,爬虫可能顺着导航栏链接爬遍整个站点。-A .js(或--accept .js):接受列表(Accept List)。仅保存以.js结尾的文件。如果要同时抓取.map源码映射文件,可以使用逗号分隔:-A ".js,.map"。-nd(或--no-directories):平铺保存模式。默认情况下,wget 会在本地完整创建远程服务器的多层目录结构(例如example.com/static/js/)。添加-nd后,所有符合条件的文件都会直接解构存放到当前所在的单层目录中。-l 1或-l 2(或--level):指定递归的最大递归深度。直接下载单目录建议设为 1,若包含子模块文件夹可按需调为 2 或 3,避免无限死循环。-erobots=off:忽略远程服务器根目录robots.txt对爬虫的屏蔽规则。很多网站的资源目录在 robots.txt 中被设置为禁止抓取,若不显式关闭,wget 会直接返回空结果或报错退出。
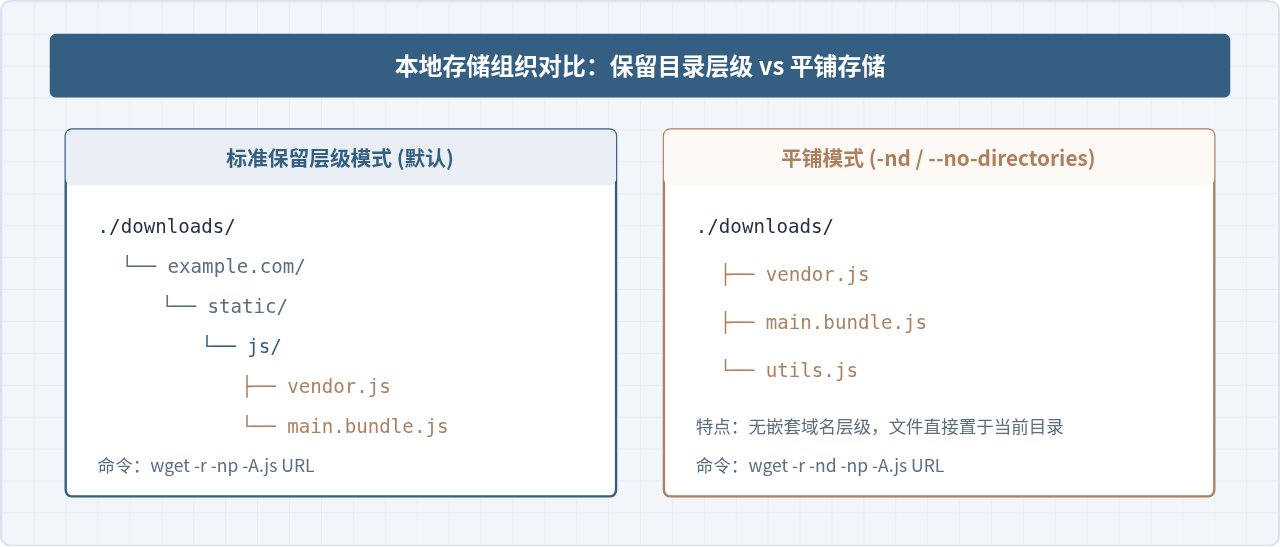
图 2:默认目录结构与平铺模式(-nd)存储效果对比
三、实战操作全流程
以下按照标准工程操作流,分步演示从准备工作到完成归档的全套步骤:
步骤 1:创建并进入独立下载目录
为了防止平铺下载的文件与本地其它重要文件发生命名冲突或混杂,在下载前务必单独建立临时存放目录:
mkdir -p ~/project_scripts && cd ~/project_scripts步骤 2:执行精准下载命令
如果目标网站开启了目录列表(Directory Listing,如 Apache/Nginx Autoindex),直接指定目标目录 URL 并在末尾保留斜杠 /:
wget -r -np -nd -l 2 -A.js -erobots=off --user-agent="Mozilla/5.0" "https://example.com/assets/js/"如果服务器要求存放到指定外部路径而不切换工作目录,可追加 -P 参数:
wget -r -np -A.js -P /data/backup/js_files "https://example.com/assets/js/"步骤 3:验证下载结果与文件完整性
下载完成后,执行列表与统计命令检查下载结果:
ls -lh *.js示例输出如下:
-rw-r--r--  1 user  staff   142K Oct 25 10:20 chunk-vendors.8b4f2c.js
-rw-r--r--  1 user  staff    45K Oct 25 10:20 runtime.a102bc.js
-rw-r--r--  1 user  staff   312K Oct 25 10:20 main.7e819a.js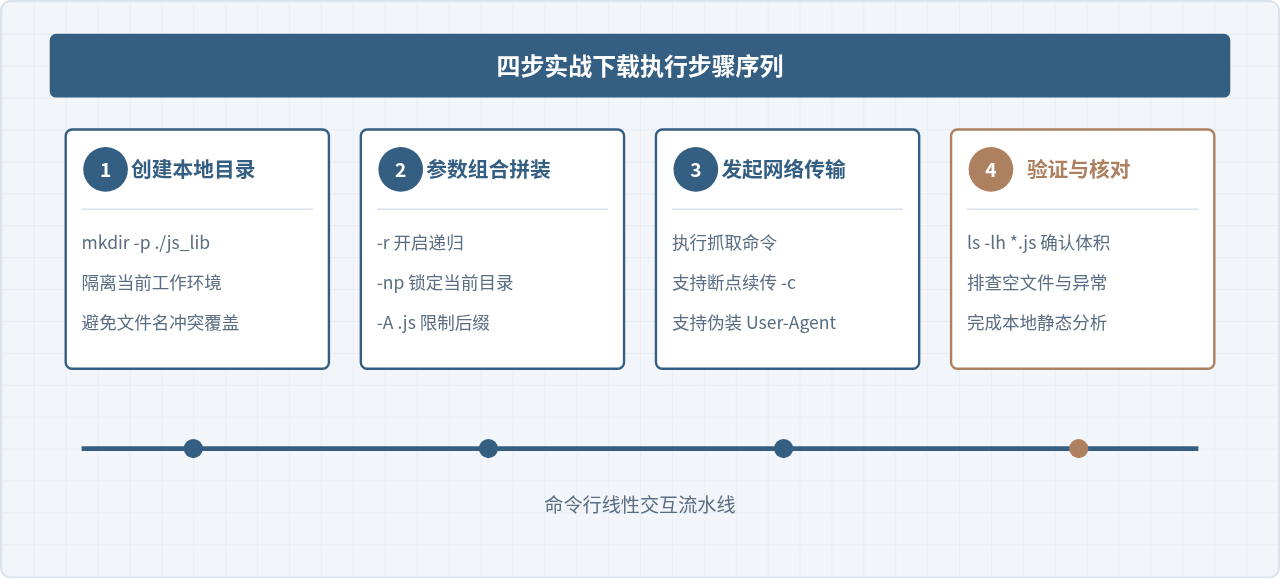
图 3:使用 wget 完成脚本批量下载的标准实操流水线
四、典型场景拓展与常见异常排查
注意事项:
如果目标目录关闭了目录列表(未返回包含
<a href="..."> 链接的索引 HTML 页面),纯文件服务器将直接返回 403 Forbidden 或空白页。此时 wget 的 -r 机制无法探测到隐藏的文件名。针对这种情况,通常需要借助网站入口页(如 index.html)解析出所有引用的脚本,或者配合已知 URL 列表进行下载。
1. 针对全站 HTML 提取所有外部 JS 脚本
如果目标网站没有公开目录索引,但你想把页面内引用的所有 JS 全部拉下来,可以使用 -p (page-requisites) 参数配合后缀筛选:
wget -r -l 1 -H -nd -A.js -erobots=off --user-agent="Mozilla/5.0" "https://example.com/"其中 -H(--span-hosts)允许跨域名下载,适合抓取挂载在 CDN(如 cdn.example.com)上的静态脚本资源。
2. 遭遇 403 Forbidden 拦截
多数现代 Web 服务器(如 Cloudflare、Nginx)默认会拦截含有 Wget 请求头的请求。此时只需增加请求头伪装即可:
wget -r -np -nd -A.js --header="User-Agent: Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36" "https://example.com/js/"3. 避免重试卡死与下载超时
在网络状况不稳定或服务器有频次限制时,设置合理的超时时间与重试次数至关重要:
wget -r -np -nd -A.js -T 15 -t 3 --wait=1 --random-wait "https://example.com/js/"这里 -T 15 表示单次请求超时 15 秒,-t 3 代表最多重试 3 次,--wait=1 --random-wait 引入随机延时以减轻被对端封禁 IP 的风险。
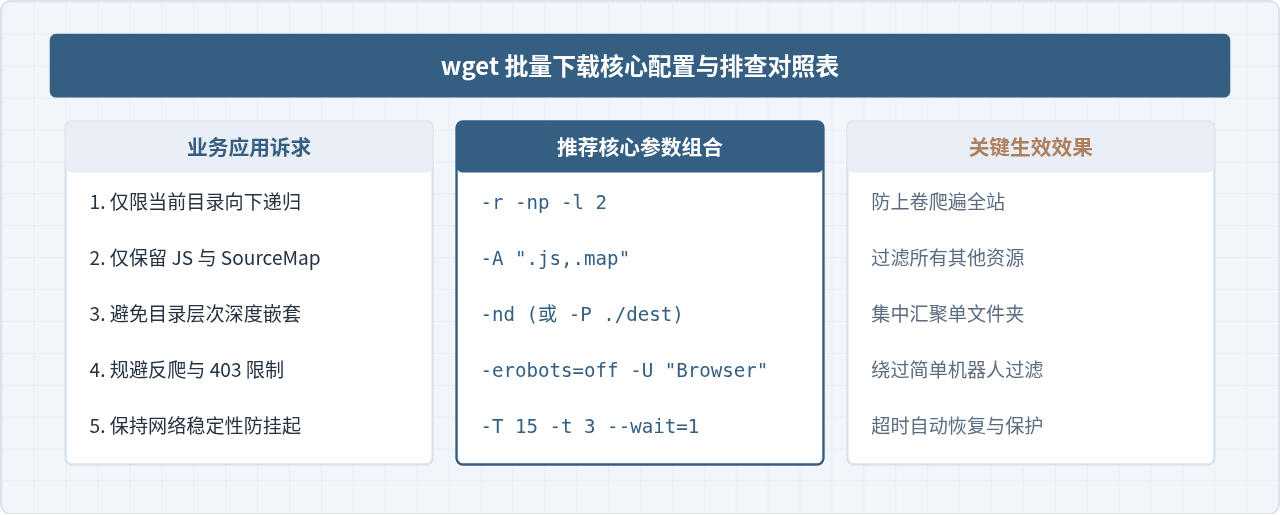
图 4:wget 参数调优与功能特性对照矩阵
五、总结
使用 wget 批量下载特定网站目录下的所有 JS 脚本,最精炼且高可靠的指令为:
wget -r -np -nd -A.js -erobots=off --user-agent="Mozilla/5.0" "https://example.com/target_dir/"牢记 -r 负责递归向下,-np 封锁上级路径,-A.js 精准过滤扩展名,而 -nd 消除多余嵌套。在实际使用中根据目标服务器是否开启 Directory Listing 和防爬规则适度补充 Header 与超时设置,即可安全、高效地获取所需的全部脚本。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章