
系统介绍针对JavaScript技术栈的刷题与面试准备平台,深度对比LeetCode、HackerRank、BFE.dev等工具的定位、特性与适用场景,提供清晰实用的备考规划与核心技巧。

当前位置:首页 > JavaScript 基础 > 正文
JavaScript刷题与面试准备网站:LeetCode、HackerRank及专项练习平台
作者:木棉
时间:2026-10-30
浏览:235
文章目录
在准备技术面试与日常技能演练时,选择匹配当前技术栈与求职目标的刷题平台是提升效率的关键。对于使用 JavaScript 的开发者而言,不仅要应对通用的基础数据结构与算法挑战,还需要应对平台判题环境中的输入输出规范,以及前端领域特有的原型链、异步事件循环、DOM 操作与高频手写题。本文将系统拆解 LeetCode、HackerRank 以及前端垂直领域的专项练习平台(如 BFE.dev、GreatFrontEnd 等),梳理各平台的侧重点与考察形式,并提供切实可行的分阶段备考方案。
一、各大刷题平台的定位与适用场景
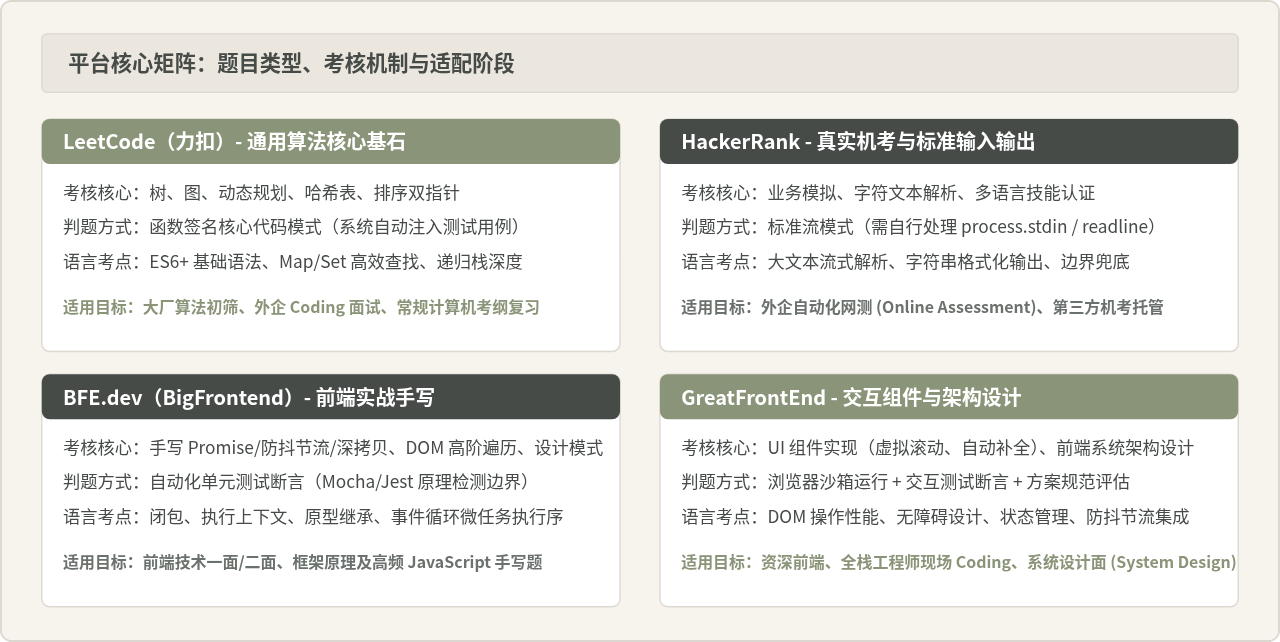
求职面试中不同平台承担的考核目的差异很大。如果仅盲目在单一平台上随机做题,容易出现算法写得熟练,但遇到需要处理标准输入输出的在线笔试时无从下手,或者遇到要求纯手写核心 API 的前端面试时频频卡壳的情况。因此,首先需要清晰建立各平台的定位坐标。
二、LeetCode:聚焦通用数据结构与经典算法
LeetCode 是目前国内外技术面试中算法考核的参考标杆。在 JavaScript 语言环境下刷题时,判题系统采用的是“核心代码模式”,即平台负责注入测试用例并调用你所编写的函数,无需开发者处理输入输出的流读取。
1. JavaScript 在 LeetCode 上的特性与限制
使用 JavaScript 刷 LeetCode 时,有几项关键语言特性必须提前知悉:
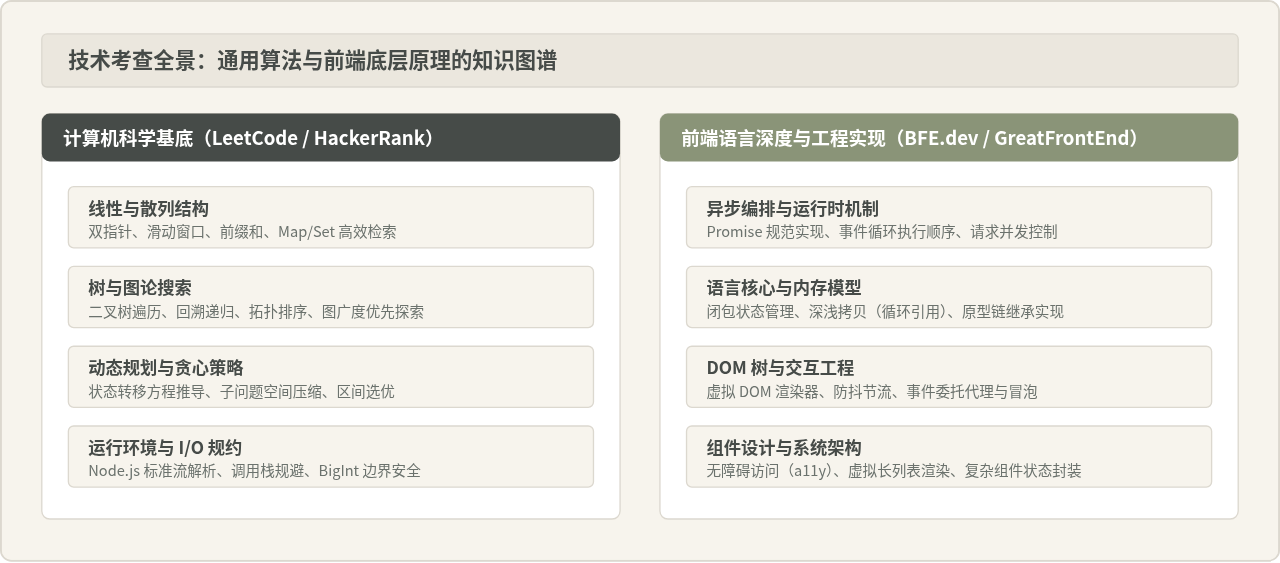
- 内置数据结构的完备性:JavaScript 原生提供了数组(Array)、哈希映射(Map)和哈希集合(Set),但在早期版本中并未内置堆/优先队列(Heap / PriorityQueue)。在需要使用大顶堆、小顶堆的题目(如“滑动窗口最大值”或“前 K 个高频元素”)中,需要手动用数组实现二叉堆,或者利用 LeetCode 运行环境额外引入的
@datastructures-js/priority-queue库。 - 递归调用栈深度:V8 引擎在 Node.js 环境下默认的调用栈深度通常在 10,000 层左右。对于深度优先搜索(DFS)中节点数量极多但树退化为单链表的情形,极易发生
RangeError: Maximum call stack size exceeded。解决方式是改为基于显式栈数组的迭代遍历。 - 数字精度边界:JavaScript 的
Number遵循 IEEE 754 双精度浮点标准,安全整数范围为Number.MIN_SAFE_INTEGER至Number.MAX_SAFE_INTEGER(即 ±(2^53 - 1))。当题目涉及超大整数乘除或累加时,必须改用BigInt,并在最终返回时根据题目要求转回 Number 或字符串。
2. 典型题型解题范例:无重复字符的最长子串(滑动窗口)
以 LeetCode 经典题目为例,展示规范的 JavaScript 编码范式:利用 Map 记录字符最后一次出现的索引,实现 O(n) 时间复杂度的双指针滑动窗口:
/**
 * @param {string} s
 * @return {number}
 */
function lengthOfLongestSubstring(s) {
  let maxLength = 0;
  let left = 0;
  const charIndexMap = new Map();

  for (let right = 0; right < s.length; right++) {
    const currentChar = s[right];

    // 如果当前字符在窗口内已存在,则将左指针收缩至重复字符的下一位置
    if (charIndexMap.has(currentChar) && charIndexMap.get(currentChar) >= left) {
      left = charIndexMap.get(currentChar) + 1;
    }

    charIndexMap.set(currentChar, right);
    maxLength = Math.max(maxLength, right - left + 1);
  }

  return maxLength;
}
三、HackerRank:掌握标准输入输出与机考实战
不同于 LeetCode 的核心代码模式,HackerRank 以及国内部分机考系统(如牛客网在线机考)普遍采用“ACM 模式”,即要求候选人直接读取 process.stdin 标准输入,解析各种格式的输入数据(单行数值、空格分隔的数字串、多行矩阵等),并将计算结果按格式写入 process.stdout。
避坑提示:许多开发者算法能力出众,却因不熟悉 Node.js 的 readline 模块,在机考前 20 分钟甚至无法正确读取二维数组输入,导致严重失分。
1. Node.js 标准 I/O 模板
在 HackerRank 或 ACM 模式平台中,针对单行或连续多行输入的标准写法通常基于 Node.js 内置的 readline 模块:
const readline = require('readline');

// 创建接口实例监听标准输入输出流
const rl = readline.createInterface({
  input: process.stdin,
  output: process.stdout
});

const lines = [];

// 逐行捕获输入数据
rl.on('line', (line) => {
  lines.push(line.trim());
});

// 输入结束时触发计算与结果输出
rl.on('close', () => {
  if (lines.length === 0) return;

  // 示例:第一行表示数据行数 N,后续为具体数据
  const n = parseInt(lines[0], 10);
  const data = [];

  for (let i = 1; i <= n; i++) {
    // 处理空格分隔的整型数组输入
    const row = lines[i].split(/\s+/).map(Number);
    data.push(row);
  }

  const result = solve(data);
  process.stdout.write(result + '\n');
});

function solve(matrix) {
  // 核心逻辑实现
  return matrix.reduce((acc, curr) => acc + curr.length, 0);
}
四、专项练习平台:BFE.dev 与 GreatFrontEnd
通用算法虽然重要,但在前端开发者的岗位面试中,面试官往往会考察候选人对 JavaScript 运行机制、高阶 API 原理及交互组件实现的能力。BFE.dev(BigFrontend)与 GreatFrontEnd 填补了这一空白。
1. BFE.dev 的核心考点
BFE.dev 专注于将前端日常开发中的高频 API 抽象为单元测试题。其高频题型包括:
- 手写异步运行时:实现符合 Promise/A+ 规范的
MyPromise,实现Promise.all、Promise.allSettled、并发控制任务调度器(Concurrency Task Scheduler)。 - 函数式与闭包:实现防抖(
debounce)、节流(throttle)、柯里化(curry)、扁平化嵌套数组与对象。 - 对象与内存操作:深拷贝(解决循环引用与特殊类型处理,如 Symbol、Map、Set)、实现
Object.create或寄生组合式继承。 - DOM 操作与事件:实现自定义事件触发器(
EventEmitter)、DOM 树深度优先遍历与层序遍历、虚拟 DOM 到真实 DOM 的渲染函数。
2. 实战示例:实现支持立即执行与取消防抖函数(Debounce)
在前端业务与 BFE.dev 题库中,防抖函数是出场率极高的必考题。以下提供工业级健壮性的解法:
function debounce(func, wait, option = { leading: false, trailing: true }) {
  let timerId = null;
  let lastArgs = null;
  let lastThis = null;

  function invoke() {
    if (lastArgs) {
      func.apply(lastThis, lastArgs);
      lastArgs = null;
      lastThis = null;
    }
  }

  function debounced(...args) {
    lastArgs = args;
    lastThis = this;

    const isInvokingLeading = option.leading && !timerId;

    if (timerId) {
      clearTimeout(timerId);
    }

    if (isInvokingLeading) {
      invoke();
    }

    timerId = setTimeout(() => {
      if (option.trailing && !isInvokingLeading) {
        invoke();
      }
      timerId = null;
    }, wait);
  }

  debounced.cancel = function() {
    clearTimeout(timerId);
    timerId = null;
    lastArgs = null;
    lastThis = null;
  };

  return debounced;
}
五、常见认知辨析:用 JavaScript 刷算法真的劣于 C++/Java 吗?
在各大技术讨论区,经常存在一种观点:“刷算法题必须用 C++ 或 Java,用 JavaScript 刷算法先天不足,甚至会在面试中吃亏。”这种观点看似合理,但并不全面,需要分场景客观看待:
1. 为什么这种观点看似合理?
- 标准库缺失特定结构:C++ 拥有极为丰富的 STL(如
std::priority_queue、std::multiset),Java 拥有PriorityQueue与TreeMap。而原生 JavaScript 缺少开箱即用的堆结构,遇到图的最短路径(Dijkstra)或前 K 项统计题目时,选手需要额外耗费 10 多分钟手写二叉堆实现。 - 执行时延与内存波动:在极端大规模数据场景下,V8 的垃圾回收(GC)机制与弱类型动态分配会引入偶发的运行时开销,使得相同时间复杂度下的代码在执行耗时统计上劣于经过严格编译优化的 C++。
2. 为什么在前端与全栈面试中,坚持使用 JavaScript 更有优势?
- 直接考察岗位匹配度:如果应聘岗位是 Web 前端或 Node.js 全栈工程师,面试官不仅考察解决问题的思维逻辑,更关注你对 JavaScript 语言惯用法(Idiomatic Code)的掌握程度。例如对
Array.prototype.reduce、解构赋值、Map与Set的熟练运用,能够体现代码素养。 - 避免思维切换成本:在技术面试中,通常算法题结束后会立刻切入项目架构与手写业务代码环节。如果前期使用 C++ 写算法,中途又必须切换回 JavaScript 处理 DOM 与异步逻辑,极易发生语法混淆与思维卡顿。
- 现代平台已补齐短板:目前无论是在 LeetCode 还是 HackerRank,均已引入扩展算法库(如内置了高效的 PriorityQueue 实现),考生无需再担心缺失堆结构的问题。
六、实操落地:分阶段刷题与复习路线
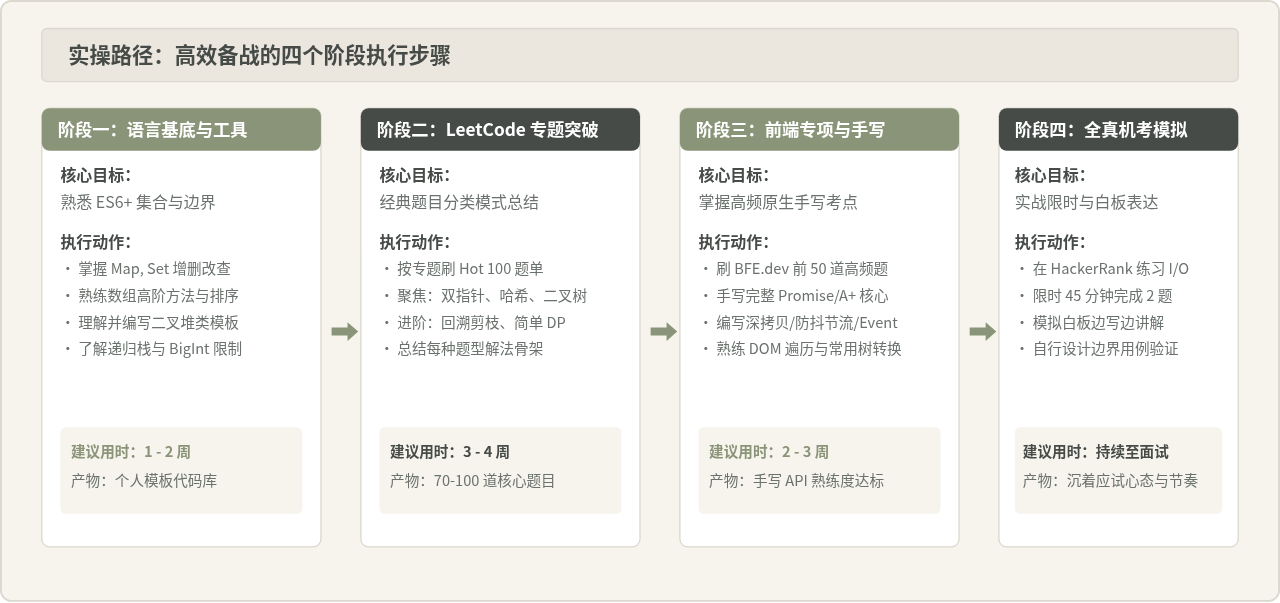
针对求职准备周期通常为 2 至 3 个月的实际情况,建议按如下四个明确阶段循序渐进推进:
七、平台横向对比与选型指南
为了让不同阶段与目标的读者迅速定位最适合自己的主攻平台,下表给出了客观的功能特性与选型对比:
| 对比维度 | LeetCode | HackerRank | BFE.dev | GreatFrontEnd |
|---|---|---|---|---|
| 核心侧重 | 经典算法、数据结构 | 综合编程、机考、多语言 | 前端高频手写 API、DOM | 前端组件、系统设计 (System Design) |
| 代码交互模式 | 核心函数补全 | 标准流输入输出 (I/O) | 单元测试驱动 (Jest/Mocha) | 沙箱渲染 + 单元测试 |
| 语言特性支持 | Node.js 最新 LTS | Node.js 及多语言环境 | 原生浏览器与 Node.js 特性 | TypeScript / React / Vue / JS |
| 社区与题解质量 | 极丰富,讨论区题解众多 | 丰富,海外公司讨论度高 | 专注前端,解答针对性极强 | 官方提供高水准权威题解方案 |
| 推荐使用时机 | 求职前期建立算法思维基底 | 准备外企网测 (OA) 与机考 | 针对技术面手写题突击 | 冲刺高级前端与架构设计考核 |
八、总结与高频注意事项
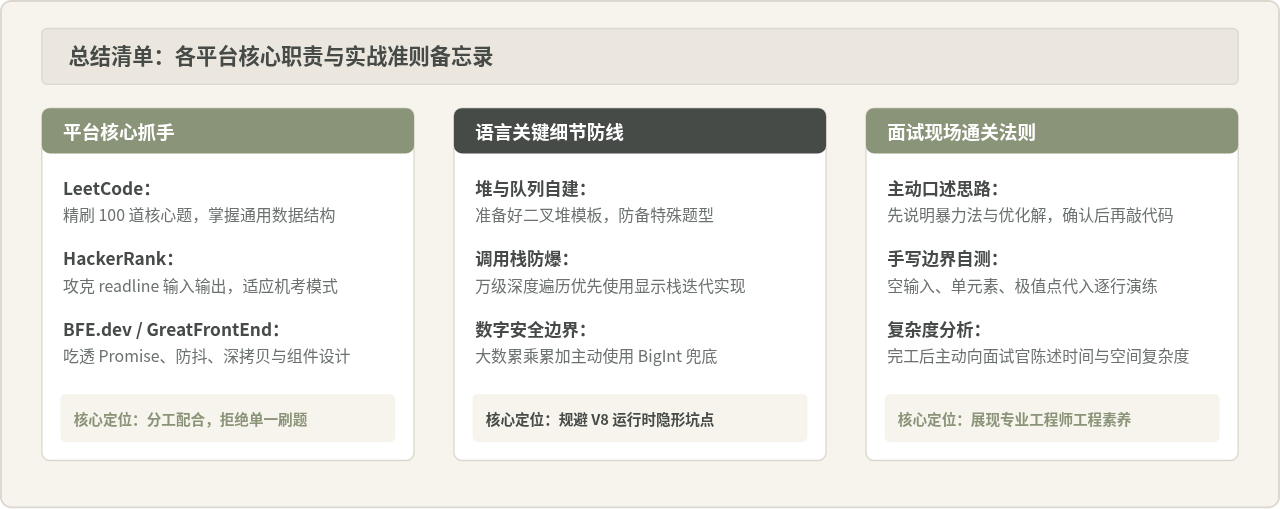
准备 JavaScript 刷题与面试不是单纯追求“做题数量”,而是建立“识别问题模型、评估时空复杂度、严谨书写边界代码、清晰口头表达”的完整闭环。在实际执行过程中,牢记以下三条操作建议:
- 严控时间分配:通用算法(LeetCode)与前端专项(BFE.dev)的精力投入比例建议保持在 6:4。既不要全扑在图论与复杂动规中而荒废了核心手写题,也不要只背八股手写而无法通过第一轮自动化算法机考。
- 重视手写代码的可读性:JavaScript 拥有灵活的原型与弱类型特点,但在面试中应尽量避免晦涩的隐式类型转换(如
~~x、+new Date()),多使用语义清晰的变量名、明确的比较操作符===以及严格的边界保护语句。 - 准备好 ACM 模式模板:在正式机考前一周,务必在 HackerRank 或类似平台上完整练习 3 至 5 道包含多行输入与格式化输出的题目,彻底消除因输入输出导致的意外超时或解析错误。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章