
深入解析编译型与解释型语言的本质分界,详细拆解Java分层编译(javac与HotSpot JIT)和JavaScript(V8引擎Ignition与TurboFan)在交付形态、类型确定性、执行链路及优化回退机制上的根本区别。

当前位置:首页 > JavaScript 基础 > 正文
编译型与解释型:Java和JavaScript执行机制的根本区别
作者:资源驿站
时间:2026-10-30
浏览:139
文章目录
编程语言架构
JVM虚拟机
V8引擎
JIT编译器
深度解析
在许多入门教程中,人们常将编程语言简单粗暴地划分为“编译型”(如 C/C++)与“解释型”(如 Python、JavaScript),并将 Java 归入两者的折中范畴。然而,在现代高性能语言运行时的工程实践中,这种静态二分法早已无法准确描述真实的执行过程。Java 与 JavaScript 的根本区别,并不在于“Java 是否生成了文件而 JavaScript 直接运行”,而在于类型约束的确定时机、代码交付与加载的中间形态、以及即时编译器(JIT)在面对推测假设时的优化与回退机制。本文将通过底层执行管线、引擎内部细节与直观图解,彻底澄清两者的本质分界。
一、基础辨析:经典“编译型”与“解释型”的本质边界
要理清 Java 与 JavaScript 的差异,首先必须回到计算机执行程序的物理本质:CPU 只能直接读取并执行由特定指令集构成的机器码(Native Machine Code)。无论是高级语言、脚本还是标记语言,最终都要以某种方式落到机器指令上。经典分类的核心标准,在于高级语言代码转换为本地机器指令的时间节点与执行载体。
- 传统编译型(Ahead-Of-Time, AOT):在程序运行前,由专门的静态编译器将所有源码一次性翻译成目标平台的二进制机器指令,打包成可执行文件。执行时由操作系统直接加载进内存并交由 CPU 运算。其优点是执行效率极高、无运行时翻译损耗;缺点是构建耗时,且生成的二进制文件与特定操作系统和硬件架构深度绑定。
- 传统解释型(Interpreter):运行前不进行任何针对本地机器码的整体翻译,而是由解释器程序实时读取源码文本,一边逐句词法解析、语法分析,一边调用预设的操作逻辑执行。其优点是跨平台能力强、即写即跑;缺点是每次运行都需重复解析文本,缺乏全局优化,执行速度较慢。
- 现代虚拟机与 JIT 混合型:现代工业级语言运行时几乎全部抛弃了纯解释的旧模式。Java 引入了虚拟机构架(JVM),JavaScript 现代引擎(如 Chrome V8、SpiderMonkey)同样引入了多层即时编译(JIT)。两者均结合了“解释器的快速冷启动”与“编译器的峰值吞吐”,但实现路径与边界条件截然不同。
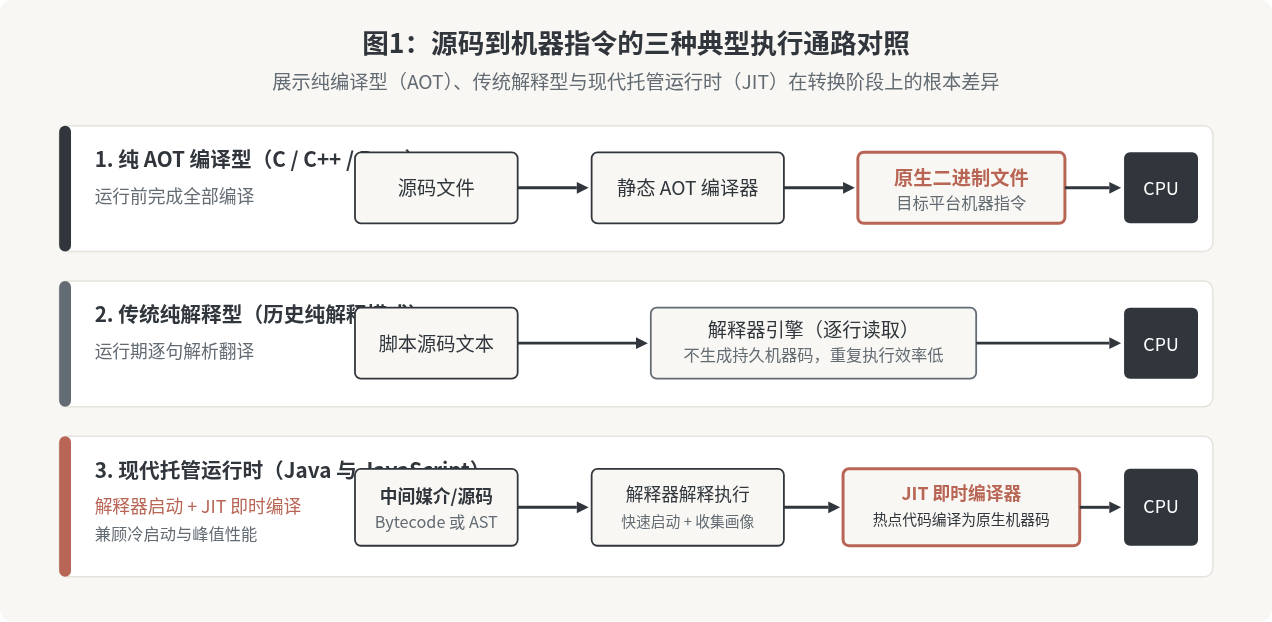
图1:源码到机器指令的三种典型执行通路对照
二、Java 执行机制:两阶段分离与强类型的分层编译
Java 绝非纯粹的编译型,也绝非纯粹的解释型。它的设计哲学源于“一次编写,到处运行”(Write Once, Run Anywhere)。为了实现这一目标,Java 将整个代码生命周期严格划分为两个阶段:离线的静态编译阶段与运行时的虚拟机托管阶段。
1. 第一阶段:javac 静态前端编译
开发人员编写的 .java 源码首先被传递给前端编译器(通常是 JDK 中的 javac)。javac 不会生成任何特定 CPU(如 x86、ARM)的机器指令,而是输出一种标准化的中间表示形式——Java 字节码(Bytecode,即 .class 文件)。
在此阶段,静态类型检查、语法树构建、常量折叠与注解处理已全部完成。所有的变量类型、类结构、接口约束都被固化在 .class 文件的常量池和属性表中。这意味着:在代码进入生产运行环境之前,静态语义与类型结构已经不可动摇。
// 示例:简单数值累加
public class Calculator {
    public int sum(int a, int b) {
        return a + b;
    }
}
通过命令 javac Calculator.java 编译后,使用 javap -c Calculator.class 反编译,可以看到确定性的字节码指令:
// 字节码输出示例(平台无关)
public int sum(int, int);
  Code:
     0: iload_1      // 将第一个 int 参数压入操作数栈
     1: iload_2      // 将第二个 int 参数压入操作数栈
     2: iadd         // 执行 int 类型加法
     3: ireturn      // 返回 int 结果
2. 第二阶段:JVM 运行期的分层编译架构
当执行 java Calculator 时,物理机器上的操作系统并未直接运行该类,而是启动了 Java 虚拟机(JVM,如 HotSpot)。JVM 内部包含三个关键组件:
- 类加载子系统(ClassLoader):负责读取
.class文件的二进制流,进行严格的格式验证、元数据验证、字节码验证与符号引用解析,确保运行安全。 - 解释器(Interpreter):JVM 启动后立即逐条读取字节码指令并执行。解释器无需等待任何机器码编译,因此应用的启动延迟极低。在执行的同时,解释器会维护两个计数器:方法调用计数器(Invocation Counter)和回边计数器(Backedge Counter,用于循环体)。
- JIT 编译器(Just-In-Time Compiler):当某段代码执行频率突破阈值被标记为“热点代码(Hot Spot)”后,后台编译线程介入。现代 HotSpot JVM 采用分层编译策略(Tiered Compilation):
- Tier 1-3(C1 编译器 / Client Compiler):进行局部内联、简单逃逸分析等快速优化,迅速生成机器码并替换解释执行。
- Tier 4(C2 编译器 / Server Compiler / Graal):进行高度激进的全局优化,包括循环展开、全局逃逸分析、去虚化(Devirtualization)以及 SIMD 向量化指令生成,产出峰值吞吐极高的原生机器码。
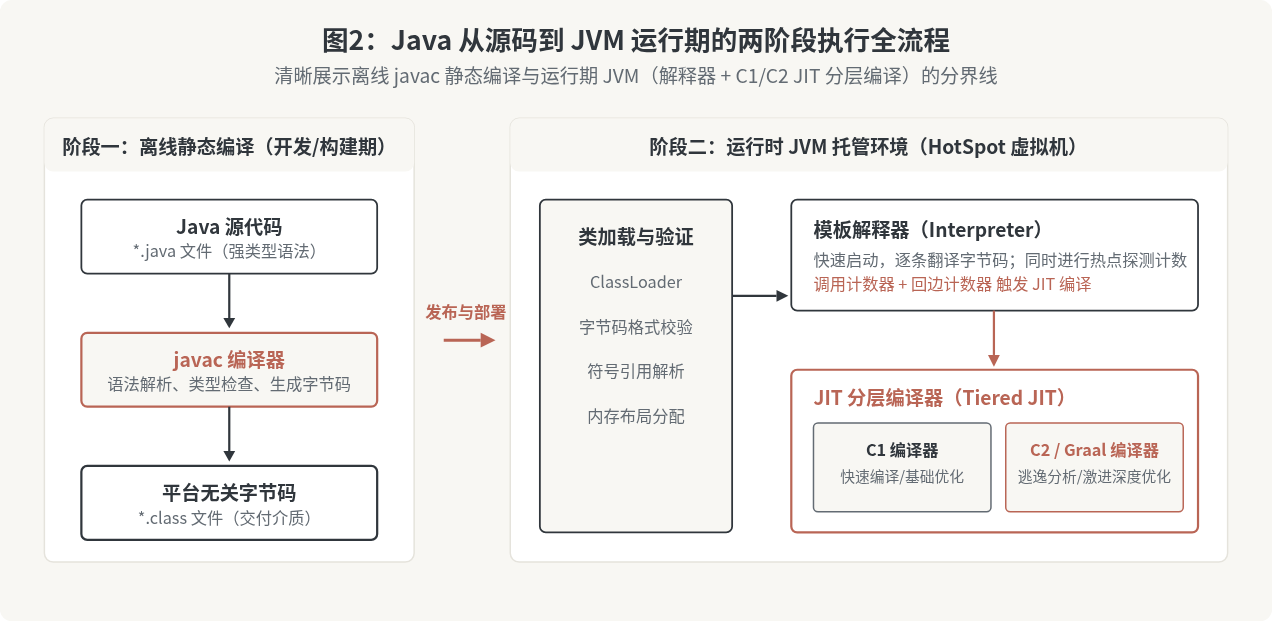
图2:Java 从源码到 JVM 运行期的两阶段执行全流程
三、JavaScript 执行机制:源码即交付与推测性 JIT 引擎
与 Java 形成鲜明对照的是,JavaScript 最初被设计为网页中的轻量级脚本语言。它必须在网络环境中按需加载并即刻呈现。这一历史使命决定了它执行机制的三个核心现实:
- 无预编译交付:服务端分发的是
.js明文源代码(或经混淆压缩的文本),客户端(浏览器或 Node.js)拿到的直接是字符串。 - 动态弱类型:变量的类型在编写时不受约束,运行时可随时赋予任意数据结构,同一个函数参数在连续两次调用中可能是整数、浮点数、字符串甚至对象。
- 无暂停的启动要求:用户打开网页时要求以毫秒级响应,引擎绝不能像 Java 那样花几十秒预热编译,必须即开即跑。
1. 现代 V8 引擎管线(Ignition 与 TurboFan)
以 Google Chrome 与 Node.js 所采用的 V8 引擎为例,其内部摒弃了早期将源码直接全量编译为机器码的笨重方案,建立了一套精密的双轨流水线:
- 词法分析与解析(Scanner & Parser): 引擎下载到 JS 文本后,词法分析器将其打碎为 Token 序列,语法分析器构建出抽象语法树(AST)。由于全量解析大体积 JS 文件会造成卡顿,V8 还会进行“预解析(Pre-parser)”,只对当前必须执行的函数进行完整解析。
- 字节码解释执行(Ignition):
V8 的解释器名为
Ignition。它将 AST 编译为精简的 V8 内部字节码,并立即启动执行。这一步极大压缩了内存占用,并保证了首屏渲染的毫秒级速度。 - 类型画像收集(Type Feedback):
在 Ignition 逐行解释字节码的过程中,它会在一个称为 反馈向量(Feedback Vector) 的数据结构中悄悄记录每个操作槽点的动态类型信息。例如:某个加法操作
a + b,在过去一万次循环中,输入的a和b是否全部都是 32 位整型(Smi)? - 推测优化编译(TurboFan):
一旦函数被判定为高频热点,优化编译器
TurboFan启动。TurboFan 不会走缓慢的多态通用逻辑,而是基于反馈向量做出“乐观推测假设”(Speculative Optimization):假设未来的调用依然全都是整数!于是直接生成跳过类型检查、直接使用 CPU 寄存器做加法的高性能原生机器指令。
2. 动态类型最大的隐患:去优化(Deoptimization)
推测优化赋予了 JavaScript 接近原生语言的峰值算力,但这也是它与 Java 最脆弱的区别所在。因为 JavaScript 是动态语言,任何代码都无法在语法层面保证调用者遵守约定。
// 示例:类型突变触发去优化
function calculateTotal(price, tax) {
    return price + tax;
}

// 阶段一:前 100,000 次调用传入纯数字,Ignition 收集到全是 Number 的类型画像
// TurboFan 介入,生成基于整数/浮点直接相加的优化机器码
for (let i = 0; i < 100000; i++) {
    calculateTotal(100, 15);
}

// 阶段二:突变调用!传入字符串
// 此时 TurboFan 生成的机器码中预设的类型守护检查(Type Guard)失败!
calculateTotal(100, "15"); // 发生 Deoptimization(去优化)!
当传入 "15" 时,CPU 执行机器指令里的前置类型断言,发现入参并非数字。此时机器码无法继续执行,V8 必须立即触发 去优化(Deopt):中断机器码执行,将当前的物理寄存器与栈状态翻译恢复为字节码栈帧,回退(Bailout)到 Ignition 解释器继续执行字符串拼接。频繁的去优化会导致严重的 CPU 颠簸,这也是为什么不规范书写的 JS 代码性能极不稳定的根本原因。
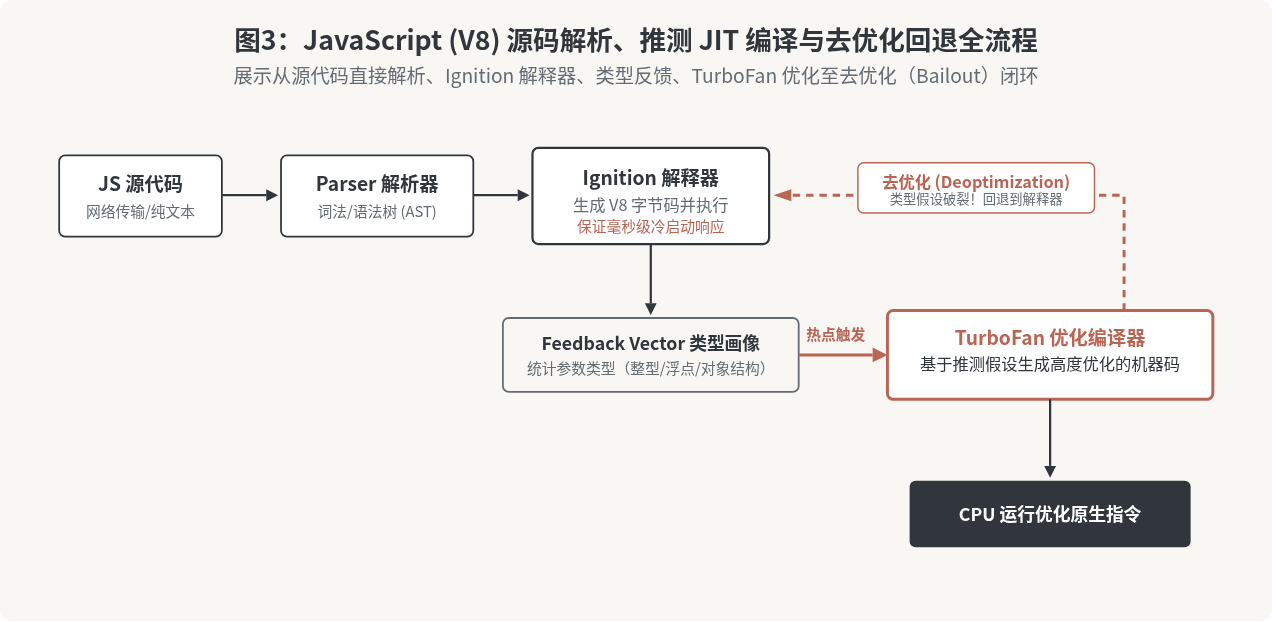
图3:JavaScript (V8) 动态编译、推测优化与去优化 (Deopt) 流程
四、核心对决:Java 与 JavaScript 执行机制的根本区别
至此,我们可以提炼出两门语言在执行层面的三个深层根本区别。这不仅是语法差异,更是两种完全不同计算范式与工程权衡的直接体现:
区别一:交付形态与代码分发的物理边界
Java 交付的是强类型的中间二进制字节码(Bytecode),而 JavaScript 交付的是源码字符流。
Java 开发者在本地或 CI/CD 流水线上使用 javac 完成了语法树构建、符号化和类型校验。部署到服务器上的 jar 包已经完全去除了源码冗余,JVM 在拿到字节码时,不需要重新对 Java 语法做词法分析。
而 JavaScript 必须把源码文本直接推送到终端。每一个用户的浏览器在执行脚本前,都必须重复消耗 CPU 资源去读取字符串、做 Tokenization 并构建 AST。为了缓解这一开销,现代引擎才引入了诸如 V8 Code Cache(缓存编译后的字节码到磁盘)等优化手段,但依然无法改变其交付起点是源码的事实。
区别二:类型系统的存在时机与 JIT 优化的稳定性
Java 的 JIT 优化基于绝对的静态契约,而 JavaScript 的 JIT 优化基于脆弱的统计推测。
在 Java 中,一个声明为 int add(int a, int b) 的方法,任何调用方都绝对不可能传入一个 String,因为编译器和类加载器会直接拦截这种非法操作。因此,C2 编译器在生成机器码时,不需要插入防御性的类型守卫(Type Guard),可以放心地应用激进的指令向量化和寄存器分配,优化结果稳如磐石。
在 JavaScript 中,没有任何静态保护。哪怕写了 TypeScript,TypeScript 的类型也在编译为 JS 后被全量擦除(Type Erasure)。V8 的 TurboFan 必须在生成的每一段优化机器码中插入类型断言指令。一旦后续调用违背了先前的统计假设,就会立即触发去优化(Deoptimization),导致性能瞬间跌落。
区别三:启动延迟、内存模型与稳态吞吐量的取舍
Java 追求极致的长期稳态吞吐(Throughput),JavaScript 追求极快的瞬时冷启动与极低首屏延迟。
Java 的 HotSpot JVM 是为长时间运行的后台服务设计的。它不在意启动耗时是 500 毫秒还是 3 秒(虽然现在有 GraalVM Native Image 解决冷启动),它愿意在运行时投入大量的 CPU 线程进行深度的 C2 逃逸分析与全局内联,最终达到逼近甚至偶尔超越 C++ 的吞吐性能。
JavaScript 是为高交互环境设计的。用户无法容忍网页白屏等待脚本编译。因此 V8 必须在“内存占用”、“解析时间”和“执行效率”之间反复权衡。它的解释器 Ignition 专门为轻量和秒开优化,TurboFan 编译也往往局限在单个函数的局部推测,极力避免全局深层优化带来的延迟阻塞。
常见认知误区提醒:TypeScript 改变了 JavaScript 的执行机制吗?
答案是否定的。很多初学者误以为使用 TypeScript 之后,代码就会像 Java 一样被“静态编译”。事实上,TypeScript 仅仅是一个开发期的语法检查工具。在最终构建产物中,所有的 interface、type 声明全部被剔除,运行在 V8 引擎内部的依然是彻头彻尾的动态弱类型 JavaScript。引擎内部依然要经历 Ignition 收集反馈、TurboFan 乐观推测与可能的 Deopt 过程。
五、全景矩阵总结与选型视角
回顾两者在执行机制上的演进,现代语言执行架构正呈现出明显的收敛趋势:纯解释由于效率低下已基本退出高性能场景,而 JIT 与 AOT 正在相互融合。例如 Java 领域推出了基于 SubstrateVM 的 GraalVM Native Image(支持将 Java 直接编译为 AOT 机器码),而 JavaScript 领域也在服务端构建阶段引入了 Bytecode Cache。然而,两者的设计基因依旧泾渭分明。
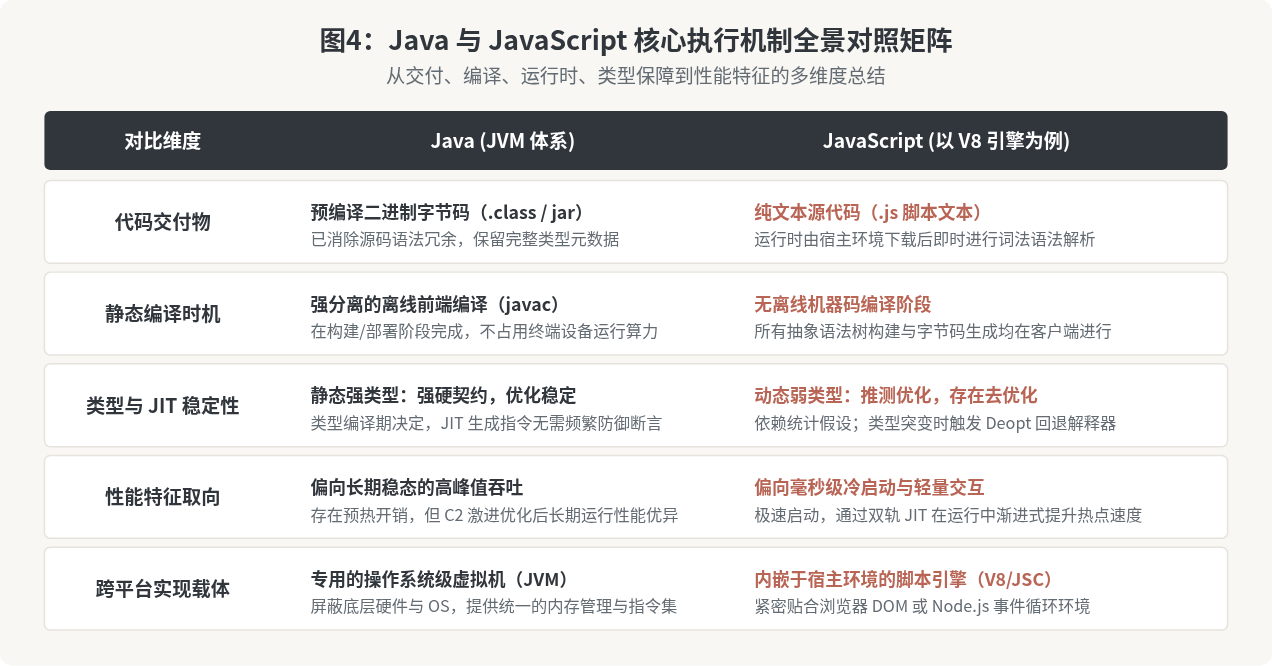
图4:Java 与 JavaScript 核心执行机制全景对照矩阵
理解了这层本质区别,程序员在面对不同技术栈选型与性能调优时便有了清晰的底层坐标系:写 Java 时,优化重心往往在于对象生命周期管理、降低 GC 停顿与设计友好的数据结构以便 JIT 内联;而写 JavaScript 时,优化重心则在于保持函数参数的单态性(Monomorphic,即输入参数结构稳定不变),避免触发昂贵的去优化陷阱。两门语言看似都带有“编译”与“解释”的影子,却分别在静态契约与动态灵活性的两端,走出了各自独特的工业化演进之路。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章