
深入对比JavaScript中手写冒泡排序与内置Array.prototype.sort()的核心差异,从算法原理、底层实现、默认行为、性能复杂度以及工程实践选型进行系统剖析。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JavaScript手写冒泡排序与Array.sort()有什么区别
作者:木棉
时间:2026-10-30
浏览:353
文章目录
在 JavaScript 开发中,排序是一项基础且频繁出现的需求。手写冒泡排序通常是初学者接触算法时的第一个范例,而 Array.prototype.sort() 则是日常工程中直接调用的标准库方法。两者的核心区别在于:冒泡排序是一种以教学与概念演示为主的基础算法,通过相邻元素两两比较逐步将极值“浮”出序列,时间复杂度固定为 O(n²);而 Array.sort() 是由 JavaScript 引擎原生实现的工业级混合排序算法(在现代 V8 等引擎中通常基于 Timsort),具备 O(n log n) 的优秀性能,但在默认使用时会将元素转换为字符串字典序比较。本文将从算法原理、实现机制、默认行为以及性能与场景等维度,系统拆解两者的本质差异。
一、手写冒泡排序的运作机制与代码实现
冒泡排序(Bubble Sort)的核心逻辑非常直观:反复遍历待排序的数组,依次比较两个相邻的元素,如果它们的顺序错误(例如前一个元素大于后一个元素),就将它们互换位置。每次遍历之后,当前范围内的最大值就会像气泡一样浮动到序列的末尾。随着循环的推进,末尾已排序的区间逐渐增大,未排序区间逐渐收缩,直至整个序列有序。
在 JavaScript 中,一个包含提前终止优化的手写冒泡排序实现如下:
function bubbleSort(arr) {
  // 为了不修改原数组,可以先复制一份,也可以直接原地排序
  const result = [...arr];
  const len = result.length;

  for (let i = 0; i < len - 1; i++) {
    let swapped = false;
    // 每一轮比较之后,末尾 i 个元素已经处于正确位置
    for (let j = 0; j < len - 1 - i; j++) {
      if (result[j] > result[j + 1]) {
        // 交换相邻两个元素
        const temp = result[j];
        result[j] = result[j + 1];
        result[j + 1] = temp;
        swapped = true;
      }
    }
    // 如果某一轮遍历没有任何交换,说明数组已经有序,提前退出
    if (!swapped) break;
  }

  return result;
}

// 示例调用
const numbers = [5, 2, 8, 1, 4];
console.log(bubbleSort(numbers)); // 输出示例: [1, 2, 4, 5, 8]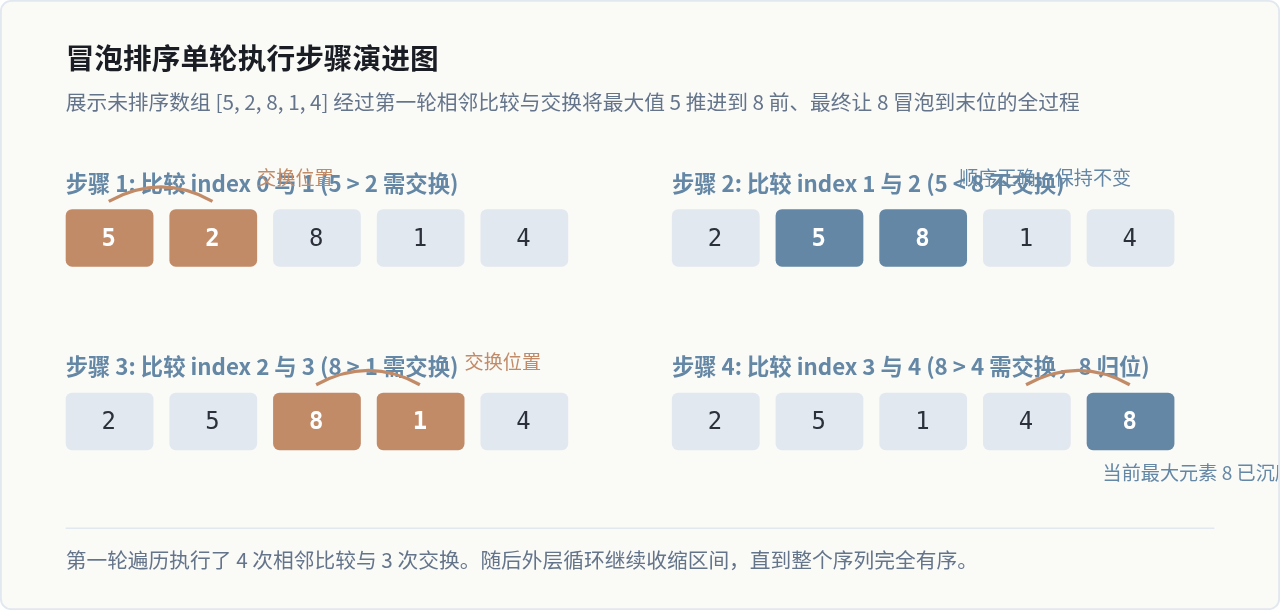
二、Array.prototype.sort() 的底层原理与设计机制
与简单的双重循环冒泡不同,Array.prototype.sort() 是 ECMAScript 标准定义的数组原型方法。在底层,各大浏览器和 Node.js 的 JavaScript 引擎(如 Google V8、Mozilla SpiderMonkey、WebKit JavaScriptCore)都为其提供了高度优化的 C++ 原生实现。
在较早的 V8 引擎版本中,Array.sort() 采用混合排序策略:当数组长度小于等于 10 时使用插入排序(Insertion Sort),大于 10 时使用快速排序(QuickSort)。但自 V8 v7.0(以及 ECMAScript 2019 标准确立排序必须是“稳定排序”以来),V8 全面切换到了 Timsort 算法。
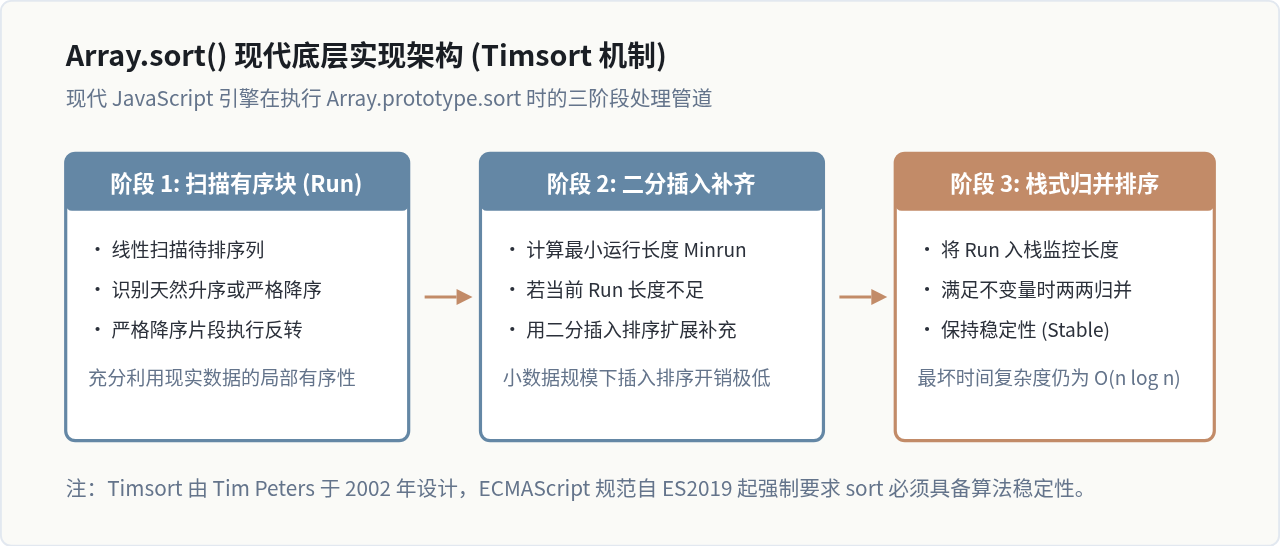
Timsort 是一种源自 Python 的自适应混合排序算法,结合了插入排序与归并排序的优势:
- 分区识别(Run Detection):算法首先扫描数组中已经天然有序(升序或严格降序)的连续片段(称为 Run)。如果是严格降序则反转为升序。
- 二分插入扩展(Minrun Padding):如果连续片段的长度小于最小运行长度(Minrun),算法会通过二分插入排序将后续元素合并进来,填满到最小规格。
- 平衡归并(Stack Merge):将生成的各个 Run 压入调用栈,根据严格的长度比例规则进行两两归并,确保归并树高度受控,避免最坏情况的性能退化。
三、核心差异对比:默认行为、类型陷阱与原地修改
在日常编码中最容易让开发者产生困惑的,并非冒泡与 sort() 的循环结构,而是 Array.sort() 的默认排序行为以及原地修改特性。
1. 默认排序行为与类型转换陷阱
在手写冒泡排序时,我们通常使用数值比较运算符(如 result[j] > result[j + 1]),比较遵循数值大小规则。然而,Array.prototype.sort() 在不传入自定义比对函数(compareFunction)时,会先将数组元素隐式调用 toString() 转换为字符串,然后按照 UTF-16 码元顺序(字典序) 进行排序。
这就导致了经典的数字排序陷阱:
const scores = [10, 5, 40, 25, 1000, 1];

// 错误示范:直接调用 sort()
scores.sort();
console.log(scores);
// 输出结果: [1, 10, 1000, 25, 40, 5]
// 原因分析: '1000' 以 '1' 开头,在字典序中排在 '25' 和 '5' 前面

// 正确示范:传入比较函数
scores.sort((a, b) => a - b);
console.log(scores);
// 输出结果: [1, 5, 10, 25, 40, 1000]
注意事项:使用
Array.sort() 对数字数组排序时,务必提供 (a, b) => a - b 比较函数。若返回值小于 0,则 a 排在 b 前;若等于 0 则保持原序;若大于 0 则 b 排在 a 前。
2. 原地修改(In-place Mutation)与纯函数设计
手写排序算法时,开发者可以自主决定是修改入参还是返回新数组(如使用 [...arr] 实现不可变更新)。而 Array.prototype.sort() 是一个破坏性方法(Mutating Method),它会直接在原有内存地址上调整数组元素的位置,同时返回原数组的引用。
const original = [3, 1, 2];
const sorted = original.sort((a, b) => a - b);

console.log(original === sorted); // true
console.log(original);            // [1, 2, 3],原数组已被篡改!

// 若需保持原数组不变,现代 JavaScript 提供了 toSorted() 方法(ES2023+):
const pureSorted = original.toSorted((a, b) => a - b);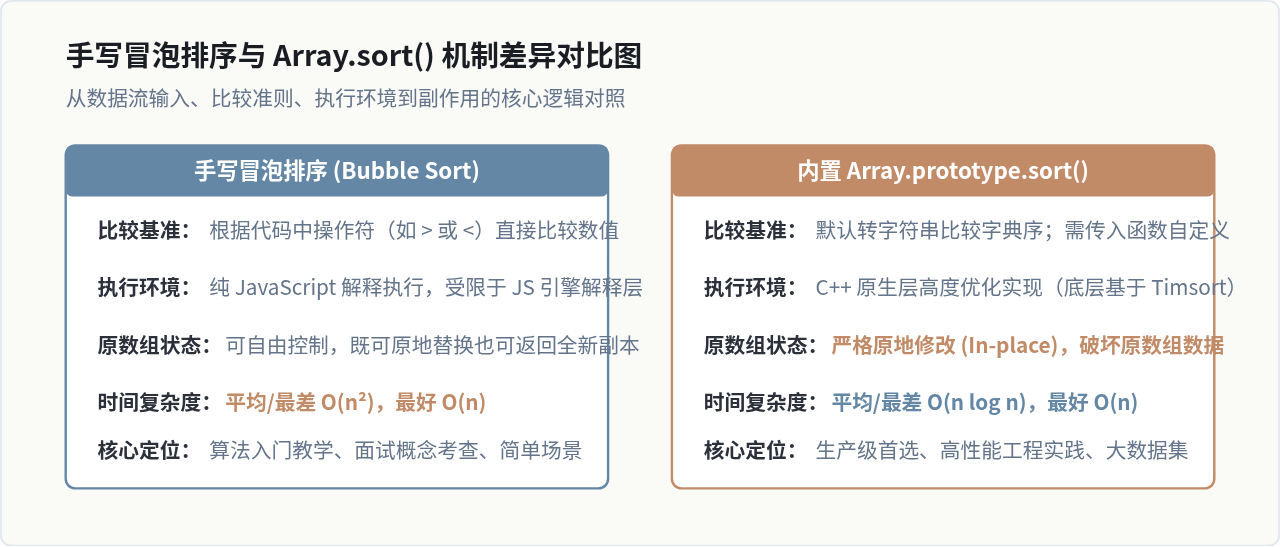
四、时间复杂度与实际性能对比
在算法效率方面,两者的理论上限与实际执行开销存在数量级上的差距。下表汇总了两者的关键技术指标:
| 对比维度 | 手写冒泡排序(Bubble Sort) | Array.prototype.sort()(现代引擎实现) |
|---|---|---|
| 核心算法类型 | 简单交换排序 | 自适应混合排序(Timsort / 归并+插入) |
| 最好时间复杂度 | O(n)(经过提前终止标记优化) | O(n)(数组已完全有序) |
| 平均时间复杂度 | O(n²) | O(n log n) |
| 最坏时间复杂度 | O(n²)(逆序数组) | O(n log n) |
| 空间复杂度 | 原地 O(1),复制副本 O(n) | O(n)(Timsort 归并时需要辅助内存栈) |
| 算法稳定性 | 稳定(相邻相等元素不交换) | 稳定(ES2019 起规范强制保证) |
| 执行环境开销 | JS 解释器循环,大量的内存读写与判断 | C++ 原生指令执行,底层优化高度成熟 |
当数组元素规模增长时,O(n²) 与 O(n log n) 的计算量增长速度截然不同:
- 当数据量
n = 1,000时,冒泡排序的比较次数上限约为 1,000,000 次,而Array.sort()仅需约 10,000 次操作。 - 当数据量达到
n = 100,000时,冒泡排序的计算量逼近 100 亿次,会导致 JavaScript 主线程彻底卡死(浏览器页面无响应),而Array.sort()耗时仅需数十毫秒。
五、开发决策与选型总结
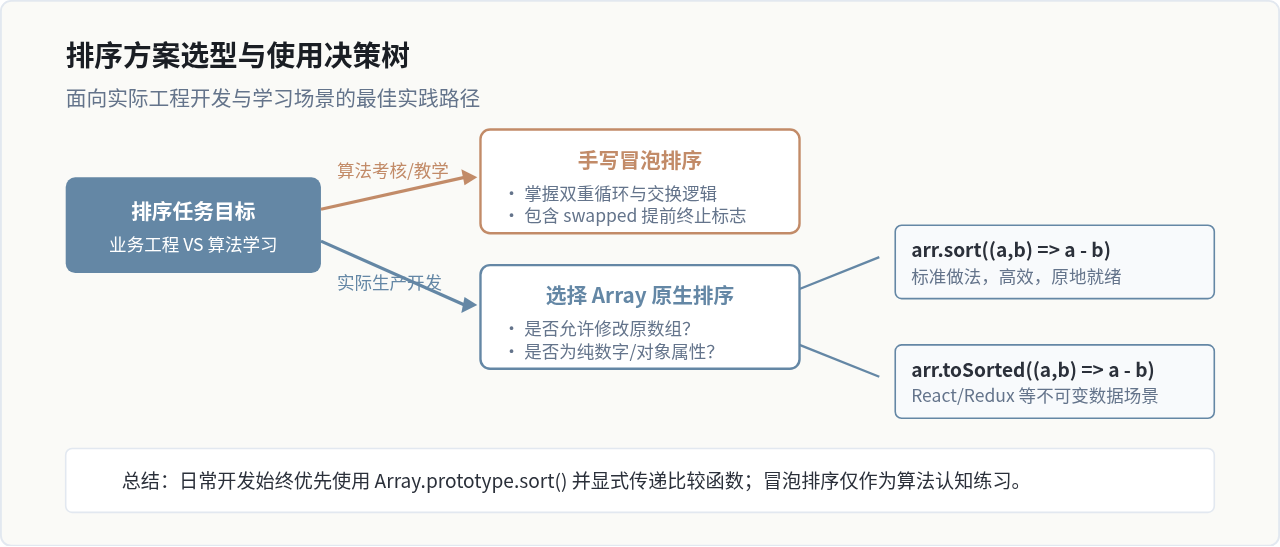
理解了上述原理与机制后,我们在实际项目开发与学习中应当如何选择?我们可以通过以下决策路径来进行判断:
综上所述,手写冒泡排序与 Array.sort() 存在于完全不同的应用维度:
- 手写冒泡排序的价值在于理解算法思维。它展示了如何用基础的循环和分支逻辑实现数据重排,帮助开发者建立对时间复杂度(O(n²))和空间换时间概念的直观认识。在实际业务开发中,应避免使用冒泡排序。
Array.prototype.sort()是生产环境下的唯一标准选择。它依托底层的 Timsort 算法,兼具极致的 O(n log n) 速度与算法稳定性。但使用时必须牢记两个原则:始终传入数值比较函数以规避字符字典序陷阱,以及警惕原地修改对调用方数据源的影响。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章