

本文介绍如何使用Node.js批量重命名Hexo博客文章文件。通过读取指定目录下的Markdown文件,解析文件头部包含的日期和标题信息,拼接生成新文件名,并利用fs模块完成文件重命名操作,解决文章数量多时管理困难的问题。
前言
Node.js批量重命名Hexo博客文章文件
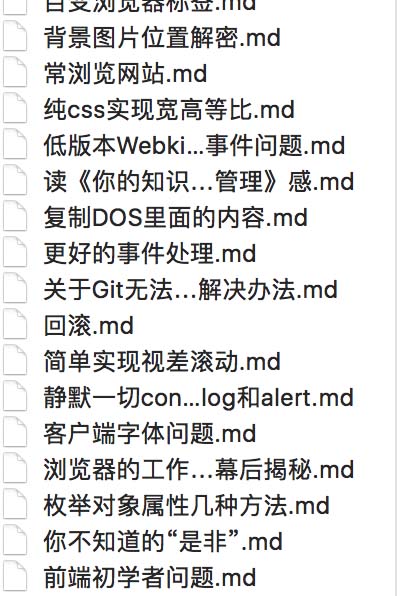
近期更换了博客主题,今早开始处理文件命名规范。Hexo生成的文章默认存放在_post文件夹中,随着文章数量增加,管理变得不便。因此,计划将文件名统一格式化为“日期+文章标题”。
更改前:
更改后:
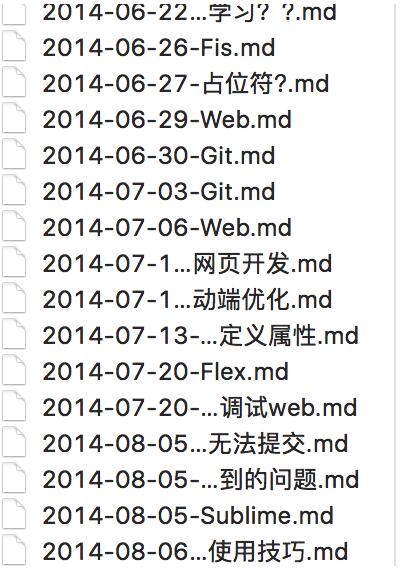
现有文章共90篇,人工逐一修改效率低下,因此编写程序来自动化完成这一机械性任务。
实现该任务的关键在于获取文章的时间戳和标题信息。
文件名由这两部分组成。Hexo在生成文章时,文件内容中已包含时间信息:
title: Nodjs重命名文件
date: 2017-03-05 08:57:47
categories:
 - nodejs
 - javascript
tags:
因此,处理流程明确如下:
1. 读取文章内容
2. 提取时间
3. 拼接时间和文章标题
代码整体思路:
1. 读取指定目录下的文件内容
2. 按行分割内容,提取所需信息
3. 拼接时间+标题
在整行读取内容遇到一些问题,查了文档nodejs好像有 https://nodejs.org/api/readline.html ,但我没有用直接用 了一个偷懒的方法分割内容:
data.toString().split('\n')这样便得到了一个以换行符\n为分隔符的数组。
涉及的方法:
readdirSync readFile rename以下是具体代码实现:
/*
* @Author: zhuxy
* @Date: 2017-03-05 08:05:39
* @Last Modified by: zhuxy
* @Last Modified time: 2017-03-05 09:23:35
*/
const fs = require('fs');
let path = 'your/path';
let files = fs.readdirSync(path);
for(let i = 0; i < files.length; i++){
 fs.readFile(`${path}/${files[i]}`,function(err,data){
  // console.log(data.toString().split('\n')[0].split(' ')[1])
  // console.log(data.toString().split('\n')[1].split(' ')[1])
  let newname = data.toString().split('\n')[1].split(' ')[1] + '-' + data.toString().split('\n')[0].split(' ')[1].replace(/['|']/g,'')
  fs.rename(`${path}/${files[i]}`,`${path}/${newname}.md`)
 })
}
总结
以上就是本文的全部内容,希望本文的内容对大家的学习或者工作能带来一定的帮助,如果有疑问大家可以留言交流,谢谢大家对本站的支持。