
深入讲解JavaScript变量生命周期、栈堆内存模型,详解数组的增删改查与filter/map/reduce流式处理,以及对象的解构赋值、动态属性、安全访问与深浅拷贝实战。

当前位置:首页 > JavaScript 基础 > 正文
JavaScript基础实例:变量、数组与对象操作代码详解
作者:异步漫步
时间:2026-10-30
浏览:319
文章目录
在 JavaScript 开发中,变量(存储单元)、数组(有序列表)与对象(键值实体)共同构建了数据流通的核心骨架。本文通过具体代码与内存机制切入,详解变量生命周期、不可变数组转换管道以及对象结构化提取模式,帮助读者建立严谨、清晰的数据处理逻辑。
一、变量声明机制与底层内存分布
JavaScript 中有三种变量声明关键字:const、let 与历史上遗留的 var。在现代前端与 Node.js 规范中,推荐默认使用 const,仅在变量确需重新赋值时使用 let,并完全废弃 var。
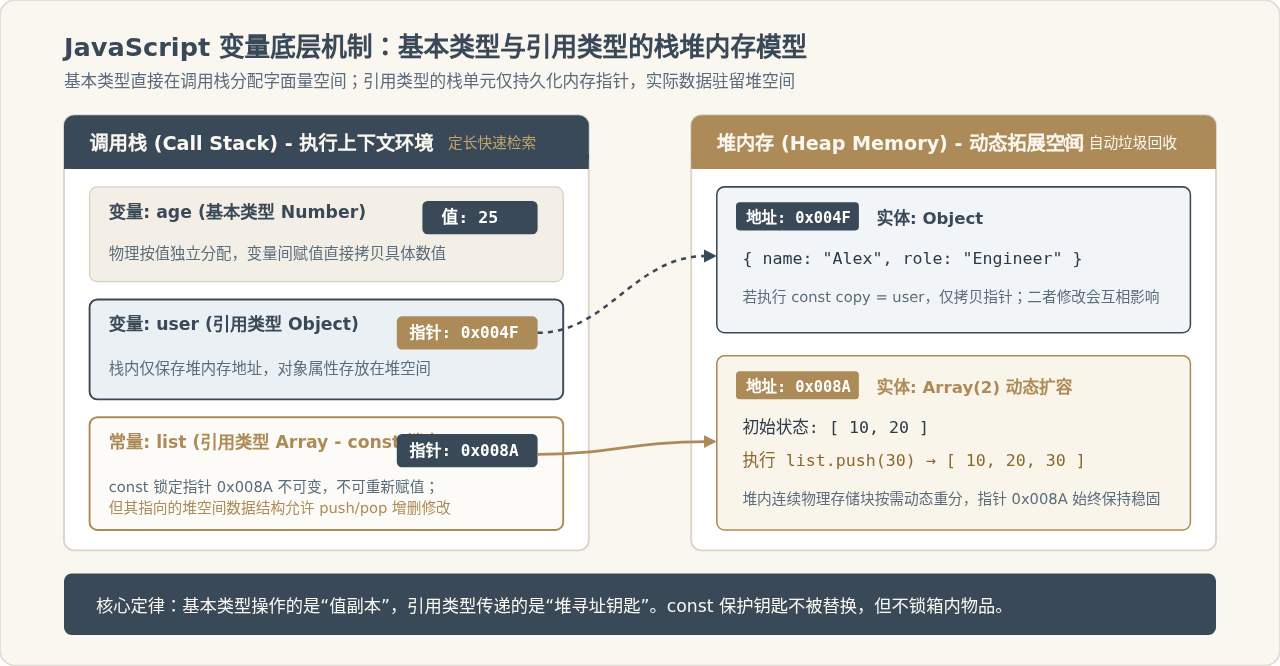
理解变量的第一步在于明确基本数据类型(Number、String、Boolean、Null、Undefined、Symbol、BigInt)与引用数据类型(Object、Array、Function)在计算机内存中的不同存放方式:
- 基本数据类型(按值分配):占用固定大小的内存空间,直接保存在调用栈(Call Stack)的执行上下文中。变量之间相互赋值时,复制的是数值本身的独立副本。
- 引用数据类型(按指针引用):数据体量动态可变,实际内容保存在堆内存(Heap)中;而栈内存中只保存一个指向该堆内存地址的十六进制指针(Reference)。
这种分离机制解释了为什么用 const 声明的对象或数组可以修改其内部属性:const 锁定的仅仅是保存在栈内存中的“指针地址”不可变更,只要指针没有指向新的内存区域,对堆内属性的追加或修改都是合法的。
变量操作代码示例
// 1. 基本类型的独立复制(值传递)
let scoreA = 100;
let scoreB = scoreA; // 复制值 100
scoreB = 85;
console.log(scoreA); // 输出: 100 (scoreA 不受影响)
console.log(scoreB); // 输出: 85

// 2. 引用类型的地址复制(共享堆内存)
const configA = { theme: "dark", fontSize: 14 };
const configB = configA; // 仅复制栈中的引用指针
configB.fontSize = 16;
console.log(configA.fontSize); // 输出: 16 (configA 同步发生变动)

// 3. const 的变量绑定约束
const userList = ["Tom", "Jerry"];
userList.push("Spike"); // 合法:修改堆中数组内容
console.log(userList); // 输出: ["Tom", "Jerry", "Spike"]

try {
  userList = ["NewUser"]; // 报错: TypeError: Assignment to constant variable.
} catch (err) {
  console.log("捕获重赋值错误:", err.message);
}
二、数组核心操作与常用函数式转换管道
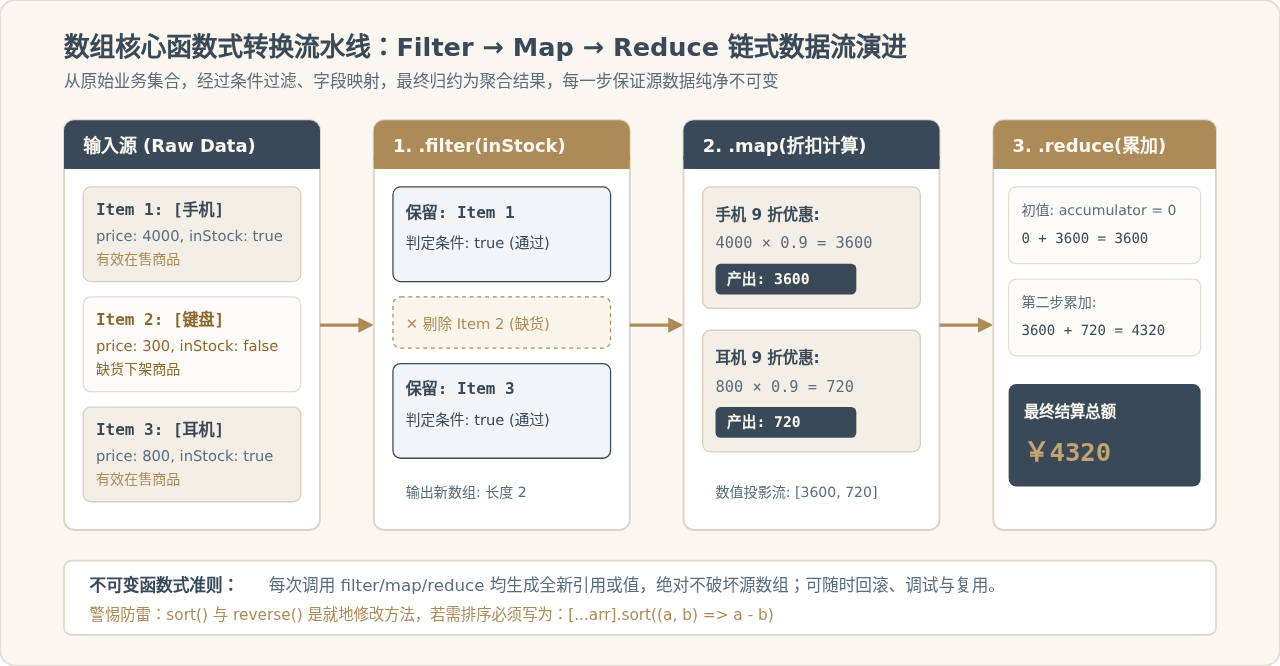
数组在 JavaScript 中是有序的数据集合。在日常业务中,数组操作通常分为两大门派:变异方法(Mutating Methods) 与 不可变纯函数(Immutable / Pure Functions)。
| 方法类型 | 典型 API | 对原数组影响 | 适用业务场景 |
|---|---|---|---|
| 变异方法 | push(), pop(), splice(), sort(), reverse() |
直接修改原数组内部元素 | 局部算法、大型循环中的原地性能优化、状态机内部私有维护 |
| 非变异方法 | slice(), concat(), map(), filter(), reduce() |
保持原数组不可变,返回全新数组或计算值 | React/Vue 响应式状态管理、数据转换管道、链式清洗计算 |
在现代代码中,数据转换管道(Data Transformation Pipeline)是处理列表的核心范式。通过 filter 剔除无效项、map 转换数据形态、reduce 汇总标量指标,可以书写出高内聚、无副作用的纯净代码。
数组操作完整代码示例
// 原始商品数据
const products = [
  { id: 101, title: "4K显示器", price: 2400, inStock: true, tags: ["办公", "数码"] },
  { id: 102, title: "人体工学椅", price: 1200, inStock: false, tags: ["办公", "家居"] },
  { id: 103, title: "机械键盘", price: 600, inStock: true, tags: ["数码", "外设"] },
  { id: 104, title: "无线鼠标", price: 200, inStock: true, tags: ["外设"] }
];

// 1. 不可变增删改模式
// 追加一项(代替 push)
const addedProducts = [...products, { id: 105, title: "升降桌", price: 1800, inStock: true, tags: ["办公"] }];

// 删除 id 为 102 的项目(代替 splice)
const removedProducts = products.filter(item => item.id !== 102);

// 修改 id 为 103 的价格(不可变修改单个属性)
const updatedProducts = products.map(item =>
  item.id === 103 ? { ...item, price: 550 } : item
);

// 2. 链式管道:筛选在售数码商品,享受85折优惠,计算总金额
const finalCartTotal = products
  .filter(item => item.inStock && item.tags.includes("数码"))
  .map(item => ({
    name: item.title,
    discountPrice: item.price * 0.85
  }))
  .reduce((accumulator, currentItem) => accumulator + currentItem.discountPrice, 0);

console.log("数码折后总计:", finalCartTotal);
// 4K显示器(2040) + 机械键盘(510) = 2550

// 3. 数组扁平化与去重(提取所有去重标签)
const allTags = [...new Set(products.flatMap(item => item.tags))];
console.log("全部去重标签:", allTags);
// 输出: ["办公", "数码", "家居", "外设"]
三、对象结构化操作与深浅拷贝实践
对象(Object)是 JavaScript 中表示复合实体的基础容器。熟练掌握解构赋值、计算属性名、安全链式调用以及引用隔离,是编写健壮业务代码的前提。
1. 对象的安全访问与动态解构
在后端接口返回复杂嵌套结构时,常常面临 TypeError: Cannot read properties of undefined 的奔溃风险。现代 JavaScript 提供了两大安全利器:
- 可选链操作符(
?.):在访问属性或调用方法前做安全短路校验,若上一层为null或undefined,直接返回undefined而不抛出运行时异常。 - 空值合并操作符(
??):仅在左侧为null或undefined时采用默认值,能正确保留有意义的假值(如数字0、空字符串""、布尔值false)。
2. 浅拷贝(Shallow Copy)与深拷贝(Deep Copy)
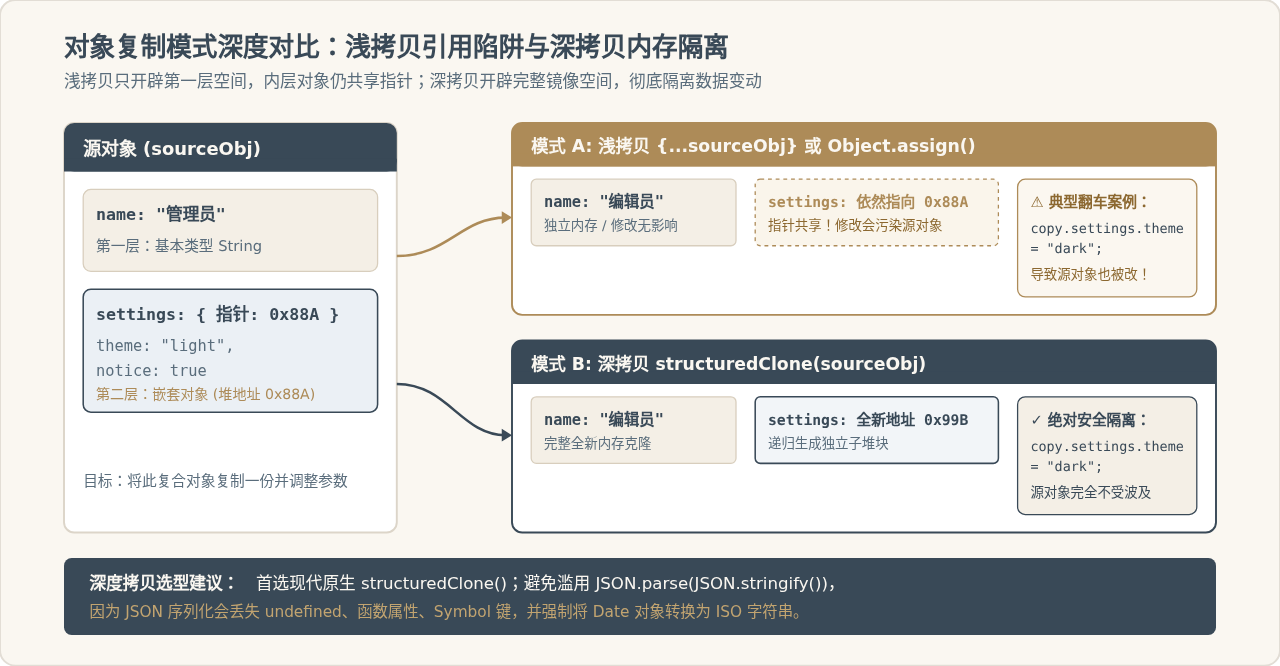
对象赋值 const b = a 仅复制引用指针。若要复制出独立的新对象:
- 浅拷贝(
Object.assign({}, source)或{ ...source }):仅对对象的第一层键值建立新内存副本;如果对象的属性值本身是一个对象或数组,复制的仍是该子对象的指针地址。 - 深拷贝(
structuredClone(source)):现代浏览器与 Node.js 17+ 原生支持的深度克隆标准,会递归地为所有嵌套层级在堆内存中申请全新的存储块,实现彻底的引用解耦。
对象操作代码示例
// 1. 动态键名与解构默认值
const statusKey = "device_status";
const responseData = {
  id: "srv-8080",
  meta: {
    ip: "192.168.1.100",
    port: 3306
  },
  [statusKey]: "online" // 动态计算属性名
};

// 结构提取并设定默认容错值
const {
  id,
  [statusKey]: currentStatus,
  meta: { ip, timeout = 5000 } = {}
} = responseData;

console.log(`服务 ${id} [${currentStatus}] 监听地址: ${ip}:${timeout}`);
// 输出: 服务 srv-8080 [online] 监听地址: 192.168.1.100:5000

// 2. 可选链 ?. 与空值合并 ?? 的安全防护
const rawApiResponse = {
  code: 200,
  payload: {
    user: {
      profile: {
        score: 0 // 注意:0 在逻辑或 || 下会被误当成假值
      }
    }
  }
};

// 危险做法:如果 profile 为空则直接崩溃;使用 || 会将 score: 0 覆盖为 60
const badScore = (rawApiResponse.payload.user.profile.score) || 60; // 错误得到了 60

// 正确做法:
const safeScore = rawApiResponse?.payload?.user?.profile?.score ?? 60;
console.log("真实用户积分:", safeScore); // 正确输出: 0

// 3. 深拷贝与浅拷贝对比验证
const originalAccount = {
  accountName: "admin",
  preferences: { notification: true }
};

// 浅拷贝尝试
const shallowCopy = { ...originalAccount };
shallowCopy.preferences.notification = false;
console.log("原对象被浅拷贝篡改:", originalAccount.preferences.notification);
// 输出: false (污染了源对象)

// 原生深拷贝防护
const safeDeepCopy = structuredClone(originalAccount);
safeDeepCopy.preferences.notification = true;
console.log("深拷贝修改后原对象仍保持:", originalAccount.preferences.notification);
// 输出: false (源对象完全不受影响)
四、综合实战:复合业务状态聚合与报表生成
为了让知识能够直接用于真实项目,下面通过一段完整的端到端实例,演示如何同时运用变量声明、不可变数组清洗以及对象字典聚合,将接口返回的扁平日志列表汇总成按用户划分的业务报表。
/**
 * 业务场景:将服务端原始扁平流水日志,汇总为结构化的用户行为报表
 */
const rawAccessLogs = [
  { userId: "u101", action: "view", duration: 12, valid: true },
  { userId: "u102", action: "click", duration: 3, valid: false }, // 无效日志
  { userId: "u101", action: "scroll", duration: 25, valid: true },
  { userId: "u103", action: "view", duration: 40, valid: true },
  { userId: "u101", action: "view", duration: 18, valid: true },
  { userId: "u103", action: "click", duration: 5, valid: true }
];

function generateUserReport(logs) {
  // 1. 过滤无效记录并生成清洗后数据流
  const cleanLogs = logs.filter(log => log?.valid === true);

  // 2. 使用 reduce 构建用户聚合对象字典
  const reportMap = cleanLogs.reduce((acc, currentLog) => {
    const { userId, action, duration } = currentLog;

    // 若当前用户尚未在字典初始化,设定初始模板
    if (!acc[userId]) {
      acc[userId] = {
        totalDuration: 0,
        actionCounts: {},
        logCount: 0
      };
    }

    // 累加总停留时长与有效记录数
    acc[userId].totalDuration += duration;
    acc[userId].logCount += 1;

    // 统计各 action 触发频次(使用空值合并赋初值)
    acc[userId].actionCounts[action] = (acc[userId].actionCounts[action] ?? 0) + 1;

    return acc;
  }, {});

  // 3. 将聚合对象转换为格式化后的最终展示列表(使用 Object.entries)
  return Object.entries(reportMap).map(([uid, stats]) => ({
    userId: uid,
    averageDuration: Number((stats.totalDuration / stats.logCount).toFixed(1)),
    dominantAction: Object.entries(stats.actionCounts).sort((a, b) => b[1] - a[1])[0][0],
    summary: stats
  }));
}

const finalReport = generateUserReport(rawAccessLogs);
console.log("最终汇总报表结构:", JSON.stringify(finalReport, null, 2));
代码设计要点解析:
1. rawAccessLogs 保持只读不可变,不使用 splice 修改原数组,保证日志溯源的可靠性。
2. 在 reduce 的累加器中,利用对象的哈希检索特性(acc[userId])实现 O(1) 的快速分组查找,避免了在循环中多次使用 find 导致 O(n²) 性能退化。
3. 提取结果时结合 Object.entries() 快速将字典转换为可迭代的键值对数组,方便进一步的排序与数据传输。
五、高频陷阱排查与编码安全指南
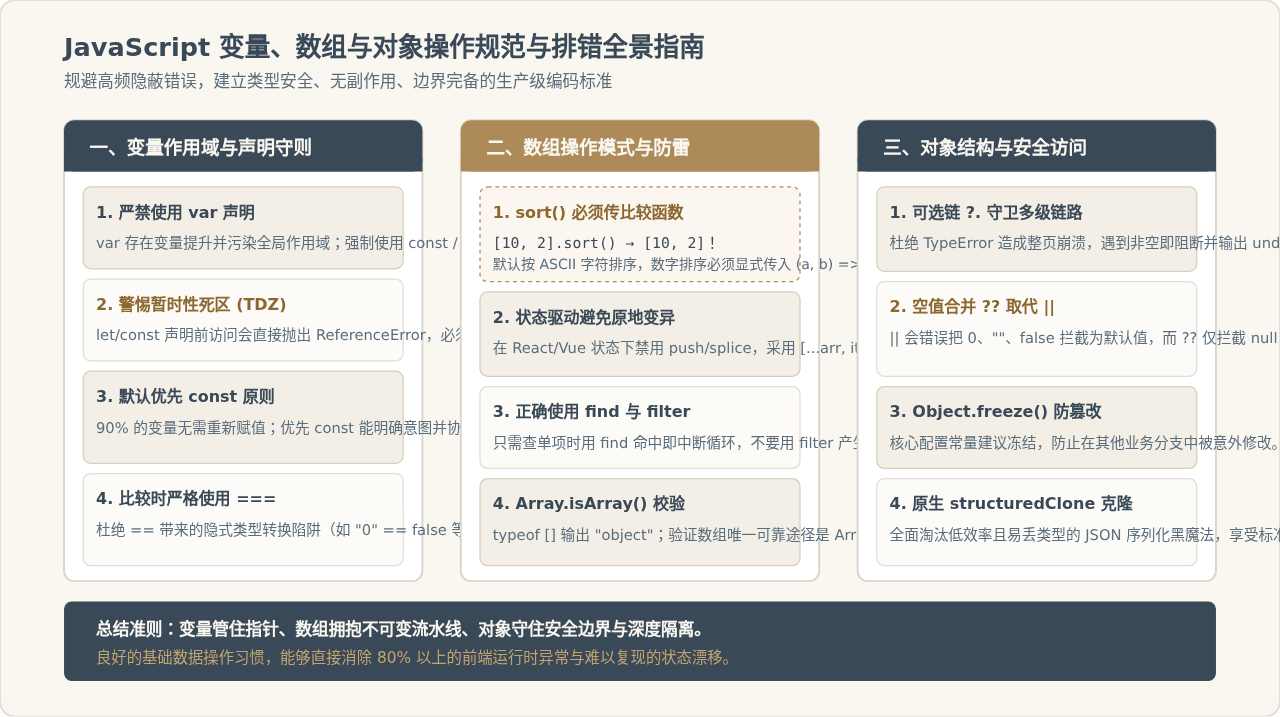
在日常编写变量、数组与对象操作时,开发者最常遇到的几类隐蔽 Bug 及其根本原因总结如下:
经典易错场景提示:关于数组 sort() 的隐式陷阱
执行 [10, 20, 5].sort() 得到的结果是 [10, 20, 5] 而不是 [5, 10, 20]。这是因为 ECMAScript 规范定义 sort() 在不传参时,会将元素转为字符串后按 UTF-16 码元顺序排列(字符 "10" 在 "20" 之前,"20" 在 "5" 之前)。数字排序必须显式编写比较函数:arr.sort((a, b) => a - b)。
六、结语
JavaScript 的数据操作并不复杂,但其灵活性背后依托着明确的运行时规则。从变量的栈堆存储分流,到不可变数组链式转换,再到对象解构与深浅拷贝隔离,掌握这些底层原理能让你在面对复杂的应用状态时游刃有余。在日常编写代码时,多问自己一句“此处是否引入了不必要的引用共享?”,便能写出更加健壮、可靠的工程化代码。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章