
深入讲解JavaScript数组高阶方法map、filter与reduce的原理、执行机制与组合应用,通过具体数据转换实例与内联SVG图解展示完整的数据清洗流程。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JavaScript数组高阶方法实例:map、filter与reduce的数据转换演示
作者:代码拾荒
时间:2026-10-30
浏览:474
文章目录
在前端与Node.js的业务数据清洗中,对后端返回的集合数据进行格式转换、条件剔除和维度聚合是最高频的操作。JavaScript原生提供的 map、filter 和 reduce 是解决此类问题的核心高阶方法。它们遵循函数式编程思想,执行过程均不会修改原始输入数组,而是返回全新结构或汇总值。掌握这三个方法不仅能消除繁琐的命令式 for 循环,还能让复杂的数据流转逻辑清晰可控。
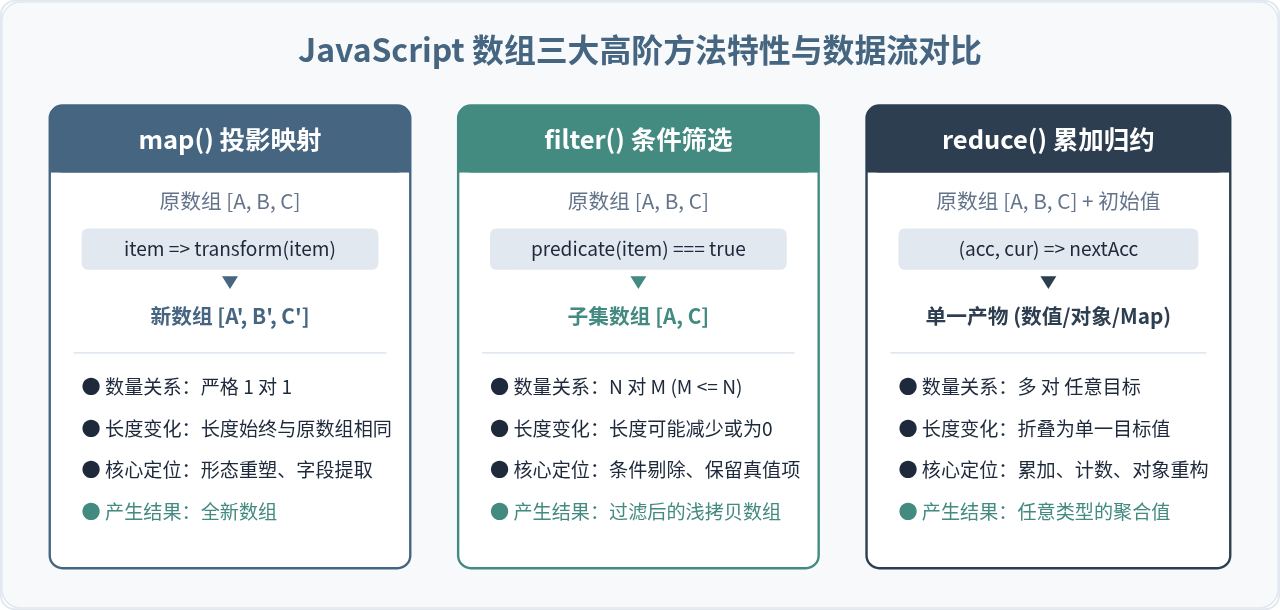
图 1:map、filter 与 reduce 的数据流动模型与职责定位对比
一、map 方法:一对一投影与数据形态转换
map() 方法的主要职责是将输入数组中的每一个元素依次传递给回调函数,并收集回调函数的返回值,最终组合成一个长度完全相同的新数组。
1. 语法规范与回调参数
const newArray = arr.map(function callback(currentValue[, index[, array]]) {
  // 返回映射后的新元素
}[, thisArg]);
回调函数接收三个参数:当前处理项 currentValue、当前项索引 index 以及调用 map 的原数组 array。thisArg 为可选的绑定执行上下文。
2. 实战示例:重构用户展示卡片数据
假设从接口拉取到的用户对象包含冗余字段,且名字被分为了姓与名,价格为分单位。我们需要将其转换为前端卡片直接可用的格式:
// 原始服务端响应数据
const rawUsers = [
  { id: 101, firstName: "张", lastName: "小明", balanceCents: 12500, active: true },
  { id: 102, firstName: "李", lastName: "建国", balanceCents: 450, active: false },
  { id: 103, firstName: "王", lastName: "晓莉", balanceCents: 89000, active: true }
];

// 使用 map 提取所需字段并计算派生数据
const userCards = rawUsers.map((user) => ({
  userId: `UID_${user.id}`,
  fullName: `${user.firstName}${user.lastName}`,
  balanceYuan: (user.balanceCents / 100).toFixed(2),
  statusText: user.active ? "正常服务中" : "已冻结"
}));

// 输出结果示例:
// [
//   { userId: 'UID_101', fullName: '张小明', balanceYuan: '125.00', statusText: '正常服务中' },
//   { userId: 'UID_102', fullName: '李建国', balanceYuan: '4.50', statusText: '已冻结' },
//   { userId: 'UID_103', fullName: '王晓莉', balanceYuan: '890.00', statusText: '正常服务中' }
// ]
注意事项
如果在 map 的回调函数中忘记写 return 语句,新数组中对应位置的项将会是 undefined。另外,如果不需要产生新数组而仅需执行打印、网络请求等副作用,请使用 forEach,不要滥用 map。
二、filter 方法:真值断言与子集筛选
filter() 方法用于通过指定的测试函数过滤原数组。它遍历每个元素,将元素传入回调函数,若回调函数返回真值(Truthly),则该元素被浅拷贝保留到新数组中;若返回假值(Falsy),则予以排除。
1. 语法规范与断言机制
const filteredArray = arr.filter(function callback(element[, index[, array]]) {
  // 返回 true 保留,返回 false 剔除
}[, thisArg]);
2. 实战示例:多维度商品库存过滤
在电商系统中,通常需要筛选出“已上架且库存大于0且评分不低于4.0”的商品:
const inventory = [
  { id: "P1", name: "机械键盘", stock: 15, isPublished: true, rating: 4.8 },
  { id: "P2", name: "无线鼠标", stock: 0, isPublished: true, rating: 4.5 },
  { id: "P3", name: "人体工学椅", stock: 4, isPublished: false, rating: 4.9 },
  { id: "P4", name: "Type-C拓展坞", stock: 50, isPublished: true, rating: 3.8 },
  { id: "P5", name: "高清显示器", stock: 8, isPublished: true, rating: 4.6 }
];

// 筛选符合在售推荐条件的商品
const availableProducts = inventory.filter((item) => {
  const hasStock = item.stock > 0;
  const isOnline = item.isPublished === true;
  const isHighRating = item.rating >= 4.0;
  return hasStock && isOnline && isHighRating;
});

// 输出结果示例:保留了 P1 和 P5,其他均被正确剔除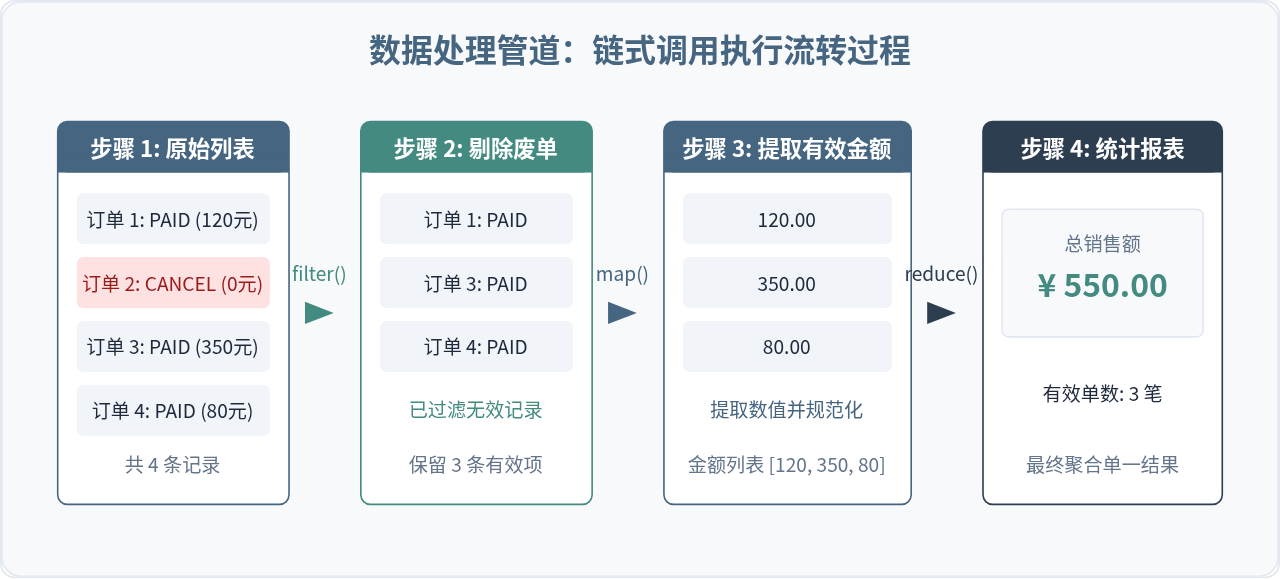
图 2:数据管道链式处理流程(Filter 过滤 -> Map 格式化 -> Reduce 聚合)
三、reduce 方法:累加器机制与多维聚合
reduce() 是数组高阶方法中最强大也最容易让初学者产生困惑的方法。它的核心思想是“折叠归约”:提供一个累加器(Accumulator),让它带着前一次计算的中间结果,依次与当前元素进行计算,并将最终结果返回。
1. 语法规范与初始值设定
const result = arr.reduce(function callback(accumulator, currentValue[, currentIndex[, array]]) {
  // 返回更新后的累加器状态
}[, initialValue]);
注意第二个参数 initialValue(初始值):
- 提供初始值时:
accumulator在第一次循环时取该初始值,currentValue取数组的第一个元素(索引为0),循环次数等于数组长度。 - 不提供初始值时:
accumulator默认取数组的第一个元素,currentValue从数组第二个元素(索引为1)开始遍历。若原数组为空且未提供初始值,运行时会直接抛出 TypeError: Reduce of empty array with no initial value。
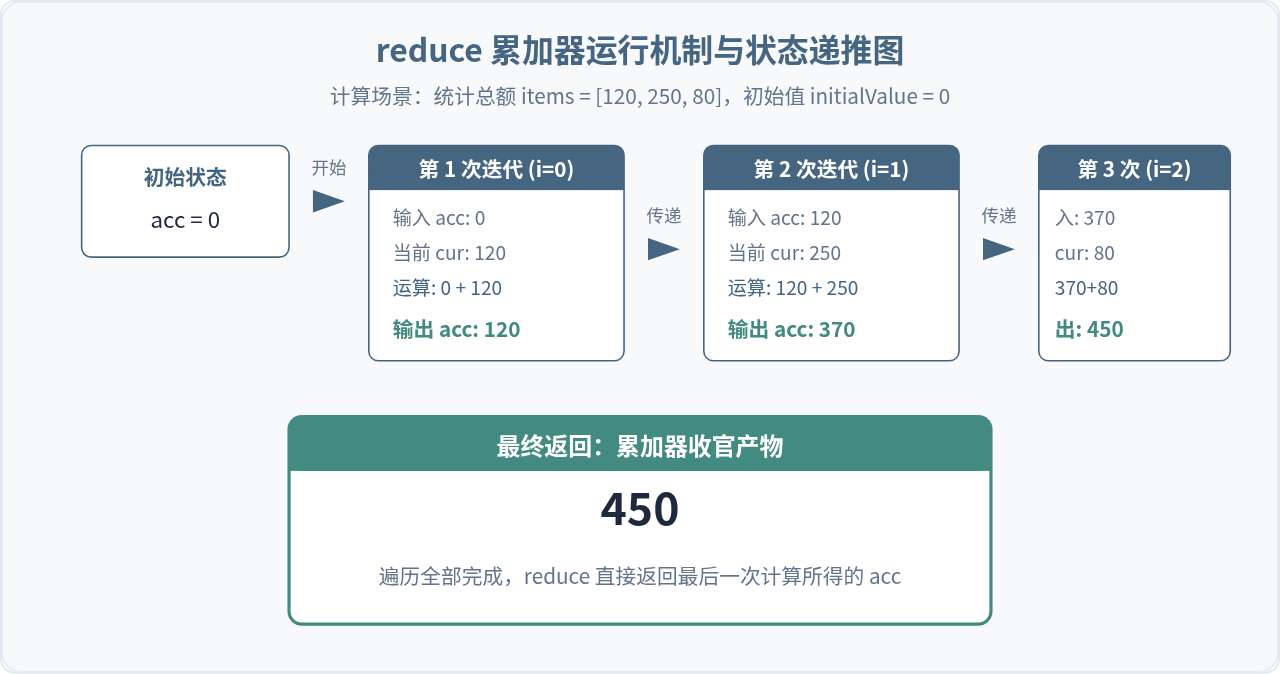
图 3:reduce 方法逐轮累加推进状态递推示意图
2. 实战示例:数组转键值对哈希字典与分类归组
reduce 不仅可以用来累加数字,更强大的用法是重构数据形态,例如将扁平的用户列表按部门分组(GroupBy):
const staffList = [
  { id: 1, name: "Alice", department: "研发部" },
  { id: 2, name: "Bob", department: "市场部" },
  { id: 3, name: "Charlie", department: "研发部" },
  { id: 4, name: "David", department: "设计部" },
  { id: 5, name: "Eva", department: "研发部" }
];

// 将 initialValue 设定为一个空对象 {}
const groupedByDept = staffList.reduce((acc, staff) => {
  const dept = staff.department;
  // 若当前部门的分组数组尚未建立,先初始化为空数组
  if (!acc[dept]) {
    acc[dept] = [];
  }
  // 将当前成员推入对应部门分组
  acc[dept].push(staff.name);
  return acc; // 必须返回更新后的累加器
}, {});

// 输出结果:
// {
//   '研发部': ['Alice', 'Charlie', 'Eva'],
//   '市场部': ['Bob'],
//   '设计部': ['David']
// }
四、综合应用:电商交易记录的管道清洗
在实际工程场景中,单一方法往往无法解决完整的业务需求。通常采用“链式调用”或“单次聚合”的方式协同完成任务。以下演示一段包含状态检查、金额校验、汇率换算与分类汇总的完整数据转换:
// 原始交易记录列表
const transactions = [
  { orderId: "T001", type: "ONLINE", status: "SUCCESS", amountUSD: 45.0, feeRatio: 0.02 },
  { orderId: "T002", type: "OFFLINE", status: "PENDING", amountUSD: 120.0, feeRatio: 0.015 },
  { orderId: "T003", type: "ONLINE", status: "SUCCESS", amountUSD: 300.0, feeRatio: 0.02 },
  { orderId: "T004", type: "ONLINE", status: "FAILED", amountUSD: 85.0, feeRatio: 0.02 },
  { orderId: "T005", type: "OFFLINE", status: "SUCCESS", amountUSD: 210.0, feeRatio: 0.015 }
];

const USD_TO_CNY = 7.25;

// 方案 A:语义清晰的链式调用(Filter + Map + Reduce)
const summaryA = transactions
  // 1. 过滤:只保留支付成功的记录
  .filter((tx) => tx.status === "SUCCESS")
  // 2. 映射:换算人民币净收益 (金额 - 手续费) * 汇率
  .map((tx) => {
    const netUSD = tx.amountUSD * (1 - tx.feeRatio);
    return {
      orderId: tx.orderId,
      type: tx.type,
      netCNY: parseFloat((netUSD * USD_TO_CNY).toFixed(2))
    };
  })
  // 3. 归约:按交易渠道统计笔数与总净额
  .reduce(
    (acc, item) => {
      acc.totalNetCNY += item.netCNY;
      acc.byType[item.type] = (acc.byType[item.type] || 0) + item.netCNY;
      acc.count += 1;
      return acc;
    },
    { count: 0, totalNetCNY: 0, byType: {} }
  );

// 方案 B:一次遍历的极致性能方案(单次 Reduce 完成所有计算)
const summaryB = transactions.reduce(
  (acc, tx) => {
    // 在 reduce 内部直接做守卫判定,跳过未成功的单据
    if (tx.status !== "SUCCESS") return acc;

    const netCNY = parseFloat(((tx.amountUSD * (1 - tx.feeRatio)) * USD_TO_CNY).toFixed(2));
    acc.totalNetCNY += netCNY;
    acc.byType[tx.type] = (acc.byType[tx.type] || 0) + netCNY;
    acc.count += 1;
    return acc;
  },
  { count: 0, totalNetCNY: 0, byType: {} }
);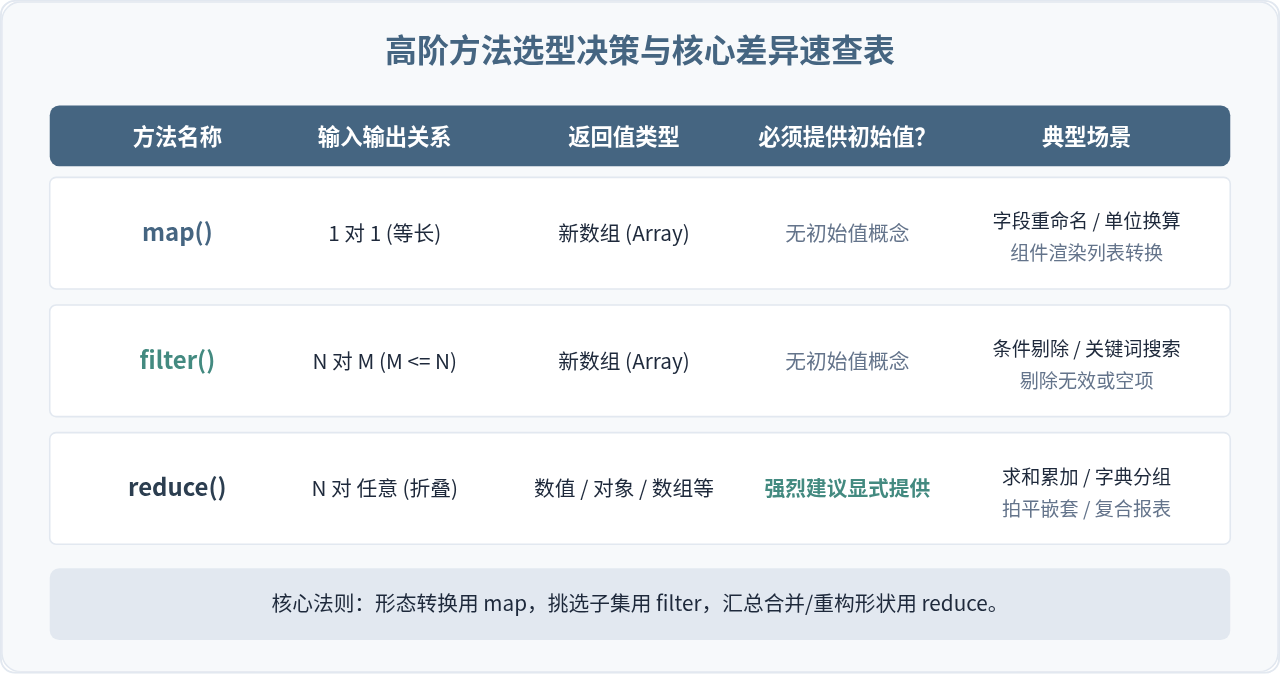
图 4:三大数组高阶方法选型矩阵与核心维度速查总结
五、工程实践常见陷阱与避坑指南
- 不可在 map/filter 中直接使用 async 回调:
arr.map(async (item) => {...})返回的并不是执行结果数组,而是一个包含多个 Promise 对象的数组Promise[]。如果需要等待所有异步操作完成,应配合await Promise.all(...)使用;而在filter中使用async则会导致所有项都被保留,因为每一个生成的 Promise 实例本身在布尔上下文中都是真值(truthy)。 - 大数据量场景下的链式性能权衡:在处理几百到几千条数据时,
filter().map()具有极佳的可读性,中间产生的临时数组开销完全可忽略;但当数据量达到数十万级别时,链式调用会频繁分配大数组内存并产生多次完整遍历。此时应优先使用单个reduce或标准for...of循环合并遍历过程。 - 保持回调函数的纯粹性:高阶方法设计初衷是纯函数转换。避免在
map或filter回调内修改传入的item原对象(若需修改,建议通过解构赋值{ ...item, newProp }返回新对象引用),以防止在应用其他模块中引发隐蔽的状态污染。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章