

本文深入探讨后端Long类型数据传输至前端时因JavaScript Number精度限制导致的精度丢失问题。通过三种策略——字段级@JsonSerialize与@JsonFormat注解、以及全局Jackson ObjectMapper配置,实现Long到String的安全转换,确保订单ID等大数据的完整性与代码可维护性。
前言
在Web开发中,前后端数据类型的不匹配是一个常见挑战,尤其是当后端采用Long等大数据类型时。由于JavaScript中Number类型的精度限制,直接传输大数值可能导致前端精度丢失。本文将深入剖析这一现象,并提供两种行之有效的解决策略。
一、问题背景
在后端开发实践中,为了保障数据的完整性与精确度,开发者常选用Long类型来存储诸如订单ID、用户ID等关键标识。然而,当这些数据经由API接口传输至前端时,受限于JavaScript中Number类型的最大安全整数(2^53-1),一旦Long类型的值超出此范围,便极易引发精度丢失现象。
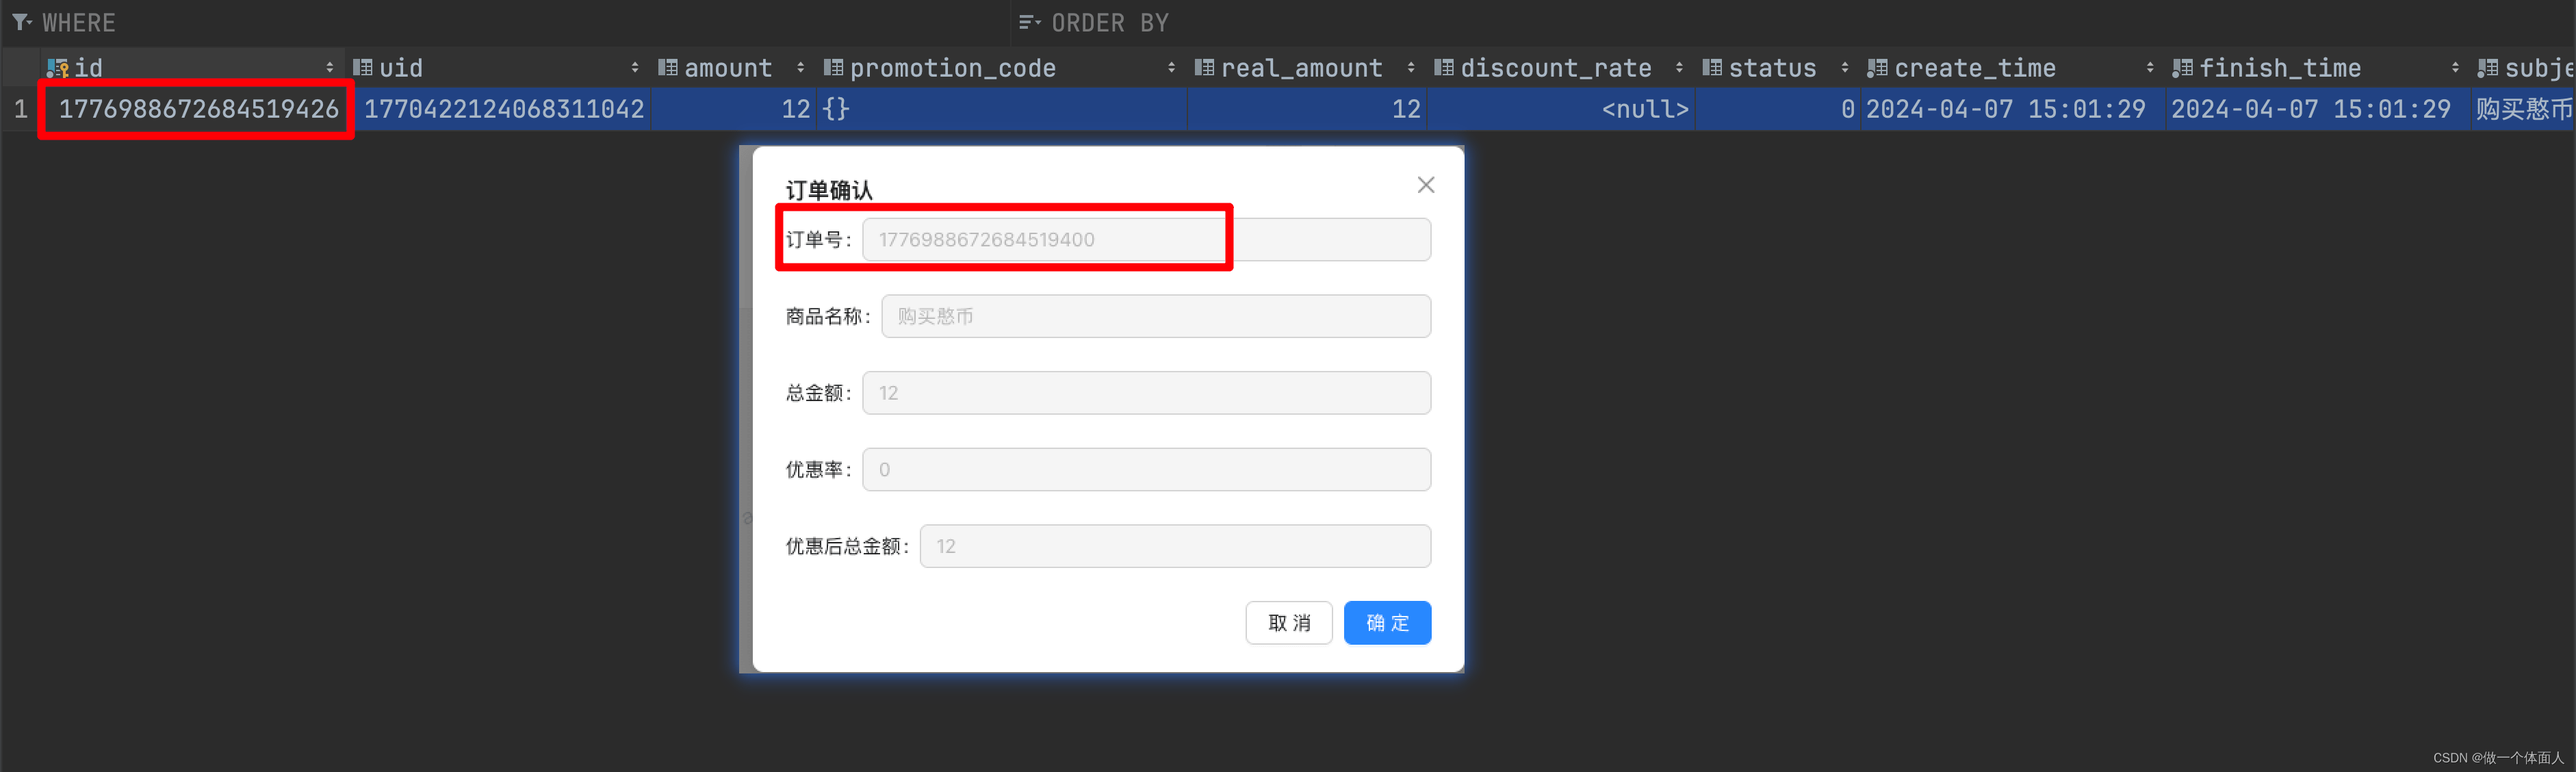
二、解决方法
针对上述精度丢失问题,我们可以从以下几个维度采取解决措施:
方法一:使用@JsonSerialize注解将Long类型转换为String类型
在Java后端开发中,借助Jackson库的注解机制,可以在将Long类型字段序列化为JSON时,强制将其转换为String类型。这种处理方式使得前端接收到的数据以字符串形式呈现,从而从根本上规避了精度丢失的风险。 示例代码如下:
import com.fasterxml.jackson.databind.annotation.JsonSerialize;
import com.fasterxml.jackson.databind.ser.std.ToStringSerializer;
import lombok.Data;

@Data
public class PayOrderVo {

    // 使用ToStringSerializer将Long类型的id字段转换为String类型
    @JsonSerialize(using = ToStringSerializer.class)
    private Long id;

    // 其他字段...
}
通过上述方式,我们能够确保后端返回的JSON数据中,所有Long类型的字段均以字符串形式存在。前端在接收数据后,可直接将其作为字符串进行处理,无需再担忧数值精度问题。
方法二:使用@JsonFormat注解将Long类型格式化为String
除了采用ToStringSerializer外,Jackson框架还提供了@JsonFormat注解,允许开发者自定义字段的序列化格式。当将shape属性设置为JsonFormat.Shape.STRING时,Long类型的字段同样会被格式化为字符串输出。
示例代码如下:
import com.fasterxml.jackson.annotation.JsonFormat;
import lombok.Data;

@Data
public class PayOrderVo {

    // 使用@JsonFormat注解将Long类型的id字段格式化为String
    @JsonFormat(shape = JsonFormat.Shape.STRING)
    private Long id;

    // 其他字段...
}
此方法同样能够确保Long类型的字段在序列化为JSON时以字符串形式出现,有效避免了前端精度丢失的问题。
前两种基于注解的方法确实能有效解决Long类型数据在前后端传输中的精度丢失问题。然而,当项目中存在大量类,且这些类中的多个字段均需将Long类型转换为String类型返回给前端时,逐一为每个字段添加注解不仅操作繁琐,还可能导致代码冗余且难以维护。为了更优雅、高效地解决这一问题,我们可以考虑采用全局配置的方式,一次性解决所有Long类型字段的序列化问题。这样,我们不仅能提高开发效率,还能确保代码的一致性和可维护性。接下来,我们将详细探讨如何通过全局配置来实现这一目标。
方法三:全局配置Jackson将Long类型序列化为String
除了对单个字段进行注解配置外,我们还可以进行全局配置,使得所有Long类型的字段在序列化时都自动转换为String类型。这样可以减少在每个字段上添加注解的重复工作。
示例代码如下:
import com.fasterxml.jackson.databind.ObjectMapper;
import com.fasterxml.jackson.databind.module.SimpleModule;
import com.fasterxml.jackson.databind.ser.std.ToStringSerializer;
import org.springframework.boot.autoconfigure.condition.ConditionalOnMissingBean;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.context.annotation.Primary;
import org.springframework.http.converter.json.Jackson2ObjectMapperBuilder;

@Configuration
public class JacksonConfig {

    @Bean
    @Primary
    @ConditionalOnMissingBean(ObjectMapper.class)
    public ObjectMapper jacksonObjectMapper(Jackson2ObjectMapperBuilder builder) {
        ObjectMapper objectMapper = builder.createXmlMapper(false).build();
        SimpleModule simpleModule = new SimpleModule();
        // 将Long类型序列化为String类型
        simpleModule.addSerializer(Long.class, ToStringSerializer.instance);
        objectMapper.registerModule(simpleModule);
        return objectMapper;
    }
}
在这个配置中,我们创建了一个自定义的ObjectMapper Bean,并注册了一个SimpleModule,该模块使用ToStringSerializer将Long类型序列化为String类型。这样,整个应用中所有Long类型的字段在序列化时都会自动转换为String类型。
三、总结
前端精度丢失问题是一个常见的挑战,但通过上述三种方法,我们可以有效地解决这个问题。在实际开发中,我们可以根据项目的具体情况和需求选择合适的方法。对于需要精确表示大数字的场景,将Long类型转换为String类型是一个简单而有效的解决方案。
到此这篇关于前端精度丢失问题解决之后端Long类型到前端处理策略的文章就介绍到这了,更多相关后端Long类型到前端精度丢失内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!