

本文详解如何使用纯原生JavaScript和Node.js实现大文件分片上传。教程涵盖文件分片、Hash计算、分片合并、秒传验证及断点续传五大核心功能,通过分步迭代方式讲解客户端与服务端交互逻辑,帮助开发者深入理解大文件上传原理并掌握实际开发技巧。
写在前面
近期工作中涉及文件上传业务,鉴于现有功能较为简单,作者尝试利用纯原生技术栈构建大文件上传的DEMO,旨在从底层逻辑深入掌握大文件上传的核心思路。本教程基于纯原生HTML与Node.js环境开发,旨在帮助初学者快速构建基础大文件上传功能,深入理解其内部运行机制,并为后续功能的扩展提供便利,非常适合希望入门大文件上传技术的开发者。
效果展示
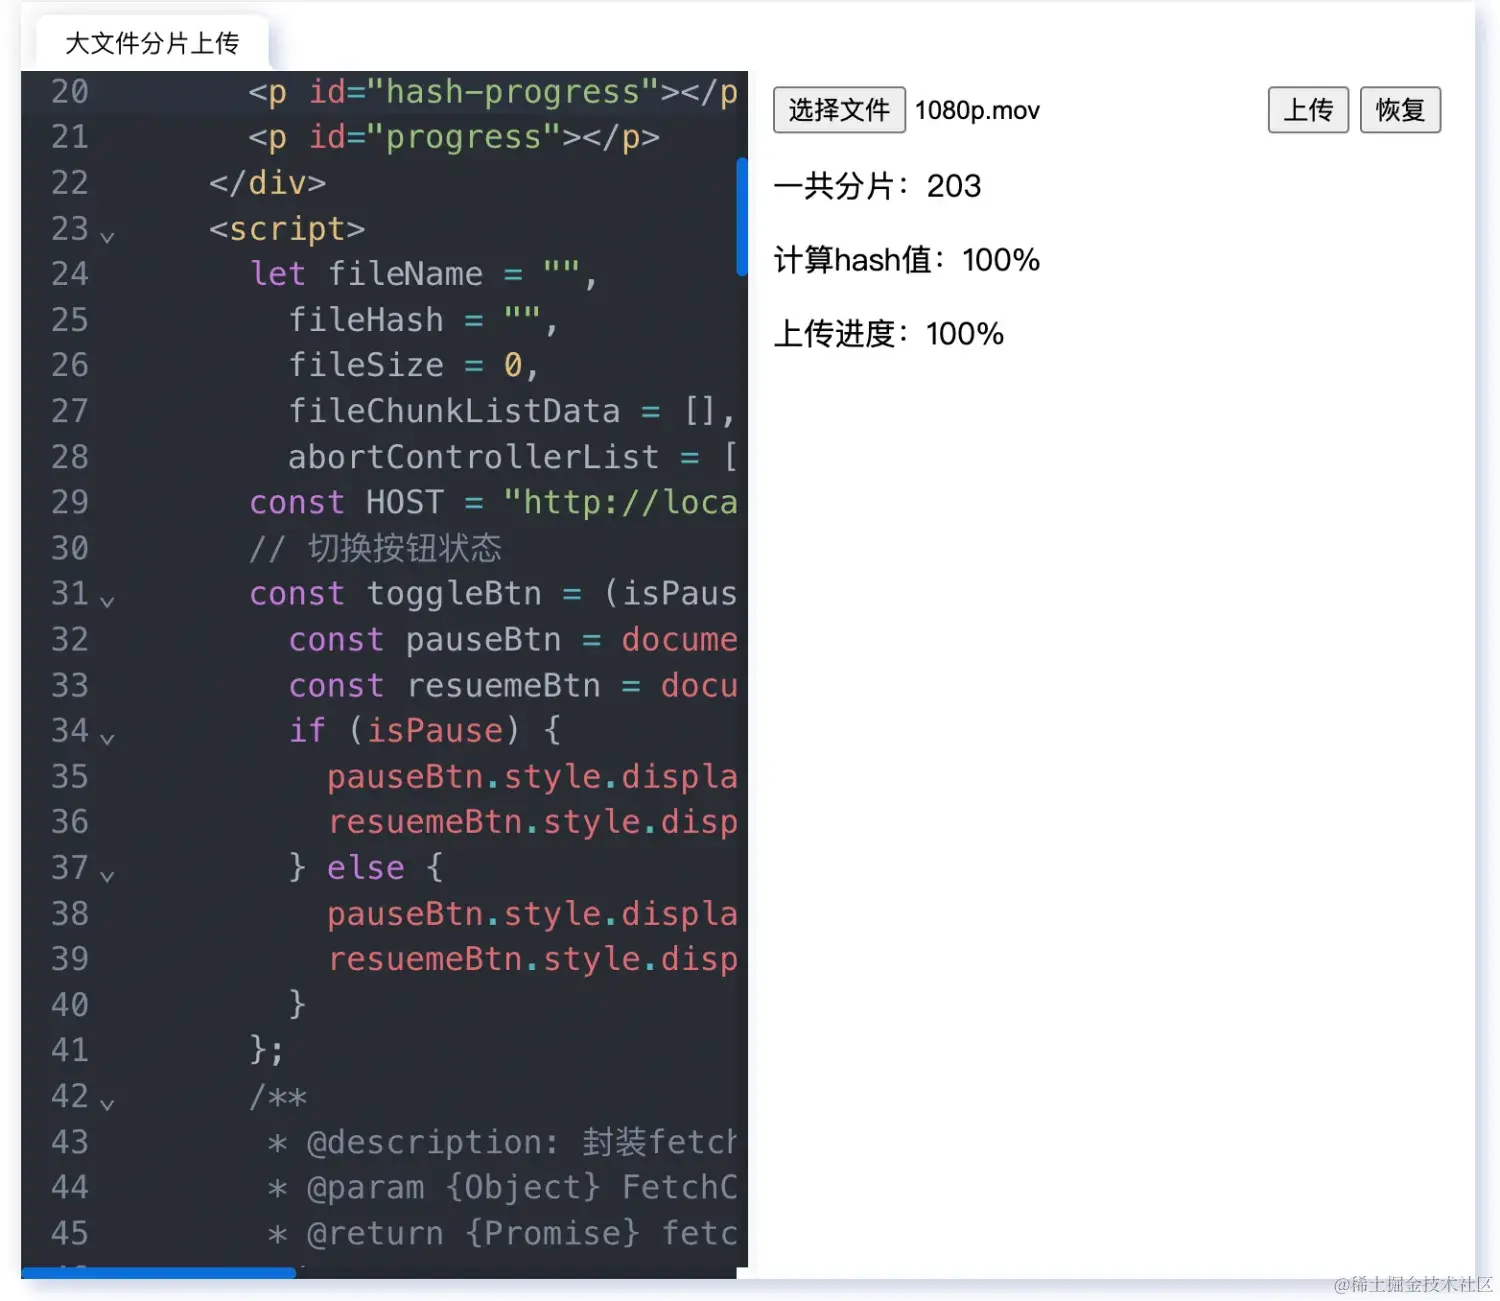
首先预览最终实现的效果。
实现思路
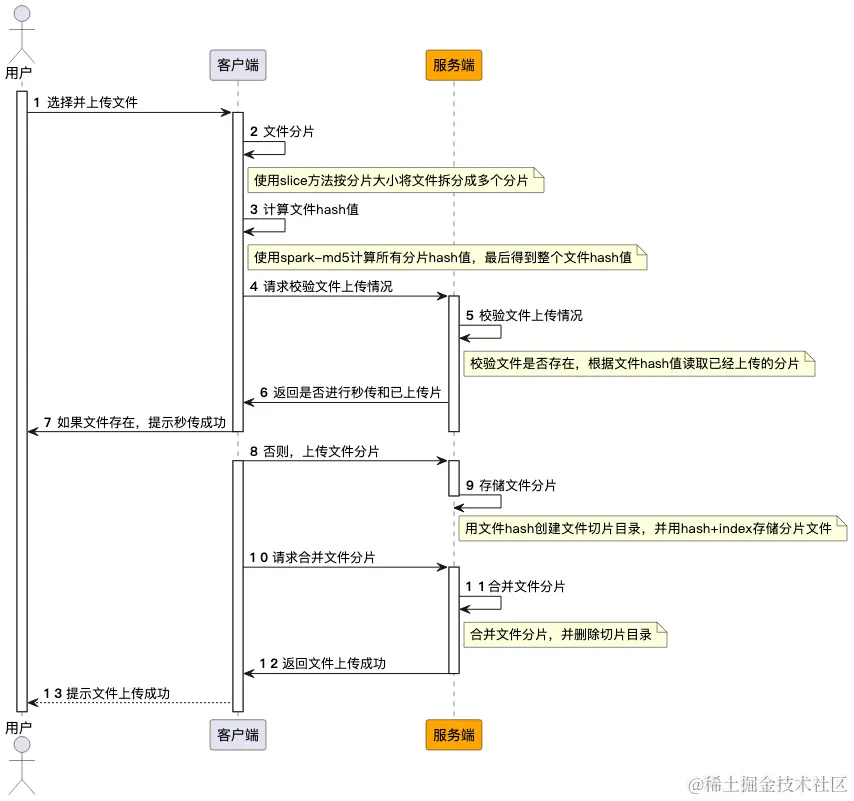
上述流程图展示了客户端与服务端在大文件上传过程中的整体交互逻辑,有助于从宏观层面理解上传流程。然而,若直接按此流程讲解入门知识,可能会增加学习难度。
下文将采用功能点逐步迭代的方式,详细讲解大文件上传的实现过程。每个功能点相对独立且简单,每完成一个功能点都能显著提升开发信心。大文件上传主要包含分片上传、分片合并、文件秒传、断点续传以及上传进度这五个核心功能点,后续功能均建立在已有功能基础之上。若能实现分片上传功能,即视为掌握了大文件上传的基础,其余功能均为在此基础上的扩展。
具体实现
分片上传
首先实现最基础且核心的分片上传功能。该功能涉及客户端的文件分片、Hash值计算、分片上传,以及服务端的创建分片目录并存储分片。客户端与服务端的源代码分别存放于BigFileUpload.html和server.js文件中。
客户端
为了后续支持取消上传和显示上传进度,首先对fetch请求进行简单封装。
/**
 * @description: 封装fetch
 * @param {Object} FetchConfig fetch config
 * @return {Promise} fetch result
 */
const requestApi = ({
  url,
  method = "GET",
  ...fetchProps
}) => {
  return new Promise(async (resolve, reject) => {
    const res = await fetch(url, {
      method,
      ...fetchProps,
    });
    resolve(res.json());
  });
};
以下是实现分片功能所需的HTML标签元素。
<input type="file" name="file" id="file" multiple />
<button id="upload" onClick="handleUpload()">上传</button>
<p id="hash-progress"></p>
<p id="total-slice"></p>
首先,利用slice()方法对大文件进行分片处理,将分片内容、大小等信息整理至分片列表中,并在页面显示分片总数。
// 文件分片
const createFileChunk = (file) => {
	const chunkList = [];
	//计算文件切片总数
	const sliceSize = 5 * 1024 * 1024; // 每个文件切片大小定为5MB
	const totalSlice = Math.ceil(fileSize / sliceSize);
	for (let i = 1; i <= totalSlice; i++) {
	  let chunk;
	  if (i == totalSlice) {
		// 最后一片
		chunk = file.slice((i - 1) * sliceSize, fileSize - 1); //切割文件
	  } else {
		chunk = file.slice((i - 1) * sliceSize, i * sliceSize);
	  }
	  chunkList.push({
		file: chunk,
		fileSize,
		size: Math.min(sliceSize, file.size),
	  });
	}
	const sliceText = `一共分片:${totalSlice}`;
	document.getElementById("total-slice").innerHTML = sliceText;
	console.log(sliceText);
	return chunkList;
};
随后,使用spark-md5分别计算每个分片的Hash值,最终得到整个文件的Hash值。由于Hash计算耗时较长,可在页面实时输出计算进度。
// 根据分片生成hash
const calculateHash = (fileChunkList) => {
  return new Promise((resolve) => {
    const spark = new SparkMD5.ArrayBuffer();
    let count = 0;
    // 计算出hash
    const loadNext = (index) => {
      const reader = new FileReader(); // 文件阅读对象
      reader.readAsArrayBuffer(fileChunkList[index].file);
      reader.onload = (e) => {
        count++;
        spark.append(e.target.result);
        if (count === fileChunkList.length) {
          resolve(spark.end());
        } else {
          // 还没读完
          const percentage = parseInt(
            ((count + 1) / fileChunkList.length) * 100
          );
          const progressText = `计算hash值:${percentage}%`;
          document.getElementById("hash-progress").innerHTML =
            progressText;
          console.log(progressText);
          loadNext(count);
        }
      };
    };
    loadNext(0);
  });
};
接着,将分片数据上传至服务器。需注意,分片的Hash值为${fileHash}-${index},服务端将依据此Hash值创建对应的分片文件。
let fileName = "",
  fileHash = "",
  fileSize = 0,
  fileChunkListData = [];
const HOST = "http://localhost:3000";

// ...

const handleUpload = async () => {
  const file = document.getElementById("file").files[0];
  if (!file) return alert("请选择文件!");
  fileName = file.name; // 文件名
  fileSize = file.size; // 文件大小
  const fileChunkList = createFileChunk(file);
  fileHash = await calculateHash(fileChunkList); // 文件hash
  fileChunkListData = fileChunkList.map(({ file, size }, index) => {
    const hash = `${fileHash}-${index}`;
    return {
      file,
      size,
      fileName,
      fileHash,
      hash,
    };
  });
  await uploadChunks();
};

//上传分片
const uploadChunks = async () => {
  const requestList = fileChunkListData
    .map(({ file, fileHash, fileName, hash }, index) => {
      const formData = new FormData();
      formData.append("file", file);
      formData.append("fileHash", fileHash);
      formData.append("name", fileName);
      formData.append("hash", hash);
      return { formData };
    })
    .map(async ({ formData }) => {
      return requestApi({
        url: `${HOST}`,
        method: "POST",
        body: formData,
      });
    });
  await Promise.all(requestList);
};
服务端
首先,使用原生node.js启动后端服务。
import * as http from "http"; //ES 6
import path from "path";

const server = http.createServer();

server.on("request", async (req, res) => {
  res.setHeader("Access-Control-Allow-Origin", "*");
  res.setHeader("Access-Control-Allow-Headers", "*");
  if (req.method === "OPTIONS") {
    res.status = 200;
    res.end();
    return;
  }
});

server.listen(3000, () => console.log("正在监听 3000 端口"));
随后,在服务器端添加处理分片上传的接口。通过multiparty读取客户端提交的表单数据后,判断切片目录是否存在;若不存在,则利用fileHash值创建临时分片目录,并使用fs-extra的move方法将文件分片存储至对应的分片目录中。
import * as http from "http"; //ES 6
import path from "path";
import fse from "fs-extra";
import multiparty from "multiparty";

const server = http.createServer();
const UPLOAD_DIR = path.resolve("/Users/sxg/Downloads/", "target"); // 大文件存储目录

server.on("request", async (req, res) => {
  res.setHeader("Access-Control-Allow-Origin", "*");
  res.setHeader("Access-Control-Allow-Headers", "*");
  if (req.method === "OPTIONS") {
    res.status = 200;
    res.end();
    return;
  }

  if (req.url === "/") {
    const multipart = new multiparty.Form();

    multipart.parse(req, async (err, fields, files) => {
      if (err) {
        console.error(err);
        res.status = 500;
        res.end(
          JSON.stringify({
            messaage: "process file chunk failed",
          })
        );
        return;
      }

      const [chunk] = files.file;
      const [hash] = fields.hash;
      const [filename] = fields.name;
      const [fileHash] = fields.fileHash;
      const chunkDir = `${UPLOAD_DIR}/${fileHash}`;

      const filePath = path.resolve(
        UPLOAD_DIR,
        `${fileHash}${extractExt(filename)}`
      );
      // 文件存在直接返回
      if (fse.existsSync(filePath)) {
        res.end(
          JSON.stringify({
            messaage: "file exist",
          })
        );
        return;
      }

      // 切片目录不存在,创建切片目录
      if (!fse.existsSync(chunkDir)) {
        await fse.mkdirs(chunkDir);
      }

      // fs-extra 专用方法,类似 fs.rename 并且跨平台
      // fs-extra 的 rename 方法 windows 平台会有权限问题
      // https://github.com/meteor/meteor/issues/7852#issuecomment-255767835
      await fse.move(chunk.path, `${chunkDir}/${hash}`);
      res.status = 200;
      res.end(
        JSON.stringify({
          messaage: "received file chunk",
        })
      );
    });
  }
});

server.listen(3000, () => console.log("正在监听 3000 端口"));
至此,已实现文件上传的最基本功能,后续功能将在此基础上进行迭代开发。
合并分片
客户端
文件分片上传完成后,需调用合并分片接口对所有分片进行合并。该接口需传递文件的fileHash和filename参数。
//上传分片
const uploadChunks = async () => {
  //...
  await mergeRequest(fileName, fileHash);
};

// 合并分片
const mergeRequest = async (fileName, fileHash) => {
  await requestApi({
    url: `${HOST}/merge`,
    method: "POST",
    headers: {
      "Content-Type": "application/json;charset=utf-8",
    },
    body: JSON.stringify({
      filename: fileName,
      fileHash,
    }),
  });
};
服务端
合并分片的核心逻辑是:根据fileHash读取对应分片目录下的分片文件列表,并按分片下标排序,以确保后续合并时文件顺序正确。接着,使用writeFile方法创建空文件,并利用appendFileSync方法依次将分片数据追加至文件中,最后删除临时分片目录。
// 合并切片
const mergeFileChunk = async (filePath, fileHash) => {
  const chunkDir = `${UPLOAD_DIR}/${fileHash}`;
  const chunkPaths = await fse.readdir(chunkDir);
  // 根据切片下标进行排序,否则直接读取目录的获得的顺序可能会错乱
  chunkPaths.sort((a, b) => a.split("-")[1] - b.split("-")[1]);
  await fse.writeFile(filePath, "");
  chunkPaths.forEach((chunkPath) => {
    fse.appendFileSync(filePath, fse.readFileSync(`${chunkDir}/${chunkPath}`));
    fse.unlinkSync(`${chunkDir}/${chunkPath}`);
  });
  fse.rmdirSync(chunkDir); // 合并后删除保存切片的目录
};
实现合并分片接口时,首先读取请求数据,拼接生成合并后的文件名称${UPLOAD_DIR}/${fileHash}${ext},最后调用合并分片方法。
import * as http from "http"; //ES 6
import path from "path";
import fse from "fs-extra";
import multiparty from "multiparty";
const server = http.createServer();
const extractExt = (filename) =>
  filename.slice(filename.lastIndexOf("."), filename.length); // 提取后缀名

//...

const resolvePost = (req) =>
  new Promise((resolve) => {
    let chunk = "";
    req.on("data", (data) => {
      chunk += data;
    });
    req.on("end", () => {
      resolve(JSON.parse(chunk));
    });
  });

server.on("request", async (req, res) => {
  //...

  if (req.url === "/merge") {
    const data = await resolvePost(req);
    const { filename, fileHash } = data;
    const ext = extractExt(filename);
    const filePath = `${UPLOAD_DIR}/${fileHash}${ext}`;
    await mergeFileChunk(filePath, fileHash);
    res.status = 200;
    res.end(JSON.stringify("file merged success"));
  }
});

server.listen(3000, () => console.log("正在监听 3000 端口"));
秒传
客户端
实现秒传功能,只需在文件上传前请求接口验证文件是否已存在。
const handleUpload = async () => {
  //...
  const { shouldUpload } = await verifyUpload(
    fileName,
    fileHash
  );
  if (!shouldUpload) {
    alert("秒传:上传成功");
    return;
  }
  //...
};

//文件秒传
const verifyUpload = async (filename, fileHash) => {
  const data = await requestApi({
    url: `${HOST}/verify`,
    method: "POST",
    headers: {
      "Content-Type": "application/json;charset=utf-8",
    },
    body: JSON.stringify({
      filename,
      fileHash,
    }),
  });
  return data;
};
服务端
若文件存在shouldUpload,则返回false;否则返回true。
import * as http from "http"; //ES 6
import path from "path";
import fse from "fs-extra";
import multiparty from "multiparty";
const server = http.createServer();

//...

server.on("request", async (req, res) => {
  //...

  if (req.url === "/verify") {
    const data = await resolvePost(req);
    const { fileHash, filename } = data;
    const ext = extractExt(filename);
    const filePath = `${UPLOAD_DIR}/${fileHash}${ext}`;
    if (fse.existsSync(filePath)) {
      res.end(
        JSON.stringify({
          shouldUpload: false,
        })
      );
    } else {
      res.end(
        JSON.stringify({
          shouldUpload: true,
        })
      );
    }
  }
});

server.listen(3000, () => console.log("正在监听 3000 端口"));
断点续传
客户端
断点续传功能新增了两个按钮,用于控制文件上传的暂停与恢复。
/* ... */
<button id="pause" onClick="handlePause()" style="display: none">
  暂停
</button>
<button id="resume" onClick="handleResume()" style="display: none">
  恢复
</button>
/* ... */
此处需对requestApi进行改造,添加abortControllerList用于存储需要取消的请求。若接口请求成功,则将fetch从abortControllerList中移除。
/**
 * @description: 封装fetch
 * @param {Object} FetchConfig fetch config
 * @return {Promise} fetch result
 */
const requestApi = ({
  url,
  method = "GET",
  onProgress,
  ...fetchProps
}) => {
  const controller = new AbortController();
  abortControllerList.push(controller);
  return new Promise(async (resolve, reject) => {
    const res = await fetch(url, {
      method,
      ...fetchProps,
      signal: controller.signal,
    });

    // 将请求成功的 fetch 从列表中删除
    const aCIndex = abortControllerList.findIndex(
      (c) => c.signal === controller.signal
    );
    abortControllerList.splice(aCIndex, 1);
    //...
  });
};
在分片上传逻辑中也需进行相应改造,从所有分片列表中过滤掉接口返回的uploadedList。仅当已上传的uploadedList数量与requestList数量之和等于分片列表fileChunkListData的总数量时,才执行分片合并操作。
let fileName = "",
  fileHash = "",
  fileSize = 0,
  fileChunkListData = [],
  abortControllerList = [];
const HOST = "http://localhost:3000";

//...

const handleUpload = async () => {
  //...
  const { shouldUpload, uploadedList } = await verifyUpload(
    fileName,
    fileHash
  );
  if (!shouldUpload) {
    alert("秒传:上传成功");
    return;
  }
  //...
  await uploadChunks(uploadedList);
};

//上传分片
const uploadChunks = async (uploadedList) => {
  const requestList = fileChunkListData
    .filter(({ hash }) => !uploadedList.includes(hash))
    .map(({ file, fileHash, fileName, hash }, index) =>     {
     //...
    })
    .map(async ({ formData, hash }) => {
  .   //...
    });
  //...
  // 之前上传的切片数量 + 本次上传的切片数量 = 所有切片数量时
  //合并分片
  if (
    uploadedList.length + requestList.length ===
    fileChunkListData.length
  ) {
    await mergeRequest(fileName, fileHash);
  }
};
此外,实现暂停和恢复的事件处理:暂停通过调用AbortController的abort()方法实现;恢复则是重新获取uploadedList后,再次进行分片上传。
//暂停
const handlePause = () => {
  abortControllerList.forEach((controller) => controller?.abort());
  abortControllerList = [];
};
// 恢复
const handleResume = async () => {
  const { uploadedList } = await verifyUpload(fileName, fileHash);
  await uploadChunks(uploadedList);
};
服务端
断点续传功能基于秒传接口实现,主要区别在于需新增已上传分片列表uploadedList。
import * as http from "http"; //ES 6
import path from "path";
import fse from "fs-extra";
import multiparty from "multiparty";
const server = http.createServer();

//...

// 返回已经上传切片名列表
const createUploadedList = async (fileHash) =>
  fse.existsSync(`${UPLOAD_DIR}/${fileHash}`)
    ? await fse.readdir(`${UPLOAD_DIR}/${fileHash}`)
    : [];

server.on("request", async (req, res) => {
  //...

  if (req.url === "/verify") {
    const data = await resolvePost(req);
    const { fileHash, filename } = data;
    const ext = extractExt(filename);
    const filePath = `${UPLOAD_DIR}/${fileHash}${ext}`;
    if (fse.existsSync(filePath)) {
      res.end(
        JSON.stringify({
          shouldUpload: false,
        })
      );
    } else {
      res.end(
        JSON.stringify({
          shouldUpload: true,
          uploadedList: await createUploadedList(fileHash),
        })
      );
    }
  }
});

server.listen(3000, () => console.log("正在监听 3000 端口"));
上传进度
上传进度功能仅需改造客户端,首先新增用于显示进度的标签。
<p id="progress"></p>
上传进度逻辑需对fetch请求进行改造,此处需使用getReader()手动读取数据流,获取当前上传进度,并添加onProgress回调函数。
/**
 * @description: 封装fetch
 * @param {Object} FetchConfig fetch config
 * @return {Promise} fetch result
 */
const requestApi = ({
  url,
  method = "GET",
  onProgress,
  ...fetchProps
}) => {
  //...
  return new Promise(async (resolve, reject) => {
    const res = await fetch(url, {
      method,
      ...fetchProps,
    });
    const total = res.headers.get("content-length");
    const reader = res.body.getReader(); //创建可读流
    const decoder = new TextDecoder();
    let loaded = 0;
    let data = "";
    while (true) {
      const { done, value } = await reader.read();
      loaded += value?.length || 0;
      data += decoder.decode(value);
      onProgress && onProgress({ loaded, total });
      if (done) {
        break;
      }
    }
    //...
    resolve(JSON.parse(data));
  });
};
在上传过程中,将已上传进度设置为100,并添加onProgress回调进行处理,累计每个分片的进度,从而计算出整体上传进度。
let fileName = "",
  fileHash = "",
  fileSize = 0,
  fileChunkListData = [],
  abortControllerList = [];
const HOST = "http://localhost:3000";

//...

const handleUpload = async () => {
  //...
  fileChunkListData = fileChunkList.map(({ file, size }, index) => {
    //...
    return {
      percentage: uploadedList.includes(hash) ? 100 : 0,
    };
  });
  //...
};

//上传分片
const uploadChunks = async (uploadedList) => {
  const requestList = fileChunkListData
    .filter(({ hash }) => !uploadedList.includes(hash))
    .map(({ file, fileHash, fileName, hash }, index) => {
    //...
    })
    .map(async ({ formData, hash }) => {
      return requestApi({
        url: `${HOST}`,
        method: "POST",
        body: formData,
        onProgress: ({ loaded, total }) => {
          const percentage = parseInt((loaded / total) * 100);
          // console.log("分片上传百分比:", percentage);
          const curIndex = fileChunkListData.findIndex(
            ({ hash: h }) => h === hash
          );
          fileChunkListData[curIndex].percentage = percentage;
          const totalLoaded = fileChunkListData
            .map((item) => item.size * item.percentage)
            .reduce((acc, cur) => acc + cur);
          const totalPercentage = parseInt(
            (totalLoaded / fileSize).toFixed(2)
          );
          const progressText = `上传进度:${totalPercentage}%`;
          document.getElementById("progress").innerHTML = progressText;
          console.log(progressText);
        },
      });
    });
   //...
};
总结
实际上,大文件上传往往无需自行实现,因为已有许多成熟的解决方案。
然而,深入理解大文件上传背后的原理,更有助于对现有大文件上传方案进行个性化改造。
在线实现大文件上传过程中使用了三个插件:multiparty、fs-extra、spark-md5。若对这些插件不太熟悉,建议自行补充相关知识。
以上即为使用纯原生JS实现大文件分片上传的详细内容,更多关于JS大文件分片上传的资料请关注本站其它相关文章!