

本文介绍在JavaScript中将富文本HTML转换为纯文本的三种常用方法。首先解析DOM元素的innerText与textContent属性差异;其次演示利用正则表达式剥离标签的字符串处理技巧;最后推荐html-to-text等第三方库以应对复杂场景。文章涵盖代码示例、注意事项及安全性建议,帮助开发者根据实际需求选择最优方案。
为什么要将HTML转换为纯文本?
HTML作为网页结构与内容的标记语言,有时我们仅需提取其中的文字信息,忽略样式、链接及其他标签。例如,为了便于搜索或数据分析,将HTML邮件或网页内容转化为纯文本格式是常见需求。
使用JavaScript进行转换
在JavaScript开发中,存在多种将HTML转换为纯文本的技术路径,以下列举几种典型实现方式。
1. 使用innerText或textContent属性
针对单个DOM节点,可通过其innerText或textContent属性直接获取纯文本内容。两者主要区别在于对空格、换行符的处理方式,以及是否包含被CSS隐藏的元素文本。
var element = document.getElementById('myElement');
var text = element.innerText || element.textContent; // 兼容性处理
console.log(text); // 输出纯文本内容
2. 使用正则表达式和字符串替换
若需处理包含HTML的字符串,可利用正则表达式配合字符串替换功能。需注意,该方法在处理嵌套标签或复杂样式时可能存在局限,无法覆盖所有HTML场景。
function htmlToText(html) {
return html
.replace(/<[^>]*>/g, '') // 移除所有HTML标签
.replace(/ /gi, ' ') // 将HTML实体转换为字符
.replace(/<br\s*\/?>/gi, '\n') // 将换行符替换为实际的换行符
// ... 可以添加更多替换规则来处理其他HTML实体或特殊字符
;
}
var htmlContent = '<p>Hello, <b>world</b>!</p>';
var textContent = htmlToText(htmlContent);
console.log(textContent); // 输出:Hello, world!3. 使用第三方库
为实现更可靠且全面的HTML到文本转换,建议采用第三方库,例如DOMPurify(主要用于HTML清洗,但也支持文本提取)或专门为此设计的库。这些工具通常提供更丰富的配置选项和更好的兼容性。
注意事项
- 处理用户输入的HTML内容时,务必重视安全性,避免直接插入或执行未经验证的代码,以防范跨站脚本攻击(XSS)。
- HTML转文本过程中,样式、链接、图像等信息将会丢失,需确保应用程序能妥善处理此类信息缺失情况。
- 使用正则表达式处理HTML时,需关注其复杂性及潜在的性能瓶颈。面对大型或结构复杂的HTML内容,可能需要采用更高级或复杂的处理策略。
拓展:
3种HTML转换为纯文本的方法
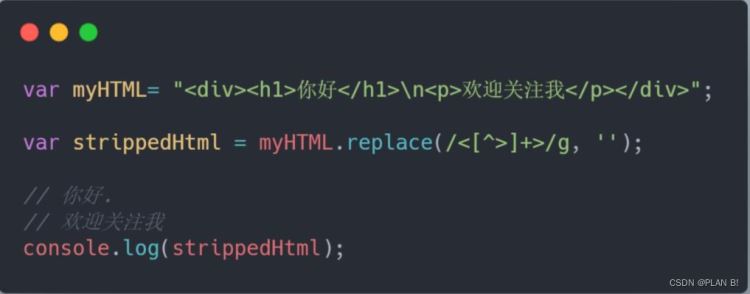
1. 使用 .replace(/<[^>]*>/g, '')
这是从文本中移除HTML标签的最简单方式。它利用字符串的.replace()方法,将待替换的字符串替换为空值。参数/g表示全局匹配,即替换字符串中所有符合条件的HTML标签。
该方法的局限性在于部分HTML标签可能无法被完全剔除,但在简单场景下依然实用。
2. 创建临时DOM元素并获取其中的文本
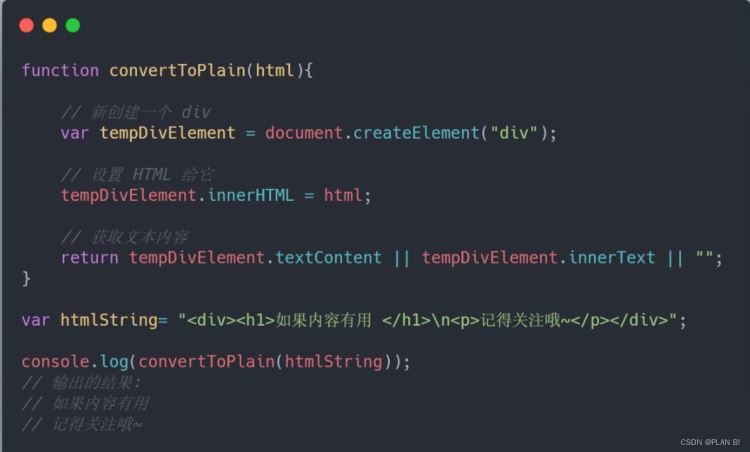
这是解决该问题较为高效的方法。通过创建一个临时DOM节点并赋值HTML字符串,随后利用DOM对象的方法提取其中的文本内容。
3. 使用 html-to-text npm 包
html-to-text 包功能全面,转换时支持多种选项配置,如wordwrap、tags、whitespaceCharacters、formatters等。
安装:
npm install html-to-text使用:
到此这篇关于使用JavaScript将富文本HTML转换为纯文本的三种方法的文章就介绍到这了,更多相关JavaScript HTML转纯文本内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!