

本文详解基于Vue和Node.js的大文件上传解决方案。通过文件切片、MD5 Hash计算实现断点续传与秒传功能。针对高并发请求导致的UI卡顿,提供了串行上传、有限并发队列控制及WebWorker异步计算Hash等优化策略,确保大文件传输的稳定性和用户体验。
常规的文件上传通常只需实例化FormData对象,将文件附加后通过POST请求发送至后端即可。然而,处理大文件时,这种单点传输方式极易引发超时错误,且一旦传输中断,用户必须从头开始重新上传。在漫长的等待期间,若用户刷新页面,之前的努力将付诸东流。因此,业界通常采用文件切片上传的策略来解决此类问题。
整体思路
- 将文件切割为多个小块。
- 计算文件的唯一标识(Hash值),以便在后续传输中识别已上传部分,仅传输剩余切片。
- 所有切片上传完毕后,通知服务端进行切片合并。
- 上传成功后,服务端向前端返回文件存储路径。
- 若传输过程中出现失败,下次上传时利用已计算的Hash值筛选未完成的切片进行续传(断点续传);若文件已完整存在,则直接返回结果,无需再次传输(秒传)。
项目演示
本示例使用Vue构建前端界面,Node.js搭建后端服务。
前端界面
核心组件文件:fileUpload.vue。
<template>
    <div class="wrap">
        <div >
           <el-upload
             ref="file"
             :http-request="handleFileUpload"
             action="#"
             class="avatar-uploader"
             :show-file-list='false'
           >
               <el-button type="primary">上传文件</el-button>
           </el-upload>
           <div>
               <div>计算hash的进度:</div>
              <el-progress :stroke-width="20" :text-inside="true" :percentage="hashProgress"></el-progress>
           </div>
           <div>
               <div>上传进度:</div>
              <el-progress :stroke-width="20" :text-inside="true" :percentage="uploaedProgress"></el-progress>
           </div>
        </div>
    </div>
</template>
文件切片
利用File.prototype.slice方法对文件进行分片处理,具体实现见fileUpload.vue。
    const CHUNK_SIZE=1024*1024//每个切片为1M
    import sparkMD5 from 'spark-md5'
    export default {
        name:'file-upload',
        data(){
            return {
              file:null,//上传的文件
              chunks:[],//切片
              hashProgress:0,//hash值计算进度
              hash:''
            }
        },
        methods:{
            async handleFileUpload(e){
              if(!file){
                  return
              }
              this.file=file
              this.upload()
            },
            //文件上传
            async upload(){
             //切片
             const chunks=this.createFileChunk(this.file)
            //...
            //hash计算
              const hash=await this.calculateHash1(chunks)
            }
           },
            //文件切片
             createFileChunk(size=CHUNK_SIZE){
              const chunks=[];
              let cur=0;
              const maxLen=Math.ceil(this.file.size/CHUNK_SIZE)
              while(cur<maxLen){
                 const start=cur*CHUNK_SIZE;
                 const end = ((start + CHUNK_SIZE) >= this.file.size) ? this.file.size : start + CHUNK_SIZE;
                 chunks.push({index:cur,file:this.file.slice(start,end)})
                 cur++
              }
              return chunks
            },

    }
Hash计算
通过MD5算法生成文件的唯一Hash值。
此处可引入 spark-md5 库,该库支持对文件进行增量Hash计算,提高效率。
calculateHash1(chunks){
   const spark=new sparkMD5.ArrayBuffer()
   let count =0
   const len=chunks.length
   let hash
   const self=this
   const startTime = new Date().getTime()
   return new Promise((resolve)=>{
        const loadNext=index=>{
            const reader=new FileReader()
            //逐片读取文件切片
            reader.readAsArrayBuffer(chunks[index].file)
            reader.onload=function(e){
                const endTime=new Date().getTime()
                chunks[count]={...chunks[count],time:endTime-startTime}
                count++
                //读取成功后利用spark做增量计算
                spark.append(e.target.result)
                if(count==len){
                    self.hashProgress=100
                    //返回整个文件的hash
                     hash=spark.end()
                     resolve(hash)
                }else{
                    //更新hash计算进度
                    self.hashProgress+=100/len
                    loadNext(index+1)
                }
            }
        }
        loadNext(0)
   })

},
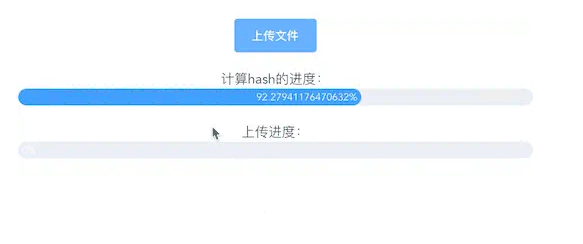
Hash计算过程可能耗时较长,存在阻塞UI线程(导致界面卡顿)的风险,因此后续将讨论通过Web Worker等技术进行优化。
查询切片状态
获取文件Hash后,在上传切片前需向后端查询该文件的上传状态。若文件已完整上传,则无需再次传输;若仅部分上传,则仅上传未完成的切片,实现断点续传。
前端代码实现见fileUpload.vue。
//...
methods:{
//...
async upload(){
//...切片,计算hash
this.hash=hash
//查询是否上传 将hash和后缀作为参数传入
this.$http.post('/checkfile',{
  hash,
  ext:this.file.name.split('.').pop()
})
.then(res=>{
  //接口会返回两个值 uploaded:Boolean 表示整个文件是否上传过 和 uploadedList 哪些切片已经上传
   const {uploaded,uploadedList}=res.data
   //如果已经上传过,直接提示用户(秒传)
    if(uploaded){
        return  this.$message.success('秒传成功')
    }
  //这里我们约定上传的每个切片名字都是 hash+‘-'+index
    this.chunks=chunks.map((chunk,index)=>{
        const name=hash+'-'+index
        const isChunkUploaded=(uploadedList.includes(name))?true:false//当前切片是否有上传
        return {
            hash,
            name,
            index,
            chunk:chunk.file,
            progress:isChunkUploaded?100:0//当前切片上传进度,如果有上传即为100 否则为0,这是用来之后计算总体上传进度
        }
    })
    //上传切片
    this.uploadChunks(uploadedList)
  })
 }

}
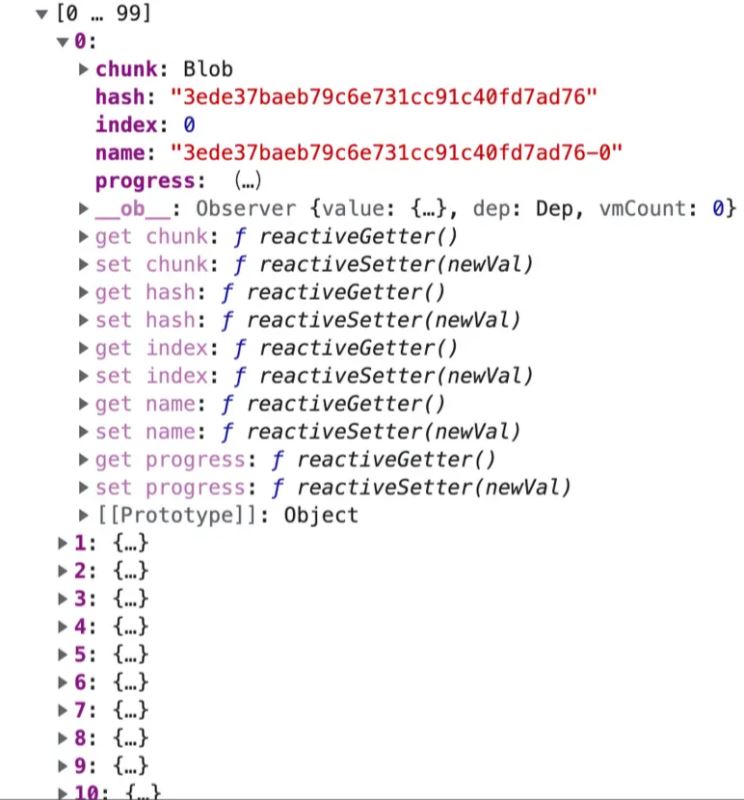
文件切片数据存储在 this.chunks 中。
服务端代码位于 server/index.js。
const Koa=require('koa')
const Router=require('koa-router')
const koaBody = require('koa-body');
const path=require('path')
const fse=require('fs-extra')
const app=new Koa()
const router=new Router()
//文件存放在public下
const UPLOAD_DIR=path.resolve(__dirname,'public')
app.use(koaBody({
    multipart:true, // 支持文件上传
}));


router.post('/checkfile',async (ctx)=>{
    const body=ctx.request.body;
    const {ext,hash}=body
    //合成后的文件路径 文件名 hash.ext
    const filePath=path.resolve(UPLOAD_DIR,`${hash}.${ext}`)
    let uploaded=false
    let uploadedList=[]
    //判断文件是否已上传
    if(fse.existsSync(filePath)){
      uploaded=true
    }else{
    //所有已经上传过的切片被存放在 一个文件夹,名字就是该文件的hash值
      uploadedList=await getUploadedList(path.resolve(UPLOAD_DIR,hash))
    }
    ctx.body={
      code:0,
      data:{
        uploaded,
        uploadedList
      }
    }
})

async function getUploadedList(dirPath){
//将文件夹中的所有非隐藏文件读取并返回
   return fse.existsSync(dirPath)?(await fse.readdir(dirPath)).filter(name=>name[0]!=='.'):[]
}
切片上传(断点续传)
根据获取的切片状态,筛选出需要上传的切片进行传输。前端代码见fileUpload.vue。
uploadChunks(uploadedList){
 //每一个要上传的切片变成一个请求
  const requests=this.chunks.filter(chunk=>!uploadedList.includes(chunk.name))
  .map((chunk,index)=>{
     const form=new FormData()
     //所有上传的切片会被存放在 一个文件夹,文件夹名字就是该文件的hash值 因此需要hash和name
     form.append('chunk',chunk.chunk)
     form.append('hash',chunk.hash)
     form.append('name',chunk.name)
     //因为切片不一定是连续的,所以index需要取chunk对象中的index
     return {form,index:chunk.index,error:0}
  })//所有切片一起并发上传
  .map(({form,index})=>{
      return this.$http.post('/uploadfile',form,{
          onUploadProgress:progress=>{
              this.chunks[index].progress=Number(((progress.loaded/progress.total)*100).toFixed(2)) //当前切片上传的进度
          }
      })
  })

  Promise.all(requests).then((res)=>{
   //所有请求都成功后发送请求给服务端合并文件
    this.mergeFile()
  })

},
服务端处理逻辑。
router.post('/uploadfile',async (ctx)=>{
  const body=ctx.request.body
  const file=ctx.request.files.chunk
  const {hash,name}=body
 //切片存放的文件夹所在路径
  const chunkPath=path.resolve(UPLOAD_DIR,hash)
  if(!fse.existsSync(chunkPath)){
      await fse.mkdir(chunkPath)
  }
 //将文件从临时路径里移动到文件夹下
  await fse.move(file.filepath,`${chunkPath}/${name}`)


  ctx.body={
    code:0,
    message:`切片上传成功`
   }

})
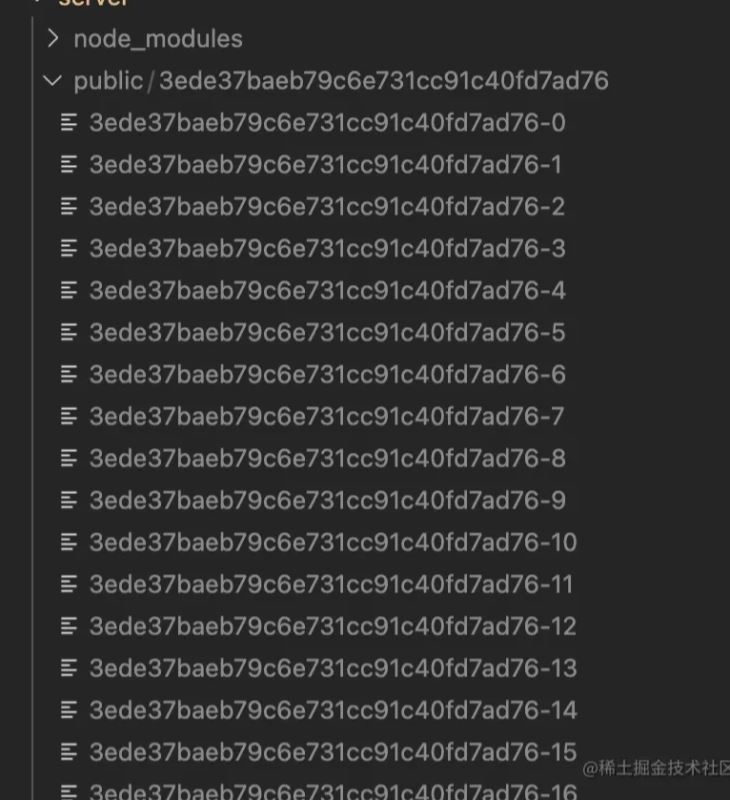
上传后的切片保存路径由服务端指定。
文件总体上传进度
总体进度基于各切片上传进度及文件总大小计算,可通过Vue的计算属性(computed)实现。
相关前端代码见fileUpload.vue。
uploaedProgress(){
    if(!this.file || !this.chunks.length){
        return 0
    }
    //累加每个切片已上传的部分
   const loaded =this.chunks.map(chunk=>{
       const size=chunk.chunk.size
       const chunk_loaded=chunk.progress/100*size
       return chunk_loaded
    }).reduce((acc,cur)=>acc+cur,0)

   return parseInt(((loaded*100)/this.file.size).toFixed(2))
},
合并文件
前端触发合并请求的代码见fileUpload.vue。
//要传给服务端文件后缀,切片的大小和hash值
mergeFile(){
    this.$http.post('/mergeFile',{
        ext:this.file.name.split('.').pop(),
        size:CHUNK_SIZE,
        hash:this.hash
    }).then(res=>{
        if(res && res.data){
            console.log(res.data)
        }
    })
},
服务端负责接收合并请求并执行文件合并操作。
router.post('/mergeFile',async (ctx)=>{
  const body=ctx.request.body
  const {ext,size,hash}=body
  //文件最终路径
  const filePath=path.resolve(UPLOAD_DIR,`${hash}.${ext}`)
  await mergeFile(filePath,size,hash)
  ctx.body={
     code:0,
     data:{
         url:`/public/${hash}.${ext}`
     }
  }
})

async function mergeFile(filePath,size,hash){
  //保存切片的文件夹地址
  const chunkDir=path.resolve(UPLOAD_DIR,hash)
  //读取切片
  let chunks=await fse.readdir(chunkDir)
  //切片要按顺序合并,因此需要做个排序
  chunks=chunks.sort((a,b)=>a.split('-')[1]-b.split('-')[1])
  //切片的绝对路径
  chunks=chunks.map(cpath=>path.resolve(chunkDir,cpath))
  await mergeChunks(chunks,filePath,size)
}

//边读边写至文件最终路径
function mergeChunks(files,dest,CHUNK_SIZE){
  const pipeStream=(filePath,writeStream)=>{
    return new Promise((resolve,reject)=>{
        const readStream=fse.createReadStream(filePath)
        readStream.on('end',()=>{
            //每一个切片读取完毕后就将其删除
            fse.unlinkSync(filePath)
            resolve()
        })
        readStream.pipe(writeStream)
    })

  }

  const pipes=files.map((file,index) => {
  return pipeStream(file,fse.createWriteStream(dest,{
        start:index*CHUNK_SIZE,
        end:(index+1)*CHUNK_SIZE
    }))
  });
  return Promise.all(pipes)

}
大文件切片上传功能已实现,以下展示运行效果(包含单个切片的上传进度演示)。
由于大量切片并发上传,尽管浏览器对并发请求数有限制(部分请求处于pending状态),但仍可能导致界面卡顿。因此,该流程仍需进一步优化。
优化
请求并发数控制
前端优化代码见fileUpload.vue。
逐片上传
这是一种直接的做法,可视作并发请求的极端情况:上传成功一个切片后再上传下一个。此方案需处理错误重试机制,若连续失败3次,则终止整个上传过程。
uploadChunks(uploadedList){
  console.log(this.chunks)
  const requests=this.chunks.filter(chunk=>!uploadedList.includes(chunk.name))
  .map((chunk,index)=>{
     const form=new FormData()
     form.append('chunk',chunk.chunk)
     form.append('hash',chunk.hash)
     form.append('name',chunk.name)
     return {form,index:chunk.index,error:0}
  })
//   .map(({form,index})=>{
//       return this.$http.post('/uploadfile',form,{
//           onUploadProgress:progress=>{
//               this.chunks[index].progress=Number(((progress.loaded/progress.total)*100).toFixed(2))
//           }
//       })
//   })
// //   console.log(requests)
//   Promise.all(requests).then((res)=>{
//     console.log(res)
//     this.mergeFile()
//   })

  const sendRequest=()=>{
      return new Promise((resolve,reject)=>{
            const upLoadReq=(i)=>{
                const req=requests[i]
                const {form,index}=req
                this.$http.post('/uploadfile',form,{
                    onUploadProgress:progress=>{
                        this.chunks[index].progress=Number(((progress.loaded/progress.total)*100).toFixed(2))
                    }
                })
                .then(res=>{
                    //最后一片上传成功,整个过程完成
                    if(i==requests.length-1){
                        resolve()
                        return
                    }
                    upLoadReq(i+1)
                })
                .catch(err=>{
                    this.chunks[index].progress=-1
                    if(req.error<3){
                        req.error++
                        //错误累加后重试
                        upLoadReq(i)
                    }else{
                        reject()
                    }
                })
           }
           upLoadReq(0)

      })


  }
  //整个过程成功后再合并文件
  sendRequest()
  .then(()=>{
     this.mergeFile()
  })

},
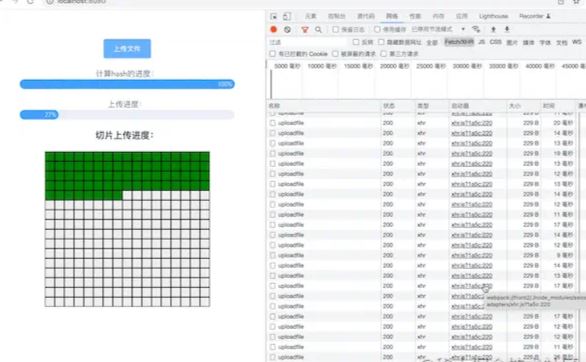
效果显示每次仅有一个上传请求在进行。
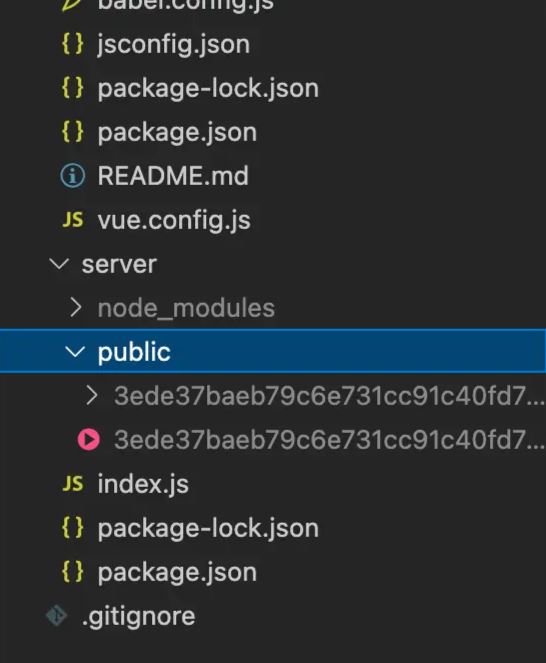
最终生成的文件。
多个请求并发
逐个请求虽能解决卡顿问题,但效率较低。我们可在此基础上实现有限数量的并发控制。
解决思路是构建任务队列:初始时从请求列表(requests)中取出指定数量的请求对象(例如3个)填充队列并发起请求;每个任务完成后,将其从队列移除,并从requests中取出新元素加入队列执行,直至requests清空。若某切片请求失败,需将其重新插入requests队首,以便下次执行时重试,从而实现重试机制。
async uploadChunks(uploadedList){
  console.log(this.chunks)
  const requests=this.chunks.filter(chunk=>!uploadedList.includes(chunk.name))
  .map((chunk,index)=>{
     const form=new FormData()
     form.append('chunk',chunk.chunk)
     form.append('hash',chunk.hash)
     form.append('name',chunk.name)
     return {form,index:chunk.index,error:0}
  })


const sendRequest=(limit=1,task=[])=>{
    let count=0 //用于记录请求成功次数当其等于len-1时所有切片都已上传成功
    let isStop=false //标记错误情况,如果某一片错误数大于3整个任务标记失败 并且其他并发的请求凭次标记也不在递归执行
    const len=requests.length
    return new Promise((resolve,reject)=>{
            const upLoadReq=()=>{
                if(isStop){
                    return
                }
                const req=requests.shift()
                if(!req){
                    return
                }
                const {form,index}=req
                this.$http.post('/uploadfile',form,{
                    onUploadProgress:progress=>{
                        this.chunks[index].progress=Number(((progress.loaded/progress.total)*100).toFixed(2))
                    }
                })
                .then(res=>{
                    //最后一片
                    if(count==len-1){
                    resolve()
                    }else{
                    count++
                    upLoadReq()
                    }
                })
                .catch(err=>{
                    this.chunks[index].progress=-1
                    if(req.error<3){
                        req.error++
                        requests.unshift(req)
                        upLoadReq()
                    }else{
                        isStop=true
                        reject()
                    }
                })
            }

            while(limit>0){
              //模拟形成了一个队列,每次结束再递归执行下一个任务
              upLoadReq()
              limit--
            }
    })

}

   sendRequest(3).then(res=>{
      console.log(res)
      this.mergeFile()
   })

},
Hash值计算优化
除请求并发控制外,Hash计算也需关注。尽管采用了增量计算,但仍可能耗时并阻塞UI。
Web Worker
利用Web Worker开启新线程进行Hash计算,计算完成后将结果通知主线程,从而避免阻塞UI。
calculateHashWork(chunks){
   return new Promise((resolve)=>{
      //这个js得独立于项目之外
      this.worker=new worker('/hash.js')
      //切片传入现成
      this.worker.postMessage({chunks})
      this.worker.onmessage=e=>{
      //线程中返回的进度和hash值
       const {progress,hash}=e.data
       this.hashProgress=Number(progress.toFixed(2))
       if(hash){
        resolve(hash)

       }

     }
   })
},
相关Worker代码见hash.js。
//独立于项目之外,得单独

// 引入spark-md5

self.importScripts('spark-md5.min.js')


self.onmessage = e=>{
  // 接受主线程传递的数据,开始计算
  const {chunks } = e.data
  const spark = new self.SparkMD5.ArrayBuffer()

  let progress = 0
  let count = 0

  const loadNext = index=>{
    const reader = new FileReader()
    reader.readAsArrayBuffer(chunks[index].file)
    reader.onload = e=>{
      count ++
      spark.append(e.target.result)

      if(count==chunks.length){
      //向主线程返回进度和hash
        self.postMessage({
          progress:100,
          hash:spark.end()
        })
      }else{
        progress += 100/chunks.length
        //向主线程返回进度
        self.postMessage({
          progress
        })
        loadNext(count)
      }
    }
  }
  loadNext(0)
}
时间切片
另一种优化方案借鉴React Fiber架构,通过时间切片(Time Slicing)在浏览器空闲时计算Hash值。这样可保证浏览器渲染连续性,避免明显卡顿。
calculateHashIdle(chunks){
    return new Promise(resolve=>{
        const spark=new sparkMD5.ArrayBuffer()
        let count=0
        const appendToSpark=async file=>{
            return new Promise(resolve=>{
                const reader=new FileReader()
                reader.readAsArrayBuffer(file)
                reader.onload=e=>{
                    spark.append(e.target.result)
                    resolve()
                }
            })
        }

        const workLoop=async deadline=>{
        //当切片没有读完并且浏览器有剩余时间
            while(count<chunks.length && deadline.timeRemaining()>1){
                await appendToSpark(chunks[count].file)
                count++
                if(count<chunks.length){
                    this.hashProgress=Number(((100*count)/chunks.length).toFixed(2))
                }else{
                    this.hashProgress=100
                    const hash=spark.end()
                    resolve(hash)
                }
            }
            window.requestIdleCallback(workLoop)
        }
        window.requestIdleCallback(workLoop)
    })
}
以上为Vue与Node.js实现大文件上传的示例代码详情,更多Vue与Node.js大文件上传资料请关注本站其他相关文章!