

本文分析JavaScript中获取Div内容的三种主要属性:innerHTML、innerText和textContent。指出不同浏览器内核对它们的支持差异,特别是IE与Firefox的兼容性问题。通过navigator.appName判断浏览器类型,分别调用innerText或textContent,提供跨浏览器获取Div文本内容的通用解决方案。
JavaScript获取Div内容的属性差异
从本文可以学习到关于获取Div数据的相关知识。
使用 document.getElementById("ddhdh").innerHTML 可以获取到Div中的全部数据,包括内部的HTML标签。不过,这种方式仅在IE和Opera浏览器中有效。
使用 document.getElementById("ddhdh").innerText 可以获取到Div中的纯文本数据,不会包含HTML标签。同样,这也仅在IE和Opera浏览器中有效。
在Firefox浏览器中,应使用 document.getElementById("text").textContent 来获取数据。
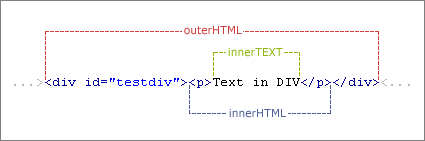
上述方法基于不同的浏览器内核,因此在多种浏览器之间并不兼容。
以下是具体的解决方案代码示例。
跨浏览器兼容解决方案
下面提供一种能够兼容Firefox和IE的JavaScript获取Div内容的方法。
首先判断浏览器名称:if(navigator.appName.indexOf("Explorer") > -1)
如果是IE浏览器,则执行:var text = document.getElementById("text").innerText;
否则(即非IE浏览器,如Firefox)
执行:var text = document.getElementById("text").textContent;
上述代码用于获取浏览器的名称。第一句判断的意思是,当获取到的浏览器名称中包含“Explorer”字符串时,判定为IE浏览器。
indexOf方法详解
这里涉及到了 indexOf 方法的用法。
indexOf 方法的基本语法为:strObj.indexOf(subString[, startIndex])
该方法的参数说明如下:
strObj
必选项。指定要查找的 String 对象或字符串文字。
subString
必选项。要在 String 对象中查找的子字符串。
startIndex
可选项。指定在 String 对象内开始查找的索引位置。如果省略此参数,则从字符串的开头处开始查找。
indexOf 方法返回一个整数值,表示 String 对象内子字符串的开始位置。如果没有找到子字符串,则返回 -1。