

本文详细介绍如何使用JavaScript实现二叉树的四种遍历方式:前序、中序、后序及广度优先遍历。内容涵盖递归与非递归两种实现思路,重点解析利用栈和队列模拟遍历过程,并附带最大深度计算及路径查找等经典算法题的JS代码示例,帮助开发者深入理解树结构操作。
前言
在计算机科学领域,树(tree)作为一种抽象数据类型(ADT),属于非线性数据结构,应用十分广泛。其中,二叉树因其结构特性,在各类算法与系统设计中尤为常见。
理解树结构需掌握以下基本概念:
- 结点:构成树的基本元素。
- 树根:位于树顶端的节点,即根节点。
- 度:指一个结点所拥有的子结点的数量。
- 叶子节点:度为0,即没有子结点的节点。
一、二叉树基础
二叉树的定义是:每个节点最多包含两个子树的树结构。
1.1、遍历二叉树
二叉树的遍历主要分为深度遍历和广度遍历两大类。深度遍历包含前序、中序和后序三种方式;广度遍历则称为层次遍历,即按照层级顺序逐层访问节点。
四种遍历的核心逻辑如下:
- 前序遍历:遵循“根-左-右”顺序,即先访问根节点,再遍历左子树,最后遍历右子树(DLR)。
- 中序遍历:遵循“左-根-右”顺序,即先遍历左子树,再访问根节点,最后遍历右子树(LDR)。
- 后序遍历:遵循“左-右-根”顺序,即先遍历左子树,再遍历右子树,最后访问根节点(LRD)。
- 广度遍历:严格按照层级顺序,从上至下、从左至右逐层访问。
以表达式 a+b*(c-d)-e/f 为例,将其转换为二叉树结构表示如下:
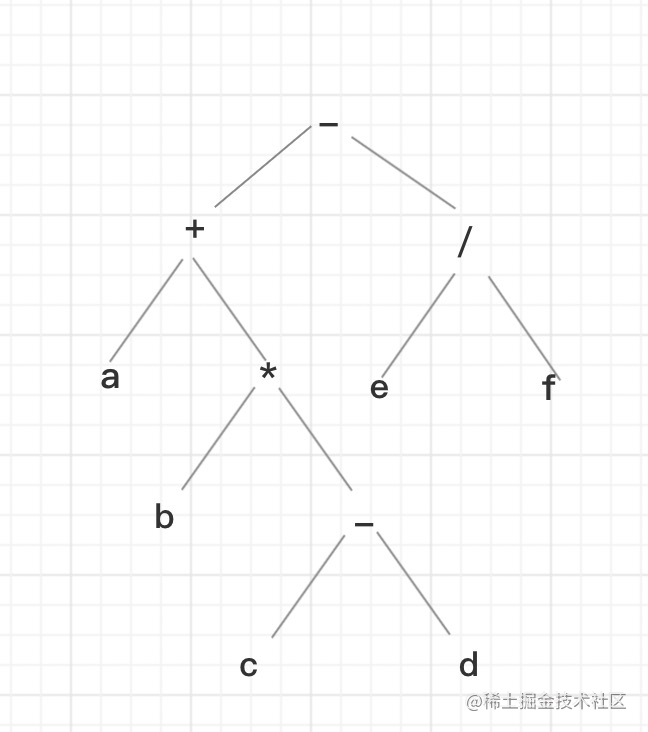
对该表达式对应的二叉树进行不同方式的遍历,结果如下:
- 前序遍历结果:-+a*b-cd/ef
- 中序遍历结果:a+b*c-d-e/f
- 后序遍历结果:abcd-*+ef/-
- 广度遍历结果:-+/a*efb-cd
1.2、用JS表示二叉树
在JavaScript中,可以使用对象来构建二叉树。每个对象包含三个属性:left(左子树)、value(节点值)和right(右子树)。以上述表达式 a+b*(c-d)-e/f 为例,其JS对象表示形式如下。
var tree = {
    value: '-',
    left: {
        value: '+',
        left: {
            value: 'a'
        },
        right: {
            value: '*',
            left: {
                value: 'b'
            },
            right: {
                value: '-',
                left: {
                    value: 'c'
                },
                right: {
                    value: 'd'
                }
            }
        }
    },
    right: {
        value: '/',
        left: {
            value: 'e'
        },
        right: {
            value: 'd'
        }
    }
}
1.3、前序遍历算法
前序遍历主要有两种实现方式,第一种是基础的递归方法。
function preOrder(treeNode) {
  if(treeNode) {
    console.log(treeNode.value); // 打印出来代表访问这个节点
    preOrder(treeNode.left);
    preOrder(treeNode.right);
  }
}
算法逻辑清晰:首先访问根节点,随后递归遍历左子树,待左子树遍历完成后,再递归遍历右子树。
第二种实现方式为非递归遍历。
function preOrder(treeNode) {
  if(treeNode) {
    var stack = [treeNode]; //将二叉树压入栈
    while (stack.length !== 0) {
      treeNode = stack.pop(); // 取栈顶
      document.getElementById('text').appendChild(document.createTextNode(treeNode.value)); // 访问节点
      if(treeNode.right) stack.push(treeNode.right); // 把右子树入栈
      if(treeNode.left) stack.push(treeNode.left); // 把左子树入栈
    }
  }
}
非递归方法利用栈(Stack)数据结构,基于“先进后出”的原则。具体步骤为:先将根节点压入栈中,然后弹出栈顶元素并访问该节点。接着将右子树压入栈,再将左子树压入栈(必须保证右子树先入栈,以确保左子树先被处理)。循环执行出栈操作,直到栈为空。
1.4、中序遍历算法
中序遍历的递归实现如下:
function InOrder(treeNode) {
    if(treeNode) {
        InOrder(treeNode.left);
        document.getElementById('text').appendChild(document.createTextNode(treeNode.value));
        InOrder(treeNode.right);
    }
}
其思路与前序递归类似,区别仅在于访问节点值的时机不同。
第二种实现为非递归方式。
function InOrder(node) {
  if(node) {
    var stack = [];             // 建空栈
    //如果栈不为空或结点不为空,则循环遍历
    while (stack.length !== 0 || node) {
      if (node) {               //如果结点不为空
          stack.push(node);     //将结点压入栈
          node = node.left;     //将左子树作为当前结点
      } else {                  //左子树为空,即没有左子树的情况
          node = stack.pop();   //将结点取出来
          document.getElementById('text').appendChild(document.createTextNode(node.value));
          node = node.right;    //将右结点作为当前结点
      }
    }
  }
}
非递归中序遍历的核心思想是:将当前节点压入栈,然后持续遍历左子树。只要左子树存在,就不断将节点压入栈,直到左子树为空。此时弹出栈顶节点进行访问,随后将右子树作为当前节点继续处理。
1.5、后序遍历算法
第一种实现为递归遍历算法。
function postOrder(node) {
    if (node) { //判断二叉树是否为空
        postOrder(node.left); //递归遍历左子树
        postOrder(node.right); //递归遍历右子树
        document.getElementById('text').appendChild(document.createTextNode(node.value));
    }
}
第二种实现为非递归遍历算法。
function postOrder(node) {
    if (node) { //判断二叉树是否为空
        var stack = [node]; //将二叉树压入栈
        var tmp = null; //定义缓存变量
        while (stack.length !== 0) { //如果栈不为空,则循环遍历
            tmp = stack[stack.length - 1]; //将栈顶的值保存在tmp中
            if (tmp.left && node !== tmp.left && node !== tmp.right) { //如果存在左子树,node !== tmp.left && node !== tmp.righ 是为了避免重复将左右子树入栈
                stack.push(tmp.left);   //将左子树结点压入栈
            } else if (tmp.right && node !== tmp.right) { //如果结点存在右子树
                stack.push(tmp.right);  //将右子树压入栈中
            } else {
                document.getElementById('text').appendChild(document.createTextNode(stack.pop().value));
                node = tmp;
            }
        }
    }
}
非递归后序遍历引入一个 tmp 变量,用于记录上一次访问的节点。算法流程为:先将根节点和左子树压入栈,取出左子树处理后,再压入右子树并处理,最后处理根节点。
以下是使用上述算法遍历前文所述二叉树的详细过程记录:
stack tmp node 打印 初始 : - null - 第1轮: -+ - - 第2轮: -+a + - 第3轮: -+ a a a 第4轮: -+* + a 第5轮: -+*b * a 第6轮: -+* b b b 第7轮: -+*- * b 第8轮: -+*-c - b 第9轮: -+*- c c c 第10轮: -+*-d - c 第11轮: -+*- d d d 第12轮: -+* - - - 第13轮: -+ * * * 第14轮: - + + + 第15轮: -/ - + 第16轮: -/e / + 第17轮: -/ e e e 第18轮: -/f / e 第19轮: -/ f f f 第20轮: - / / / 第21轮: - - -
最终结果:abcd-*+ef/-
1.6、按层遍历算法
function breadthTraversal(node) {
    if (node) {                             //判断二叉树是否为空
        var que = [node];                   //将二叉树放入队列
        while (que.length !== 0) {          //判断队列是否为空
            node = que.shift();             //从队列中取出一个结点
            document.getElementById('text').appendChild(document.createTextNode(node.value));   //将取出结点的值保存到数组
            if (node.left) que.push(node.left);   //如果存在左子树,将左子树放入队列
            if (node.right) que.push(node.right); //如果存在右子树,将右子树放入队列
        }
    }
}
按层遍历使用数组模拟队列结构。首先将根节点加入队列。当队列不为空时,执行循环:取出队首节点,若该节点存在左子树,则将左子树加入队列;若存在右子树,则将右子树加入队列。
二、算法题实战
1.1、二叉树的最大深度
题目要求:给定一个二叉树,计算并返回其最大深度。
定义:二叉树的深度是指从根节点到最远叶子节点的最长路径上的节点数量。
示例如下,该二叉树的最大深度为3:
3 / \ 9 20 / \ 15 7
const tree = { value: 3, left: { value: 9 }, right: { value: 20, left: { value: 15 }, right: { value: 9 } } }
递归算法思路:分别获取左子树和右子树的最大深度,取两者中的较大值,再加上根节点的1,即为整棵树的深度。
var maxDepth = function(root) {
  if (!root) {
    return 0;
  }
  const leftDeep = maxDepth(root.left) + 1;
  const rightDeep = maxDepth(root.right) + 1;
  return Math.max(leftDeep, rightDeep);
};
/*
maxDepth(root) = maxDepth(root.left) + 1  = 2
maxDepth(root.left) = maxDepth(root.left.left) + 1 = 1
maxDepth(root.left.left) = 0;

maxDepth(root) = maxDepth(root.right) + 1 = 3
maxDepth(root.right) = maxDepth(root.right.right) + 1 = 2
maxDepth(root.right.right) = maxDepth(root.right.right.right) + 1 = 1
maxDepth(root.right.right.right) = 0
*/
1.2、二叉树的所有路径
题目要求:给定一个二叉树,返回所有从根节点到叶子节点的路径字符串。
示例:
3 / \ 9 20 / \ 15 7 返回:['3->9', '3->20->15', '3->20->7']
实现方法:使用递归遍历,在遍历过程中构建路径字符串。
var binaryTreePaths = function(root) {
  if (!root) return [];
  const res = [];
  function dfs(curNode, curPath) {
    if(!curNode.left && !curNode.right) {
      res.push(curPath);
    }
    if(curNode.left) {
      dfs(curNode.left, `${curPath}->${curNode.left.value}`)
    }
    if(curNode.right) {
      dfs(curNode.right, `${curPath}->${curNode.right.value}`)
    }
  }
  dfs(root, `${root.value}`);
  return res;
};
总结
本文介绍了利用JavaScript实现二叉树遍历算法的完整过程,涵盖递归与非递归多种实现方式。如需了解更多JS二叉树相关算法内容,可查阅本站往期文章或继续浏览后续内容,感谢支持。