
深入解析JavaScript在遍历对象时属性顺序是否确定。基于ECMAScript规范的OrdinaryOwnPropertyKeys算法,详细拆解整数键升序、常规字符串键与Symbol键的排序规则,对比不同遍历API的表现与边界特例,并给出实用的工程选型建议。

当前位置:首页 > JavaScript 对象与原型 > 正文
JS遍历对象时属性顺序是确定的吗
作者:代码拾荒
时间:2026-11-04
浏览:402
文章目录
主题类别:JavaScript 原理与规范
标准基准:ECMAScript 2015 (ES6) / ES2020
阅读时间:约 8 分钟
在现代 JavaScript 中,遍历对象属性时的顺序是完全确定且有规范约束的。然而,这种“确定性”并不等同于直觉上的“按代码声明或属性添加的先后顺序”。自 ES2015(ES6)起,ECMAScript 规范在底层引入了统一的
OrdinaryOwnPropertyKeys 算法,将属性键划分为非负整数索引、普通字符串和 Symbol 符号三个梯队按优先级处理;而在 ES2020 中,此前在历史版本中实现各异的 for...in 循环顺序也得到了全平台标准规范。理解这一机制与各遍历 API 的行为边界,能够帮助开发者在日常编码中彻底避开隐蔽的数据排布陷阱。
一、规范底层:OrdinaryOwnPropertyKeys 算法的三层判定
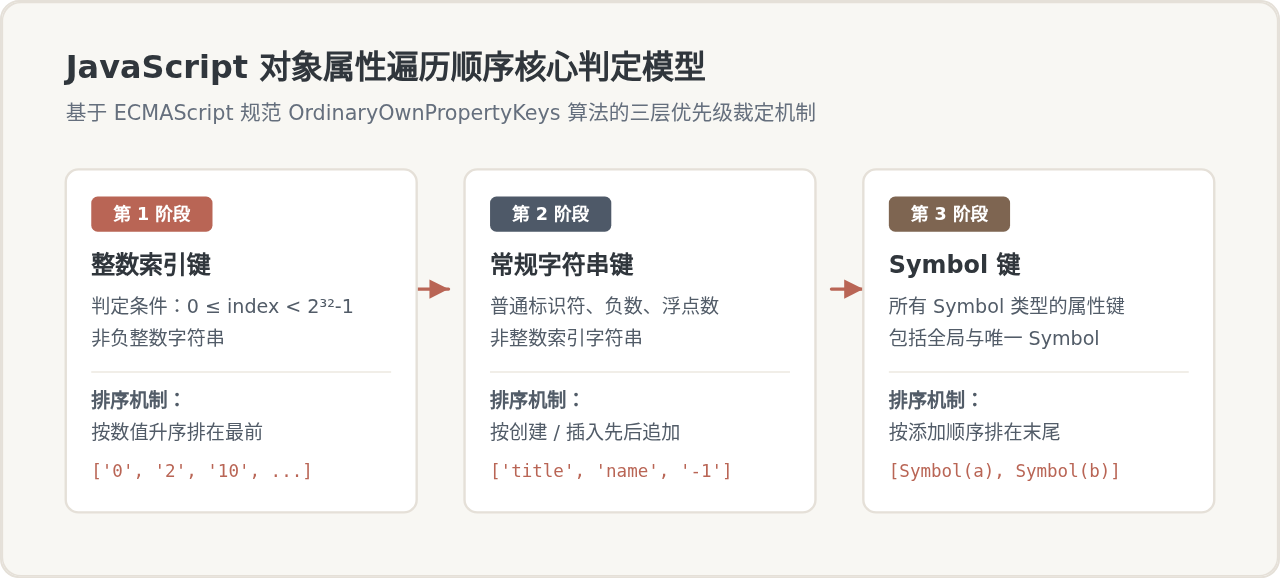
在讨论具体的循环语法之前,必须先看 JavaScript 引擎在底层是如何组织一个对象自身键(Own Property Keys)的。现代 ECMAScript 规范定义了一个抽象操作:OrdinaryOwnPropertyKeys(O)。无论是 Reflect.ownKeys、Object.keys,还是底层序列化操作,均以该操作的结果为基准。
该算法对对象自身所有属性键执行严格的三步排布:
- 第一阶段:整数索引键(Integer Indices)
所有可以转换为 32 位无符号非负整数(即满足规范0 ≤ ToUint32(key) < 232 - 1)且其字符串表示形式规范一致的键名,不论在代码中何时添加,统一按照数值大小升序排列。 - 第二阶段:常规字符串键(String Keys)
所有非整数索引的普通字符串键(包括英文标识符、汉字、负数如'-1'、浮点数如'1.5'等),严格按照属性被添加到对象上的先后时间顺序(Insertion Order)追加。 - 第三阶段:Symbol 键
所有 Symbol 类型的属性键,同样严格按照被添加到对象上的先后时间顺序追加在末尾。
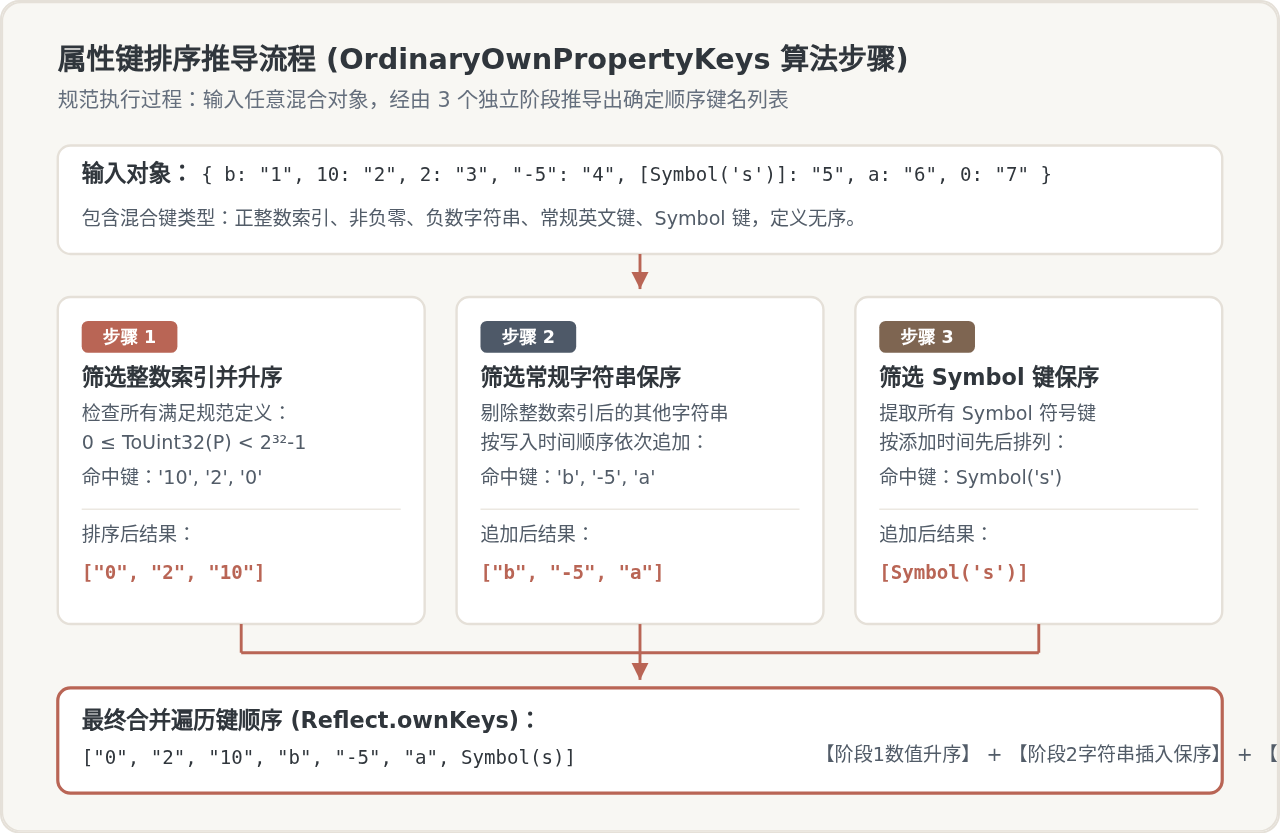
通过以下代码可以清晰直观地观察到这一算法的完整执行结果:
// 声明包含各类型键的混合对象,故意打乱添加次序
const sample = {};
sample['b'] = 'letter-b';
sample[10] = 'num-10';
sample[2] = 'num-2';
sample['-5'] = 'negative-5';
sample[Symbol('first')] = 'sym-1';
sample['a'] = 'letter-a';
sample[0] = 'num-0';
sample[Symbol('second')] = 'sym-2';

// 使用无过滤的原生规范方法 Reflect.ownKeys 查看完整键顺序
const keys = Reflect.ownKeys(sample);
console.log(keys);
// 输出结果:
// ['0', '2', '10', 'b', '-5', 'a', Symbol(first), Symbol(second)]
分析上面的实际输出:
- 数字键
0、2、10虽然在不同的时间点写入,但因为被判定为整数索引,立刻被提升至最前列,并按数值大小0 → 2 → 10完成升序排列。 - 普通字符串键
'b'、'-5'、'a'排在整数键之后,严格保持它们被写入时的先后次序(先'b',再'-5',最后'a')。注意:'-5'虽然看似是数字,但因为是负数,规范将其归类为普通字符串,绝不会参与第一阶段的整数升序。 - 两个
Symbol属性被稳定排在整个数组的最末尾,同样保持着它们的添加次序。
二、常用遍历 API 的具体表现与过滤差异
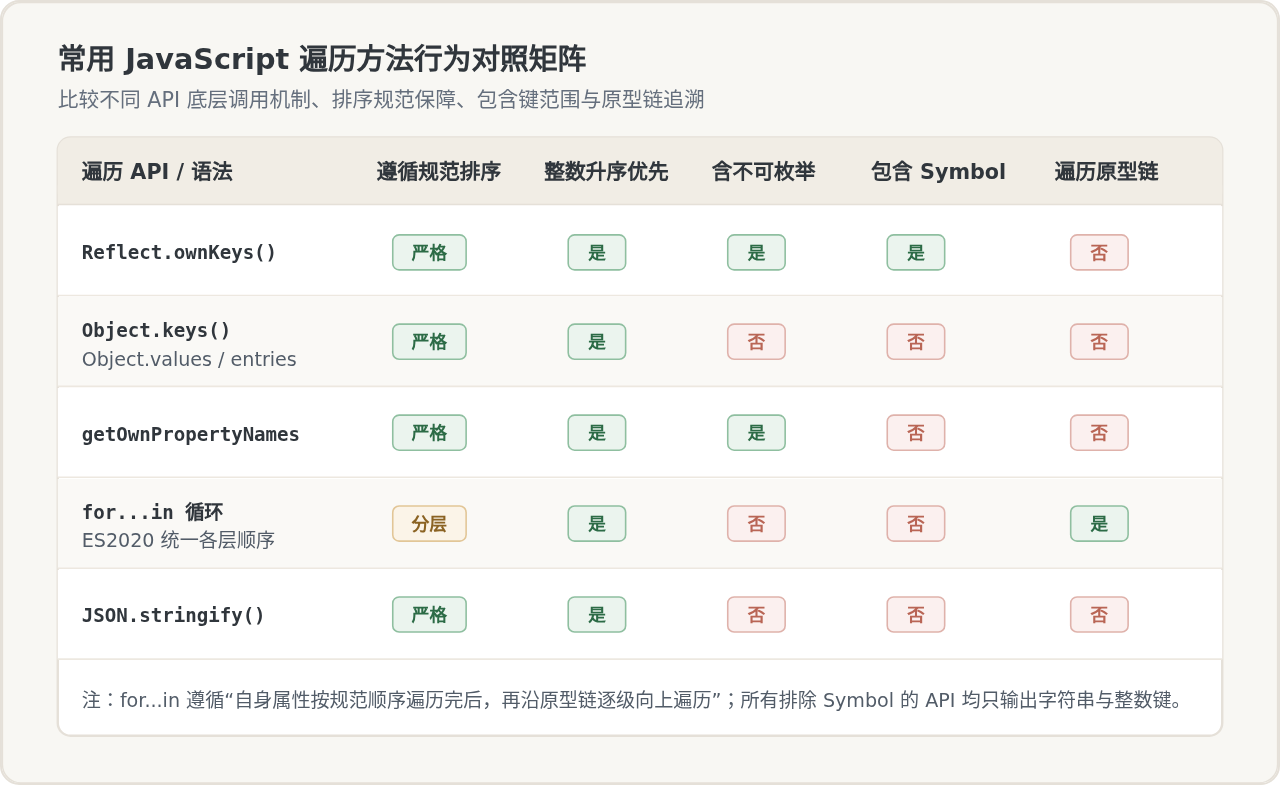
虽然所有现代遍历 API 的底层都依赖于上述的属性键排序规范,但不同的 API 为满足不同的业务场景,对返回结果做了特定的过滤和作用域约束。开发者在实际使用中感受到的“顺序差异”,往往来源于 API 自身的过滤机制。
1. Reflect.ownKeys(obj)
这是与规范核心算法 OrdinaryOwnPropertyKeys 对应度最高的方法。它不进行任何过滤,返回对象自身所有的键,包括不可枚举属性、整数键、字符串键和 Symbol 键。顺序完全遵照“整数升序 → 字符串插入序 → Symbol 插入序”。
2. Object.keys(obj) / Object.values(obj) / Object.entries(obj)
这组方法是日常业务开发中最常用的遍历工具。它们以相同的底层算法为准,但增加了两个过滤条件:只返回对象自身属性(不含原型链),且只返回可枚举属性(enumerable 为 true),同时自动排除所有 Symbol 键。因此,它们返回的顺序是“可枚举整数键升序 → 可枚举常规字符串键插入序”。
3. Object.getOwnPropertyNames(obj)
返回对象自身所有的字符串与整数键,包含不可枚举属性,但不包含 Symbol 键。顺序同样遵循整数升序加字符串插入序。
4. for...in 循环与原型链
for...in 是 JavaScript 最早期的循环语法,用于遍历对象及其原型链上所有可枚举的字符串键。历史上,ES5 及更早的规范曾明确声明 for...in 的枚举顺序是“未指定(implementation-dependent)”的,这导致不同浏览器引擎(如早期 IE、Firefox、Chrome)在原型链或属性删除后的枚举顺序存在细微差异。
为了终结这一历史遗留混乱,ES2020(ECMAScript 2020)正式发布了 for-in 枚举顺序提案,将现代引擎(V8、JavaScriptCore、SpiderMonkey 等)的事实标准固化入规范。现代规范明确规定:
for...in按照由近及远的顺序遍历原型链:先遍历当前对象自身层,自身层遍历完毕后,再沿原型链向上遍历上层原型。- 在每一层对象内部,依然严格遵循“整数升序 → 常规字符串插入序”的规则。
- 如果在原型链上发现了已被自身或更近原型屏蔽(Shadowed)的同名属性,或者已被设为不可枚举的属性,则予以跳过。
5. JSON.stringify(obj)
在对对象进行 JSON 序列化时,属性的输出次序同样严格遵循 Object.keys 的规则,即整数索引升序在前,其余常规属性按插入顺序紧随其后。如果后端服务或者第三方对接系统误认为 JSON 属性顺序反映了业务时间线,此处就极易产生协议解析偏差。
三、4 个最容易导致逻辑偏差的边界场景
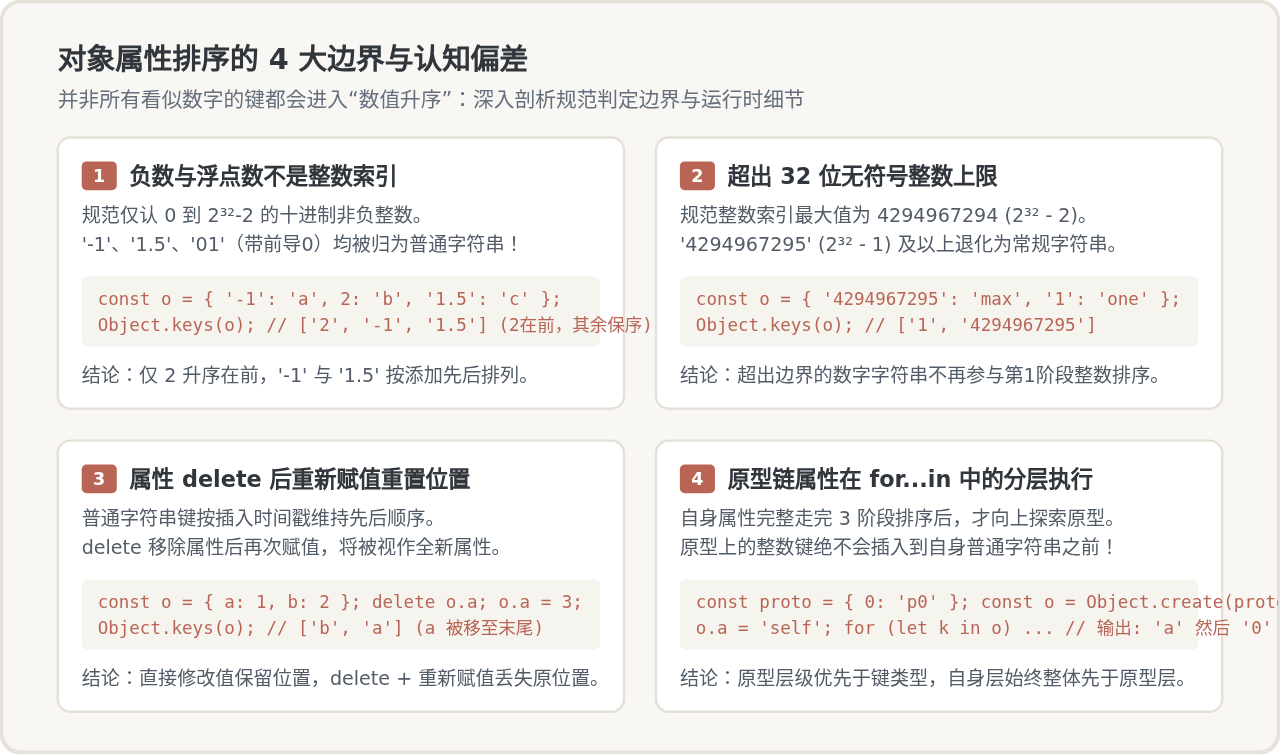
在实际编码中,很多开发者由于对“整数索引”与“普通字符串”的划分标准理解不透彻,常常写出带有潜在 Bug 的代码。以下是 4 个最典型的边界特例:
1. 负数、小数与带前导零的数值字符串
许多开发者潜意识里认为“只要能转成数字的都是数字键”,但 ECMAScript 规范对整数索引有着极其严苛的定义:必须满足 ToString(ToUint32(P)) === P,且不能等于 232 - 1。这意味着:
const edgeObj = {};
edgeObj['-1'] = '负整数';
edgeObj['1.5'] = '浮点数';
edgeObj['01'] = '带前导零的数字串';
edgeObj['2'] = '合法整数索引';
edgeObj['0'] = '合法整数索引';

console.log(Object.keys(edgeObj));
// 输出: ['0', '2', '-1', '1.5', '01']
可以看到,只有 '0' 和 '2' 属于合法的整数索引,它们被提至头部升序;而 '-1'、'1.5' 以及带有前导零的 '01',都不满足规范的 CanonicalNumericIndexString 整数约束,全部被当成普通字符串,老老实实呆在后面按插入顺序排列。
2. 超出 32 位无符号整数上限的大数键
32 位无符号整数的最大可表示值为 4294967295(即 $2^32 - 1$)。规范专门将此值作为哨兵排除在数组索引之外。因此,合法的整数索引范围为 0 到 4294967294($2^32 - 2$)。
const bigNumObj = {};
bigNumObj['4294967295'] = '刚好超出上限';
bigNumObj['100'] = '普通整数索引';
bigNumObj['4294967294'] = '最大合法整数索引';

console.log(Object.keys(bigNumObj));
// 输出: ['100', '4294967294', '4294967295']
其中 '100' 和 '4294967294' 顺利进入第一阶段升序排布,而 '4294967295' 则退化为第二阶段的普通字符串,排在所有合法整数之后。
3. 属性使用 delete 删除后的重写操作
如果对一个已有属性进行单纯的修改赋值(如 obj.a = 2),该属性在普通字符串序列中的插入时间戳不会改变,依然保留在原来的位置;但如果先执行了 delete obj.a 将其删除,再执行 obj.a = 2 重新添加,则该属性被视为一个全新的键,其位置会被挪到普通字符串队列的最末尾。
4. 原型链上的整数键不会穿插到自身的普通字符串前
由于 for...in 采用的是逐层推进模型,原型链的层级优先级永远高于键类型的优先级:
const parent = { 0: 'parent-0', z: 'parent-z' };
const child = Object.create(parent);
child.b = 'child-b';
child.a = 'child-a';

for (let key in child) {
  console.log(key);
}
// 输出依次为: 'b', 'a', '0', 'z'
原型 parent 上虽然拥有整数键 0,但它绝不会被插到子对象 child 的字符串键 'b' 或 'a' 之前。引擎一定是把 child 自身的属性完整输出完毕,才会开始遍历 parent 上的属性。
四、工程实践与技术选型建议
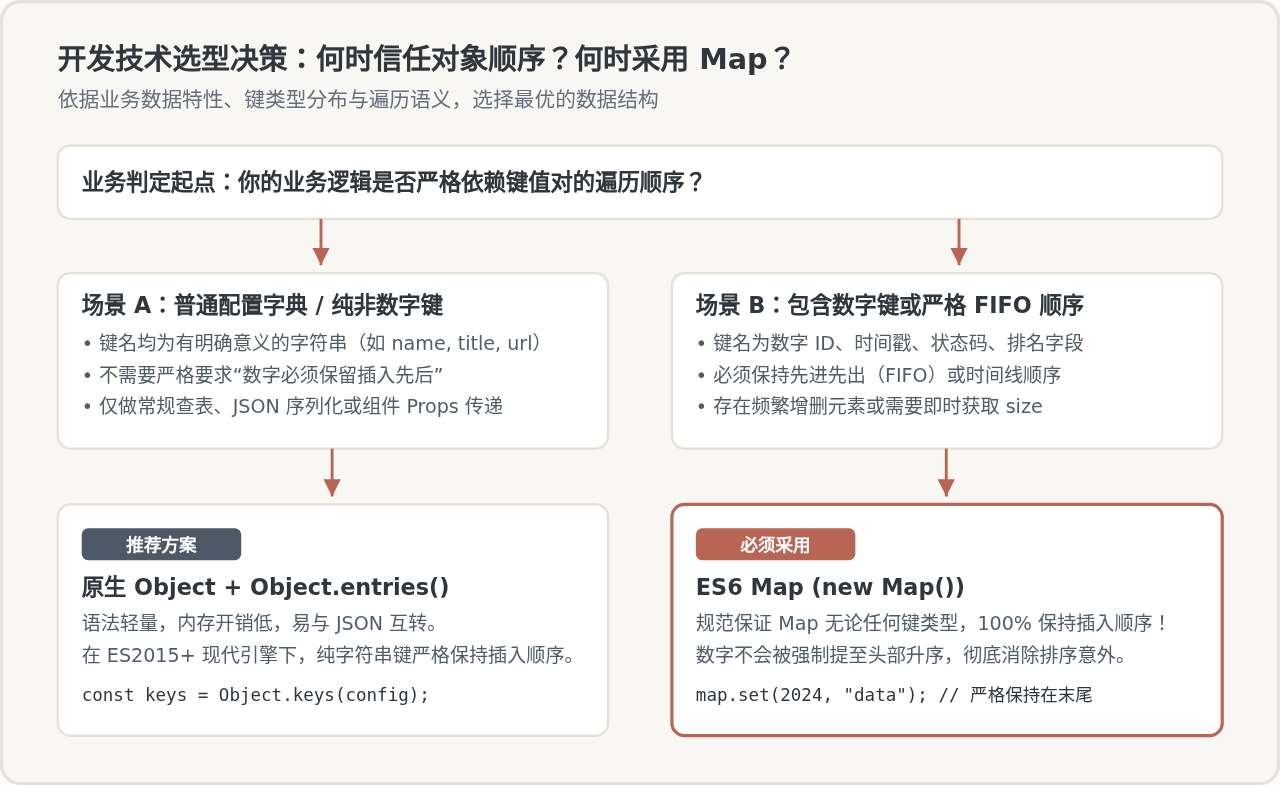
既然现代 JavaScript 的对象属性顺序已经完全确定,那么在工程开发中是否可以随意依赖普通对象来维持业务顺序?答案需要分类审视:
1. 何时可以放心使用普通对象?
当满足以下两个前提条件时,可以信赖普通对象的属性顺序:
- 运行环境明确为现代浏览器或 Node.js 环境(已全量支持 ES2015/ES2020 规范)。
- 对象的所有属性键全部为明确的非数字字符串(如常量配置表、UI 表单字段映射、枚举定义)。在这种情况下,属性的遍历顺序就是严格的插入顺序。
2. 为什么存在数字键时绝对不要使用普通对象保序?
最容易引发严重业务事故的场景,就是使用普通对象去记录带有先后顺序的带数字键数据。例如:
// 错误示范:试图用普通对象按时间顺序记录年份事件
const timeline = {};
timeline['2024'] = '巴黎奥运会';
timeline['2008'] = '北京奥运会';
timeline['2012'] = '伦敦奥运会';

console.log(Object.keys(timeline));
// 实际输出: ['2008', '2012', '2024']
// 原本期望的记录时间顺序被整数升序彻底打乱!
即使在声明时键是字符串类型的 '2024',引擎依然会将其识别为合法的整数索引,从而强行执行升序重排,破坏业务原本的先进先出(FIFO)或时间线逻辑。
3. 最佳替代方案:标准 Map 与有序结构
针对需要严格保持键值对插入顺序的业务场景,ES6 提供了原生的 Map 结构:
- 绝对保序:规范保证
Map的所有键(无论数字、负数、对象引用还是字符串)100% 严格按照插入先后顺序迭代,绝对不存在整数优先升序的特例。 - 性能更优:
Map专为频繁增删键值对优化,并原生提供map.size属性,无需像对象那样通过Object.keys(obj).length重新生成数组计算长度。 - 如果必须兼容 JSON:可以使用二维键值对数组
[ [key, value], ... ]进行传输和存储,既能保证顺序不被篡改,又具备标准的跨语言通用性。
核心总结
回答标题提出的问题:JS 遍历对象时的属性顺序是确定的。在现代规范下,它遵循确定的三阶段排序规则(整数升序 → 字符串插入序 → Symbol 插入序)。但正是因为存在整数自动升序机制,普通对象不能当作纯粹的插入顺序集合来使用。在涉及数字键、时间线或需要可靠顺序保证的场景下,使用 Map 才是符合工程严谨性的正确选择。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章