

本文探讨Node.js在处理大文件复制时常见的内存溢出问题,通过对比直接读取与使用Stream及Pipe机制的代码示例,揭示背压(Backpressure)机制如何有效限制内存缓冲,从而显著降低内存占用并提升执行效率。
前言
软件应用运行于计算机主存储器,即随机存取存储器(RAM)。JavaScript及Node.js(服务端JS)支持开发从微型到大型的终端用户软件。内存管理始终是棘手议题,低效实现可能阻塞服务器上运行的其他所有应用。C/C++开发者关注内存管理,因代码各处潜藏内存泄漏风险;JS开发者是否同样重视此问题?
JS开发者常在专用高容量服务器进行Web编程,可能忽略多任务延迟。例如开发Web服务器时,需运行数据库(MySQL)、缓存(Redis)及其他应用,它们均消耗主内存。随意编写应用可能降低其他进程性能,甚至导致内存分配拒绝。本文通过解决一个问题,探讨NodeJS的流、缓冲区和管道等结构,了解它们如何支持编写内存高效应用。
问题:大文件复制
若要求用Node.js编写文件复制程序,开发者可能迅速写出以下代码:
const fs = require('fs');

let fileName = process.argv[2];
let destPath = process.argv[3];

fs.readFile(fileName, (err, data) => {
    if (err) throw err;

    fs.writeFile(destPath || 'output', data, (err) => {
        if (err) throw err;
    });

    console.log('New file has been created!');
});
该代码根据输入的文件名和路径,尝试读取文件后写入目标路径,对小文件而言不成问题。
假设需备份一个大文件(大于4 GB),以我一个7.4G的超高清4K电影为例,使用上述代码将其从当前目录复制到其他目录。
$ node basic_copy.js cartoonMovie.mkv ~/Documents/bigMovie.mkv在Ubuntu(Linux)系统下,我得到了以下报错:
/home/shobarani/Workspace/basic_copy.js:7
if (err) throw err;
^
RangeError: File size is greater than possible Buffer: 0x7fffffff bytes
at FSReqWrap.readFileAfterStat [as oncomplete] (fs.js:453:11)
如你所见,由于Node.js最大只允许写入2GB数据到缓冲区,导致读取文件时发生错误。为解决此问题,在进行I/O密集操作(如复制、处理、压缩等)时,务必考虑内存情况。
NodeJS中的Streams和Buffers
为解决上述问题,需将大文件切分为多个文件块,并需要数据结构存放这些文件块。Buffer是存储二进制数据的结构。接下来,需要读写文件块的方法,Streams提供了此能力。
Buffers(缓冲区)
利用Buffer对象可轻松创建buffer。
let buffer = new Buffer(10); # 10 为 buffer 的体积
console.log(buffer); # prints <Buffer 00 00 00 00 00 00 00 00 00 00>
在新版Node.js(>8)中,也可这样写。
let buffer = new Buffer.alloc(10);
console.log(buffer); # prints <Buffer 00 00 00 00 00 00 00 00 00 00>
若已有数据如数组或其他数据集,可为其创建buffer。
let name = 'Node JS DEV';
let buffer = Buffer.from(name);
console.log(buffer) # prints <Buffer 4e 6f 64 65 20 4a 53 20 44 45 5>
Buffers具有一些重要方法如buffer.toString()和buffer.toJSON(),可深入存储的数据。
我们不会为优化代码直接创建原始buffer。Node.js和V8引擎在处理streams和网络socket时,已在创建内部缓冲区(队列)中实现这一点。
Streams(流)
简言之,流如同Node.js对象上的任意门。在网络中,入口为输入动作,出口为输出动作。我们将继续使用这些术语。
流的类型总共有四种:
- 可读流(用于读取数据)
- 可写流(用于写入数据)
- 双工流(同时可用于读写)
- 转换流(一种用于处理数据的自定义双工流,如压缩、检查数据等)
下面这句话清晰阐述了为何应使用流。
Stream API(尤其是stream.pipe()方法)的重要目标是将数据缓冲限制在可接受水平,使不同速度的源和目标不阻塞可用内存。
我们需要完成任务而不压垮系统。这也是文章开头已提及的。
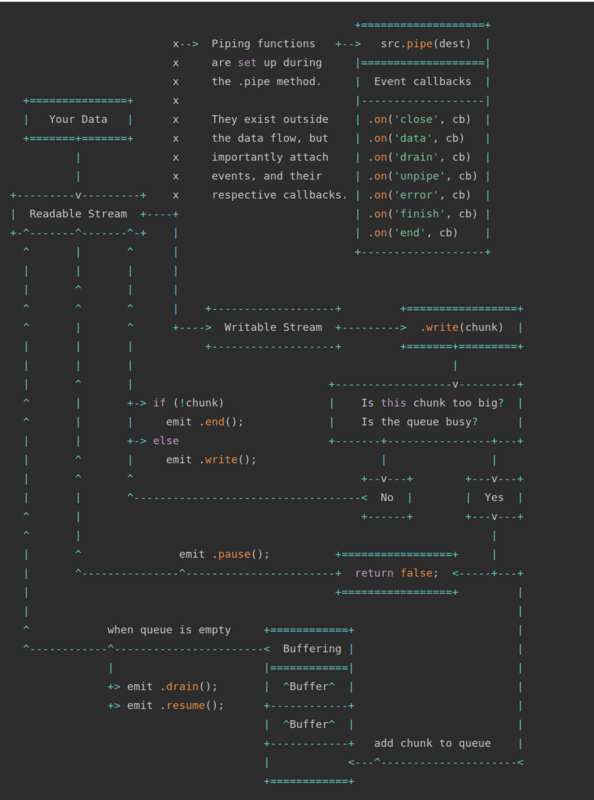
上图中展示了两种流:可读流和可写流。.pipe()方法是连接可读流和可写流的基本方法。若不理解上图,看完例子后可回到此处,一切将显得理所当然。管道是一种引人注目的机制,下面用两个例子说明。
解法1(简单地使用流来复制文件)
让我们设计一种解法解决前文大文件复制问题。首先创建两个流,然后执行接下来几个步骤。
1.监听来自可读流的数据块
2.把数据块写进可写流
3.跟踪文件复制的进度
我们将这段代码命名为streams_copy_basic.js
/*
    A file copy with streams and events - Author: Naren Arya
*/

const stream = require('stream');
const fs = require('fs');

let fileName = process.argv[2];
let destPath = process.argv[3];

const readabale = fs.createReadStream(fileName);
const writeable = fs.createWriteStream(destPath || "output");

fs.stat(fileName, (err, stats) => {
    this.fileSize = stats.size;
    this.counter = 1;
    this.fileArray = fileName.split('.');

    try {
        this.duplicate = destPath + "/" + this.fileArray[0] + '_Copy.' + this.fileArray[1];
    } catch(e) {
        console.exception('File name is invalid! please pass the proper one');
    }

    process.stdout.write(`File: ${this.duplicate} is being created:`);

    readabale.on('data', (chunk)=> {
        let percentageCopied = ((chunk.length * this.counter) / this.fileSize) * 100;
        process.stdout.clearLine();  // clear current text
        process.stdout.cursorTo(0);
        process.stdout.write(`${Math.round(percentageCopied)}%`);
        writeable.write(chunk);
        this.counter += 1;
    });

    readabale.on('end', (e) => {
        process.stdout.clearLine();  // clear current text
        process.stdout.cursorTo(0);
        process.stdout.write("Successfully finished the operation");
        return;
    });

    readabale.on('error', (e) => {
        console.log("Some error occured: ", e);
    });

    writeable.on('finish', () => {
        console.log("Successfully created the file copy!");
    });

});
程序中接收用户传入的两个文件路径(源文件和目标文件),创建两个流,将数据块从可读流运到可写流。定义变量追踪文件复制进度,输出到控制台(console)。同时订阅了一些事件:
data:当一个数据块被读取时触发
end:当一个数据块被可读流所读取完的时候触发
error:当读取数据块的时候出错时触发
运行该程序,可成功完成大文件(此处为7.4 G)的复制任务。
$ time node streams_copy_basic.js cartoonMovie.mkv ~/Documents/4kdemo.mkv然而,通过任务管理器观察程序运行过程中的内存状况时,依旧存在问题。
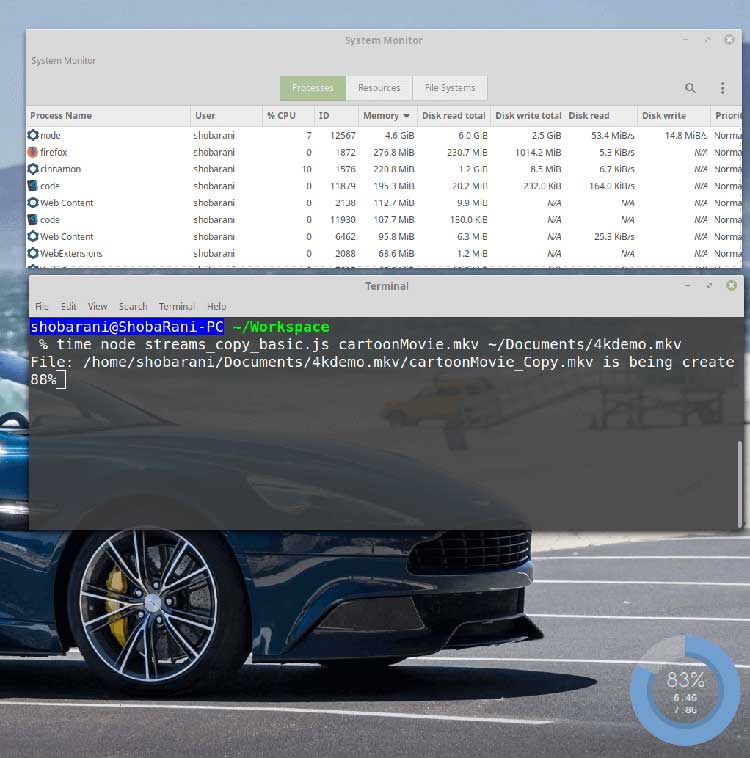
4.6GB?程序运行时消耗的内存在此讲不通,且很可能卡死其他应用。
发生了什么?
若仔细观察上图中的读写率,会发现一些端倪。
Disk Read: 53.4 MiB/s
Disk Write: 14.8 MiB/s
这意味着生产者以更快速度生产,而消费者无法跟上。计算机为保存读取的数据块,将多余数据存储到机器RAM中。这就是RAM出现峰值的原因。
上述代码在我的机器上运行了3分16秒……
17.16s user 25.06s system 21% cpu 3:16.61 total
解法2(基于流和自动背压的文件复制)
为克服上述问题,可修改程序自动调整磁盘读写速度。这个机制就是背压。我们无需做太多,只需将可读流导入可写流即可,Node.js会负责背压工作。
让我们将此程序命名为streams_copy_efficient.js
/*
    A file copy with streams and piping - Author: Naren Arya
*/

const stream = require('stream');
const fs = require('fs');

let fileName = process.argv[2];
let destPath = process.argv[3];

const readabale = fs.createReadStream(fileName);
const writeable = fs.createWriteStream(destPath || "output");

fs.stat(fileName, (err, stats) => {
    this.fileSize = stats.size;
    this.counter = 1;
    this.fileArray = fileName.split('.');

    try {
        this.duplicate = destPath + "/" + this.fileArray[0] + '_Copy.' + this.fileArray[1];
    } catch(e) {
        console.exception('File name is invalid! please pass the proper one');
    }

    process.stdout.write(`File: ${this.duplicate} is being created:`);

    readabale.on('data', (chunk) => {
        let percentageCopied = ((chunk.length * this.counter) / this.fileSize) * 100;
        process.stdout.clearLine();  // clear current text
        process.stdout.cursorTo(0);
        process.stdout.write(`${Math.round(percentageCopied)}%`);
        this.counter += 1;
    });

    readabale.pipe(writeable); // Auto pilot ON!

    // In case if we have an interruption while copying
    writeable.on('unpipe', (e) => {
        process.stdout.write("Copy has failed!");
    });

});
在此例子中,我们用一句代码替换了之前的数据块写入操作。
readabale.pipe(writeable); // Auto pilot ON!这里的pipe就是所有魔法发生的原因。它控制了磁盘读写的速度,以免阻塞内存(RAM)。
运行一下。
$ time node streams_copy_efficient.js cartoonMovie.mkv ~/Documents/4kdemo.mkv我们复制了同一个大文件(7.4 GB),让我们来看看内存利用率。
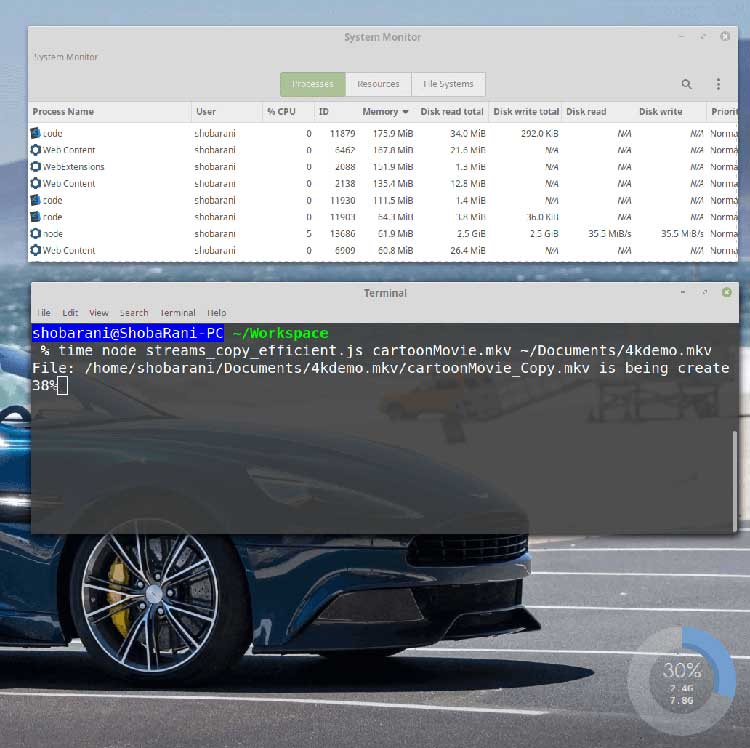
震惊!现在Node程序仅占用61.9 MiB的内存。若观察读写速率:
Disk Read: 35.5 MiB/s
Disk Write: 35.5 MiB/s
在任意给定时间内,因背压存在,读写速率保持一致。更惊喜的是,这段优化后的程序代码整整比之前的快了13秒。
12.13s user 28.50s system 22% cpu 3:03.35 total
由于Node.js流和管道,内存负载减少了98.68%,执行时间也减少了。这就是为什么管道是一个强大的存在。
61.9 MiB是由可读流创建的缓冲区大小。我们还可以使用可读流上的read方法为缓冲块分配自定义大小。
const readabale = fs.createReadStream(fileName);
readable.read(no_of_bytes_size);
除了本地文件的复制以外,该技术还可用于优化许多I/O操作的问题:
- 处理从卡夫卡到数据库的数据流
- 处理来自文件系统的数据流,动态压缩并写入磁盘
- 更多……
结论
我写这篇文章的动机,主要是为说明即使Node.js提供了很好的API,我们仍可能一不留神写出性能很差的代码。若能更多关注其内置工具,便可更好地优化程序运行方式。
以上就是如何用Node.js编写内存效率高的应用程序的详细内容,更多关于Node.js的资料请关注本站其它相关文章!