
全面解析 JavaScript 获取与设置标签内容的三个核心属性:innerText、textContent 与 innerHTML 的区别。深入对比它们在 HTML 标签解析、CSS 隐藏与样式感知、空白与排版换行处理、性能回流及 XSS 安全防护等维度的差异与最佳实践。

当前位置:首页 > JavaScript DOM 与事件 > 正文
JS获取标签内容:innerText、textContent与innerHTML的区别
作者:竹影
时间:2026-11-22
浏览:438
文章目录
在 JavaScript 开发中,读取或修改网页元素内部的内容,最常使用的三个属性分别是 innerText、textContent 和 innerHTML。它们的核心区别在于:innerHTML 专注于 HTML 标记与节点树的序列化,能保留并解析完整的标签结构;textContent 专注于 DOM 节点的全部纯文本,会提取所有子孙节点的内容且不受 CSS 样式影响,性能极高;innerText 则专注于 浏览器排版渲染后的可见文本,会感知 CSS 样式(自动排除 display: none 的内容并处理视觉换行),但会引发回流计算。掌握这三者的底层逻辑,能帮助我们在文本渲染、富文本操作与 XSS 安全防御中做出准确选择。
一、直观示例:同一个元素读取结果的差异
为了直观对比三者的返回值,我们准备一段具有代表性的 HTML 结构。该容器中包含了行内标签 <span>、使用 CSS 隐藏的段落、内联脚本 <script> 以及源代码中的缩进和换行:
<div id="demo">
  欢迎阅读 <span style="text-transform: uppercase;">javascript</span> 教程!
  <p style="display: none;">这里是一段隐藏的提示文本。</p>
  <script>console.log("内部脚本代码");</script>
  <br>保持学习与实践。
</div>
我们在控制台中分别读取该元素的三个属性:
const el = document.getElementById('demo');

// 1. 读取 innerHTML
console.log(el.innerHTML);
// 输出结果包含完整 HTML 标签片段:
// "  欢迎阅读 <span style="text-transform: uppercase;">javascript</span> 教程!
  <p style="display: none;">这里是一段隐藏的提示文本。</p>
  <script>console.log("内部脚本代码");</script>
  <br>保持学习与实践。
"

// 2. 读取 textContent
console.log(el.textContent);
// 输出结果剥离了 HTML 标签,但保留了源代码换行、空格、隐藏文本以及 <script> 中的代码:
// "  欢迎阅读 javascript 教程!
  这里是一段隐藏的提示文本。
  console.log("内部脚本代码");
  保持学习与实践。
"

// 3. 读取 innerText
console.log(el.innerText);
// 输出结果严格模拟人眼在浏览器中看到的视觉效果:
// 隐藏文本被过滤,<script> 彻底忽略,<br> 转换成换行,且 CSS 的大写样式生效:
// "欢迎阅读 JAVASCRIPT 教程!
保持学习与实践。"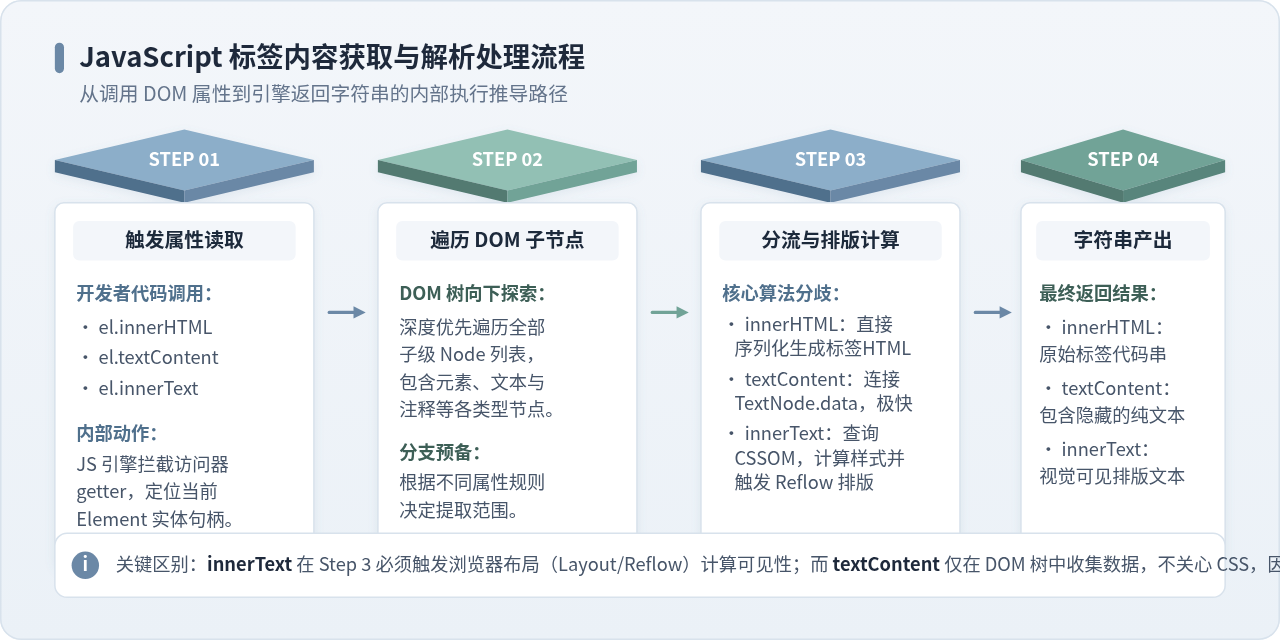
从上面的输出可以看出,浏览器处理这三个属性时经过了完全不同的逻辑通路:textContent 只遍历 DOM 树节点数据;innerHTML 调用了 HTML 序列化器;而 innerText 必须查询渲染树(Render Tree)并计算排版布局。
二、核心区别一:HTML 标签的解析与结构保留
这是三者在日常开发中最显著的区分点:
- innerHTML:读写都会保留或解析 HTML。读取时,它将元素内部的所有子节点序列化为合法的 HTML 文本;写入时,它会将传入的字符串传给浏览器的 HTML 解析引擎,将标签构建成真实的 DOM 元素节点并替换现有内容。
- textContent 与 innerText:无论读取还是写入,它们都将内容视作纯文本。读取时会主动剔除所有尖括号及标签名;写入时会将包含尖括号的内容进行自动字符转义,直接创建为
TextNode,绝对不会将字符串解释为新的 HTML 元素。
const container = document.getElementById('box');

// 写入 innerHTML:生成一个加粗标签
container.innerHTML = '<strong>加粗文本</strong>';
// 页面显示加粗的“加粗文本”,DOM 树新增了一个 <strong> 元素

// 写入 textContent:作为纯文本输出
container.textContent = '<strong>加粗文本</strong>';
// 页面字面显示为“<strong>加粗文本</strong>”,尖括号被安全展示,不会加粗
三、核心区别二:CSS 样式感知与隐藏元素提取
当页面元素应用了 CSS 样式时,innerText 与 textContent 的行为会出现决定性的分流:
1. display: none 与 visibility: hidden
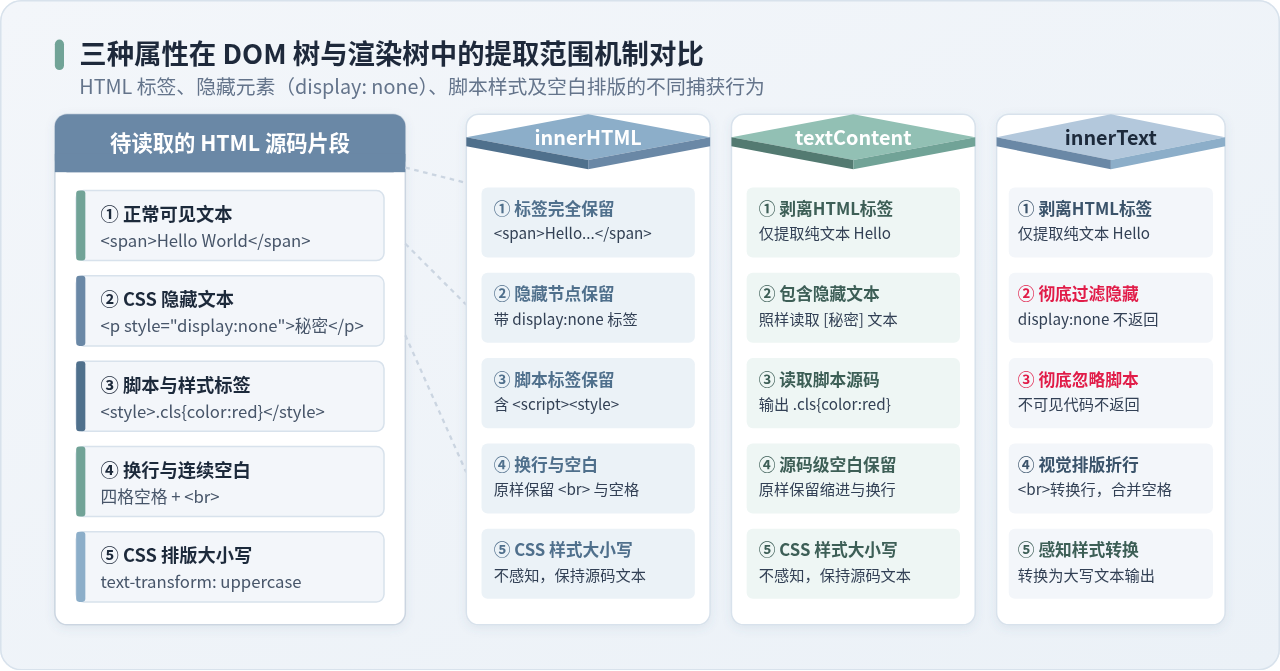
如果一个子元素设置了 display: none,它会从浏览器的渲染树(Render Tree)中被彻底移除。innerText 基于渲染树运作,因此完全不会读取该隐藏元素里的文本;相反,textContent 仅仅遍历底层的 DOM 节点树,只要该节点存在于 DOM 中,无论是否隐藏,都会如实提取出来。
需要注意的是,对于 visibility: hidden,元素虽然不可见,但在排版布局中仍然占据几何空间,此时部分现代浏览器在 innerText 中仍可能排除其文本或保留空白占位,而 textContent 始终原样返回。
2. <script> 与 <style> 标签的处理
在默认情况下,<script> 和 <style> 标签属于不可见元素。innerText 会自动识别并完全忽略这两个标签内部的内容;但 textContent 会忠实地将样式规则代码和 JavaScript 源码一并当做文本提取出来。如果你从父容器中批量提取文本,使用 textContent 可能会意外夹带 CSS 或 JS 源代码,需要在选择器中精准指定目标节点。
3. CSS 文本形变(text-transform)
如果一个元素的 CSS 样式设置了 text-transform: uppercase,页面视觉上会将字母渲染为大写。innerText 会读取这个计算后的结果,返回全大写的字符串;而 textContent 和 innerHTML 完全无视样式计算,依然返回 HTML 源码中的原始字母大小写。
四、核心区别三:空白字符、缩进与换行规则
处理源代码中存在的多余空白与换行时,三者的表现规则如下:
- textContent 忠实保留源码字符:开发者在 HTML 文件中写下的多余连续空格、Tab 缩进以及回车换行,
textContent会一个不落地保存在字符串中。 - innerText 模拟渲染排版规则:它遵循浏览器的空白折叠规则(White-space Collapsing),将多个连续的空格合并为一个空格,并且只在具有视觉折行效果的地方(例如
<br>标签或块级元素<div>、<p>之间)生成实际的 - innerHTML 保持原始标记:如果遇到换行,它输出的是代码里的
<br>字符串或源码中的换行字符。
实用提示:如果需要获取用户肉眼看到的一行一行排好版的文本(例如“复制屏幕所选内容”功能),使用 innerText 最符合预期;如果需要处理原始数据流、模板渲染或保留代码格式,应使用 textContent。
五、核心区别四:性能开销与回流重排(Reflow)
在性能敏感的高频操作场景中,textContent 与 innerText 的运行效率差异十分巨大:
textContent是一项轻量级的底层 DOM 操作,浏览器只需顺着 DOM 树的链表结构收集各个TextNode内部的字符串缓冲区即可完成拼接,不会触发任何 CSS 样式计算和回流重排。innerText为了确认文本是否被display: none隐藏、是否大写形变、是否折行,必须强制要求浏览器完成最新样式的计算以及几何布局的确认(Layout / Reflow)。如果在循环或高频事件监听器(如scroll、resize)中频繁读取innerText,会导致严重的页面卡顿与强制同步重排(Forced Synchronous Layout)。
六、核心区别五:内容写入与 XSS 安全防范
在修改页面标签内容时,安全边界是必须优先考量的要素:
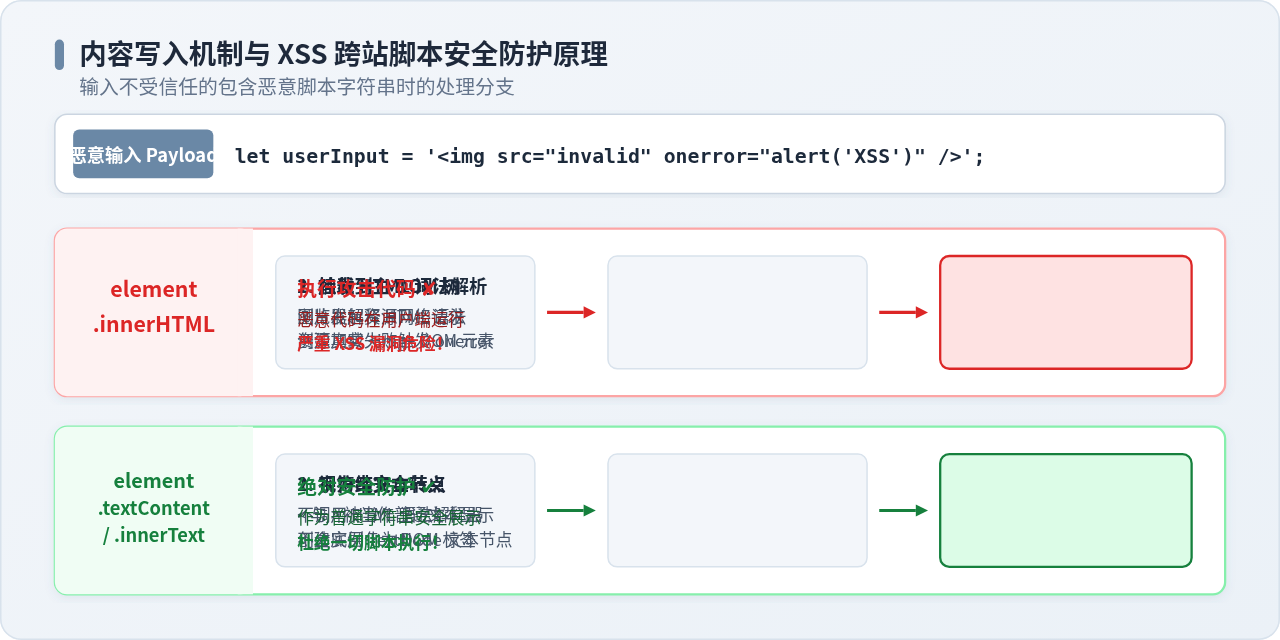
当我们需要将接口返回的数据或用户输入的文本渲染到页面上时,若错误地使用 innerHTML,一旦内容中含有未经转义的恶意代码(例如 <img src="x" onerror="stealCookie()">),浏览器就会将其解析为可执行的 DOM 元素,进而触发 XSS 跨站脚本攻击。
安全规范:只要渲染的目标是“纯文本”,永远优先使用 element.textContent = data;。浏览器会把一切尖括号和引号当作普通字面量处理,在底层杜绝了脚本被解析执行的可能。若业务确需插入富文本 HTML,必须先使用经过严格审计的净化库(如 DOMPurify)清洗标签。
七、选型决策指南与特性总结
为了帮助在不同业务场景中做出正确的技术选型,我们可以通过以下决策路径与对比矩阵进行判断:
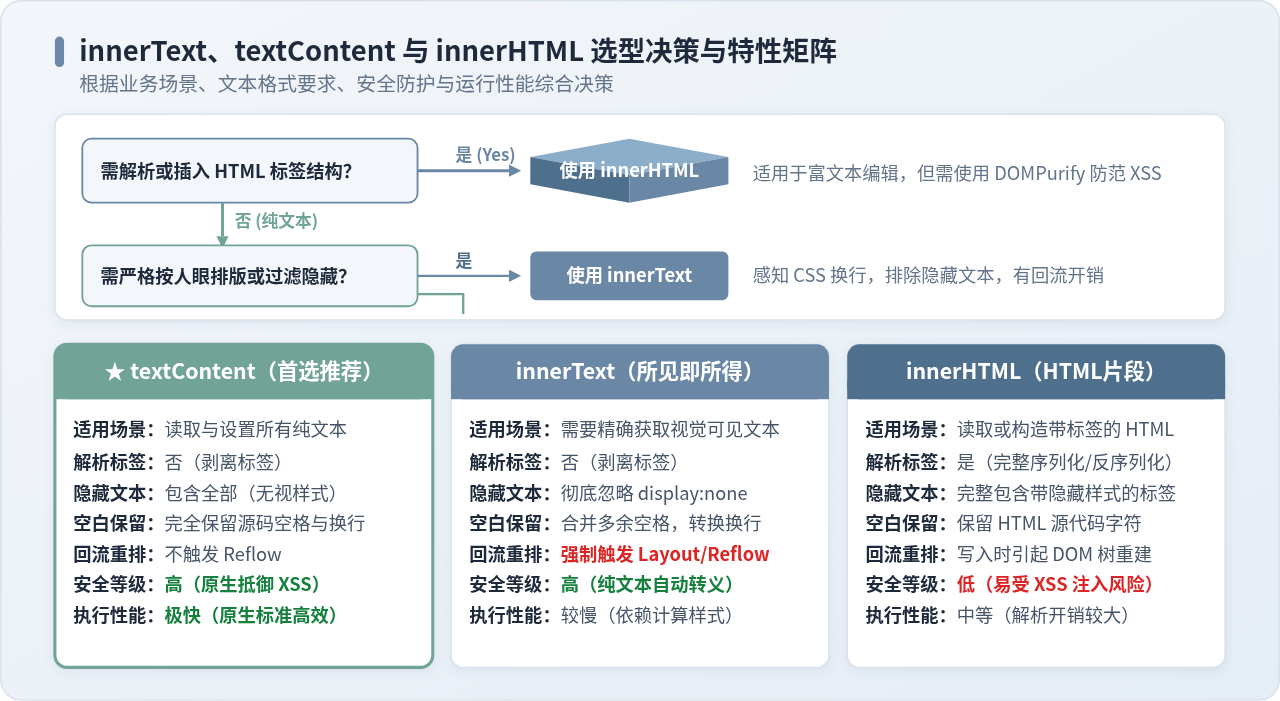
| 特性对比维度 | textContent | innerText | innerHTML |
|---|---|---|---|
| 数据类型 | 节点全部纯文本 | 渲染后的可见纯文本 | HTML 标记与文本 |
| 解析 HTML 标签 | 否(剔除标签) | 否(剔除标签) | 是(完整解析与构造) |
| 感知 CSS 样式 | 否(完全忽略样式) | 是(感知隐藏与文本形变) | 否(输出源码标签) |
| 隐藏元素处理 | 包含隐藏元素文本 | 过滤 display:none 内容 | 输出隐藏元素的标签文本 |
| <script> <style> | 输出内部脚本/样式文本 | 彻底忽略不输出 | 完整输出标签及内容 |
| 格式与空白排版 | 保留源码空格与换行 | 合并多余空格,转换视觉换行 | 原样保留 HTML 源码字符 |
| 回流重排(Reflow) | 不触发,无排版开销 | 强制计算样式,触发回流 | 写入时可能引起 DOM 重建 |
| XSS 安全风险 | 安全(原生抵御注入) | 安全(自动字符串转义) | 高危(未净化直接拼接引发 XSS) |
| 标准规范支持 | W3C DOM Level 3 标准 | 早前为 IE 私有,后纳入 HTML5 | W3C HTML5 标准 |
使用选型速记:
- 默认推荐使用
textContent:在 90% 以上需要读取或写入纯文本的常规场景中,它具备最快的运行性能、无回流负担,并且天生免疫 XSS 漏洞。 - 视觉所见即所得使用
innerText:当需要获取用户在屏幕上真正“看得到”的文字排版,或者需要明确过滤掉隐藏元素时使用。 - 富文本渲染慎用
innerHTML:仅在必须动态构造、插入或读取完整 HTML 标签结构时使用,并且在写入不可信数据时务必做好安全净化过滤。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章