
深入解析在Node.js中使用fs.readFile读取JavaScript脚本文件出现乱码的核心根源,提供encoding参数配置规范、GBK文件处理方案、UTF-8 BOM剥离方法以及完整的避坑排查指南。

当前位置:首页 > Node.js 基础 > 正文
Node.js读取JS文件乱码:fs.readFile encoding参数设置指南
作者:接口漫谈
时间:2026-11-22
浏览:212
文章目录
在 Node.js 中调用
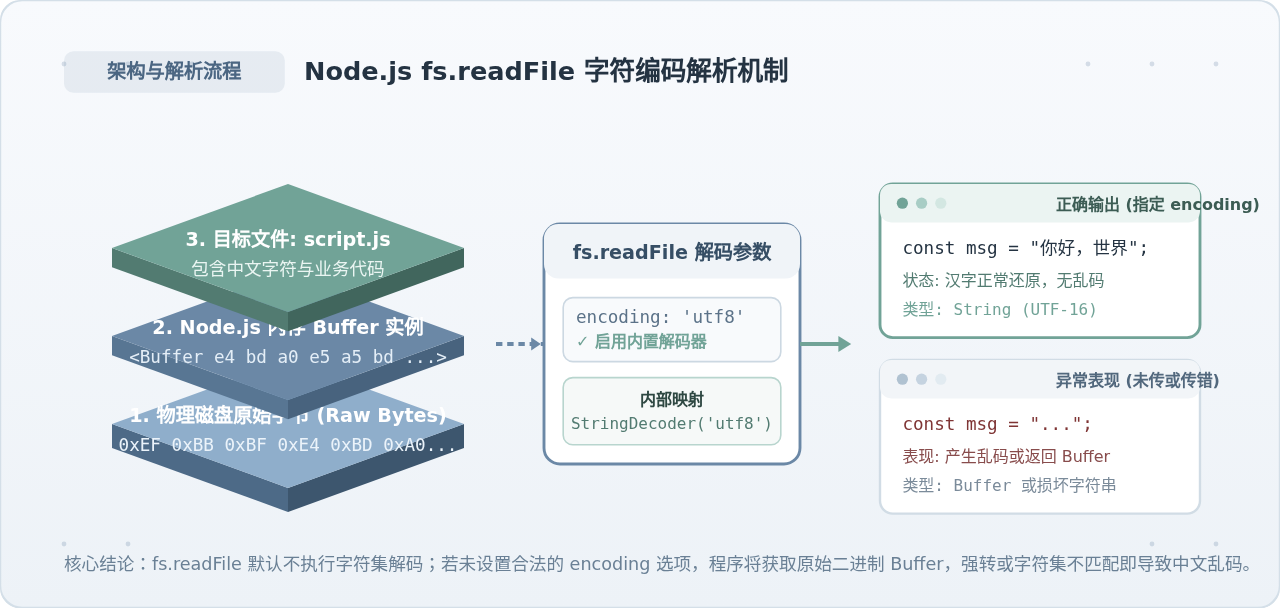
fs.readFile 读取包含中文注释或字符串的 JavaScript 文件时,出现乱码的核心原因通常是未显式指定编码参数导致返回了原始 Buffer 二进制对象,或者源文件实际保存的编码格式(如 GBK/ANSI 或带 BOM 的 UTF-8)与 Node.js 默认解码器产生冲突。要彻底解决该问题,只需在调用时传入 'utf8' 字符串或 { encoding: 'utf8' } 选项;若遇到历史遗留的 GBK 编码脚本,则需读取原始 Buffer 并配合 iconv-lite 库进行对应解码。
一、为什么直接读取 JS 文件会出现乱码?
在 Node.js 的文件系统(fs)模块设计中,fs.readFile 承担的是底层的通用 I/O 操作。如果开发者在调用该方法时只传入了文件路径与回调函数,Node.js 无法也不会预先假设目标文件是文本文件还是二进制图片、压缩包。
因此,当省略第二个参数时,回调函数接收到的数据对象是一个 Buffer 实例。许多开发者直接在终端中打印该变量,或者在未指定编码的情况下将其与字符串进行隐式拼接(例如 'File content: ' + data),甚至直接调用 data.toString()。
由于现代中文字符在 UTF-8 编码下占用 3 个字节,一旦遇到编码格式不统一(例如在 Windows 记事本中保存的 ANSI/GBK 格式)、分块切片损坏,或者脚本开头包含不可见的 UTF-8 BOM 标记(),解码器便无法正确识别字符前导位,最终将损坏的字节序列渲染为 (Unicode 替换字符)或一连串无序的问号与乱码。
二、fs.readFile encoding 参数的标准配置方式
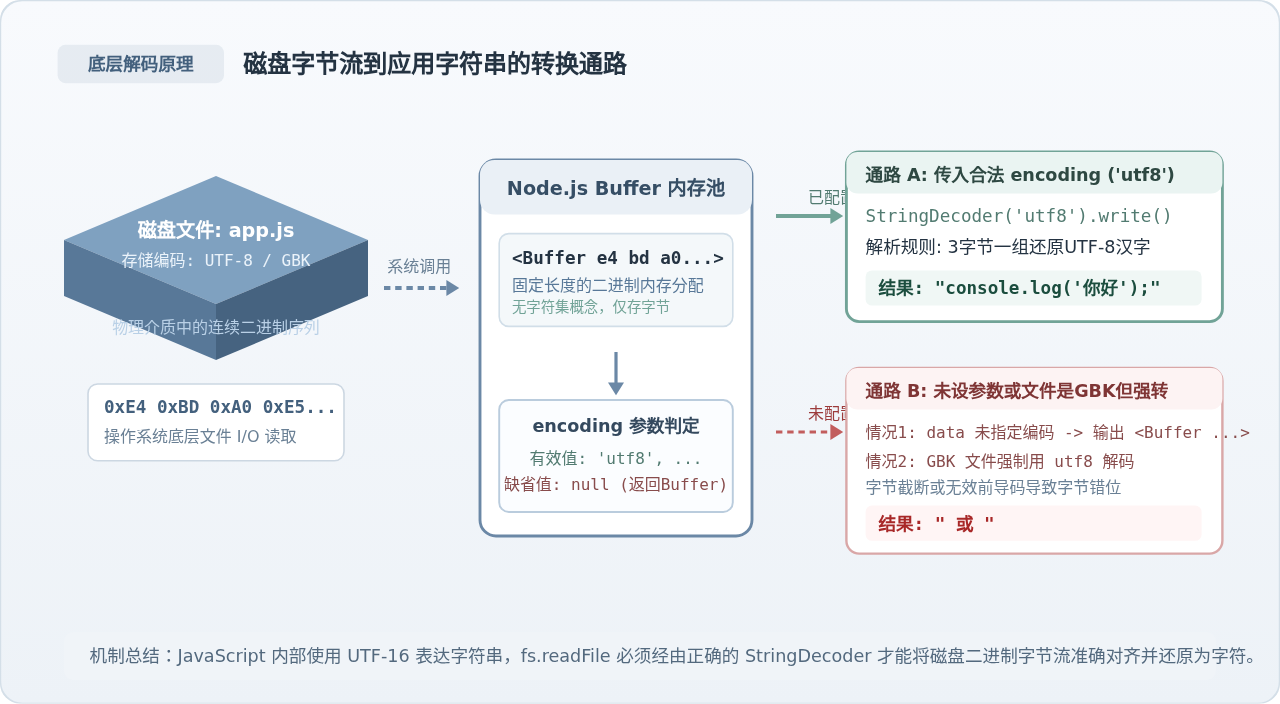
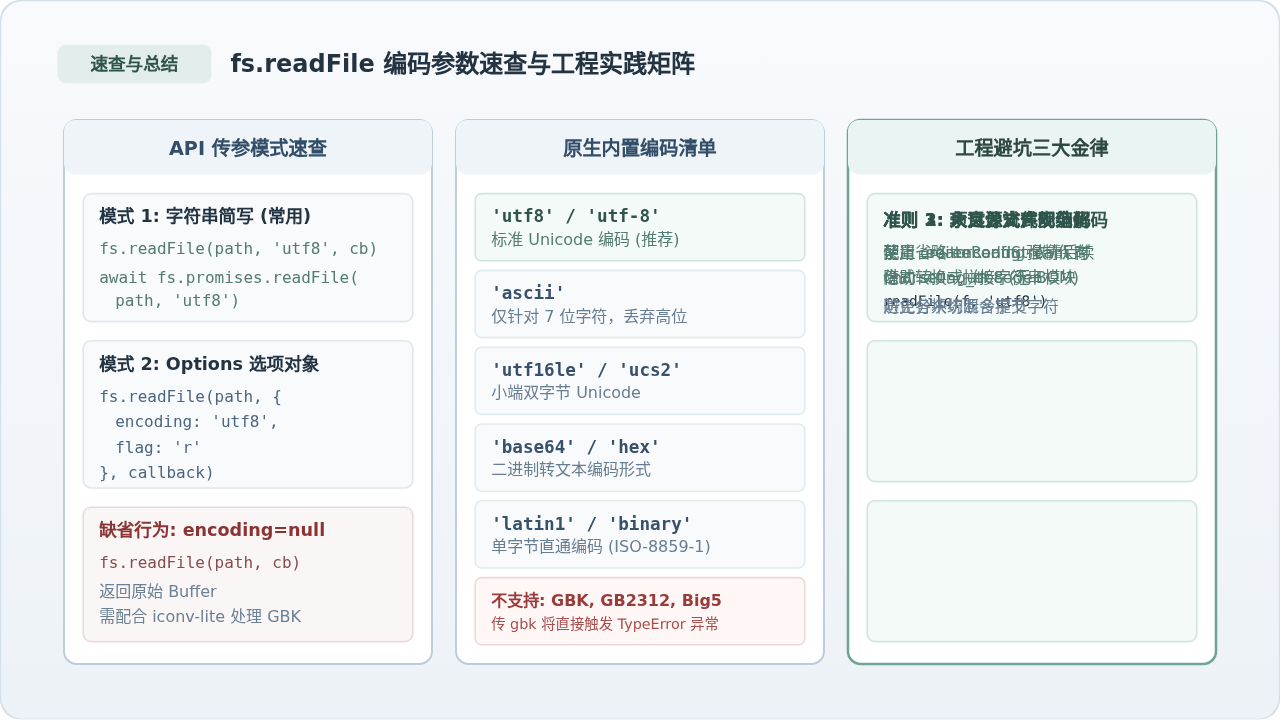
要让 fs.readFile 自动将二进制字节流转换为开发所需的字符串,必须通过 encoding 参数明确指定解码算法。Node.js 官方提供了两种标准的配置写法:
1. 字符串简写形式(推荐日常使用)
将编码字符串作为第二个参数直接传入,这是最简洁也是最常见的写法:
const fs = require('fs');
const path = require('path');

const targetPath = path.join(__dirname, 'script.js');

// 回调函数风格
fs.readFile(targetPath, 'utf8', (err, content) => {
  if (err) {
    console.error('读取文件失败:', err.message);
    return;
  }
  // 此时 content 为标准 String 类型,中文正常展示
  console.log(content);
});
在现代工程项目中,通常更推荐使用 fs/promises 搭配 async/await 语法:
const fs = require('fs/promises');
const path = require('path');

async function readMyScript() {
  try {
    const targetPath = path.join(__dirname, 'script.js');
    const content = await fs.readFile(targetPath, 'utf8');
    console.log('读取成功,文件内容:
', content);
  } catch (err) {
    console.error('读取出错:', err.message);
  }
}

readMyScript();
2. 选项对象(Options)形式
当需要额外控制文件打开标记(如 flag: 'r')或配置信号量时,可以传入一个配置对象:
const fs = require('fs');

fs.readFile('script.js', { encoding: 'utf8', flag: 'r' }, (err, content) => {
  if (err) throw err;
  console.log(content);
});
参数别名注意:在 Node.js 中,
'utf8' 与 'utf-8' 是等价的,大小写不敏感;官方文档推荐使用小写无连字符的 'utf8'。
3. Node.js 官方支持的原生编码一览
需要明确的是,Node.js 内部只支持以下字符集。如果传入不在下表中的编码字符串,系统将直接抛出 TypeError: Unknown encoding 错误:
| 编码标识 | 对应字符集 | 主要适用场景 |
|---|---|---|
'utf8' / 'utf-8' |
UTF-8 变长 Unicode 编码 | 绝大多数现代 JavaScript 文件、JSON 及网页源码 |
'ascii' |
7 位 ASCII 字符集 | 仅包含英文字符与标准符号,遇中文字符会强制剥离最高位导致乱码 |
'utf16le' / 'ucs2' |
小端序 16 位 Unicode | 特定 Windows 导出的宽字符文本文件 |
'latin1' / 'binary' |
ISO-8859-1 单字节编码 | 每个字节原样对应一个字符代码点,常用于低级二进制直通传输 |
'base64' / 'hex' |
二进制转 ASCII 文本编码 | 用于输出二进制文件的十六进制或 Base64 字符串 |
三、典型乱码场景与针对性解决方案
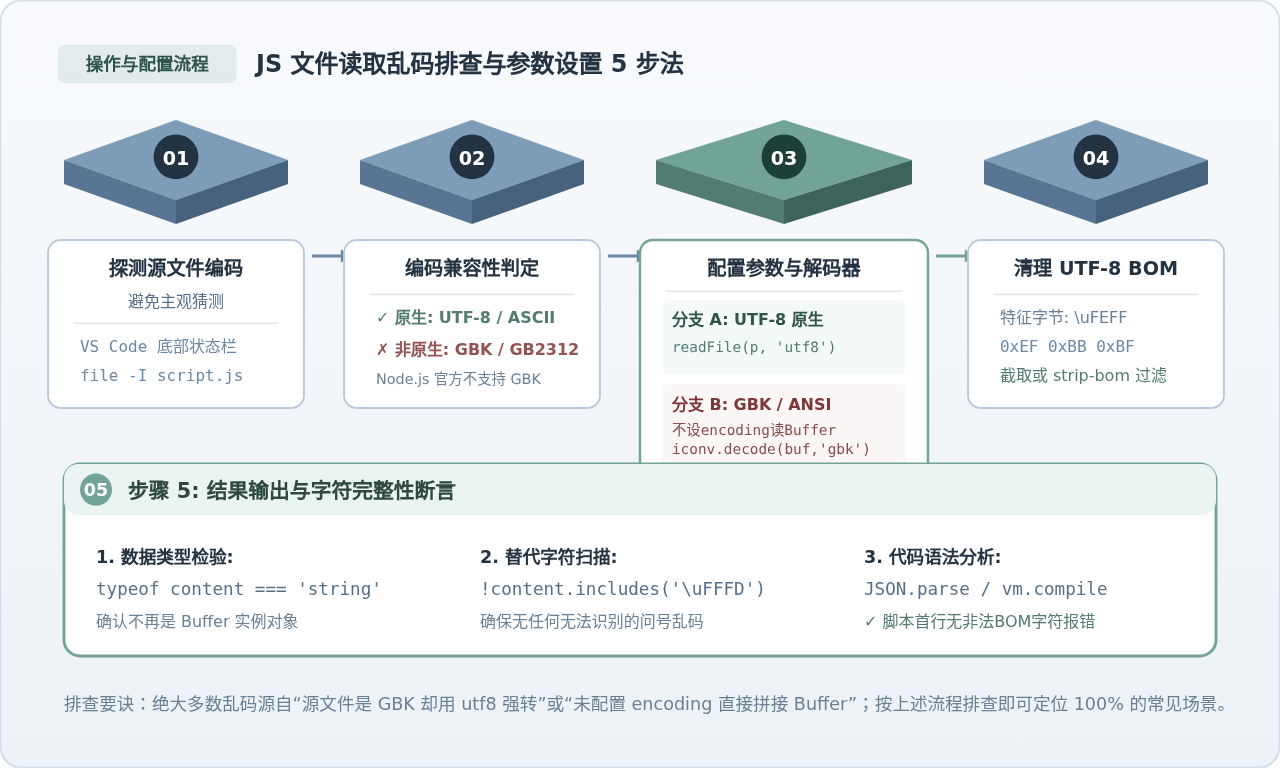
场景 1:源文件本为 UTF-8,但控制台输出了十六进制字节
表现:控制台打印出 <Buffer 63 6f 6e 73 6f 6c 65 2e 6c 6f 67 28 27 e4 bd a0 e5 a5 bd 27 29 3b>,并没有看到可读代码。
解决方式:为 fs.readFile 补充传入 'utf8' 参数即可;或者如果代码已获取了 Buffer,可通过 data.toString('utf8') 完成手动还原。
场景 2:历史遗留项目或 Windows 导出的 GBK/GB2312 文件
表现:即便设置了 fs.readFile(file, 'utf8'),打印出的中文仍然是 ֪ 或乱码菱形符号。
原因剖析:Node.js 内核出于体积精简考虑,原生不包含 GBK、GB2312 与 Big5 解码器。GBK 汉字采用双字节编码,与 UTF-8 的 3 字节变长结构完全不同。当强行使用 UTF-8 解码 GBK 字节时,字节无法对齐,解码器会强行插入 Unicode 替换字符 �(),造成信息永久性丢失。
标准解法:调用 fs.readFile 时不传递 encoding 参数(保留原始 Buffer),然后借助纯 JavaScript 编码转换库 iconv-lite 进行准确解码:
// 需先执行 npm install iconv-lite
const fs = require('fs/promises');
const iconv = require('iconv-lite');
const path = require('path');

async function readGbkJsFile(filePath) {
  // 1. 读取为原始二进制 Buffer,切勿传入 'utf8'
  const rawBuffer = await fs.readFile(filePath);

  // 2. 利用 iconv-lite 按照 gbk 字符集进行解码
  const decodedContent = iconv.decode(rawBuffer, 'gbk');

  console.log('GBK 文件正确解析内容:
', decodedContent);
  return decodedContent;
}

readGbkJsFile(path.join(__dirname, 'legacy-module.js'));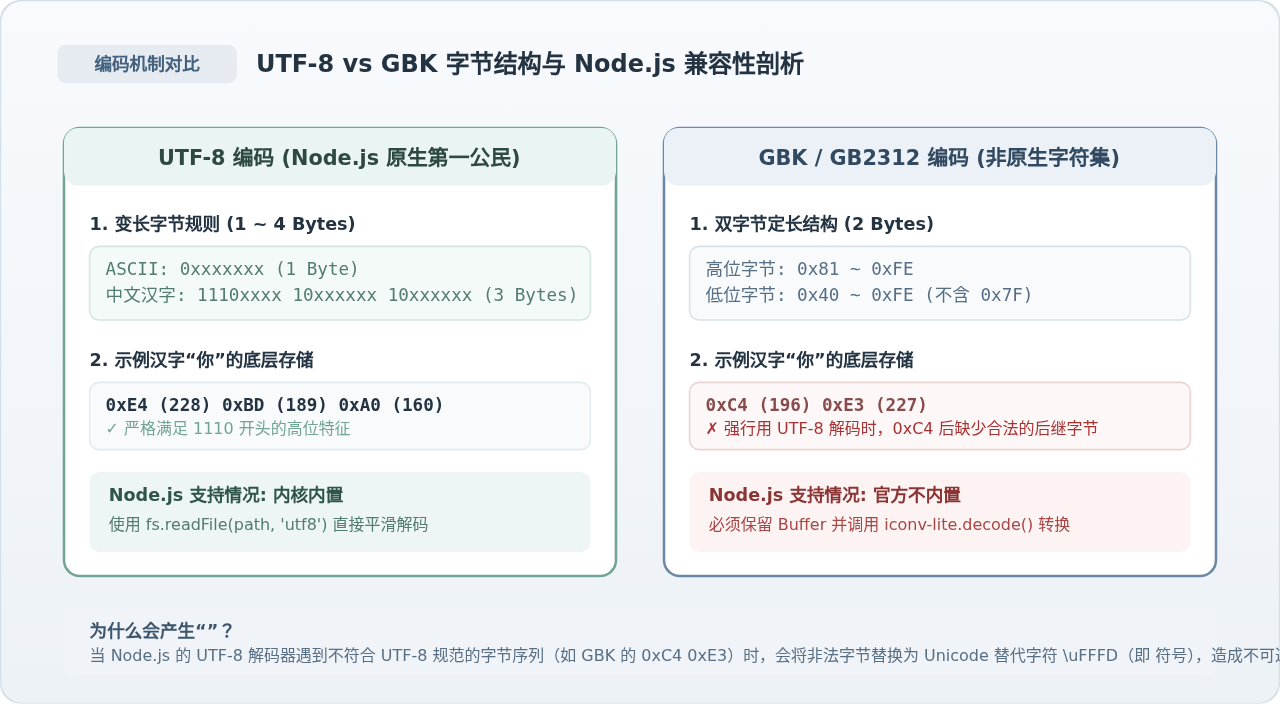
场景 3:UTF-8 BOM 头导致的第一行语法报错
表现:在读取 JS 脚本并通过 eval()、vm.runInContext() 或将其作为 JSON 解析时,控制台报错 SyntaxError: Unexpected token in JSON at position 0,或者首行报非法字符错误。
原因剖析:Windows 自带的部分文本编辑器在保存 UTF-8 格式时,会在文件最开头写入 3 个隐藏字节:0xEF 0xBB 0xBF(即 Byte Order Mark,BOM,对应字符 )。Node.js 的 'utf8' 解码器会将这 3 个字节原样解码为零宽非换行空格字符 ,虽然在文本输出中不可见,但在解析语法时会被视作语法错误。
修复代码:在获取字符串后剥离开头的 BOM 标记:
function stripBOM(content) {
  if (typeof content === 'string' && content.charCodeAt(0) === 0xFEFF) {
    return content.slice(1);
  }
  return content;
}

// 配合 fs.readFile 使用
const fs = require('fs/promises');

async function readCleanScript(file) {
  const rawText = await fs.readFile(file, 'utf8');
  const cleanScript = stripBOM(rawText);
  // 执行或语法分析安全无隐患
  return cleanScript;
}
四、工程化避坑指南与验证步骤
在团队协作与持续集成流程中,建议通过以下规范从源头上杜绝乱码隐患:
-
统一项目字符集配置:在项目根目录创建
.editorconfig文件,明确声明charset = utf-8,保证所有团队成员提交的代码文件均为不带 BOM 的 UTF-8 编码。 -
流式读取(Stream)时使用 string_decoder:如果通过
fs.createReadStream分块读取大体积脚本文件,切勿直接对每个 chunk 调用chunk.toString('utf8')。因为分块很可能会将一个 3 字节的 UTF-8 汉字切断在两个 chunk 之间。正确做法是引入 Node.js 内置的const { StringDecoder } = require('string_decoder');,通过decoder.write(chunk)保留未闭合的多字节缓存。 -
多环境准确探测文件编码:遇到异常乱码时,请在终端使用
file -I filename.js(macOS/Linux)或在 VS Code 底部状态栏直接查看文件的物理编码,先确认源头编码,再匹配对应的解码逻辑。
五、总结
在 Node.js 中读取 JS 文件发生乱码,本质上是二进制字节流与字符解码器之间的契约未对齐。
治理乱码的行动指南非常清晰:在读写标准现代代码时,始终显式传递 'utf8' 编码参数;在面对历史遗留的 GBK/ANSI 编码文件时,保持缺省状态读取原始 Buffer 并交由 iconv-lite 解码;在解析带格式文本或动态执行脚本前,做好 BOM 头的检测与剥离。严格遵循这一处理范式,即可确保文本数据在整个 Node.js I/O 管道中完整、准确且无损还原。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章