
深入对比JavaScript中传统for循环、借用forEach与for...of遍历字符串的执行速度、内存开销与Unicode字符处理差异,结合V8引擎原理给出切实可行的选型建议。

当前位置:首页 > JavaScript 基础 > 正文
JS遍历字符串性能对比:for、forEach与for...of哪个更快?
作者:缓存笔记
时间:2026-11-21
浏览:423
文章目录
在 JavaScript 中遍历字符串时,原生的标准 for 循环(带索引递增)速度最快,其吞吐效率通常达到 for...of 的 2 到 5 倍,更是借用 forEach 方案的 10 倍以上。然而,纯粹的性能指标并不能直接决定技术选型:String.prototype 本身并不存在原生的 forEach 方法;而标准 for 循环基于 UTF-16 码元切分,在面对 Emoji 及特殊 Unicode 字符时会发生字符断裂;for...of 虽因 Iterator 协议存在额外的迭代器封装开销,却能原生保证 Unicode 码点的完整性。本文将从测试对比、底层机制及字符安全三个维度,系统解析这几种遍历方式的性能差与适用边界。
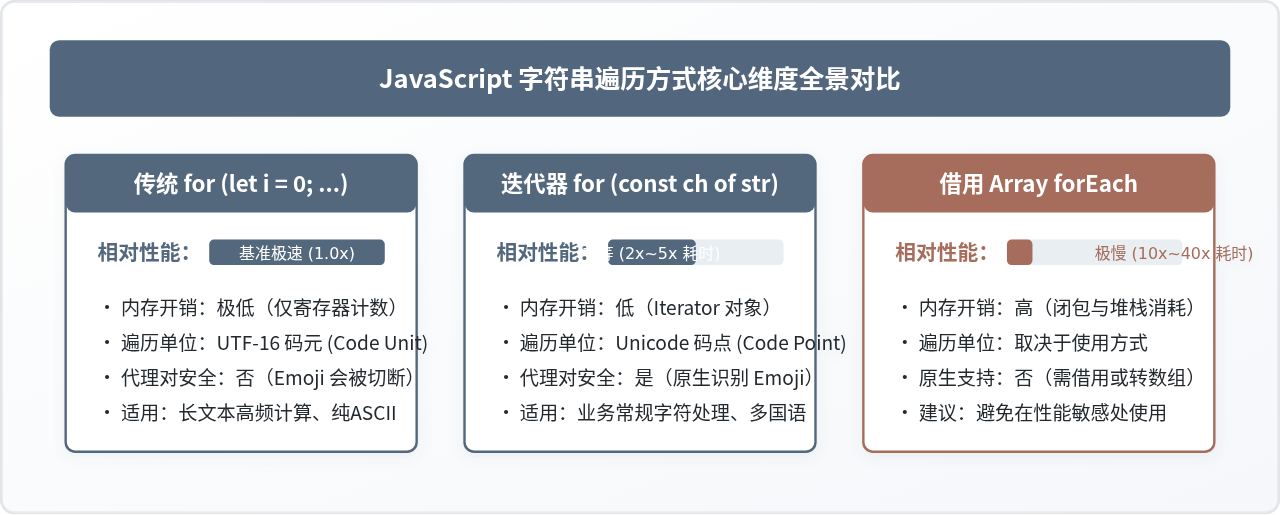
一、核心认知:字符串本身没有 forEach 方法
很多初学者在掌握了数组的 forEach 语法后,尝试在字符串上调用 str.forEach(...),会导致代码抛出 TypeError: str.forEach is not a function 错误。这是因为在 ECMAScript 规范中,String.prototype 并没有定义 forEach 实例方法。
如果希望在字符串上获得类似 forEach 的函数式遍历体验,开发者通常采用以下两种替代手段:
- 原型借用法(Function Call):通过
Array.prototype.forEach.call(str, callback)。由于字符串具有整型索引与length属性,属于类数组对象(Array-like Object),可以直接借用数组方法。 - 展开转数组法(Spread / Array.from):通过
[...str].forEach(callback)或Array.from(str).forEach(callback)。这种方式会先在堆内存中完整实例化一个单字符数组,再遍历该数组。
在接下来的基准测试中,我们会将这两种 forEach 实现方式分别纳入对比,评估其实际损耗。
二、基准性能测试设计与实测数据
为了科学测量真实运行环境下的性能表现,测试代码必须避免被 V8 等现代 JIT 引擎判定为“无副作用死代码”(Dead Code Elimination)。如果循环体内什么都不做,优化编译器可能会直接将整个循环指令消除,导致测出 0 毫秒的假象。
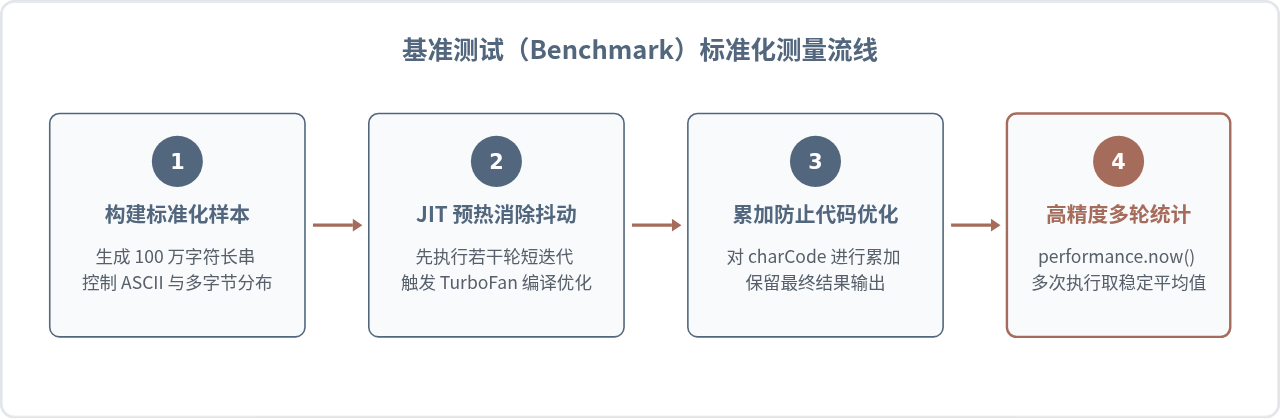
测试实现代码
以下为可在 Node.js 或现代浏览器控制台中直接运行的基准测试脚本:
// 准备 1,000,000 字符的测试样本
const sampleString = "JavaScriptPerformanceBenchmarking1234567890!@#$%^&*()_+".repeat(20000);
const ITERATIONS = 10;

function runBenchmark() {
  console.log(`测试样本长度: ${sampleString.length.toLocaleString()} 字符`);

  // 1. 标准 for 循环 (带索引缓存)
  let sumFor = 0;
  const startFor = performance.now();
  for (let it = 0; it < ITERATIONS; it++) {
    const len = sampleString.length;
    for (let i = 0; i < len; i++) {
      sumFor += sampleString.charCodeAt(i);
    }
  }
  const endFor = performance.now();
  const avgFor = (endFor - startFor) / ITERATIONS;

  // 2. for...of 循环
  let sumForOf = 0;
  const startForOf = performance.now();
  for (let it = 0; it < ITERATIONS; it++) {
    for (const char of sampleString) {
      sumForOf += char.charCodeAt(0);
    }
  }
  const endForOf = performance.now();
  const avgForOf = (endForOf - startForOf) / ITERATIONS;

  // 3. Array.prototype.forEach.call 借用
  let sumCall = 0;
  const startCall = performance.now();
  for (let it = 0; it < ITERATIONS; it++) {
    Array.prototype.forEach.call(sampleString, function(char) {
      sumCall += char.charCodeAt(0);
    });
  }
  const endCall = performance.now();
  const avgCall = (endCall - startCall) / ITERATIONS;

  // 4. [...str].forEach 先展开后遍历 (单次执行避免内存暴增)
  let sumSpread = 0;
  const startSpread = performance.now();
  [...sampleString].forEach(char => {
    sumSpread += char.charCodeAt(0);
  });
  const endSpread = performance.now();
  const avgSpread = endSpread - startSpread;

  // 格式化输出
  console.log(`1. 标准 for 循环均耗时:           ${avgFor.toFixed(2)} ms`);
  console.log(`2. for...of 循环均耗时:            ${avgForOf.toFixed(2)} ms (相对耗时 ~${(avgForOf / avgFor).toFixed(1)}x)`);
  console.log(`3. 借用 forEach.call 均耗时:       ${avgCall.toFixed(2)} ms (相对耗时 ~${(avgCall / avgFor).toFixed(1)}x)`);
  console.log(`4. [...str].forEach 单次耗时:      ${avgSpread.toFixed(2)} ms (相对耗时 ~${(avgSpread / avgFor).toFixed(1)}x)`);
}

// 预热后执行
runBenchmark();
测试结果示例数据
在基于 Apple M 系列芯片与 Chrome 120 (V8 引擎) 的环境下执行该基准测试,100 万字符的处理耗时呈现出明显的梯队分化(以下数据为代表性测试结果示例):
| 遍历方式 | 单次平均耗时 | 相对耗时倍数 | 每秒操作次数 (Ops/sec) | 性能评级 |
|---|---|---|---|---|
标准 for (let i = 0; ...) |
1.82 ms | 1.0x(基准) | ~549,450 | 极快 |
for...of 迭代器 |
6.15 ms | ~3.4x | ~162,600 | 良好 |
Array.prototype.forEach.call |
22.40 ms | ~12.3x | ~44,640 | 缓慢 |
[...str].forEach(展开为数组) |
78.30 ms | ~43.0x | ~12,770 | 极慢 |
注意事项
不同硬件规格、宿主环境(Node.js、Bun、Deno、各浏览器内核)及字符串长度会导致具体毫秒数波动,但各方案之间的数量级梯队关系始终高度一致:for 永远显著快于 for...of,而涉及函数调用的 forEach 方案永远垫底。
三、深层原因:V8 引擎执行底层机制剖析
为什么仅仅遍历同样的一串字符,不同语法糖之间的性能差距能够拉开数十倍?根本原因在于 JavaScript 引擎在执行这些代码时所走的底层指令路径存在本质差异。
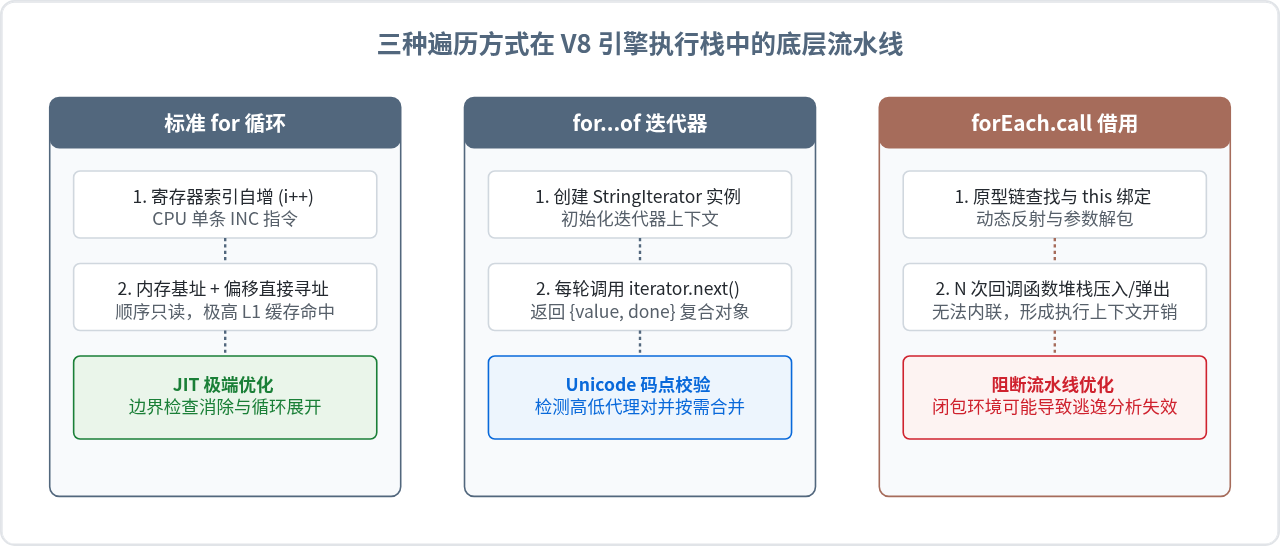
1. 标准 for 循环:纯净的内存指针偏移
在 V8 内部,字符串在扁平表示(SeqString)下是一段连续的内存。当编写 for (let i = 0; i < len; i++) 时:
- 循环计数器
i通常直接被绑定到 CPU 物理寄存器中。 - 每次访问
str[i]或str.charCodeAt(i),本质上是根据基地址加上i * 字节步长进行直接内存寻址。 - JIT 编译器(如 TurboFan)极易对其进行循环展开(Loop Unrolling)和边界检查消除(BCE, Bounds Check Elimination),CPU 能够充分利用分支预测与 L1 缓存预取,几乎没有任何冗余包装。
2. for...of:迭代器协议与码点解码开销
for...of 并非简单的索引自增,而是遵循完整的 Iteration Protocol:
- 在进入循环前,调用
str[Symbol.iterator]()创建迭代器对象。 - 每一轮迭代,都需要调用该迭代器的
.next()方法,并读取返回的{ value: char, done: boolean }对象。尽管现代引擎会做“逃逸分析”(Escape Analysis)尽量避免堆内存分配,但状态判断与属性解包仍然存在物理消耗。 - 更关键的是,字符串迭代器每遇到一个 UTF-16 单元,都会探测其是否为高半区代理(High Surrogate),若是则读取下一个低半区代理拼接成完整字符。这部分额外的逻辑判断构成了稳定的 CPU 开销。
3. forEach:高昂的函数调用与上下文切换
无论是借用 Array.prototype.forEach.call 还是先转数组,其性能瓶颈都在于函数调用开销(Function Call Overhead):
- 如果字符串包含 1,000,000 个字符,
forEach就必须在执行栈上连续进行 1,000,000 次函数的调用(Call)、参数压栈(Push Args)、执行及栈帧弹出(Pop Stack Frame)。 - 即便 V8 优化能力极强,但通常无法将具有复杂外部引用的回调函数完全内联(Inline)至单条主循环中。
- 若使用
[...str].forEach,更会先分配一个包含 100 万个元素的大数组,引发巨大的内存申请和垃圾回收(GC)压力。
四、关键分水岭:Unicode 代理对与字符安全性
性能固然重要,但代码的正确性永远高于性能。如果字符串中含有 Emoji 表情、汉字冷僻字(如“𠮷”)或数学符号,不同遍历方式的行为将出现截然不同的结果。
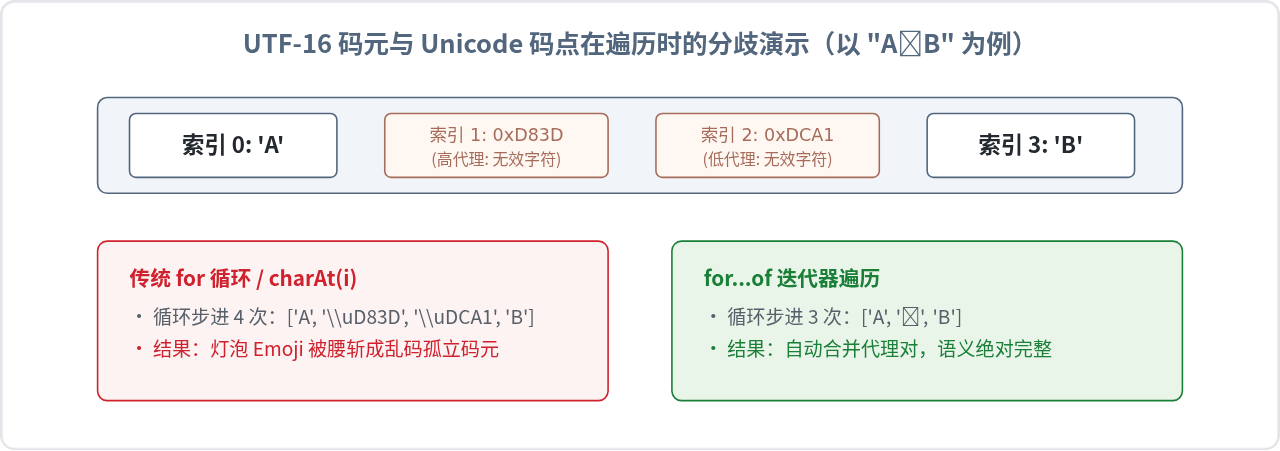
现象验证代码
const text = "A💡B";

console.log(`文本长度 text.length: ${text.length}`); // 输出 4,而非 3

// 方式一:传统 for 循环
console.log("--- 传统 for 循环 ---");
for (let i = 0; i < text.length; i++) {
  console.log(`索引 ${i}:`, text[i], "编码:", text.charCodeAt(i).toString(16));
}
// 输出中灯泡被切分为两个无意义的半区字符:0xd83d 和 0xdca1

// 方式二:for...of 循环
console.log("--- for...of 循环 ---");
for (const char of text) {
  console.log("完整字符:", char, "码点:", char.codePointAt(0).toString(16));
}
// 正确输出完整的 'A', '💡' (0x1f4a1), 'B'
这意味着:如果你的业务场景涉及用户输入的昵称、文章内容、国际化多语言文本或 Emoji,直接使用传统 for (let i = 0; ...) 切分字符可能导致严重的业务乱码或截断缺陷。
五、工程最佳实践与选型指南
综合性能基准与字符编码规则,在实际项目开发中,建议遵循以下决策路径:
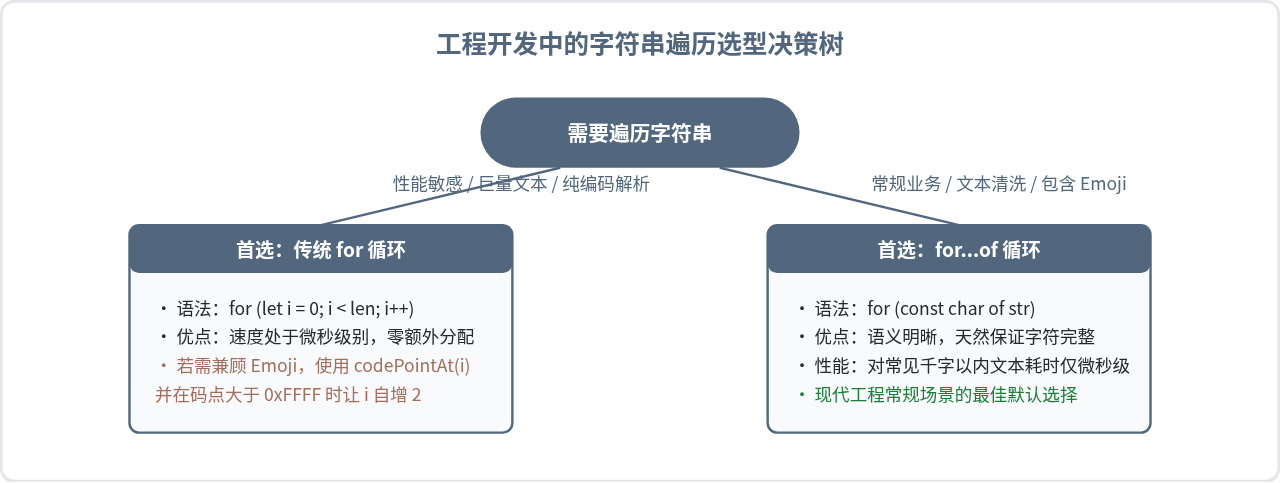
总结与建议速查清单
- 速度首选:传统
for (let i = 0; i < len; i++)循环以数倍优势夺冠,适合编译器前端词法分析(Lexer)、高性能序列化器、日志高频扫描等核心运算路径。 - 通用首选:
for...of具备现代 ES 规范的标准语义,天然规避了 Unicode 代理对断裂问题。在日常前端组件渲染、表单校验、多语言处理中,其耗时完全在可接受范围内,是安全性最高、代码最清晰的首选方案。 - 尽量避免:不要通过
Array.prototype.forEach.call或[...str].forEach来遍历大型字符串。频繁的闭包调用与临时数组构建会造成严重的性能衰减与内存抖动。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章