
深入解析在 JavaScript 中通过递归遍历处理复杂嵌套对象的底层机制,提供包含 WeakMap 循环引用防御的健壮深拷贝实现,以及支持去除空值、格式转换和自底向上剪枝的数据清洗工程实践。

当前位置:首页 > JavaScript 对象与原型 > 正文
JS递归遍历嵌套对象:实现深拷贝与数据清洗
作者:青柠
时间:2026-11-21
浏览:140
文章目录
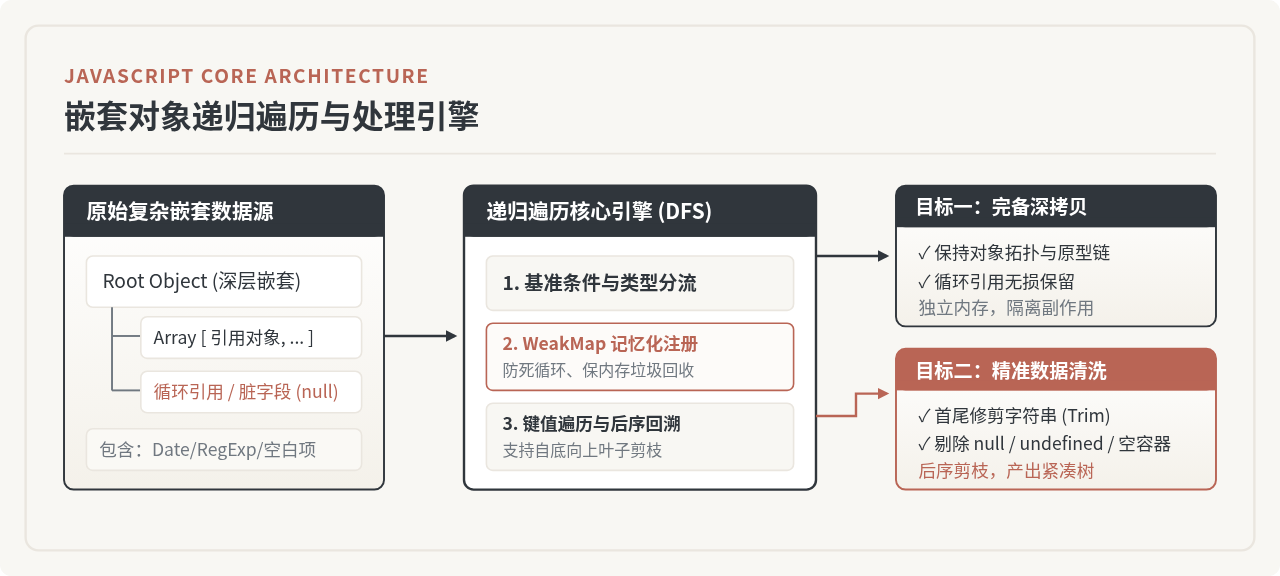
在 JavaScript 开发中,接口响应、表单模型和配置文件通常以任意深度的多层嵌套对象形式存在。单层循环无法穿透未知深度的层级,而直接赋值又会因引用传递导致对象间相互污染。解决这类问题的通用底层技术是深度优先递归遍历:通过基准条件终止叶子节点、通过 WeakMap 解决环引用,以此构建高保真的深拷贝函数;同时利用自底向上的后序遍历特征,在回溯过程中剔除多余脏键并剪除空容器,完成无副作用的数据清洗。
一、为什么单层遍历无法胜任多层嵌套结构
JavaScript 提供了 Object.keys()、Object.entries() 以及 for...in 等多种对象遍历语法,但它们均属于浅层遍历,只能读取对象的第一层键值。当对象的属性值依然是一个对象、数组或自定义实例时,浅层操作获取到的只是该嵌套内存地址的指针。
如果对嵌套结构直接进行浅拷贝(例如 Object.assign() 或对象展开运算符 { ...obj }),内层对象依然与原始数据共享同一个引用。一旦修改克隆体内部的某个属性,原始对象也会被连带篡改。而在处理后端返回的脏数据时,深层嵌套中的 null、多余首尾空格、无意义空数组 [] 或空对象 {},同样无法通过顶层的一次 filter 或键遍历剔除干净。
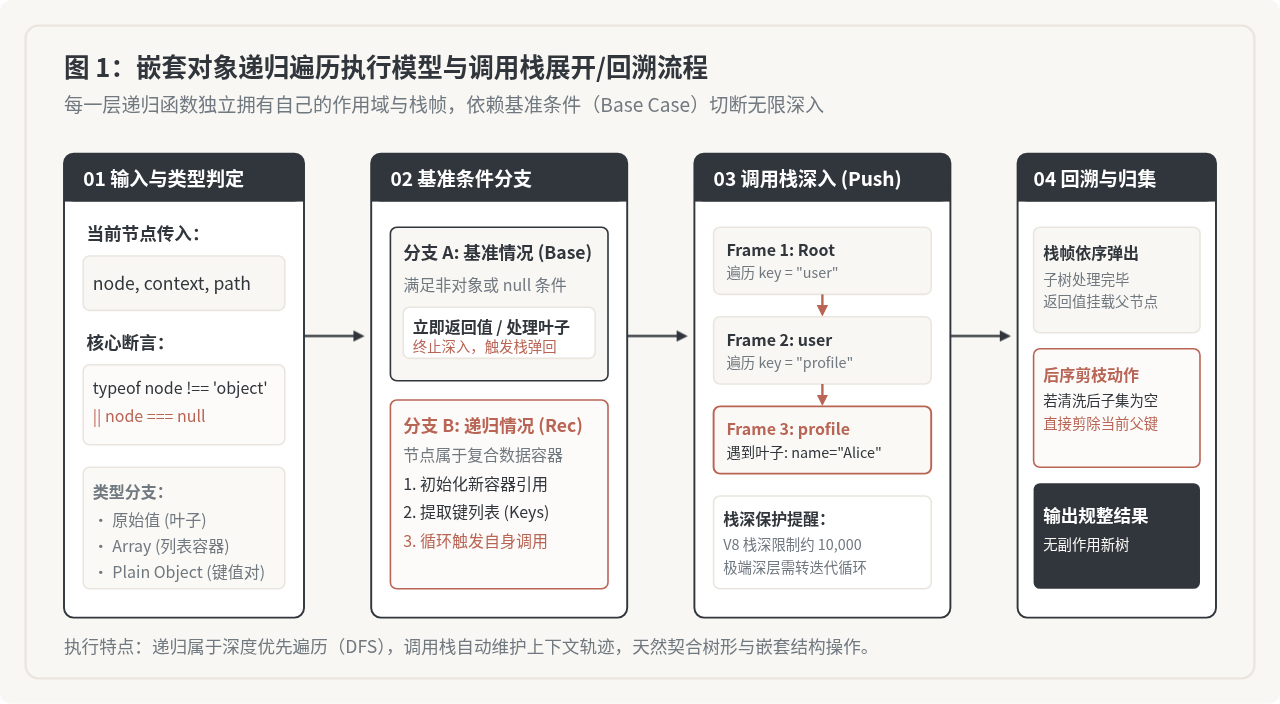
面对层级不确定的树状数据结构,递归(Recursion)是实现完全遍历的自然解法。递归遍历的实质是深度优先搜索(DFS):对于当前节点,首先判定其是否为复合容器(普通对象或数组)。若不是,则作为叶子节点直接处理并返回;若是,则遍历其所有子属性,并将每个子属性再次传入遍历函数自身,直到全部节点触碰到底部基准条件后逐层回溯。
二、递归遍历的核心机制与边界断言
编写一个安全、可维护的递归遍历器,关键在于明确划分“基准终止情况(Base Case)”与“递归推进情况(Recursive Case)”。缺少精准的基准判断,会导致函数无限递归最终抛出 RangeError: Maximum call stack size exceeded。
1. 正确识别容器与基本类型
在 JavaScript 中,判断一个值是否需要继续递归展开存在一个历史悠久的陷阱:typeof null === 'object' 为真。如果代码中仅通过 typeof val === 'object' 进行判断,传入 null 时会将其误判为容器,从而在执行 Object.keys(null) 时直接抛出运行时错误。
因此,准确的非容器判定条件必须显式排除 null:
function isObject(val) {
  return val !== null && (typeof val === 'object' || typeof val === 'function');
}
此外,数组与普通对象在遍历方式上存在差异。数组具有数字索引与连续性语义,克隆或清洗时应保持其实例类型为 Array,而普通字面量对象则初始化为 {}。在 ES6 环境下,使用 Array.isArray(val) 能够穿透跨 iframe 环境准确断言数组。
2. 先序遍历与后序遍历的选择
遍历阶段的执行顺序直接决定了业务操作能否生效:
- 先序遍历(Pre-order):先访问并处理当前节点本身,再递归进入子节点。这适合于深拷贝场景,因为必须先为当前层级开辟新对象的内存空间并注册引用指针,子属性的克隆结果才能挂载进来。
- 后序遍历(Post-order):先深入到树的最底层叶子节点,在递归函数逐层弹栈回溯的过程中再对父节点进行判定。这适合于数据清洗与空节点剪枝场景。只有子节点全部清洗完毕后,我们才能确认当前对象内部是否已被清空;若已被清空,当前父容器本身才可作为无用节点一并剔除。
三、场景实战一:实现健壮的深拷贝(Deep Clone)
虽然开发者常常使用 JSON.parse(JSON.stringify(obj)) 实现快速深拷贝,但该方式存在致命限制:它会自动丢失函数、undefined 和 Symbol 键;遇到 Date 对象会强制转为 ISO 字符串;遇到正则表达式会转为空对象 {};尤其是当对象存在自引用或相互循环引用时,会直接抛出 TypeError: Converting circular structure to JSON 导致应用崩溃。
虽然现代浏览器与 Node.js 17+ 提供了原生 structuredClone(),但它在遇到函数或特定类方法时依然会抛出 DataCloneError,且无法在克隆过程中动态修改或注入属性。自主实现一套基于递归遍历的深拷贝,不仅能应对特殊类型,更能与业务深度整合。
1. 使用 WeakMap 破除循环引用
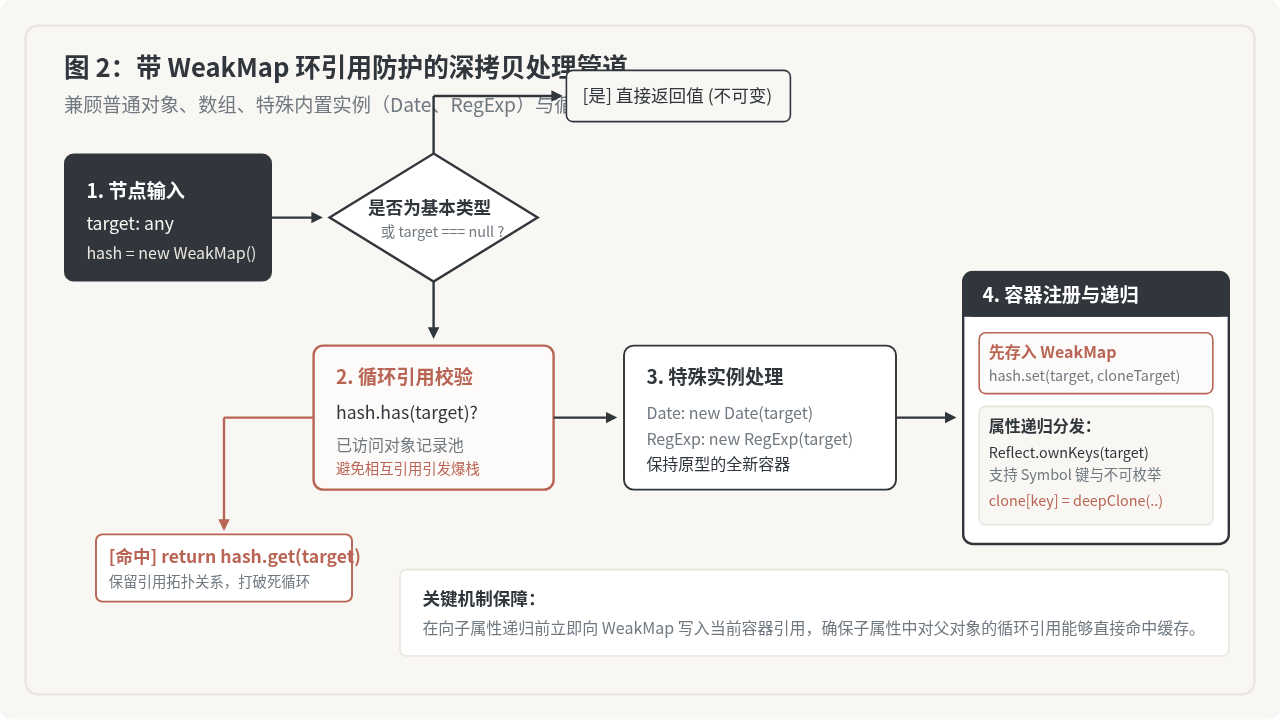
当对象 A 的属性指向对象 B,而对象 B 的属性又反向指向对象 A 时,若不加干预地递归,程序将陷入死循环直到调用栈打满溢出。解决方法是引入一个记录池:在每次进入递归克隆时,首先检查当前对象是否已经在记录池中。
如果已经存在,说明该对象之前已被克隆,直接从记录池中取出克隆后的副本引用返回,不再重复深入;如果不存在,则在初始化新对象容器后立即将 [原始对象, 克隆副本] 写入记录池中。这里必须使用 WeakMap 而非普通 Map,因为 WeakMap 对键所指向的源对象保持弱引用,克隆函数执行完毕后不会阻止垃圾回收机制正常释放内存,避免造成隐式内存泄露。
2. 支持特殊对象与 Symbol 键
除了普通字面量与数组外,日常数据中常见的还有 Date、RegExp、Map 与 Set。对于 Date,应当通过 new Date(target) 重建时间实例;对于 RegExp,通过 new RegExp(target.source, target.flags) 保持匹配模式与标志位。在遍历属性键时,推荐使用 Reflect.ownKeys(target) 代替传统的 Object.keys(),这样可以完整获取包含 Symbol 键以及不可枚举属性在内的全部自有属性。
3. 完备深拷贝代码实现
以下为具备类型分治、WeakMap 环引用阻断与 Symbol 支持的完整深拷贝代码:
function deepClone(target, hash = new WeakMap()) {
  // 1. 基准情况:基本数据类型及 null 直接返回
  if (target === null || typeof target !== 'object') {
    return target;
  }

  // 2. 特殊对象类型精准重建
  if (target instanceof Date) return new Date(target);
  if (target instanceof RegExp) return new RegExp(target.source, target.flags);
  if (target instanceof Map) {
    const copyMap = new Map();
    hash.set(target, copyMap);
    target.forEach((val, key) => {
      copyMap.set(deepClone(key, hash), deepClone(val, hash));
    });
    return copyMap;
  }
  if (target instanceof Set) {
    const copySet = new Set();
    hash.set(target, copySet);
    target.forEach(val => {
      copySet.add(deepClone(val, hash));
    });
    return copySet;
  }

  // 3. 循环引用检测:若已访问过,直接返回缓存的克隆引用
  if (hash.has(target)) {
    return hash.get(target);
  }

  // 4. 根据源类型初始化新容器,保持原型链一致
  const isArray = Array.isArray(target);
  const cloneTarget = isArray ? [] : Object.create(Object.getPrototypeOf(target));

  // 5. 立即缓存当前克隆容器,必须在深入子属性递归之前存入
  hash.set(target, cloneTarget);

  // 6. 获取包含 Symbol 在内的所有自身键名进行递归赋值
  const keys = Reflect.ownKeys(target);
  for (const key of keys) {
    cloneTarget[key] = deepClone(target[key], hash);
  }

  return cloneTarget;
}
4. 验证示例与输出
// 构造测试数据:包含嵌套、循环引用、Date、RegExp 和 Symbol
const sym = Symbol('uid');
const original = {
  id: 101,
  name: "系统配置",
  createAt: new Date("2026-01-01T00:00:00Z"),
  pattern: /^[a-z]+$/gi,
  tags: ["config", "core"],
  subTree: {
    level: 2,
    details: { active: true }
  },
  [sym]: "sym_value"
};

// 制造循环引用
original.self = original;
original.subTree.parent = original;

// 执行克隆
const cloned = deepClone(original);

// 验证独立性与环引用保留
console.log(cloned !== original); // 输出: true
console.log(cloned.subTree !== original.subTree); // 输出: true
console.log(cloned.createAt instanceof Date); // 输出: true
console.log(cloned.self === cloned); // 输出: true (环结构在副本内部闭合)
console.log(cloned[sym]); // 输出: "sym_value"
四、场景实战二:多层级数据清洗(Data Cleaning)
在前端向后端提交表单,或消费第三方接口返回的复杂 JSON 时,数据中常常夹杂大量噪声:用户误输入的字符串前后空格、未填写的 null 或 undefined、接口未匹配到的空数组 [],以及当所有字段被过滤后遗留的空对象 {}。如果直接把带有这些噪音的数据入库或参与计算,容易引发异常或增加不必要的数据体积。
1. 自底向上剪枝的必要性
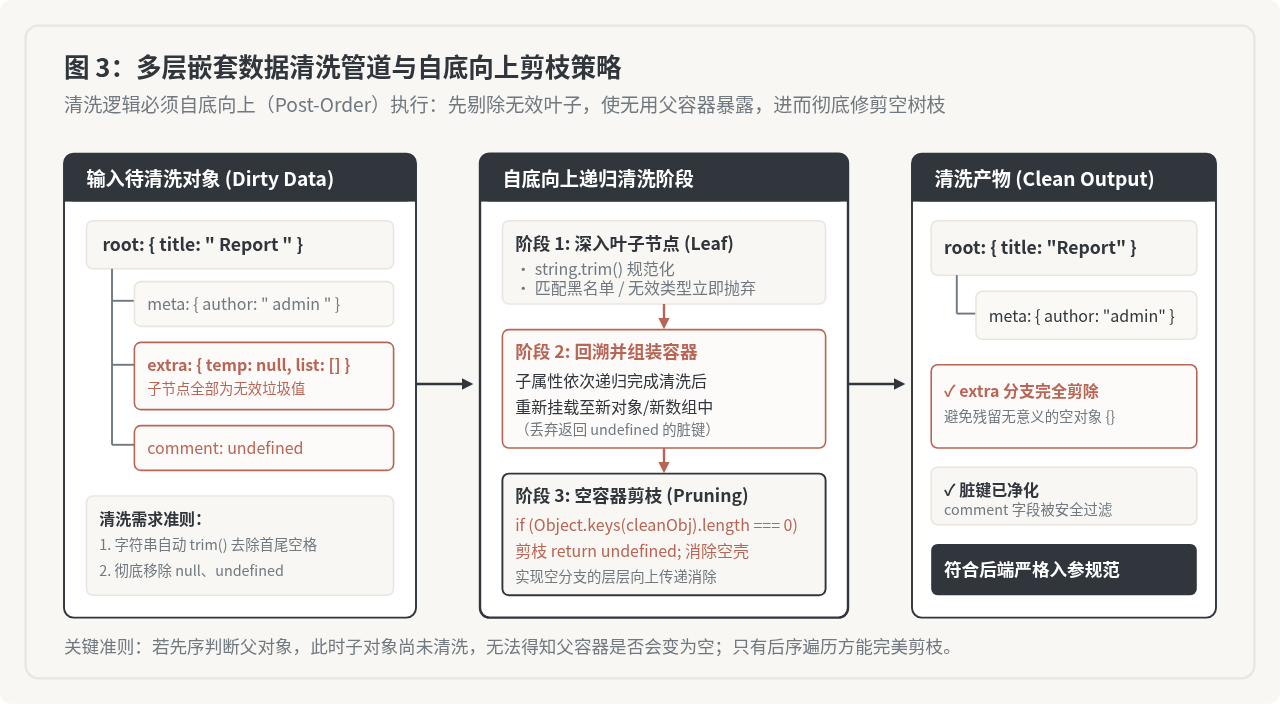
很多开发者初次实现数据清洗时,习惯先检查顶层对象。这种先序思路在遇到多层嵌套时会失效。例如对象 { user: { profile: { address: null } } }:
- 如果采用先序检查,
user内部有profile,它不是空对象;profile内部有address,它也不是空对象。 - 当递归到
address时将其剔除后,profile变成了{},而此时外部遍历早已跳过了profile和user的检查,最终仍会残留一个无意义的{ user: { profile: {} } }空壳结构。
正确的做法是后序处理(Post-order Pruning):先让子节点完成清洗。当子节点返回给父节点时,父节点再检查自己的属性集合。如果经过子节点过滤后,父节点的所有键均已被清空,则父节点自身也向上层返回 undefined,从而触发祖先节点一并将其剪除。
2. 通用数据清洗器代码实现
以下数据清洗器支持四项核心能力:自动 trim 修剪字符串、过滤 null 与 undefined、移除无意义空容器、根据键黑名单过滤敏感或废弃字段:
function cleanData(data, options = {}) {
  const {
    trimStrings = true,
    removeEmptyContainers = true,
    removeNullish = true,
    blacklistKeys = []
  } = options;

  // 1. 基准条件:非对象类型直接处理
  if (data === null || typeof data !== 'object') {
    if (removeNullish && (data === null || data === undefined)) {
      return undefined;
    }
    if (trimStrings && typeof data === 'string') {
      return data.trim();
    }
    return data;
  }

  // 2. 特殊对象保持原样(如 Date、RegExp 等不作为键值容器展开)
  if (data instanceof Date || data instanceof RegExp) {
    return data;
  }

  // 3. 数组类型处理:清洗每一项并剔除空结果
  if (Array.isArray(data)) {
    const cleanedArray = [];
    for (const item of data) {
      const cleanedItem = cleanData(item, options);
      // 若清洗后不为 undefined,则收录入数组
      if (cleanedItem !== undefined) {
        cleanedArray.push(cleanedItem);
      }
    }
    // 若开启空容器剪枝且数组为空,则向上返回 undefined
    if (removeEmptyContainers && cleanedArray.length === 0) {
      return undefined;
    }
    return cleanedArray;
  }

  // 4. 普通对象处理:自底向上后序遍历属性
  const cleanedObject = {};
  let validKeysCount = 0;

  for (const key of Object.keys(data)) {
    // 命中黑名单的键直接丢弃
    if (blacklistKeys.includes(key)) {
      continue;
    }

    const cleanedVal = cleanData(data[key], options);

    // 只有当清洗出的子属性不是 undefined 时,才记录入结果对象
    if (cleanedVal !== undefined) {
      cleanedObject[key] = cleanedVal;
      validKeysCount++;
    }
  }

  // 5. 后序剪枝:若当前对象已被清空且开启了空容器剪除,向上反馈 undefined
  if (removeEmptyContainers && validKeysCount === 0) {
    return undefined;
  }

  return cleanedObject;
}
3. 数据清洗效果对比示例
const dirtyPayload = {
  title: "  文章标题  ",
  author: "  张三 ",
  internal_id: "ignore_secret_999", // 黑名单字段
  description: null,
  emptyNotes: "",
  metadata: {
    source: undefined,
    history: [], // 空数组
    debugInfo: {
      traceId: null // 子属性被删后,debugInfo 变为空对象
    }
  },
  comments: [
    { id: 1, text: " 赞 " },
    { id: 2, text: null } // 清洗后 text 移除,保留 id
  ]
};

const result = cleanData(dirtyPayload, {
  trimStrings: true,
  removeEmptyContainers: true,
  removeNullish: true,
  blacklistKeys: ["internal_id"]
});

console.log(JSON.stringify(result, null, 2));
执行清洗后的输出结果结构规整,多余的层级与脏键均被自动消除:
{
  "title": "文章标题",
  "author": "张三",
  "emptyNotes": "",
  "comments": [
    {
      "id": 1,
      "text": "赞"
    },
    {
      "id": 2
    }
  ]
}可以看到,description 与 source 等 null/undefined 属性被直接清除;internal_id 被黑名单拦截;metadata.debugInfo 因其子属性 traceId 被剔除而变为空对象,触发了后序剪枝;随后 metadata 容器也因没有任何有效字段而被整体剪除,未留下任何残缺的空壳结构。
五、边界陷阱与工程防护
在生产环境中运行递归程序,除了业务逻辑本身外,还需要特别关注以下三个系统级边界问题:
重要边界防护准则
1. 防范对象原型污染(Prototype Pollution):当递归清洗直接接收来自未受信任的外部输入时,恶意用户可能构造包含 __proto__ 或 constructor.prototype 的 JSON 数据。如果在遍历过程中进行不安全的属性赋值,可能会篡改全局 Object.prototype。因此,在遍历赋值前应当显式过滤 key === '__proto__' || key === 'constructor',或使用 Object.create(null) 隔绝原型链。
2. 规避调用栈溢出(Stack Overflow):JavaScript 引擎给每个执行线程分配的调用栈空间是有限的(V8 中单次深度通常在 10,000 层左右)。普通业务数据很少达到此深度,但如果是长链表、复杂图结构或极端恶意的构造输入,深层递归会导致线程崩溃。对于可能存在超深层级的数据,应将递归转换为显式栈结构(利用 while 循环结合数组模拟堆栈操作)。
3. 保持不可枚举与原型属性边界:深拷贝时使用 Reflect.ownKeys() 能够读取自身属性,但若对象继承了原型方法,直接通过 Object.create(Object.getPrototypeOf(target)) 能够保留原型指向,而不会粗暴地将原型方法复制为对象自身的属性,兼顾了内存效率与面向对象多态语义。
六、方案对照与选型决策
针对对象深拷贝与数据清洗,工程中存在多种技术路径。下表归纳了不同方案的核心差异:
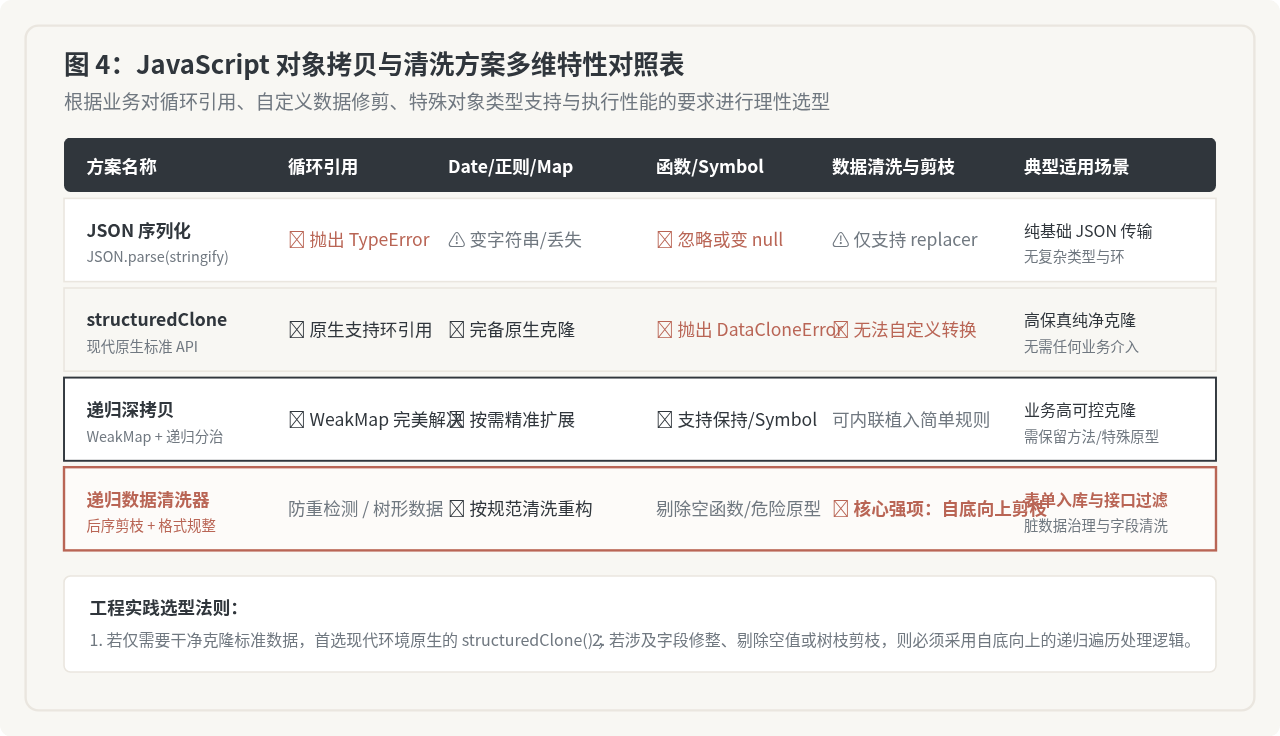
| 方案类型 | 循环引用支持 | 特殊类型 (Date/RegExp) | 函数与 Symbol | 数据剪枝与转换 | 推荐使用场景 |
|---|---|---|---|---|---|
| JSON 序列化 | 否(抛出 TypeError) | 否(转为字符串或丢失) | 否(被忽略或转为 null) | 仅能通过 replacer 简单过滤 | 快速克隆纯数据传输对象(DTO),无复杂类型与环 |
| structuredClone() | 是(原生内存级支持) | 是(完备内置支持) | 否(遇到函数抛出异常) | 否(黑盒拷贝,不支持业务干预) | 现代标准环境下的纯净数据深克隆,无需修改字段 |
| 递归深拷贝 | 是(通过 WeakMap 解决) | 是(可按需灵活扩展) | 是(支持保留函数与 Symbol) | 可内联基础转换规则 | 复杂业务对象、需要维护特定原型或保留方法的场景 |
| 递归数据清洗器 | 可控支持 | 按业务规范处理 | 安全过滤 / 剔除 | 是(自底向上剪除空节点) | 前端表单提交前净化、接口脏数据修剪、存储入库治理 |
在架构设计上,深拷贝与数据清洗本质上是一体两面:深拷贝的核心任务是无损保真,在隔离内存引用的同时尽可能复刻原始对象的全部特征与拓扑关系;而数据清洗的核心任务是有损提纯,在穿透层级的过程中遵循明确的业务规则,丢弃冗余脏键并剪除空树枝。理解递归调用的栈展开与回溯生命周期,是掌握 JavaScript 复杂数据结构操作的基本功。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章