

深入讲解JavaScript解析XML时遇到Invalid XML与编码乱码的根因剖析与完整解决方案,覆盖TextDecoder字符集转码、BOM清洗、特殊实体转义及DOMParser parsererror错误捕获实战。
JS解析XML报错Invalid XML或编码乱码怎么办
作者:百宝袋
时间:2026-11-21
浏览:606
文章目录
在 JavaScript 环境中解析 XML 时,遇到 Invalid XML(语法无效)或中文显示为乱码(如黑菱形问号 ��),核心排查路径主要由两步构成:首先,检查网络请求的二进制流解码机制,切勿使用默认的 response.text() 强制按 UTF-8 读取非 UTF-8(如 GBK/GB2312)数据,必须改用 response.arrayBuffer() 配合标准 TextDecoder 完成无损字符还原;其次,清洗 XML 字符串中隐藏的 UTF-8 BOM 标头()与未转义保留字符(如裸 &),并利用浏览器 DOMParser 特有的 parsererror 节点检测机制代替传统的 try...catch 进行精准异常捕获。
一、为什么会出现乱码与 Invalid XML 报错?
XML(可扩展标记语言)与宽松容错的 HTML 不同,它遵循极度严格的 W3C 词法解析规范。任何微小的字符偏离、非法转义或编码偏差,都会导致解析器立即终止处理并判定为语法非法。而在日常开发中,字符编码乱码与 Invalid XML 往往是互为因果的连带问题:
-
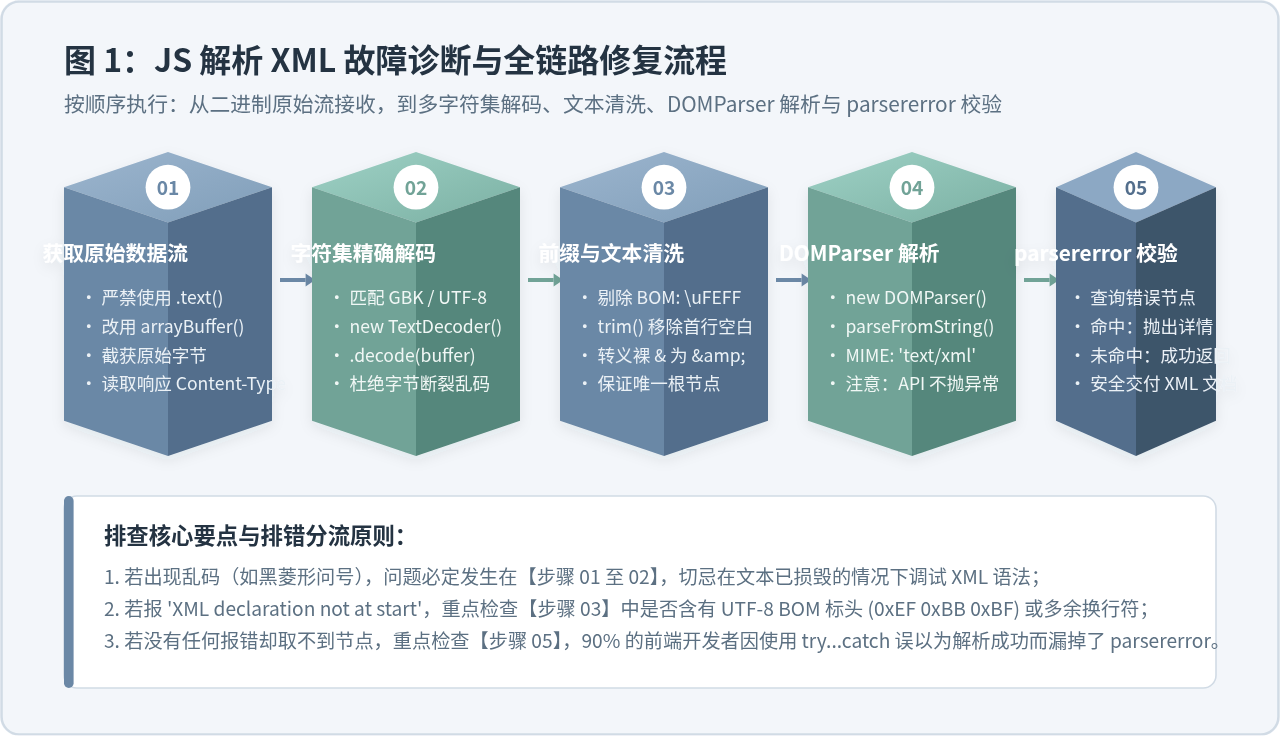
多字节编码被截断破坏: GBK/GB2312 编码下的汉字占 2 个字节,而 UTF-8 编码下的汉字占 3 个字节。若服务端吐出 GBK 字节流,而前端使用默认 UTF-8 解码,无法识别的字节会被替换为 Unicode 替代符
�(即页面上看到的黑色菱形问号�)。如果这类断裂字节出现在标签边界、属性引号或闭合标签中,XML 的语法结构便瞬间瓦解,解析器进而抛出Invalid XML或XML Parsing Error: syntax error。 -
静默失败与捕获陷阱: 在浏览器端调用
new DOMParser().parseFromString(xmlStr, 'text/xml')时,W3C 标准规范并没有规定解析失败时抛出 JavaScript 异常。解析器会默默返回一个包含了<parsererror>节点的特殊 XML 树。很多开发者习惯性编写try { ... } catch (err) { ... },导致错误被完全漏掉,后续在读取节点属性时报出TypeError: Cannot read properties of undefined。
二、彻底解决编码乱码:从二进制流到正确字符集
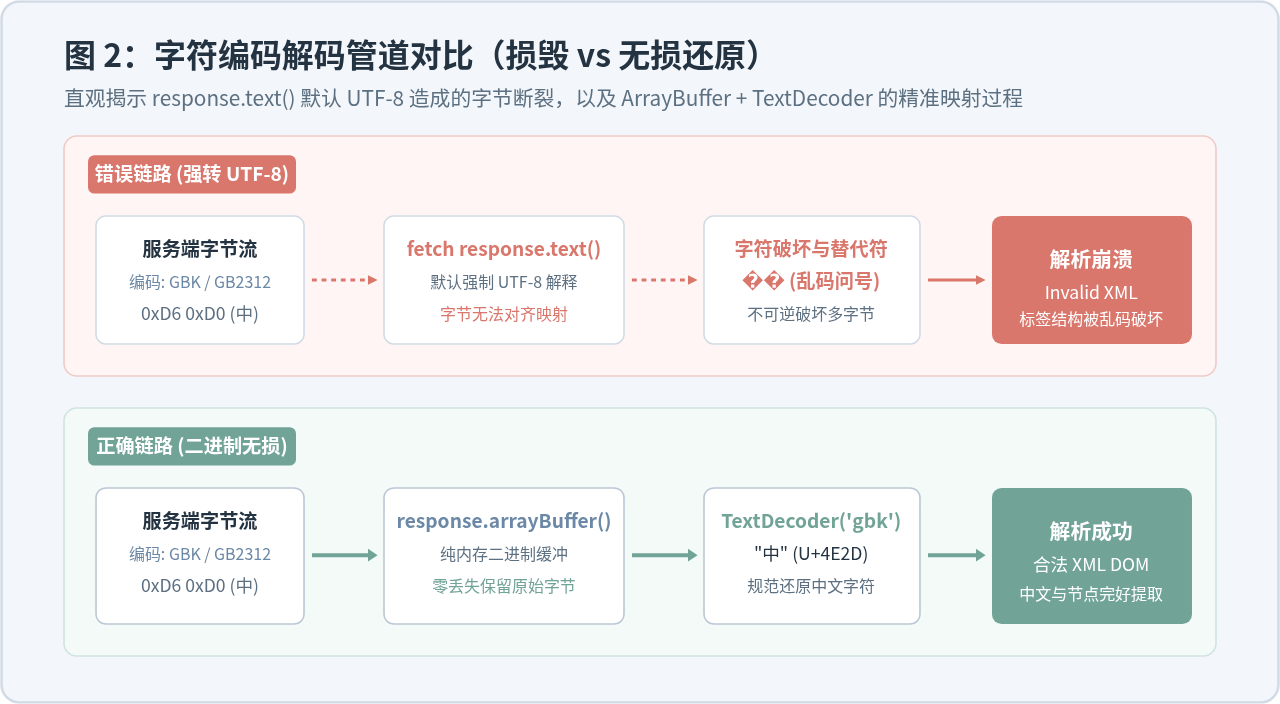
解决乱码的前提是阻止传输层发生不可逆的破坏性解码。现代浏览器中 fetch() API 的 response.text() 方法在未指定 charset 时,默认无条件使用 UTF-8 解码字节流。一旦字节被强制以 UTF-8 解释并生成 � 字符串,原始二进制信息便已永久丢失,后续再试图通过编码转换函数抢救都是徒劳的。
1. 浏览器环境:Fetch + ArrayBuffer + TextDecoder 标准方案
现代浏览器提供了原生支持各地区码表的 TextDecoder API。正确的做法是获取原始的 ArrayBuffer 二进制缓冲,并根据服务端实际编码(通常是 gbk、gb2312 或 gb18030)进行解码:
/**
 * 健壮的 XML 获取与解码函数 (兼容 GBK 与 UTF-8)
 * @param {string} url 请求地址
 * @param {string} fallbackEncoding 默认兜底编码,如 'gbk'
 */
async function fetchAndDecodeXML(url, fallbackEncoding = 'gbk') {
  const response = await fetch(url);
  if (!response.ok) {
    throw new Error(`HTTP 请求失败,状态码: ${response.status}`);
  }

  // 1. 获取纯净的底层二进制缓冲,防止被默认 UTF-8 污染
  const arrayBuffer = await response.arrayBuffer();

  // 2. 尝试从响应头提取字符集
  let charset = fallbackEncoding;
  const contentType = response.headers.get('content-type');
  if (contentType) {
    const match = contentType.match(/charset=([^;]+)/i);
    if (match) {
      charset = match[1].trim().toLowerCase();
    }
  }

  // 3. 使用标准 TextDecoder 执行解码
  // fatal: false 允许在非致命异常字符时容错
  const decoder = new TextDecoder(charset);
  const xmlString = decoder.decode(arrayBuffer);

  return xmlString;
}
提示:在
TextDecoder 中,传入 'gbk'、'gb2312' 或 'gb18030' 均能识别大部分中文字符集,推荐统一传入 'gbk' 或其超集 'gb18030',以获得最全面的冷僻字支持。
2. 传统 XMLHttpRequest 方案
对于使用 XMLHttpRequest 的遗留老项目,可以通过 overrideMimeType 在发送前重写响应编码,或者直接将 responseType 设为 'arraybuffer':
function loadXmlWithXHR(url, callback) {
  const xhr = new XMLHttpRequest();
  xhr.open('GET', url, true);
  // 方式 A:直接重写响应字符集为 GBK
  xhr.overrideMimeType('text/xml; charset=gbk');

  xhr.onload = function() {
    if (xhr.status === 200) {
      // 此时 responseText 已按 GBK 正确还原
      callback(null, xhr.responseText);
    } else {
      callback(new Error(`请求失败: ${xhr.status}`));
    }
  };
  xhr.onerror = () => callback(new Error('网络请求异常'));
  xhr.send();
}
3. Node.js 服务端环境下的 Buffer 解码
在 Node.js 中,fetch 或 axios 可以直接获取 ArrayBuffer 或 Buffer。如果项目中缺少特定编码支持,可以使用内置的 util.TextDecoder 或成熟的 iconv-lite 库:
// Node.js 原生方案 (Node.js 11+ 已内置全球字符集 TextDecoder)
const { TextDecoder } = require('util');

function decodeNodeBuffer(buffer, charset = 'gbk') {
  const decoder = new TextDecoder(charset);
  return decoder.decode(buffer);
}

// 或者使用 iconv-lite (适合极端老旧环境或特定非标编码)
// const iconv = require('iconv-lite');
// const xmlString = iconv.decode(Buffer.from(rawBuffer), 'gbk');
三、排查与修复四大经典 Invalid XML 语法隐患
当编码乱码问题被消除后,若解析器依然提示 Invalid XML,说明文本内容违反了 XML 语法的铁律。以下是开发中最容易踩坑的四种具体原因及针对性修复策略:
1. UTF-8 BOM 标头与前置空白导致报错
很多由 Windows 记事本或其他编辑器创建的 XML 文件,其头部常带有 3 个字节的 UTF-8 签名(即 BOM:0xEF 0xBB 0xBF,在 JS 字符串中表现为 )。此外,很多后端模板拼接 XML 时会在首行前留下空行或制表符。
典型报错表现:
XML declaration not at beginning of external entity 或 syntax error: line 1, column 2。XML 规范严格要求:如果存在 <?xml ...?> 声明,它必须是整个文档的绝对第一字符,前面不能有任何不可见字符、空格或换行。
解决办法:在送入解析器前,通过简单正则强行剥离 BOM 与首尾空白:
// 清洗 BOM 字符与前置/后置空白
function cleanXmlPreamble(xmlStr) {
  return xmlStr
    .replace(/^/, '') // 移除 UTF-8 BOM
    .trim();                // 去除可能存在的前后换行与空格
}
2. 正文中存在未转义的特殊字符(如裸 & 与 <)
XML 仅原生定义了 5 个预保留的实体引用:
| 保留字符 | 标准实体引用 | 常见出错场景 |
|---|---|---|
& |
& |
文本中包含 URL 参数(如 url?id=1&type=2) |
< |
< |
数学比较式或正文混入了 HTML 标签(如 price < 100) |
> |
> |
大于符号或箭头表达式 |
" |
" |
XML 属性值内部未转义的双引号 |
' |
' |
XML 属性值内部未转义的单引号 |
其中最常导致 Invalid XML 崩溃的是 “裸” &。解析器遇到 & 时会尝试寻找结尾的分号 ;。如果找不到,就会报 xmlParseEntityRef: no name 错误。
容错修复方案:最佳做法是由输出端生成标准 XML。若前端必须清洗外部不可控脏数据,可使用负向先行断言将未转义的 & 补齐为 &,或者对大段富文本使用 <![CDATA[ ... ]]> 进行保护:
// 将未正确编码的裸 & 替换为 &(不重复替换合规实体)
function sanitizeAmpersands(xmlStr) {
  return xmlStr.replace(/&(?!amp;|lt;|gt;|quot;|apos;|#[0-9]+;|#x[0-9a-fA-F]+;)/g, '&');
}
3. 缺少唯一根节点或存在多个同级根节点
XML 规范要求有且仅有一个根元素。如果接口返回的是多段片段数据的拼接(如连续输出 <item>1</item><item>2</item>),直接解析会报 Extra content at end of document。
// 若 XML 片段缺少统摄根节点,在外部包裹一层虚拟根
function ensureSingleRoot(xmlFragment) {
  const trimmed = xmlFragment.trim();
  // 若未包含标准 xml 头,且存在多个平级标签,包裹 <root>
  if (!trimmed.startsWith('<?xml') && !trimmed.match(/^<([a-zA-Z0-9_\-]+)>[\s\S]*<\/>$/)) {
    return `<root>${trimmed}</root>`;
  }
  return trimmed;
}
4. 标签未闭合或大小写不匹配
HTML 允许 <br> 或 <img src="..."> 自闭合缺省,且标签名不区分大小写;但 XML 对此零容忍。<title>内容</Title> 会直接触发标签不匹配错误;每一个标签都必须严格以 /> 或成对标签闭合。
四、浏览器 DOMParser 异常捕获机制与 parsererror 提取
很多前端开发者最困惑的问题是:“为什么我明明在 DOMParser 外面写了 try...catch,报错却依然没有被抓到?”
原因在于 W3C DOMParser 规范规定:当 XML 解析失败时,解析器不会向外 throw 任何 JavaScript 异常,而是构造并返回一个结构特殊的 XML Document 对象。在这个对象中,包含了由浏览器引擎自动生成的 <parsererror> 元素。
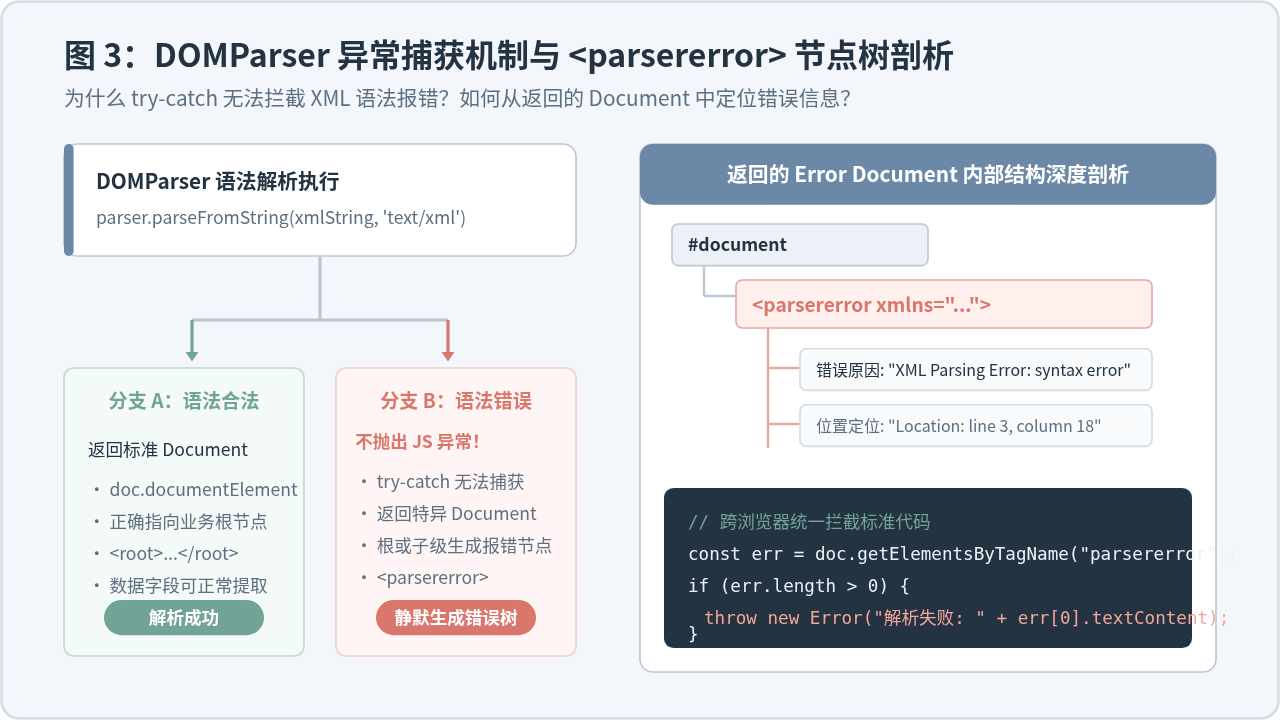
不同浏览器(Chrome、Firefox、Safari)生成的 <parsererror> 节点的命名空间和子节点树略有差异,但都统一实现了 getElementsByTagName("parsererror")。因此,我们必须手动进行校验:
/**
 * 工业级安全 XML 字符串解析器
 * @param {string} xmlString XML 源码
 * @returns {Document} 合法的 XML Document 对象
 * @throws {Error} 包含精准行号与报错描述的异常
 */
function safeParseXML(xmlString) {
  // 1. 基础预处理
  const cleanXml = xmlString.replace(/^/, '').trim();

  // 2. 实例化解析器
  const parser = new DOMParser();
  const xmlDoc = parser.parseFromString(cleanXml, 'text/xml');

  // 3. 严格检测 parsererror 节点 (兼容 Firefox / Chrome / Safari)
  const parseErrors = xmlDoc.getElementsByTagName('parsererror');
  if (parseErrors.length > 0) {
    // 提取错误详细信息文本
    const rawErrorMsg = parseErrors[0].textContent || '未知 XML 语法错误';

    // 整理出清晰的错误提示
    const cleanMsg = rawErrorMsg
      .replace(/\s+/g, ' ')
      .trim();

    throw new Error(`XML 语法解析失败 (Invalid XML): ${cleanMsg}`);
  }

  // 4. 返回合格的 DOM 树
  return xmlDoc;
}
五、端到端完整实战:从网络请求到安全解析
将上述字符集还原、标头清洗、特殊字符容错及 parsererror 拦截整合为一个开箱即用的通用模块:
/**
 * 完整端到端解决方案:安全加载并解析任意编码的远程 XML
 */
async function loadAndParseRemoteXML(url, options = {}) {
  const { defaultCharset = 'gbk', sanitize = true } = options;

  try {
    // 第一步:拉取二进制流
    const response = await fetch(url);
    if (!response.ok) {
      throw new Error(`HTTP 异常: ${response.status} ${response.statusText}`);
    }
    const buffer = await response.arrayBuffer();

    // 第二步:字符集侦测与解码
    let charset = defaultCharset;
    const contentType = response.headers.get('content-type');
    if (contentType && contentType.includes('charset=')) {
      charset = contentType.split('charset=')[1].split(';')[0].trim();
    }

    const decoder = new TextDecoder(charset);
    let xmlText = decoder.decode(buffer);

    // 第三步:文本清洗 (BOM 剥离与实体修补)
    xmlText = xmlText.replace(/^/, '').trim();
    if (sanitize) {
      // 容错转义裸 &
      xmlText = xmlText.replace(/&(?!amp;|lt;|gt;|quot;|apos;|#[0-9]+;)/g, '&');
    }

    // 第四步:安全 DOMParser 语法解析
    const parser = new DOMParser();
    const doc = parser.parseFromString(xmlText, 'text/xml');

    // 第五步:parsererror 校验
    const errorNode = doc.getElementsByTagName('parsererror')[0];
    if (errorNode) {
      throw new Error(`[XML Parse Error] ${errorNode.textContent.trim()}`);
    }

    // 解析成功,返回合法的 Document 对象
    return doc;

  } catch (err) {
    console.error('XML 解析管线终止:', err.message);
    throw err;
  }
}

// 使用示例:
// (async () => {
//   try {
//     const doc = await loadAndParseRemoteXML('/api/legacy-gbk-data.xml');
//     const items = doc.querySelectorAll('item title');
//     items.forEach(node => console.log('文章标题:', node.textContent));
//   } catch (err) {
//     alert(`读取失败: ${err.message}`);
//   }
// })();
六、常见报错成因与解决方案决策矩阵
为了便于在面对具体报错信息时快速自查,以下矩阵总结了常见报错现象、根本原因及立竿见影的代码级对策:
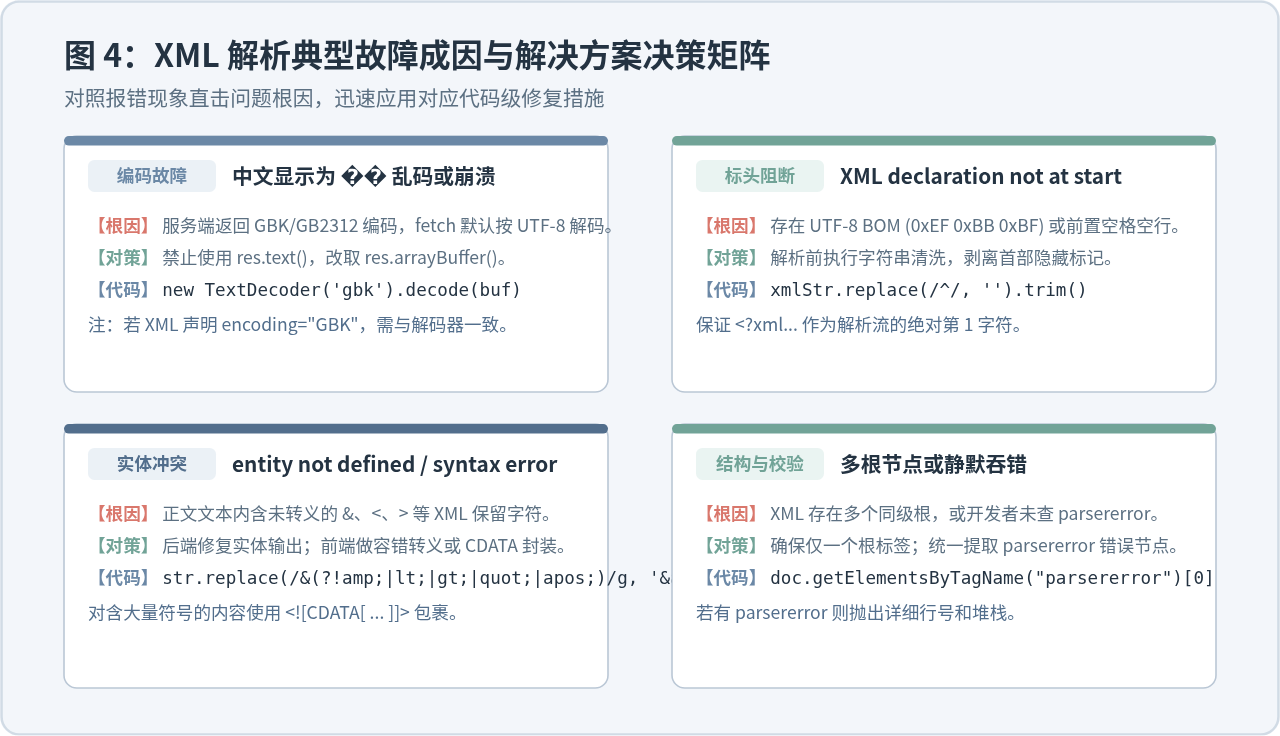
| 报错现象 / 提示 | 典型根因 | 快速验证与修复动作 |
|---|---|---|
中文显示为黑色菱形问号 � |
服务端为 GBK/GB2312 编码,前端用了默认 UTF-8 解码 | 改用 response.arrayBuffer(),并使用 new TextDecoder('gbk').decode() 转码。 |
XML declaration not at start of entity |
文件包含 UTF-8 BOM 头()或 <?xml 前有多余空格换行 |
在解析前执行 xmlStr.replace(/^/, '').trim()。 |
xmlParseEntityRef: no name 或 syntax error |
正文中出现了裸 &(如未经转义的链接参数) |
将未转义的 & 批量替换为 &,或用 <![CDATA[ ... ]]> 包裹该字段。 |
Extra content at end of document |
XML 存在多个平级根节点,或者截断未收尾 | 确保整个文档由单一外层 <root>...</root> 容器包裹。 |
try...catch 抓不到错误,后续取值报 undefined |
DOMParser 规范不抛出 JS 异常,而是静默生成 <parsererror> |
解析后主动调用 doc.getElementsByTagName("parsererror") 进行校验判断。 |
七、验证与收尾检查
在部署或上线相关修复逻辑前,建议按照以下清单完成最终确认:
- 网络抓包核验: 在开发者工具 Network 面板中,检查 XML 请求的
Content-Type是否携带字符集;对比 Raw Response(原始十六进制/二进制)与 Preview 标签页,确认服务端返回的原始字节是否完整。 - 多浏览器兼容性: 在 Chrome、Firefox、Safari 及移动端浏览器上分别运行解析逻辑,确认对
parsererror的检索均能正常生效。 - 极端异常边界覆盖: 传入空字符串
""、非法非 XML 文本(如返回了 HTML 404 页面)以及截断的 XML,确认代码均能平稳抛出具名异常,不引起前端应用白屏。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章