
详细讲解在 JavaScript 中将 URL 查询参数转换为 JSON 对象的各种实用方法,涵盖现代标准 API、重复键数组合并、类型推断转换及开发避坑指南。

当前位置:首页 > JavaScript 基础 > 正文
JS将URL查询参数转换为JSON对象的方法
作者:工具松鼠
时间:2026-11-20
浏览:568
文章目录
JavaScript 核心技法
Web API 实践
适用环境:现代浏览器、Node.js 12+、Deno / Bun
在 JavaScript 中将 URL 查询参数(Query String)解析为 JSON 对象,现代规范的最简直接方案是结合 URLSearchParams 与 Object.fromEntries()。但在生产业务中,该方案存在“同名重复参数会被静默覆盖”与“所有值均为纯字符串”的局限。本文将从原生单行基础写法展开,逐步解析同名键合并为数组、字段智能类型转换以及防御原型污染的完整健壮方案,帮助你在不同业务场景中准确完成参数解析。
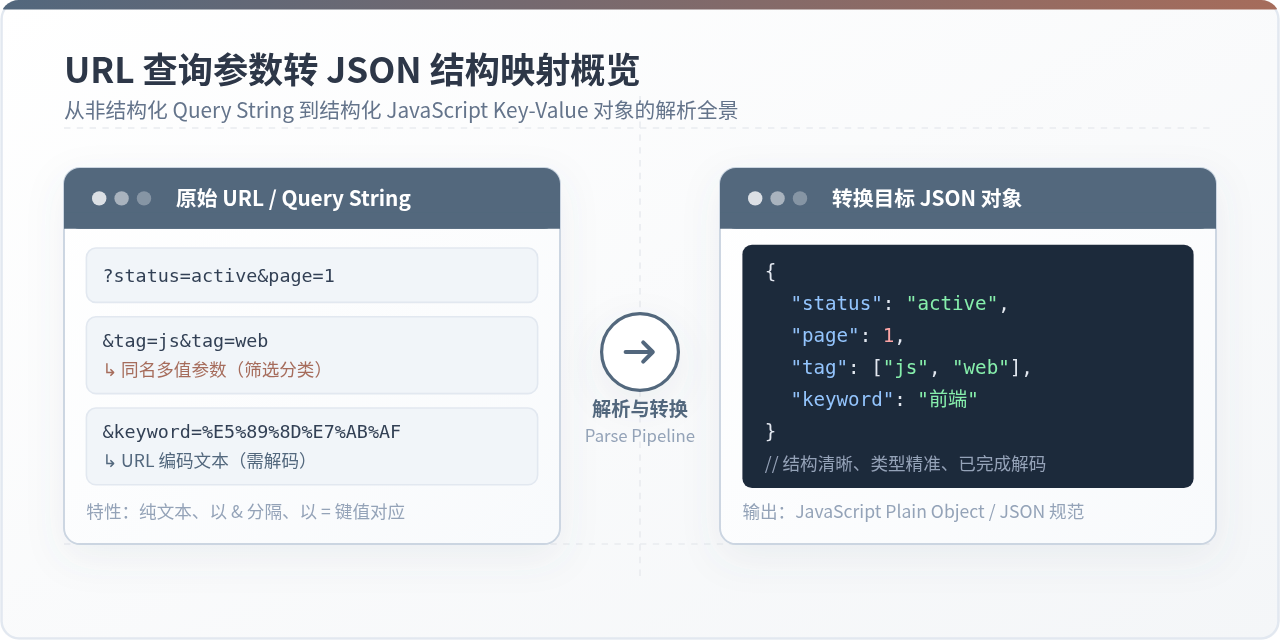
一、最简原生写法:URLSearchParams 与 Object.fromEntries
在现代 JavaScript 环境(Chrome 73+、Firefox 63+、Safari 12.1+ 以及 Node.js 12+)中,浏览器原生提供了两个核心 API,配合起来只需一行代码即可完成查询字符串的键值对解析:
- URLSearchParams:专门用于处理 URL 查询字符串的标准接口,能够自动完成参数提取、键值切分,以及针对特殊符号与中文的
decodeURIComponent自动解码。 - Object.fromEntries():ECMAScript 2019 引入的标准方法,用于将键值对列表(形如
[[key, value], ...]的迭代器)直接组装为一个标准的 JavaScript 纯对象。
下面是基于这两个 API 的通用封装实现:
// 原生最简解法:单行转换函数
function parseQuerySimple(urlOrSearch) {
  // 兼顾传入完整 URL 或仅传入查询串的情况,安全截取 ? 后面的部分
  const search = urlOrSearch.includes('?')
    ? urlOrSearch.split('?')[1].split('#')[0]
    : urlOrSearch.replace(/^#/, '');

  const params = new URLSearchParams(search);
  return Object.fromEntries(params.entries());
}

// 示例调用
const rawUrl = "https://example.com/search?keyword=javascript&page=2&sort=desc";
const result = parseQuerySimple(rawUrl);

console.log(result);
// 示例输出:
// { keyword: "javascript", page: "2", sort: "desc" }

// 若需要标准 JSON 字符串,直接调用 JSON.stringify 即可:
const jsonStr = JSON.stringify(result);
如上所示,函数在几行之内干净地完成了任务。如果当前执行环境是在浏览器中且只需要解析当前页面的 URL,代码甚至可以简化为极短的一句:
Object.fromEntries(new URLSearchParams(window.location.search))。
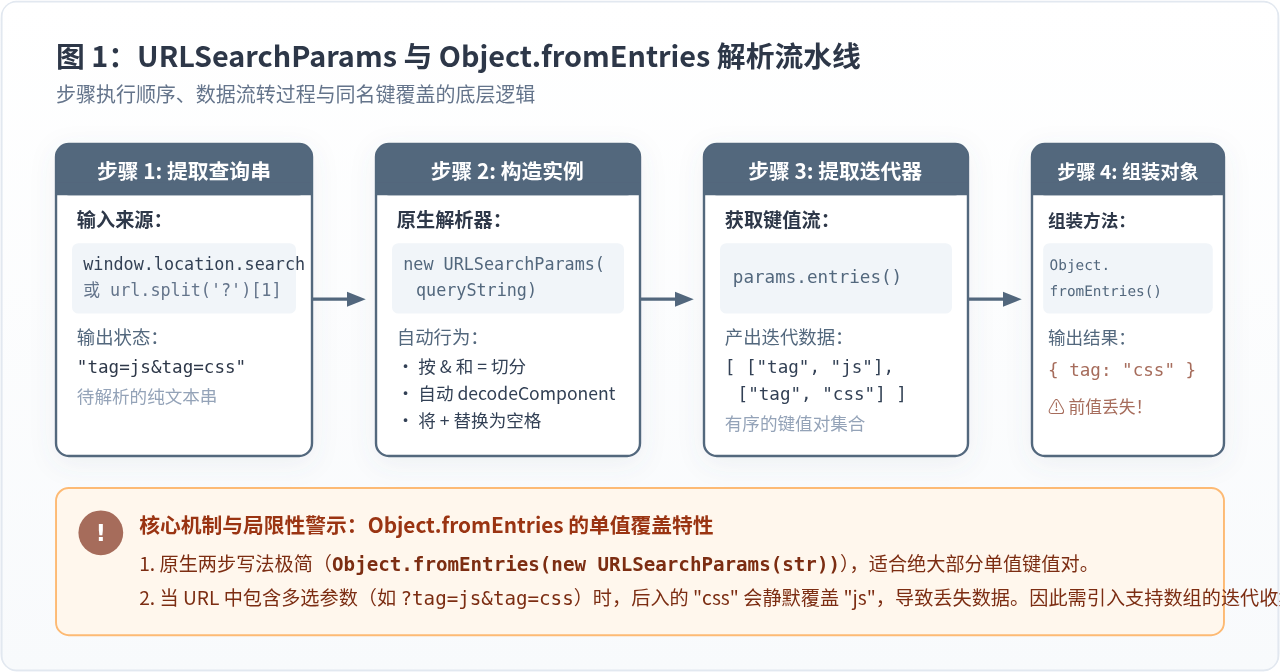
注意单值覆盖隐患:
由于
Object.fromEntries() 底层遵循“后写入的属性覆盖先写入的属性”原则,如果 URL 包含同名参数(例如表格多选筛选器常用的 ?tag=javascript&tag=css),前一个值 "javascript" 会被后面的 "css" 彻底覆盖丢失。如果业务存在多选或同名参数,必须使用下文介绍的数组合并方案。
二、支持同名重复参数:自动合并为数组
在电商筛选、多标签分类、权限复选框等业务场景中,同名键是极常见的 URL 表达形式。主要有两种书写风格:
- 直接重复键名:
?tag=web&tag=mobile&tag=desktop - 带中括号的数组语法:
?tag[]=web&tag[]=mobile
为了完整保留所有参数,我们通过 for...of 手动遍历 URLSearchParams.entries() 迭代器,并在发现键名重复时动态将其升格为数组。
/**
 * 支持同名参数与数组后缀的健壮解析函数
 * @param {string} urlOrSearch - 目标 URL 或 search 查询串
 * @returns {Record<string, any>} 转换后的普通对象
 */
function parseQueryParamsWithArrays(urlOrSearch) {
  // 提取问号之后、哈希之前的有效查询部分
  const queryString = urlOrSearch.includes('?')
    ? urlOrSearch.split('?')[1].split('#')[0]
    : urlOrSearch.replace(/^#/, '');

  const params = new URLSearchParams(queryString);
  const result = Object.create(null); // 使用纯粹对象,天然免疫 Object 原型污染

  for (const [rawKey, value] of params.entries()) {
    // 清理键名末尾的 [],统一规整命名(例如 tag[] 统一为 tag)
    const key = rawKey.endsWith('[]') ? rawKey.slice(0, -2) : rawKey;

    if (!Object.prototype.hasOwnProperty.call(result, key)) {
      // 首次出现的键:作为标量值保存
      result[key] = value;
    } else if (Array.isArray(result[key])) {
      // 已为数组:直接追加新值
      result[key].push(value);
    } else {
      // 第二次出现:将先前的标量值升级为包含两项的数组
      result[key] = [result[key], value];
    }
  }

  return Object.assign({}, result); // 浅拷贝为普通 Object 返回
}

// 示例调用
const complexUrl = "https://example.com/filter?category=it&tag=js&tag=css&role[]=admin&role[]=user";
const parsedData = parseQueryParamsWithArrays(complexUrl);

console.log(parsedData);
// 示例输出:
// {
//   category: "it",
//   tag: ["js", "css"],
//   role: ["admin", "user"]
// }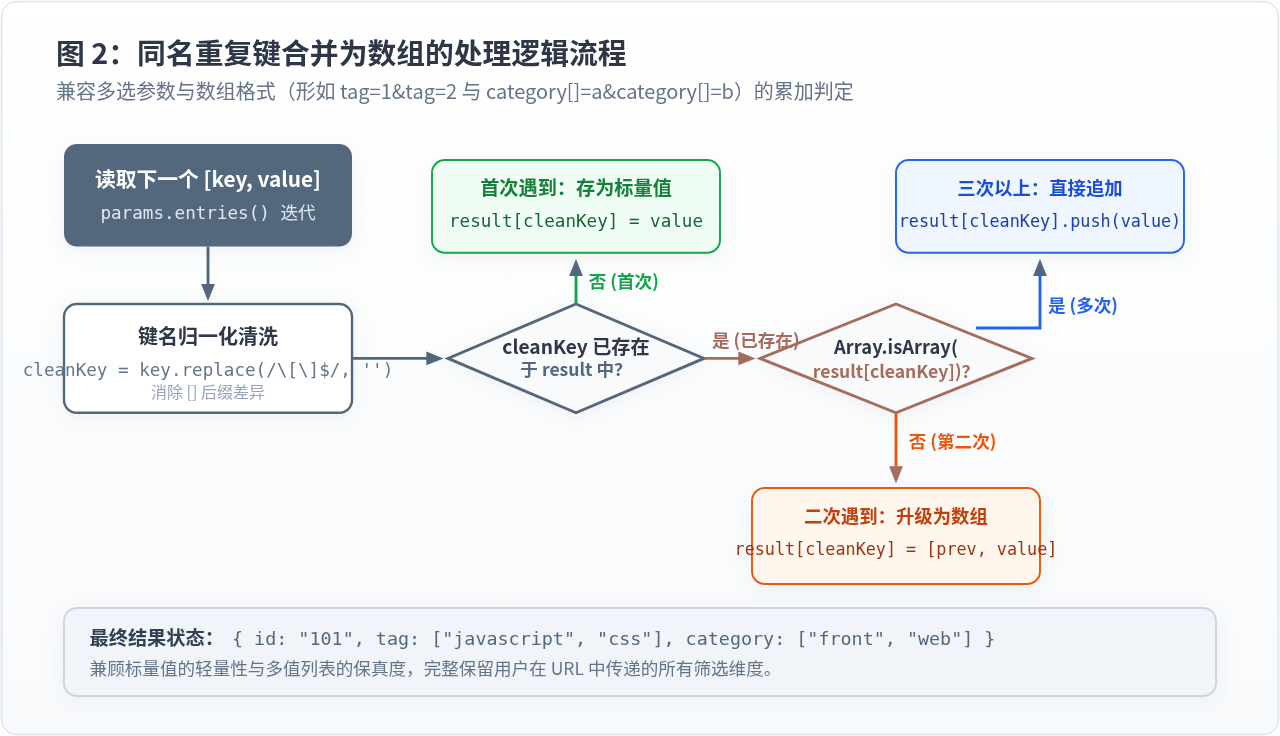
这一处理流程既保持了普通单值属性的轻量扁平,又确保了多选筛选条件在往返转换时不丢失任何一项。
三、进阶:字符串类型智能转换与安全防御
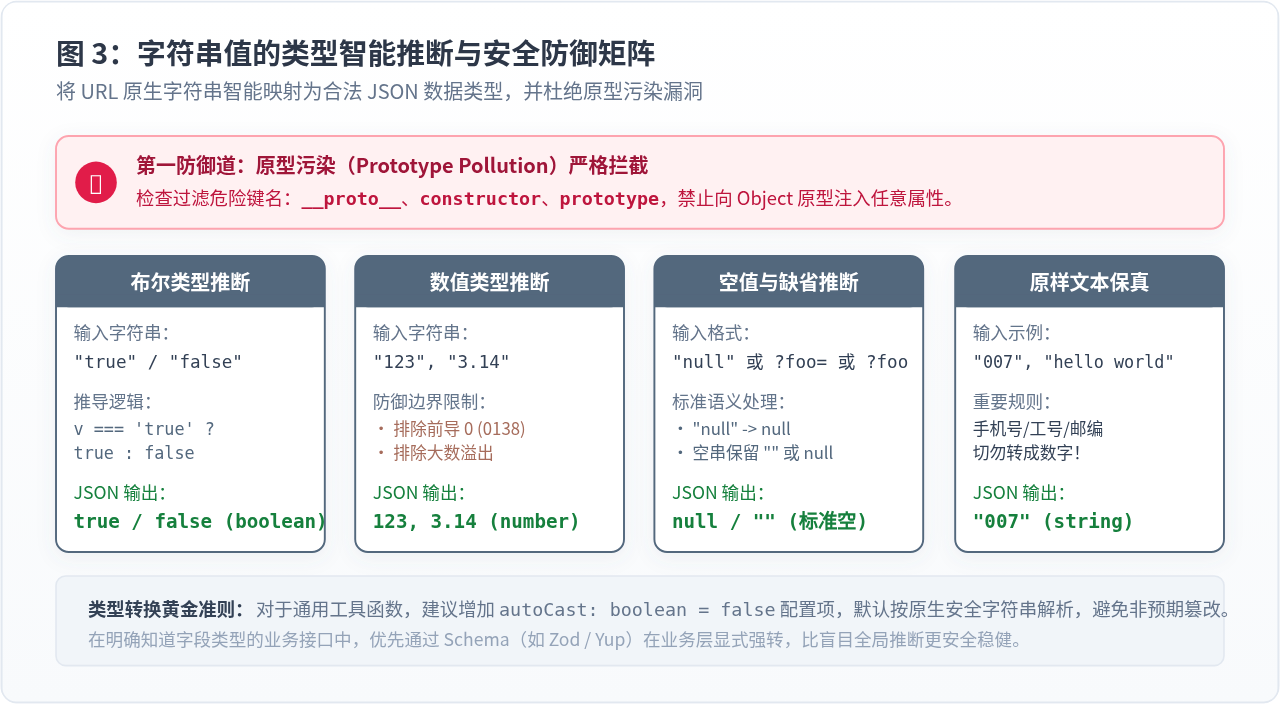
URL 标准规范规定查询字符串全为文本流。但在业务中,我们往往期望数字字符(如 page=1)在转换为 JSON 后能直接作为数字数值使用,布尔标志(如 isVip=true)作为布尔类型。如果全留为字符串,后续在业务代码中执行 if (data.isVip) 或者 data.page + 1 时,极易因隐式类型转换引发严重 Bug(例如 "1" + 1 === "11")。
1. 安全类型推断准则
编写类型推断时,务必警惕“过度推断”。例如像国内手机号 13800000000、商品编码 001290 或身份证号等,如果直接调用 Number() 转换,不仅会丢失前导 0,还可能超过 JavaScript 的安全整数范围(Number.MAX_SAFE_INTEGER)。
2. 防御原型污染攻击(Prototype Pollution)
如果直接使用未经清洗的用户输入构建对象的键,恶意构造的 URL(例如 ?__proto__[isAdmin]=true 或 ?constructor.prototype.isAdmin=true)可能修改全局 Object.prototype,引发严重的安全漏洞。因此在设置对象键名前,必须对敏感系统键进行拦截过滤。
四、生产级通用转换函数完整封装
将上述的“同名数组合并”、“智能类型转换(可选开关)”以及“原型污染防护”融为一体,得到以下开箱即用的工业级函数:
/**
 * 生产级 URL 查询参数转 JSON 对象解析器
 * @param {string} urlOrQuery - 待解析的 URL 地址或 query 字符串
 * @param {object} options - 解析配置选项
 * @param {boolean} options.autoCast - 是否开启自动类型推导(默认 false,保持全字符串更安全)
 * @returns {Record<string, any>} 解析后的 JSON 对象
 */
function parseUrlQueryToJSON(urlOrQuery, options = {}) {
  const { autoCast = false } = options;

  // 1. 规整并提取纯 query 片段
  if (!urlOrQuery || typeof urlOrQuery !== 'string') {
    return {};
  }

  let searchStr = urlOrQuery;
  if (searchStr.includes('?')) {
    searchStr = searchStr.split('?')[1];
  }
  // 移除哈希标记之后的内容
  searchStr = searchStr.split('#')[0];

  if (!searchStr.trim()) {
    return {};
  }

  const params = new URLSearchParams(searchStr);
  const output = {};

  // 内部类型转换辅助函数
  const castValue = (val) => {
    if (!autoCast) return val;
    if (val === 'true') return true;
    if (val === 'false') return false;
    if (val === 'null') return null;
    if (val === 'undefined') return undefined;

    // 纯数字转换检验:非空、非科学计数法、不带非法前导 0 的有限数字
    if (
      val.trim() !== '' &&
      !Number.isNaN(Number(val)) &&
      // 避免将 0123 这种编码转成十进制数字 123
      !(val.length > 1 && val.startsWith('0') && !val.includes('.'))
    ) {
      const num = Number(val);
      // 处于安全整数范围内或正常浮点数时才转换
      if (Number.isSafeInteger(num) || val.includes('.')) {
        return num;
      }
    }

    return val;
  };

  // 2. 遍历参数并执行组装
  for (const [rawKey, rawVal] of params.entries()) {
    // 核心防线:过滤原型污染敏感关键词
    if (rawKey === '__proto__' || rawKey === 'constructor' || rawKey === 'prototype') {
      continue;
    }

    // 统一去除 [] 数组标号后缀
    const key = rawKey.endsWith('[]') ? rawKey.slice(0, -2) : rawKey;
    const value = castValue(rawVal);

    if (!Object.prototype.hasOwnProperty.call(output, key)) {
      output[key] = value;
    } else if (Array.isArray(output[key])) {
      output[key].push(value);
    } else {
      output[key] = [output[key], value];
    }
  }

  return output;
}

// 实测验证调用
const testUrl = "https://shop.example.com/api?id=9821&code=007&active=true&tag=phone&tag=5g&__proto__[hack]=1";

// 模式 1:默认安全字符串模式
console.log(parseUrlQueryToJSON(testUrl));
// 输出: { id: "9821", code: "007", active: "true", tag: ["phone", "5g"] }

// 模式 2:启用自动类型推断
console.log(parseUrlQueryToJSON(testUrl, { autoCast: true }));
// 输出: { id: 9821, code: "007", active: true, tag: ["phone", "5g"] }
// 注意: code: "007" 仍被稳妥保留为文本,防止业务前导 0 丢失;__proto__ 攻击被直接拦截
五、常见开发避坑与注意事项
在实际工程落地时,除了代码本身的解析逻辑外,还有以下三个典型的高频问题需要特别注意:
1. 单页应用(SPA)中的 Hash 路由陷阱
在使用 Vue Router 或 Hash 模式前端路由时,URL 往往带有形如 https://example.com/#/detail?id=10 的结构。
此时直接读取浏览器原生 window.location.search 将会返回空字符串,因为问号出现在 # 哈希片段之后,查询参数实际上附属于 window.location.hash。
解决方案:
针对 Hash 路由,应通过
window.location.href.split('?')[1] 或通过路由库暴露的上下文(如 route.query)来获取参数串,避免直接盲信 window.location.search。
2. 空值与无值键的处理语义
在标准查询串中,?flag 和 ?flag= 在底层含义上稍有区别:
?flag(无等号):URLSearchParams.get("flag")返回空字符串""。?flag=(有等号无值):同样返回空字符串""。- 某些团队在后端习惯将无等号的键视为布尔开关
true,若有此特定需求,可根据传入字符串手工预处理。
3. 加号 + 与空格的编码差异
在 application/x-www-form-urlencoded 规范中,空格会被序列化为加号 +,而标准 URI 编码(encodeURIComponent)会将空格转为 %20。
原生 URLSearchParams 会自动把 + 视为空格进行解码。如果你是在写基于 split('&') 的原生降级逻辑,切记在 decodeURIComponent 之前执行 replace(/\+/g, ' '),否则会留下字面量加号。
六、方案对比与总结
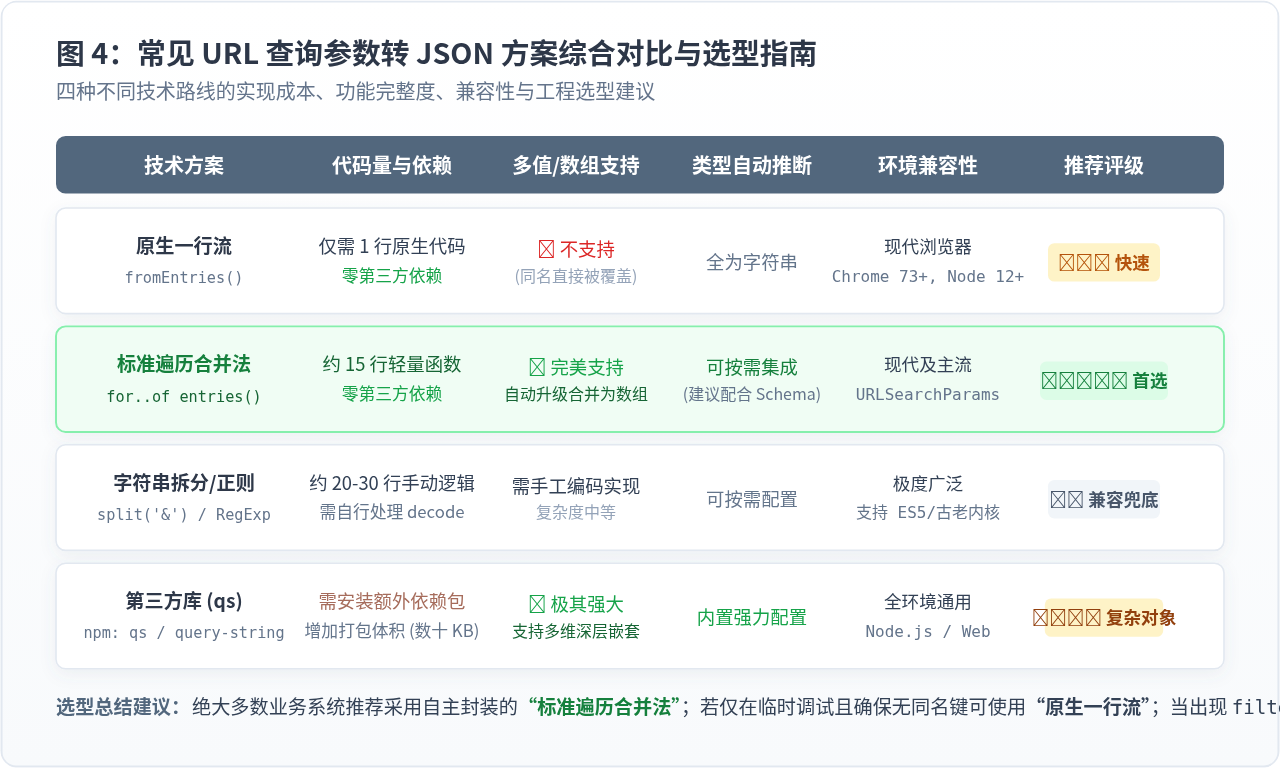
将 URL 查询参数转为 JSON 对象并没有绝对“放之四海皆准”的单一写法,合理的选型取决于你的应用场景和数据复杂度:
| 解析方案 | 依赖体积 | 多值/数组支持 | 适用业务场景 |
|---|---|---|---|
| Object.fromEntries(new URLSearchParams(s)) | 0(原生单行) | 不支持(后值覆盖) | 简单脚本、内部工具、无同名参数的单值快速获取 |
| 自主封装的遍历合并函数 | 0(约 30 行工具代码) | 完全支持(自动合并) | 绝大多数商业 Web 项目(推荐首选) |
| 第三方解析库(qs / query-string) | 额外 npm 包(几十 KB) | 强(支持多维嵌套对象) | 深度嵌套筛选器(如 filter[user][id]=1) |
综上所述,对于大多数日常项目,掌握 URLSearchParams 的迭代机制并配合防原型污染、多值合并逻辑进行轻量封装,既能获得极佳的运行时性能与零打包依赖体积,又能完全掌控数据格式与类型安全,是处理 URL 参数转 JSON 的最佳工程实践。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章