
深入解析JavaScript中ArrayBuffer、Blob与Base64的核心特征与相互转换方法,提供完整的浏览器端与Node.js端转换代码、性能注意事项及场景选型指南。

当前位置:首页 > JavaScript 基础 > 正文
JavaScript中ArrayBuffer、Blob与Base64的相互转换方法
作者:小满
时间:2026-11-20
浏览:179
文章目录
前端技术
二进制处理
Web API
阅读时长约 8 分钟
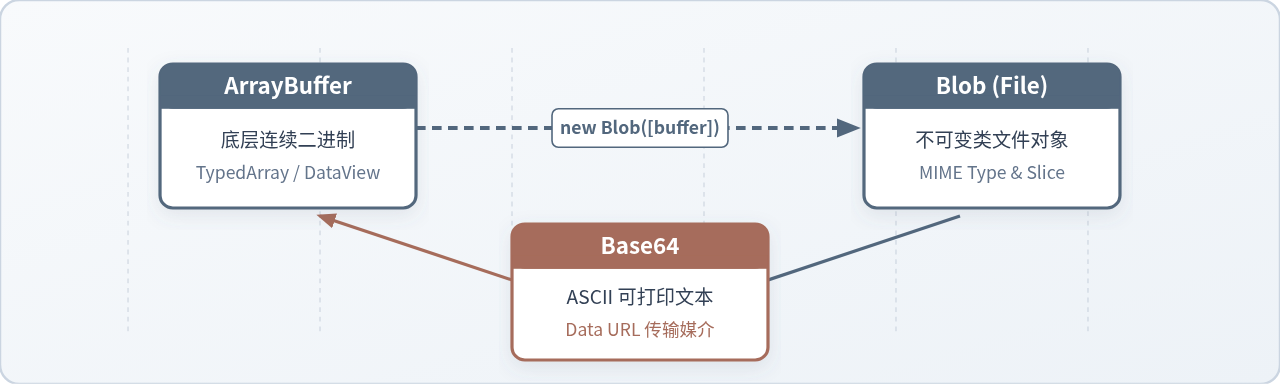
在 JavaScript 前端与服务端开发中,处理图片裁剪、音视频转码、文件切片上传或数据下载时,经常需要在底层的连续内存块(
ArrayBuffer)、不可变的文件封装对象(Blob)以及文本化编码字符串(Base64)之间进行形态转换。三者并非孤立概念,而是分别对应“物理内存字节”、“带类型的类文件容器”与“可打印 ASCII 文本序列”,了解其内部构造并掌握清晰的互转路径,能够帮助开发者在面对复杂二进制处理时游刃有余。
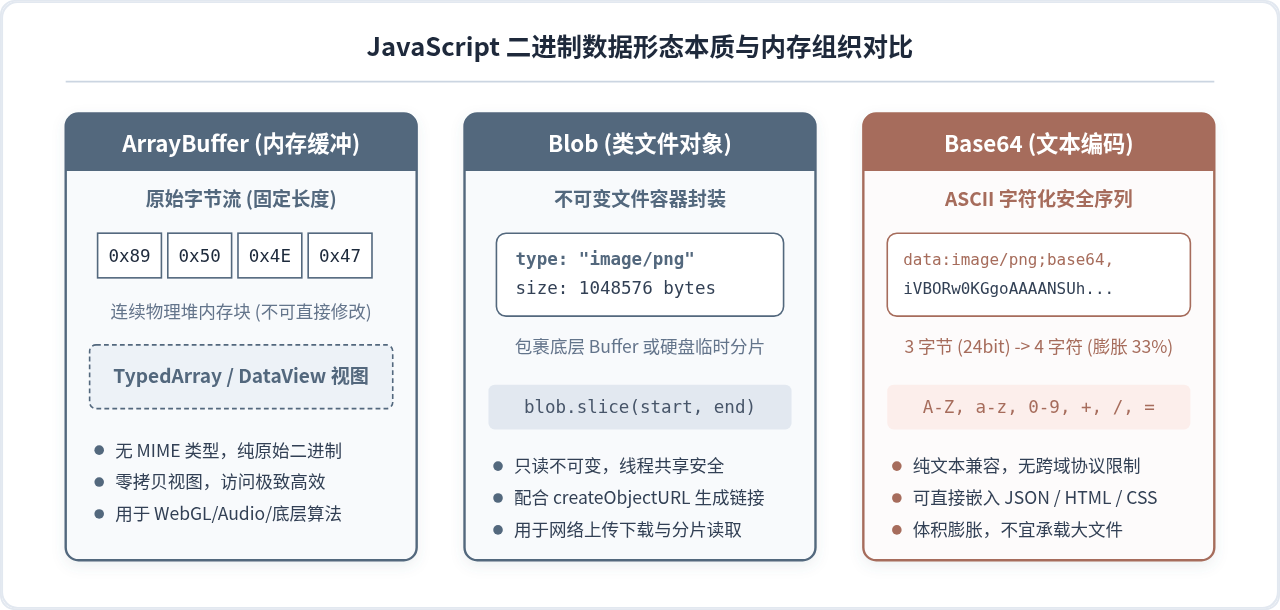
一、三类核心数据形态的本质区别
在编写转换代码之前,需要清晰界定它们在运行时的内存特征与设计用途。混淆它们的边界往往会导致内存重复拷贝甚至主线程卡死:
-
ArrayBuffer:代表在物理堆内存中开辟的一段固定长度的连续二进制缓冲区。它本身只是一段裸数据,不具备直接读写接口,也没有 MIME 类型标识。开发者必须通过
Uint8Array、Int32Array等类型化数组(TypedArray)或者DataView视图才能解析或修改内部字节。它适用于底层算法计算、音频合成、WebGL 纹理处理及 Web Worker 间的零拷贝转移(Transferable Objects)。 -
Blob(Binary Large Object):是一个代表只读、不可变类文件原始数据的容器。它拥有
size(字节数)和type(MIME 字符串,如image/png)属性。Blob 可以持有内存中的数据,也可以映射本地文件系统或网络流。通过blob.slice()可以低成本实现大文件切片。它广泛配合FormData、fetch()上传,以及通过URL.createObjectURL()供 DOM 节点即时预览。 -
Base64:是一种基于 64 个可打印 ASCII 字符(
A-Z、a-z、0-9、+、/,末尾补位=)来表示二进制数据的文本编码方案。Base64 将每 3 个字节(24 位)拆分为 4 个 6 位的组,因此编码后的文本体积比原始二进制大约增加 33%。它常以data:image/png;base64,...(Data URL)的形式直接内联于 HTML、CSS 或 JSON 响应中,从而避免额外的 HTTP 轮询请求。
二、互转全景与六大核心转换路径
三者之间的互转形成了一个闭环。根据业务数据流向,共有 6 种明确的转换路径。以下分别提供标准、高可靠且具备容错能力的实现代码。
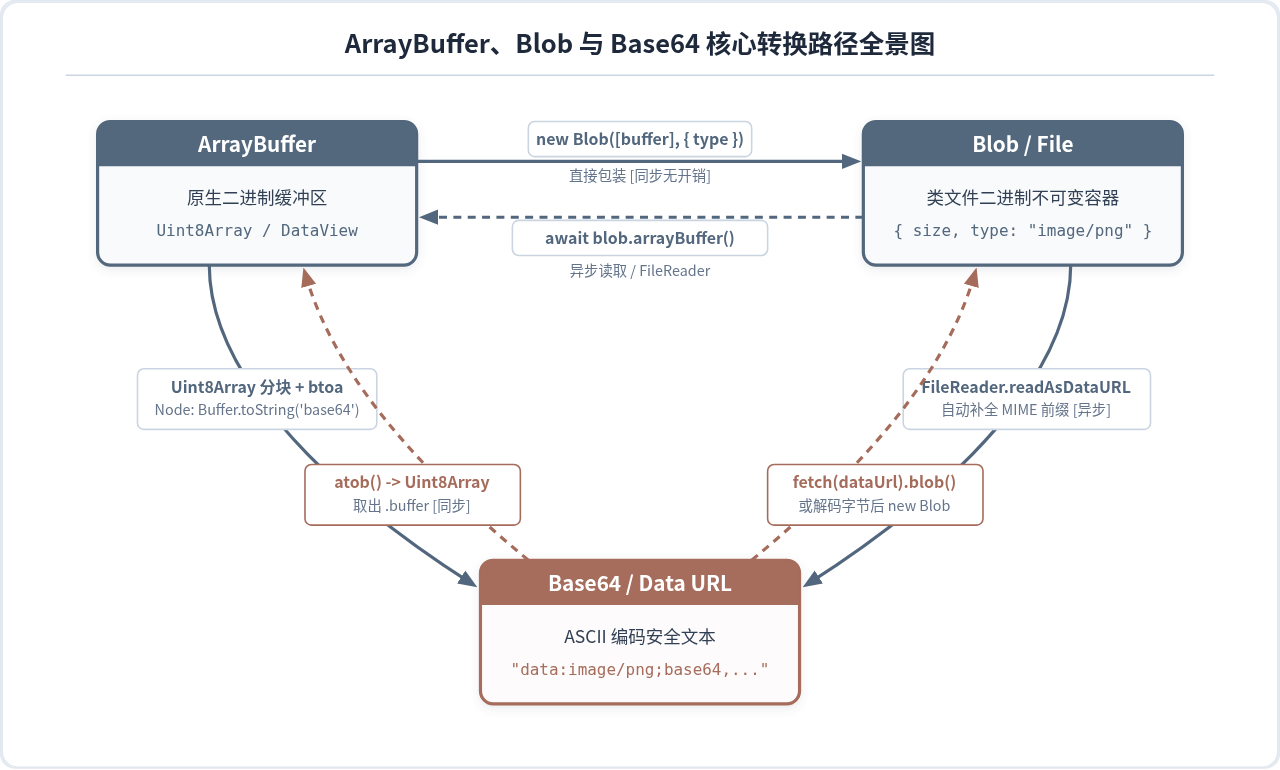
1. ArrayBuffer 与 Blob 的互转
这是两类二进制格式之间最自然的转换通道。因为 Blob 的底层构造器直接支持吸收 ArrayBuffer 或 TypedArray,而现代浏览器中 Blob 也提供了直接返回 Promise 的原生解析方法。
(1)ArrayBuffer 转 Blob(同步构造)
直接通过 new Blob([arrayBuffer], { type: mimeType }) 完成封装。注意必须以数组形式传入首个参数:
/**
 * 将 ArrayBuffer 转为指定 MIME 类型的 Blob
 * @param {ArrayBuffer} buffer - 原始二进制缓冲区
 * @param {string} mimeType - 数据 MIME 类型,如 "application/octet-stream"、"image/png"
 * @returns {Blob}
 */
function arrayBufferToBlob(buffer, mimeType = 'application/octet-stream') {
  return new Blob([buffer], { type: mimeType });
}
(2)Blob 转 ArrayBuffer(异步读取)
在现代主流浏览器中,优先使用标准 Promise API blob.arrayBuffer();若需兼顾极老版本环境,可使用 FileReader:
/**
 * 将 Blob 转为 ArrayBuffer(现代异步方案)
 * @param {Blob} blob
 * @returns {Promise<ArrayBuffer>}
 */
async function blobToArrayBuffer(blob) {
  if (typeof blob.arrayBuffer === 'function') {
    return await blob.arrayBuffer();
  }

  // 针对旧版浏览器的 FileReader 回退方案
  return new Promise((resolve, reject) => {
    const reader = new FileReader();
    reader.onload = () => resolve(reader.result);
    reader.onerror = () => reject(reader.error);
    reader.readAsArrayBuffer(blob);
  });
}
2. ArrayBuffer 与 Base64 的互转
将物理字节转换为可打印字符串时,核心要点在于如何避免“栈溢出”并兼顾运行效率。浏览器环境通常使用 btoa 与 atob,而 Node.js 环境则依托于原生 Buffer。
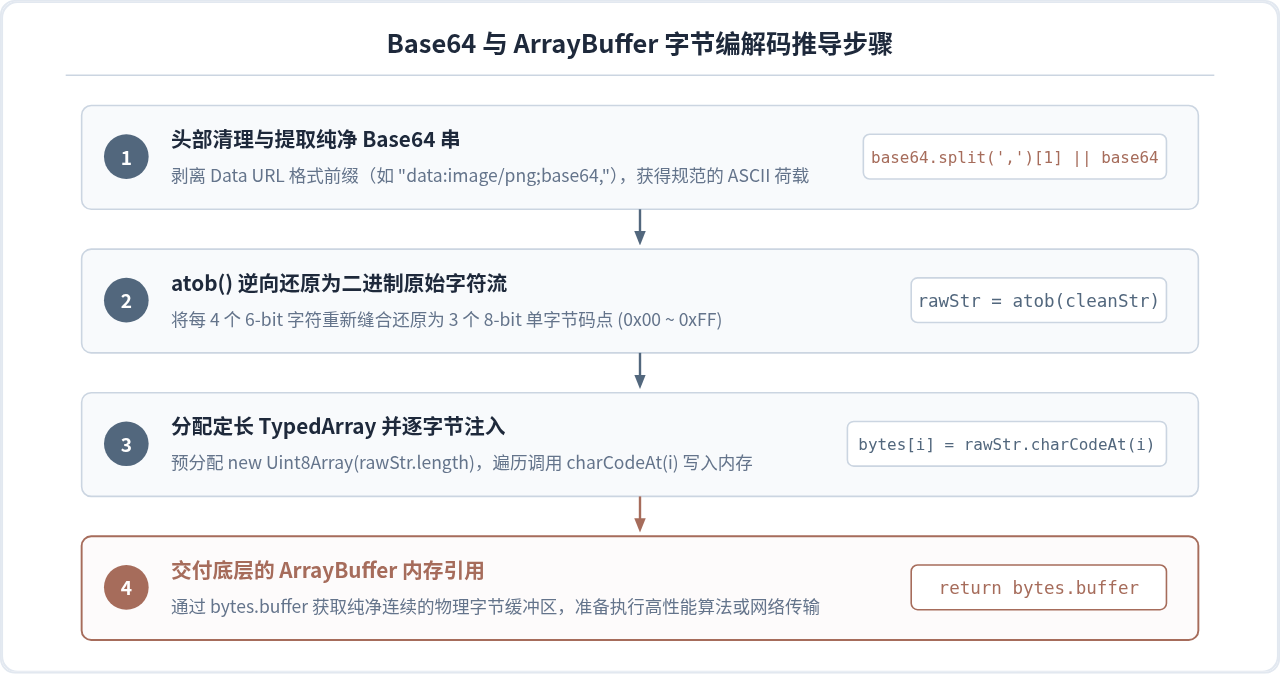
(1)ArrayBuffer 转 Base64
常见但危险的写法是 btoa(String.fromCharCode.apply(null, new Uint8Array(buffer)))。当数据超过几十 KB 时,该写法会触发 JavaScript 虚拟机的参数长度限制,导致 RangeError: Maximum call stack size exceeded。工业级实现应采用分块转换循环:
/**
 * 将 ArrayBuffer 转为 Base64 编码字符串(防爆栈分块实现)
 * @param {ArrayBuffer} buffer
 * @returns {string}
 */
function arrayBufferToBase64(buffer) {
  // Node.js 环境兼容
  if (typeof Buffer !== 'undefined') {
    return Buffer.from(buffer).toString('base64');
  }

  // 浏览器环境:采用 32768 字节分块转换
  const bytes = new Uint8Array(buffer);
  const chunkSize = 0x8000;
  let binaryString = '';

  for (let i = 0; i < bytes.length; i += chunkSize) {
    const chunk = bytes.subarray(i, i + chunkSize);
    binaryString += String.fromCharCode.apply(null, chunk);
  }

  return btoa(binaryString);
}
(2)Base64 转 ArrayBuffer
先清洗掉可能附带的 Data URL 协议前缀(如 data:image/png;base64,),随后通过 atob() 解码为单字节字符串,最后遍历填入 Uint8Array 内存区并提取其底层的 .buffer:
/**
 * 将 Base64 字符串解码为 ArrayBuffer
 * @param {string} base64Str - 可以带有 data:*/*;base64, 前缀
 * @returns {ArrayBuffer}
 */
function base64ToArrayBuffer(base64Str) {
  // Node.js 环境兼容
  if (typeof Buffer !== 'undefined') {
    const clean = base64Str.includes(',') ? base64Str.split(',')[1] : base64Str;
    const buf = Buffer.from(clean, 'base64');
    return buf.buffer.slice(buf.byteOffset, buf.byteOffset + buf.byteLength);
  }

  // 1. 过滤 Data URL 头部信息
  const cleanBase64 = base64Str.includes(',') ? base64Str.split(',')[1] : base64Str;

  // 2. atob 解码为字节字符串
  const binaryString = atob(cleanBase64);
  const len = binaryString.length;

  // 3. 创建定长 TypedArray 并灌入字节
  const bytes = new Uint8Array(len);
  for (let i = 0; i < len; i++) {
    bytes[i] = binaryString.charCodeAt(i);
  }

  return bytes.buffer;
}
3. Blob 与 Base64 的互转
在日常图像展示、文件上传组件开发中,Blob 与 Base64 的互转是最普遍的需求。
(1)Blob 转 Base64(Data URL 格式)
利用浏览器的 FileReader.readAsDataURL(),不仅转换过程交由底层线程异步执行,而且能自动拼接 MIME 头部信息:
/**
 * 将 Blob 转换为 Base64 Data URL 字符串
 * @param {Blob} blob
 * @returns {Promise<string>}
 */
function blobToBase64(blob) {
  return new Promise((resolve, reject) => {
    const reader = new FileReader();
    reader.onload = () => resolve(reader.result);
    reader.onerror = () => reject(reader.error);
    reader.readAsDataURL(blob);
  });
}
(2)Base64 转 Blob
将 Base64 转换回 Blob 有两种通用方式:一种是利用现代 fetch() 直接请求 Data URL(代码极简);另一种是手动解析 MIME 并经由 Uint8Array 组装(在不支持 Data URL fetch 的特定环境或需要微调时更灵活):
/**
 * 方式一:利用 fetch 直接将 Data URL 转化为 Blob(现代简洁推荐)
 * @param {string} dataUrl
 * @returns {Promise<Blob>}
 */
async function base64ToBlobViaFetch(dataUrl) {
  const res = await fetch(dataUrl);
  return await res.blob();
}

/**
 * 方式二:纯数学与 TypedArray 转换(同步无网络栈开销)
 * @param {string} base64Str
 * @param {string} defaultMime
 * @returns {Blob}
 */
function base64ToBlobManual(base64Str, defaultMime = 'application/octet-stream') {
  let mime = defaultMime;
  let rawBase64 = base64Str;

  if (base64Str.startsWith('data:')) {
    const parts = base64Str.split(',');
    const mimeMatch = parts[0].match(/:(.*?);/);
    if (mimeMatch) mime = mimeMatch[1];
    rawBase64 = parts[1];
  }

  const binaryStr = atob(rawBase64);
  const len = binaryStr.length;
  const bytes = new Uint8Array(len);

  for (let i = 0; i < len; i++) {
    bytes[i] = binaryStr.charCodeAt(i);
  }

  return new Blob([bytes], { type: mime });
}
三、关键陷阱与大文件性能治理
在实际生产环境中处理文件时,不当的转换方式会导致内存成倍暴增,甚至引发浏览器标签页崩溃。
避坑警示:不要在大于 10MB 的场景滥用 Base64
由于 JavaScript 引擎内部对于普通字符串多采用 UTF-16 表达,一段 100MB 的二进制文件编码为 Base64 文本后,不仅本身的字符长度变为约 133MB,在 V8 引擎堆内存中更可能占用近 260MB 的内存空间。如果紧接着调用 split() 或正则替换,瞬时内存将突破 500MB,极易触发垃圾回收卡顿(GC Thrashing)甚至崩溃。
-
图片即时预览优先使用
URL.createObjectURL(): 当用户选择本地图片上传需要展示缩略图时,调用URL.createObjectURL(fileBlob)会直接生成一个轻量的blob:http://...句柄,它只持有底层文件指针,几乎零内存占用且是同步返回。相比FileReader.readAsDataURL()解析成庞大的 Base64 字符串,性能优势极其明显。但在使用完毕(如组件卸载或图片加载完成)后,记得显式调用URL.revokeObjectURL(url)释放句柄引用。 -
Web Worker 线程通信利用可转移对象(Transferable Objects):
在主线程与 Worker 之间传递大型计算数据时,如果传递普通对象或 Base64 文本,会执行结构化克隆(Structured Clone)深拷贝;而如果传递
ArrayBuffer,可以通过worker.postMessage(buffer, [buffer])实现所有权转移,数据无需经过任何物理内存复制,耗时维持在毫秒级别。
四、技术选型矩阵与实践建议
为了在复杂业务开发中快速定位最佳格式,以下提供完整的选型决策参考:
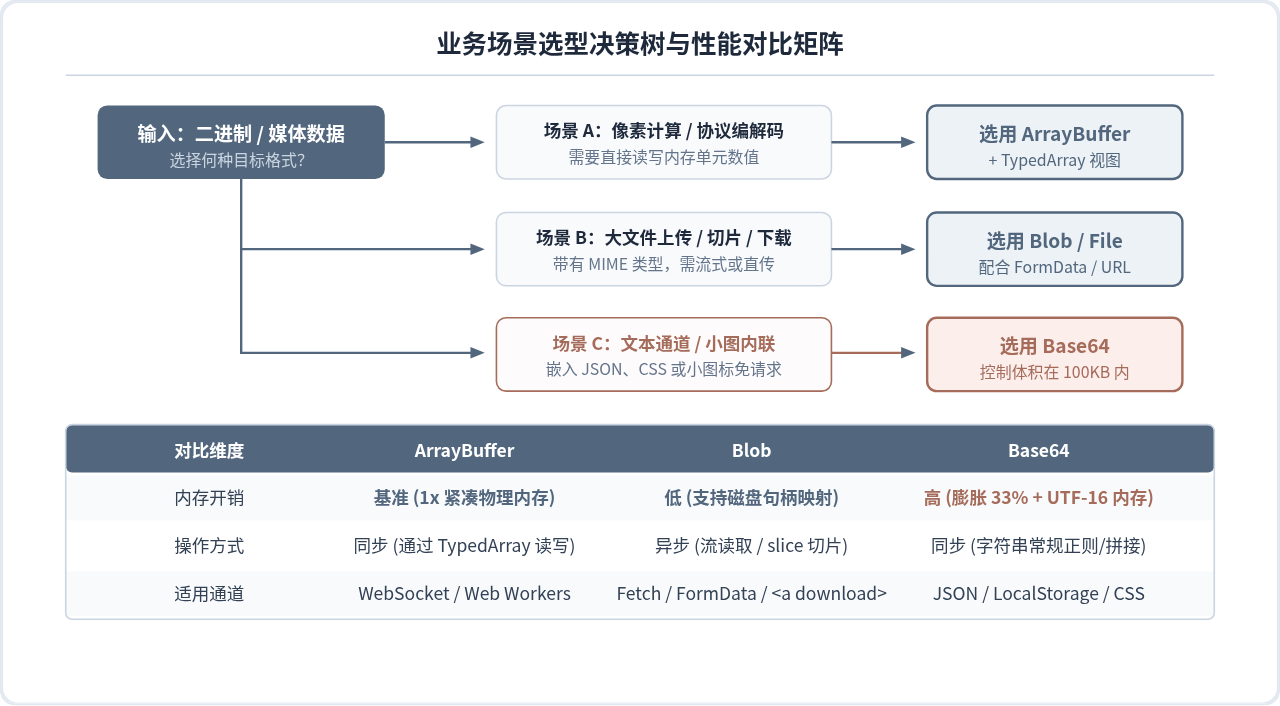
| 特性 / 指标 | ArrayBuffer | Blob (File) | Base64 (Data URL) |
|---|---|---|---|
| 物理存储形态 | 连续内存字节块 | 不可变包装句柄(支持文件映射) | ASCII 字符串文本 |
| MIME 类型感知 | 无(需应用层自维护元数据) | 内置 type 属性 |
内置(Data URL 协议头) |
| 数据读写能力 | 强(依赖 TypedArray/DataView 修改) | 只读不可变(仅支持切片分块) | 只读字符串(只能正则/拼接) |
| 典型应用场景 | 音视频算法、WebGL、加密运算 | 大文件断点续传、表单上传、下载 | 小图标内联、JSON API 数据嵌套 |
| 内存资源开销 | 极低(1x 紧凑内存占用) | 极低(可由操作系统虚拟文件映射) | 高(1.33x ~ 2.6x 堆内存膨胀) |
总结而言,如果你的目标是高频读写或底层运算,请始终保留在 ArrayBuffer / TypedArray 状态;如果需要网络传输、切片分块或文件保存,应将数据包装为 Blob;而 Base64 仅应作为在只能传递文本字符串的受限信道(如 JSON 载荷、Markdown 内联图片)时的权宜桥梁。把握这三者的边界与核心转换工具,就能在各类复杂的二进制开发场景中游刃有余。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章