
本文系统详解JavaScript中正则表达式的两种创建方式(字面量与RegExp构造函数)、核心基础语法规则(元字符、字符集、量词、边界、分组)、常用修饰符与API,并深入分析动态正则与lastIndex有状态陷阱。

当前位置:首页 > JavaScript 基础 > 正文
JavaScript正则表达式基础语法与创建方式详解
作者:闭包旅人
时间:2026-11-20
浏览:199
文章目录
在 JavaScript 中,正则表达式(Regular Expression,简称 RegExp)是用于在字符串中执行模式匹配、字符检索、格式校验与内容替换的核心工具对象。无论是前端表单中验证手机号与邮箱格式、富文本编辑器中过滤非法标签,还是服务端 Node.js 处理数据流,掌握正则表达式的基础语法与底层创建机制都是前端与全栈开发者的必备技能。本文将从正则表达式的两种创建方式入手,剖析编译时机与转义差异,逐一拆解元字符、字符集、量词、边界等核心基础语法,并重点分析全局模式下容易引发隐蔽 Bug 的 lastIndex 状态流转机制,帮助读者建立系统、可靠的正则表达式使用范式。
一、JavaScript 中创建正则表达式的两种方式
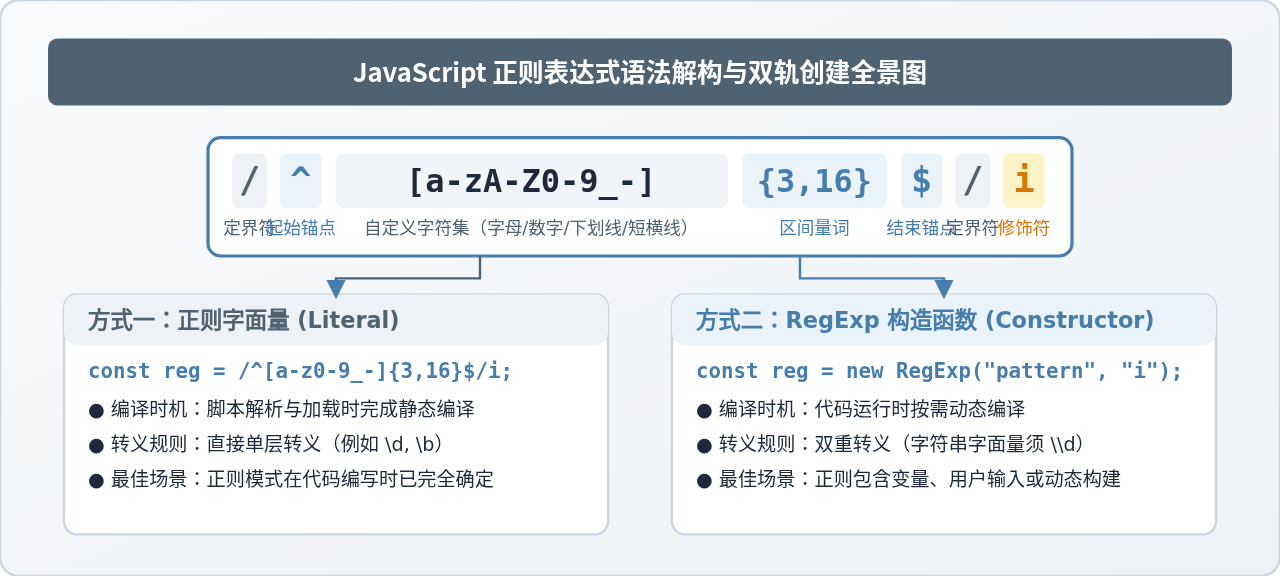
JavaScript 提供了两种构建 RegExp 实例的语法:字面量方式与 RegExp 构造函数方式。两者的核心功能一致,但在语法形式、解析时机、性能表现以及转义规则上存在明确差异。
1. 字面量创建方式(Literal)
字面量语法由一对正斜杠 / 包裹模式文本,末尾附加可选的修饰符(Flags):
// 语法格式:/pattern/flags
const reg1 = /^\d{3,4}-\d{7,8}$/;      // 匹配固定电话号码格式
const reg2 = /hello/i; // 匹配 hello,忽略大小写编译时机与机制:字面量在 JavaScript 引擎加载并解析脚本源代码阶段即完成静态编译。这意味着如果把字面量放在循环体内部,现代 JavaScript 引擎在语法分析期就构建好了该正则模式,不会在每一次循环迭代中重复耗费解析成本。
书写优势:书写简洁直接,定界符与元字符无需多重转义。例如表示数字时直接使用 \d,表示普通点号时书写 \. 即可。
2. RegExp 构造函数创建方式(Constructor)
构造函数语法通过 new RegExp(pattern, flags) 构建对象,接收字符串形式的模式和修饰符参数:
// 语法格式:new RegExp(patternString, flagsString)
const reg1 = new RegExp("^\\d{3,4}-\\d{7,8}$");
const reg2 = new RegExp("hello", "i");编译时机与机制:构造函数属于运行时编译。引擎只有在代码实际执行到 new RegExp(...) 这一行时,才会将传入的字符串解析为正则表达式模式。当正则模式依赖外部传入的参数、配置文件或用户实时输入的搜索关键字时,构造函数是唯一的实现途径。
3. 核心差异:双重转义与动态输入安全防御
许多初学者在使用构造函数时经常遇到正则匹配失效的问题,其根本原因在于字符串字面量解析与正则语法解析的双重转义机制。
在 JavaScript 中,双引号 "" 或单引号 '' 包含的字符串本身就支持转义序列(例如
表示换行符, 表示制表符)。当书写 new RegExp("\d+") 时:
- 第一层解析(字符串字面量解析):字符串编译器读取
"\d",由于\d在字符串转义规则中并不是合法的特殊转义字符,反斜杠被直接脱除,字符串结果退化为普通字符"d"。 - 第二层解析(正则引擎解析):正则引擎接收到的实际输入是
"d+",最终变成匹配“一个或多个字母 d”,完全丢失了原本期望的数字匹配意图。
因此,若要在构造函数中传递反斜杠元字符,必须书写双反斜杠 \(例如 "\d+")。第一个反斜杠用于转义第二个反斜杠,确保传递给正则引擎的字符串中包含单反斜杠。
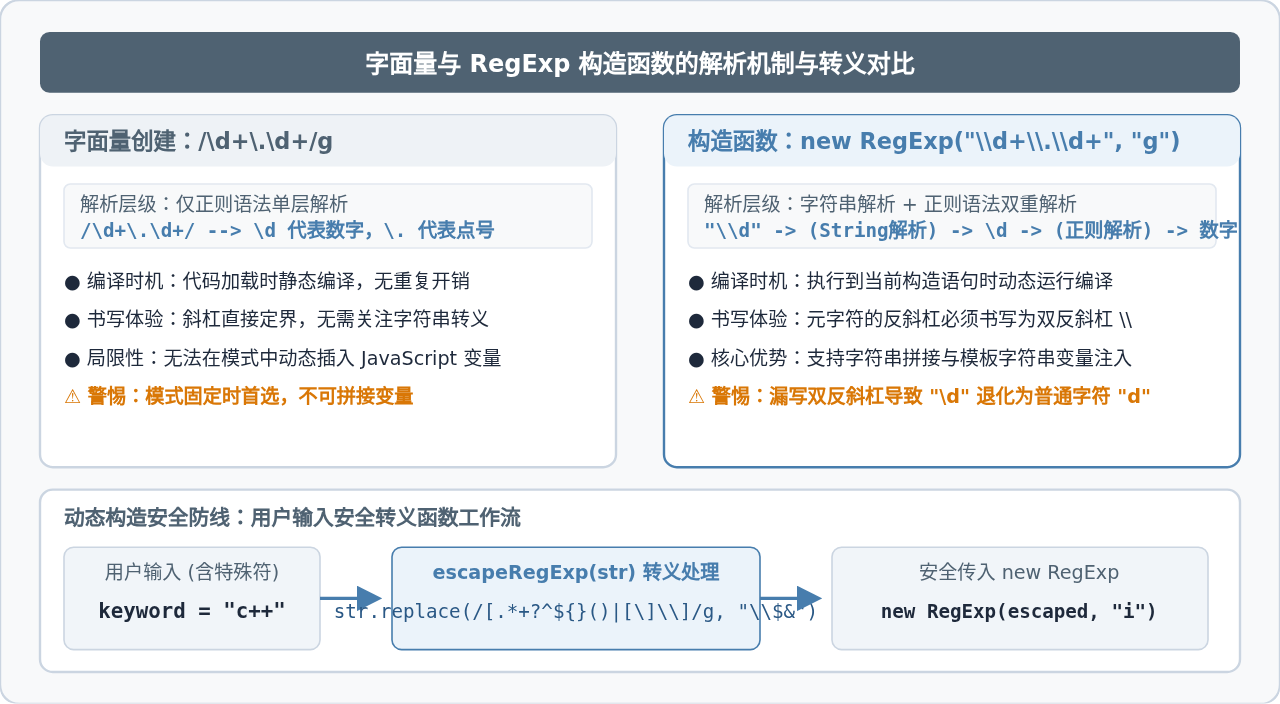
安全防范提醒:在使用构造函数接收用户输入动态构建正则时(例如站内文本高亮搜索),如果用户输入包含了正则表达式的保留字符(如
.、*、+、?、$、^、[、( 等),不加转义直接传入构造函数会导致语法解析错误(SyntaxError: Invalid regular expression)或引发非预期的匹配行为。必须使用通用的转义函数先行处理:
/**
 * 将任意字符串中的正则表达式保留字符进行安全转义
 * @param {string} string 待转义的原始字符串
 * @returns {string} 可安全用于 new RegExp 的转义字符串
 */
function escapeRegExp(string) {
  return string.replace(/[.*+?^${}()|[\]\\]/g, "\\$&");
}

// 使用场景:动态高亮搜索关键词
const userInput = "price($100.00)"; // 包含 $ ( . ) 等保留字
const safePattern = escapeRegExp(userInput);
const searchReg = new RegExp(safePattern, "gi");

const content = "Special deal: price($100.00) today only.";
console.log(searchReg.test(content)); // 输出:true(安全精确匹配,无语法崩溃)
二、正则表达式基础语法与分类解析
正则表达式的本质是描述字符排列规则的形式语言。JavaScript 正则语法主要由以下四大核心要素构成:
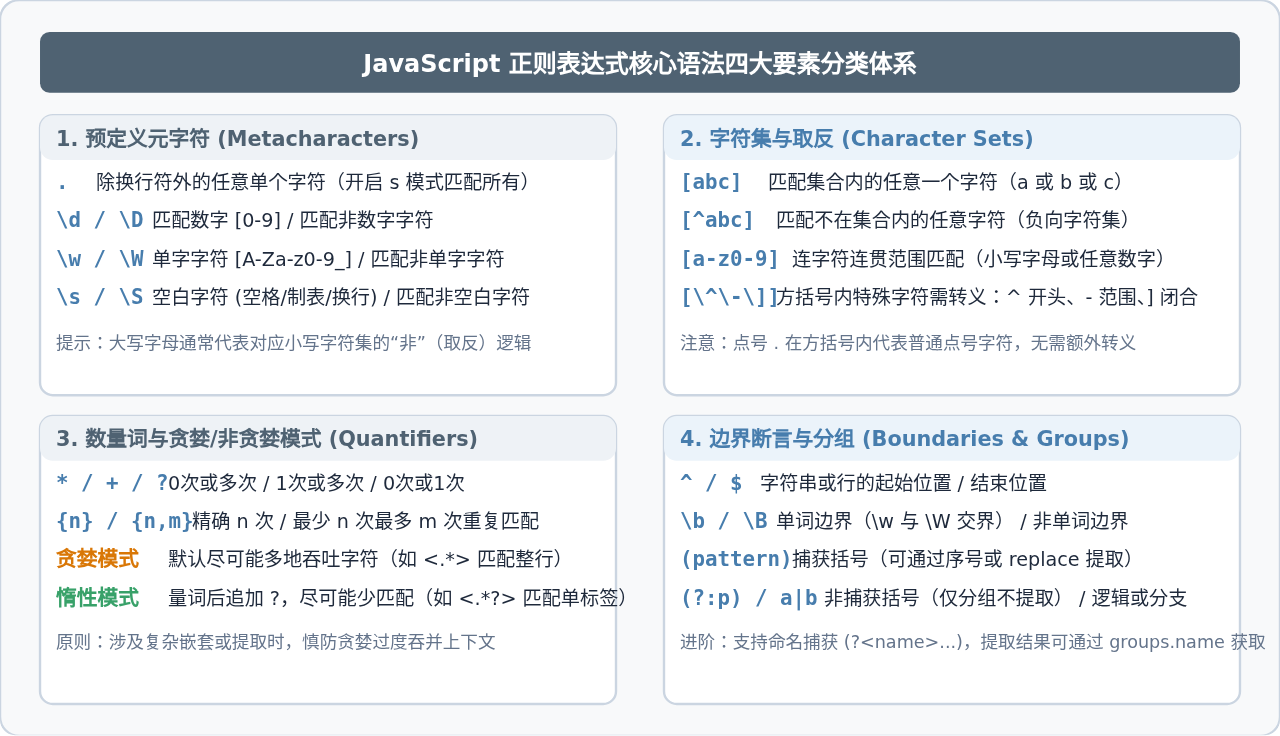
1. 预定义元字符(Metacharacters)
元字符是正则表达式中具有特殊表意功能的字符简写:
| 元字符 | 对应等价集合 | 含义解释与匹配范围 | 示例匹配 |
|---|---|---|---|
. |
除换行符外的任意字符 | 匹配除
、 以外的任意单个字符;若启用 s 修饰符则包含换行符 |
/a.c/ 匹配 abc, a-c |
\d |
[0-9] |
匹配任意一个 ASCII 数字字符 | /\d{3}/ 匹配 123 |
\D |
[^0-9] |
匹配任意一个非数字字符(\d 的取反) |
/\D+/ 匹配 hello |
\w |
[A-Za-z0-9_] |
匹配任意字母、数字或下划线(基础单词字符) | /\w+/ 匹配 user_01 |
\W |
[^A-Za-z0-9_] |
匹配任意非单字字符,如空格、标点符号、中文汉字 | /\W/ 匹配 @ 或 中 |
\s |
[

] |
匹配任意单个空白字符,包含空格、Tab 制表符、换行符 | /\s+/ 匹配连续空格或制表符 |
\S |
[^

] |
匹配任意单个非空白字符 | /\S+/ 匹配非空单词片段 |
2. 自定义字符集与取反(Character Sets)
当预定义元字符无法满足特定匹配需求时,可以通过方括号 [...] 自定义字符集合:
- 枚举集合:
[aeiou]匹配 5 个英文字母中的任意一个。 - 范围连字符:
[0-9a-fA-F]使用短横线-表达闭区间范围,用于匹配十六进制字符。 - 负向集合(取反):在方括号起始位置添加脱字符
[^...]表示排除。例如[^0-9]匹配任意非数字字符。注意脱字符只有置于首位时才代表取反,处于中间位置时(如[a^b])仅代表字面量^本身。 - 方括号内的特殊字符特性:大多数在正则外部具有特殊语法的符号(如
.、*、+、?、$、(、)),在方括号内部会自动退化为字面量字符,无需额外加反斜杠转义。例如[.]仅匹配普通小数点字符本身。
3. 量词与贪婪/惰性模式(Quantifiers)
量词用于限定其前导字符或分组允许连续出现的次数:
*:匹配 0 次或多次(等价于{0,})。+:匹配 1 次或多次(等价于{1,})。?:匹配 0 次或 1 次(等价于{0,1}),常用于表达可选字符。{n}:精确匹配 n 次。{n,}:最少匹配 n 次。{n,m}:最少匹配 n 次,最多匹配 m 次。
贪婪模式与惰性模式(非贪婪):
JavaScript 正则量词默认采用贪婪匹配(Greedy),即在满足匹配规则的前提下,尽可能多地吞入字符。如果在量词后面紧跟一个问号 ?,该量词即转变为惰性匹配(Lazy / Non-greedy),改为尽可能少地吞入字符。
const html = "<div>First</div><div>Second</div>";

// 默认贪婪匹配:.* 会一直匹配到最后一个 >
const greedyReg = /<div>.*<\/div>/;
console.log(html.match(greedyReg)[0]);
// 输出:"<div>First</div><div>Second</div>"

// 惰性匹配:.*? 只要遇到第一个 </div> 便立即停止
const lazyReg = /<div>.*?<\/div>/;
console.log(html.match(lazyReg)[0]);
// 输出:"<div>First</div>"
4. 边界断言与锚点(Boundaries)
边界符号本身不消耗字符,仅用于断言匹配发生的位置:
^:匹配输入字符串的起始位置。在多行模式(m标志)下,还匹配换行符$:匹配输入字符串的结束位置。在多行模式下,还匹配换行符之前的行尾。:匹配单词边界,即\w字符与\W字符或字符串首尾之间的过渡位置。例如/cat/匹配独立的单词cat,不会匹配caterpillar或bobcat。\B:匹配非单词边界,即前后均为单词字符或前后均为非单词字符的位置。
5. 分组、捕获与分支选择(Groups & Alternation)
通过圆括号 (...) 可以对子表达式进行逻辑组合,并实现数据捕获:
// 1. 捕获括号:自动按顺序编号为 $1, $2
const dateStr = "2026-11-18";
const dateReg = /(\d{4})-(\d{2})-(\d{2})/;
const match = dateStr.match(dateReg);
console.log(match[1]); // "2026" (分组1)
console.log(match[2]); // "11"   (分组2)
console.log(match[3]); // "18"   (分组3)

// 2. 非捕获括号 (?:...):仅用于限定范围或重复,不保存捕获结果,提升性能
const techReg = /(?:http|https):\/\/[\w.-]+\/;

// 3. 命名捕获组 (?<name>...):ES2018 引入,增强语义化
const namedReg = /(?<year>\d{4})-(?<month>\d{2})-(?<day>\d{2})/;
const res = namedReg.exec(dateStr);
console.log(res.groups.year);  // "2026"
console.log(res.groups.month); // "11"

// 4. 分支选择 | :表示逻辑“或”
const extReg = /\.(png|jpe?g|gif|webp)$/i; // 匹配常见图片后缀
三、常用修饰符(Flags)功能说明
修饰符用于改变正则表达式的全局搜索规则与字符匹配模式,可以组合使用:
| 修饰符 | 属性名称 | 作用说明 | 典型应用场景 |
|---|---|---|---|
g |
global |
全局匹配。找到所有符合条件的子串,而不是在找到第一个匹配后立即停止。 | 文本中全局查找、批量统计与全量替换 |
i |
ignoreCase |
忽略大小写。匹配时不区分大写字符与小写字符。 | 用户检索输入匹配、协议头匹配 |
m |
multiline |
多行模式。使 ^ 与 $ 除了匹配首尾外,还能匹配每一行的行首与行尾。 |
多行日志分析、逐行配置文件解析 |
s |
dotAll |
点号全匹配模式(ES2018)。允许元字符 . 匹配包括换行符在内的任意字符。 |
跨多行的 HTML 标签内容提取 |
u |
unicode |
Unicode 模式。正确处理超过 |
包含多语言字符集、Emoji 文本校验 |
y |
sticky |
粘滞模式。强制从 lastIndex 指定的索引位置精确开始匹配,若当前位置不匹配则直接失败。 |
编写词法分析器(Lexer / Tokenizer) |
四、正则执行方法与全局修饰符 lastIndex 有状态陷阱
在 JavaScript 中执行正则匹配,既可以通过 RegExp 自身原型方法,也可以通过 String 原型方法配合完成:
- 正则方法:
reg.test(str)返回布尔值;reg.exec(str)返回详细匹配结果数组或null。 - 字符串方法:
str.match(reg)、str.matchAll(reg)、str.search(reg)、str.replace(reg, ...)、str.split(reg)。
深入剖析:lastIndex 有状态陷阱
在实际业务开发中,开发者经常遇到一个经典而诡异的 Bug:“同一个正则表达式实例,对完全相同的合法字符串执行 test(),第一次返回 true,第二次却返回 false,第三次又变成 true。”
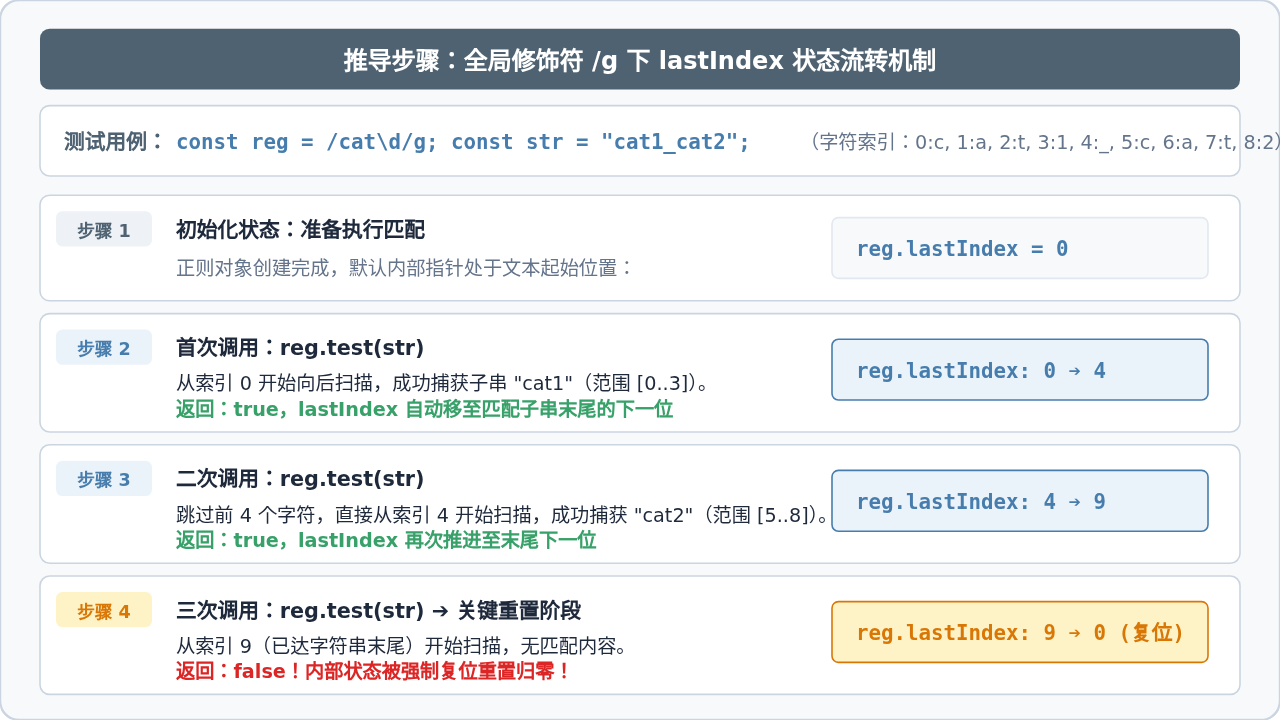
这个现象的根本原因在于:当正则表达式启用了 g(全局)或 y(粘滞)修饰符时,该正则实例会变成有状态对象(Stateful),并在其实例属性 lastIndex 中记录上一次匹配成功结束后的下一个字符索引位置。
// 错误示范:在模块顶层定义带 /g 的共享正则对象用于校验
const phoneValidator = /^1[3-9]\d{9}$/g; // 携带了全局修饰符 g

console.log(phoneValidator.test("13800138000")); // 第 1 次执行:true
console.log("当前 lastIndex:", phoneValidator.lastIndex); // 输出:11

console.log(phoneValidator.test("13800138000")); // 第 2 次执行:false!
console.log("重置后 lastIndex:", phoneValidator.lastIndex); // 输出:0

console.log(phoneValidator.test("13800138000")); // 第 3 次执行:true
执行机制与流转剖析:
- 首次调用:
lastIndex初始为 0。正则从索引 0 开始检查字符串"13800138000",校验成功,返回true。此时引擎将lastIndex更新为匹配文本末尾后的位置(即 11)。 - 二次调用:再次传入相同的字符串时,由于携带了
g标志,引擎不再从头匹配,而是强制从lastIndex = 11(即字符串末尾之后)开始匹配。此时已无字符可供匹配,因此校验直接失败返回false。同时,根据规范,匹配失败后引擎会自动将lastIndex重置为 0。 - 三次调用:此时
lastIndex已回到 0,匹配再次成功返回true。这种忽真忽假的交替现象在表单验证或接口权限校验中极难排查。
解决方案与黄金守则:
- 格式校验绝不加
g:仅用于test()校验格式完整性的正则表达式(如手机号、邮箱、身份证),严禁添加g修饰符。无g修饰符的正则始终从索引 0 开始匹配,不记录也不依赖lastIndex。 - 遍历提取优先选用
matchAll:需要提取字符串中所有匹配项及其捕获组时,推荐直接使用现代 ES2020 的str.matchAll(reg)。它返回一个不可变的迭代器,每次返回独立的匹配详情对象,避免手动维护while ((match = reg.exec(str)) !== null)带来的死循环或状态残留风险。
五、实战选型与开发决策指南
为了在实际开发中写出既高效又健壮的正则表达式代码,下方的决策路线图梳理了从模式设计、创建方式到 API 调用的完整思考链路:
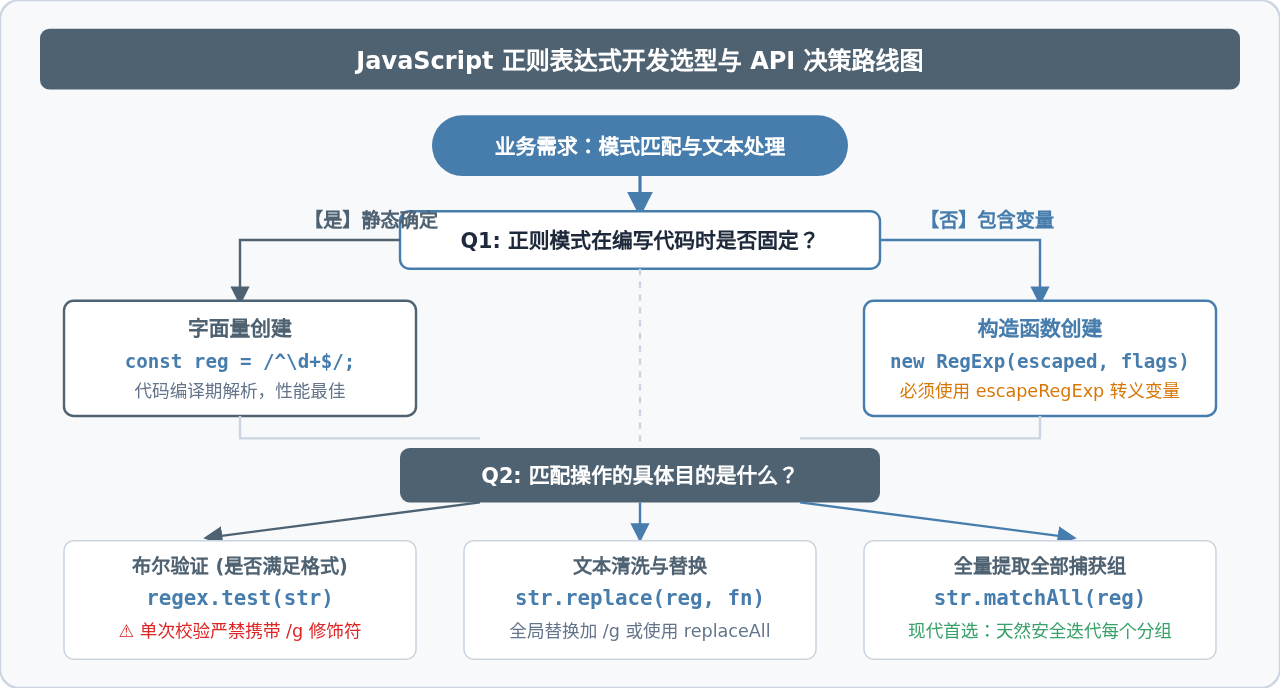
常用场景核心代码模板
// 场景 1:精准手机号验证(纯字面量,无状态)
const isPhoneNumber = (val) => /^1[3-9]\d{9}$/.test(val);

// 场景 2:安全动态敏感词脱敏替换(构造函数 + 安全转义 + 全局替换)
function maskSensitiveWords(text, keywords) {
  if (!keywords || keywords.length === 0) return text;
  // 先转义保留字符,再通过管道符 | 组合为多选分支
  const escapedList = keywords.map(k => escapeRegExp(k));
  const reg = new RegExp(escapedList.join("|"), "gi");
  return text.replace(reg, (match) => "*".repeat(match.length));
}

const comment = "Please visit http://test.com or call me.";
const filtered = maskSensitiveWords(comment, ["http://test.com", "call"]);
console.log(filtered);
// 输出:"Please visit *************** or **** me."

// 场景 3:全量提取 URL Query 键值对(matchAll 现代安全迭代)
function parseQueryParams(queryString) {
  const queryReg = /(?<key>[^&=?]+)=(?<val>[^&]+)/g;
  const params = {};
  for (const match of queryString.matchAll(queryReg)) {
    const { key, val } = match.groups;
    params[decodeURIComponent(key)] = decodeURIComponent(val);
  }
  return params;
}

const url = "https://api.example.com/search?keyword=javascript&page=1&order=desc";
console.log(parseQueryParams(url));
// 输出:{ keyword: "javascript", page: "1", order: "desc" }
结语与总结:
JavaScript 正则表达式的威力在于简洁而严密的规则描述。在日常编码中,牢记“静态模式优先用字面量,动态拼接必用构造函数并配合转义”的原则;同时警惕全局匹配
g 带来的 lastIndex 游标状态流转。结合 matchAll 等现代标准 API,便能让正则表达式成为前端数据处理与表单校验中稳定可靠的高效利器。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章