
深入解析在 JavaScript 中使用 for...of 正确遍历字符串字符的方法、底层机制与避坑实践,彻底解决传统下标索引导致的生僻字及 Emoji 截断乱码问题。

当前位置:首页 > JavaScript 基础 > 正文
JS中for...of怎么正确遍历字符串字符?
作者:函数茶馆
时间:2026-11-20
浏览:262
文章目录
在 JavaScript 中,正确遍历字符串字符的最直接方式是使用
for (const char of str)。与传统的基于索引的 for 循环或 str.split('') 不同,for...of 内部原生遵循 ECMAScript 迭代协议,能够自动按 Unicode 码点(Code Point)解构字符串,完整保留生僻字(如“𠮷”)与各类 Emoji 等 4 字节代理对字符,彻底杜绝半字符乱码。
一、为什么常规遍历方式容易出错?
在日常开发中,许多初学者习惯使用普通的 for (let i = 0; i < str.length; i++)、str.charAt(i) 或 str.split('') 来拆分和遍历字符串。对于纯英文字母和基本汉字,这种方式看似能够正常工作,但一旦字符串中出现 Emoji 表情、生僻字、数学特殊符号或特定古籍文字时,程序便会出现截断和乱码。
要理解这个问题的根源,必须了解 JavaScript 底层的字符编码机制。JavaScript 诞生于 1995 年,其字符串在内存中始终采用 UTF-16 编码格式 存储。在 UTF-16 规范中,最小的存储单元是 16 位的二进制值,称为码元(Code Unit)。
- 基本多语言平面(BMP)字符:编码范围在
U+0000至U+FFFF之间,包括英文字母、数字和绝大部分常用汉字。每个字符恰好占用 1 个 16 位码元(2 个字节)。 - 辅助平面(Supplementary Planes)字符:编码范围在
U+010000至U+10FFFF之间,包括 Emoji 表情(如“😊”、“🚀”)以及生僻汉字(如“𠮷”)。1 个 16 位码元无法容纳这些字符,因此 UTF-16 采用一对连续的 16 位码元共同表示一个字符,这被称为代理对(Surrogate Pair),分为高位代理(0xD800 ~ 0xDBFF)和低位代理(0xDC00 ~ 0xDFFF)。
⚠️ 经典遍历的缺陷根源
字符串的 .length 属性与 str[i] 索引访问反映的从来不是“字符数”,而是底层的“UTF-16 码元数”。当遇到由 4 字节代理对组成的字符时,传统循环会将其当作 2 个独立的字符分别读取,从而将完整的码点拦腰截断为两个不具备独立渲染语义的孤立代理项。
// 传统遍历出现的截断示例
const str = "Hi! 𠮷😊";

console.log("str.length:", str.length);
// 输出 7('H','i','!' 占 3 个,'𠮷' 占 2 个,'😊' 占 2 个)

for (let i = 0; i < str.length; i++) {
  console.log(`下标 ${i}:`, str[i]);
}
// 实际输出:
// 下标 0: H
// 下标 1: i
// 下标 2: !
// 下标 3: \uD842 (孤立高位代理,显示为乱码或空白)
// 下标 4: \uDFB7 (孤立低位代理,显示为乱码或空白)
// 下标 5: \uD83D (孤立高位代理)
// 下标 6: \uDE0A (孤立低位代理)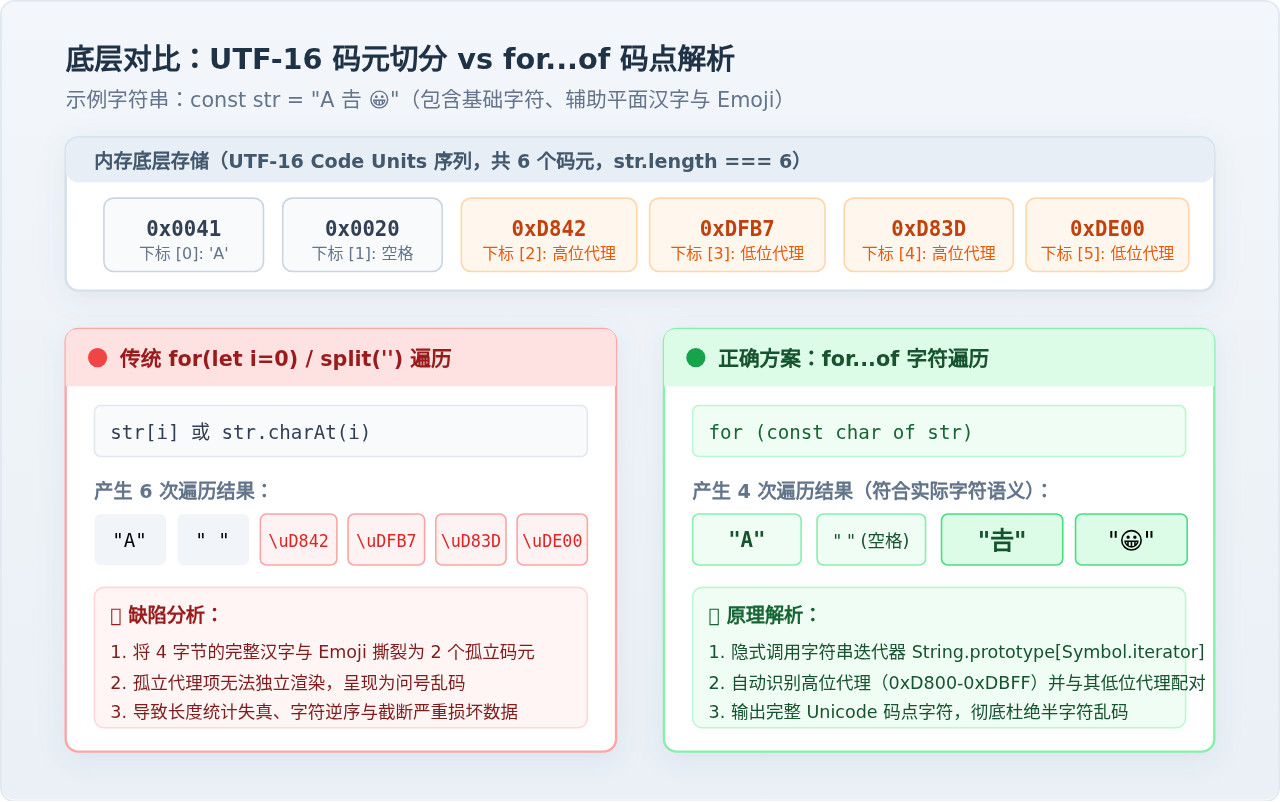
二、for...of 的正确使用方法与执行机制
为了解决编码截断问题,ECMAScript 2015(ES6)正式引入了 for...of 语法以及迭代器协议(Iteration Protocol)。JavaScript 中的 String 原型对象内置实现了 [Symbol.iterator] 方法,这使得字符串本身就是一个合法的可迭代对象(Iterable)。
1. 标准使用语法
直接在 for...of 语句中声明变量接收字符即可。语法干净直观,无需做任何额外的参数配置:
// 正确遍历字符串中的每一个 Unicode 字符
const text = "Hi! 𠮷😊";

for (const char of text) {
  console.log(char);
}

// 运行结果(完整按字符输出,共 5 个):
// 'H'
// 'i'
// '!'
// '𠮷'
// '😊'
2. 内部迭代状态机解析
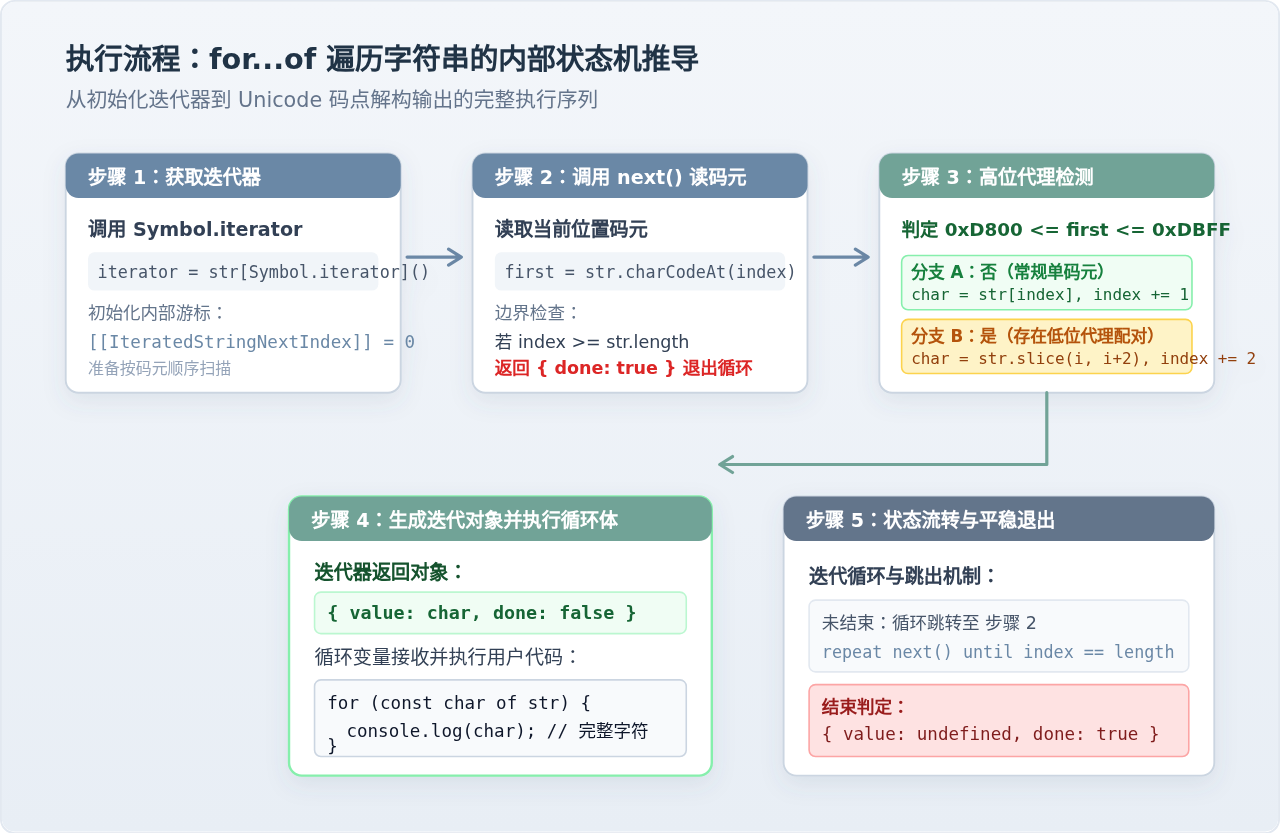
当执行 for (const char of str) 时,JavaScript 引擎并非执行机械的下标自增,而是按如下规范步骤流转:
- 创建迭代器对象:引擎隐式调用
str[Symbol.iterator](),生成一个专属于当前字符串的内置StringIterator实例,并在内部将游标索引重置为0。 - 按码元探测:每次迭代自动调用
iterator.next()。迭代器读取游标处的首个 UTF-16 码元。 - 代理对智能判定:
- 如果该码元的十六进制值不在高位代理区间(
0xD800 ~ 0xDBFF),说明该字符为单码元字符,迭代器截取该 1 个码元作为结果,游标后移 1 位。 - 如果该码元属于高位代理,且紧随其后的下一个码元属于低位代理(
0xDC00 ~ 0xDFFF),迭代器会自动将这两个码元作为一个整体切出(4 字节合成码点),游标后移 2 位。
- 如果该码元的十六进制值不在高位代理区间(
- 交付循环体:封装为
{ value: char, done: false },将完整字符赋给循环头部的char变量供业务逻辑使用。 - 平稳结束:当游标到达字符串末尾时,返回
{ value: undefined, done: true },退出循环。
三、如何在 for...of 遍历中获取字符索引?
在实际业务中,我们往往既需要拿到完整字符,又需要知道该字符对应的序号(例如高亮第 N 个字符、限制输入长度等)。此时读者会自然产生一个疑问:数组可以使用 arr.entries() 同时解构 [index, item],字符串能直接这样用吗?
⚠️ 常见报错避坑
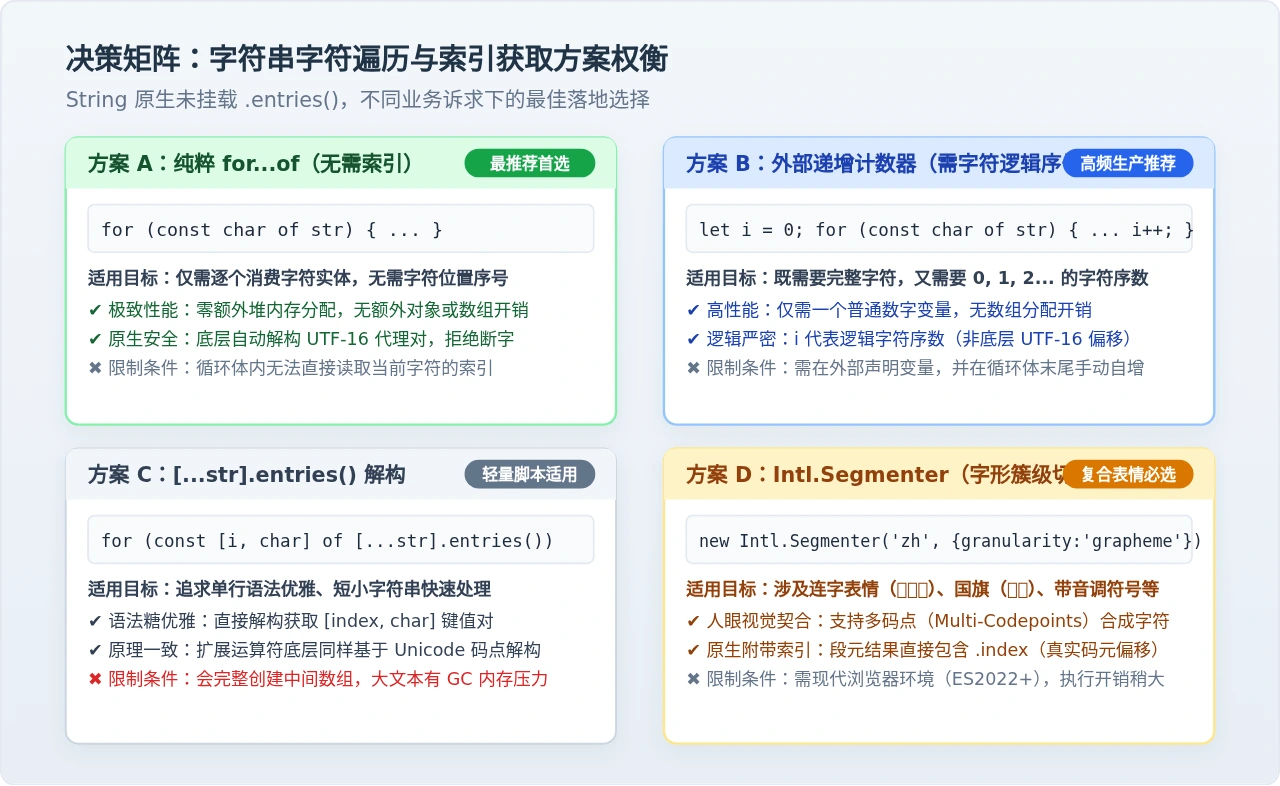
直接执行 for (const [i, char] of str.entries()) 会立即抛出 TypeError: str.entries is not a function。因为 String.prototype 并没有定义 .entries() 方法,entries() 是 Array、Map、Set 等集合类型的专有 API。
针对“既要完整字符,又要索引”的场景,推荐以下三种实用解法:
解法一:维护外部局部计数器(性能最佳,推荐生产使用)
在循环外部声明一个递增的索引变量。这种方式没有任何多余的中间对象生成,内存开销为零,在大文本或高频循环中性能最为优异。
const message = "A𠮷B😊";
let index = 0;

for (const char of message) {
  console.log(`字符序号: ${index}, 内容: ${char}`);
  index++;
}

// 运行结果:
// 字符序号: 0, 内容: A
// 字符序号: 1, 内容: 𠮷
// 字符序号: 2, 内容: B
// 字符序号: 3, 内容: 😊
解法二:借助扩展运算符或 Array.from 转为数组迭代(代码简洁)
如果追求代码书写的简短,可以利用数组扩展运算符 [...str] 或 Array.from(str)。由于数组扩展运算符和 Array.from 内部同样严格遵循字符串的迭代协议,因此生成的字符数组天然保证代理对完整。随后即可直接调用数组的 .entries() 方法:
const message = "A𠮷B😊";

// 使用 [...str].entries() 进行解构遍历
for (const [index, char] of [...message].entries()) {
  console.log(`[${index}] -> ${char}`);
}
注意:该方法会产生一个临时数组,若字符串长度达到兆字节(MB)级别,会带来额外的堆内存消耗和垃圾回收(GC)开销;常规中短文本则可放心使用。
四、进阶边界:当遇到“字形簇”(Grapheme Clusters)时的局限
掌握了 for...of 之后,是否就能万无一失地应对所有字符场景?答案是:绝大多数场景已经足够,但对于复杂的复合字形(字形簇),仍需了解其边界。
Unicode 标准中,“码点(Code Point)”并不完全等同于“人眼可见的一个字符”。例如:
- 带肤色修饰符的 Emoji:如“👍🏽”是由大拇指码点
U+1F44D和肤色码点U+1F3FD组合而成的。 - 零宽连字符(ZWJ)组合 Emoji:如家庭表情“👨👩👧👦”实际上是由“男”、“女”、“女孩”、“男孩”4 个独立码点通过看不见的零宽连字符(
\u200D)连接起来的复合图案。 - 国旗符号:如中国国旗“🇨🇳”由两个区域指示符号码点
U+1F1E8与U+1F1F3组合而成。
for...of 的处理粒度是单个 Unicode 码点。因此,遇到上述复合表情时,for...of 会将其拆为多个构成码点。
💡 终极方案:Intl.Segmenter
在现代 JavaScript(ECMAScript 2022+)中,若需要严格按照人眼感知的“独立字符”切分文本,可以使用国际化分词器 Intl.Segmenter,设置 granularity: 'grapheme':
const complexStr = "👨👩👧👦 🇨🇳 é";
// 创建字形簇级别的分割器
const segmenter = new Intl.Segmenter("zh", { granularity: "grapheme" });
for (const { segment, index } of segmenter.segment(complexStr)) {
console.log(`起始偏移: ${index}, 视觉字符: "${segment}"`);
}
// 运行结果:
// 起始偏移: 0, 视觉字符: "👨👩👧👦" (完整保留组合家庭表情,不被拆散)
// 起始偏移: 11, 视觉字符: " "
// 起始偏移: 12, 视觉字符: "🇨🇳" (完整保留国旗)
// 起始偏移: 16, 视觉字符: " "
// 起始偏移: 17, 视觉字符: "é" (字母与重音符被视为单一视觉字形)五、全景对比与技术选型总结
为了便于在工程实践中快速做出正确决策,下表总结了 JavaScript 中四种主流字符串遍历方式的关键特性与适用场景:
| 遍历方式 | 底层粒度 | 代理对安全(Emoji/生僻字) | 复合表情安全(字形簇) | 内存消耗 | 推荐使用场景 |
|---|---|---|---|---|---|
for (let i = 0; ...) |
16位 UTF-16 码元 | ❌ 截断乱码 | ❌ 截断乱码 | 极低 | 明确已知仅含 ASCII 字符的高性能底层算法 |
str.split('') |
16位 UTF-16 码元 | ❌ 截断乱码 | ❌ 截断乱码 | 高(生成数组) | 不推荐在任何包含 Unicode 的场景中使用 |
for...of |
32位 Unicode 码点 | ✅ 完美支持 | ⚠️ 按单码点输出 | 极低(零额外分配) | 日常开发默认首选,兼具安全性与性能 |
Intl.Segmenter |
视觉字形簇(Grapheme) | ✅ 完美支持 | ✅ 完美支持 | 中等 | 富文本编辑、字数统计限制、复杂 Emoji 处理 |
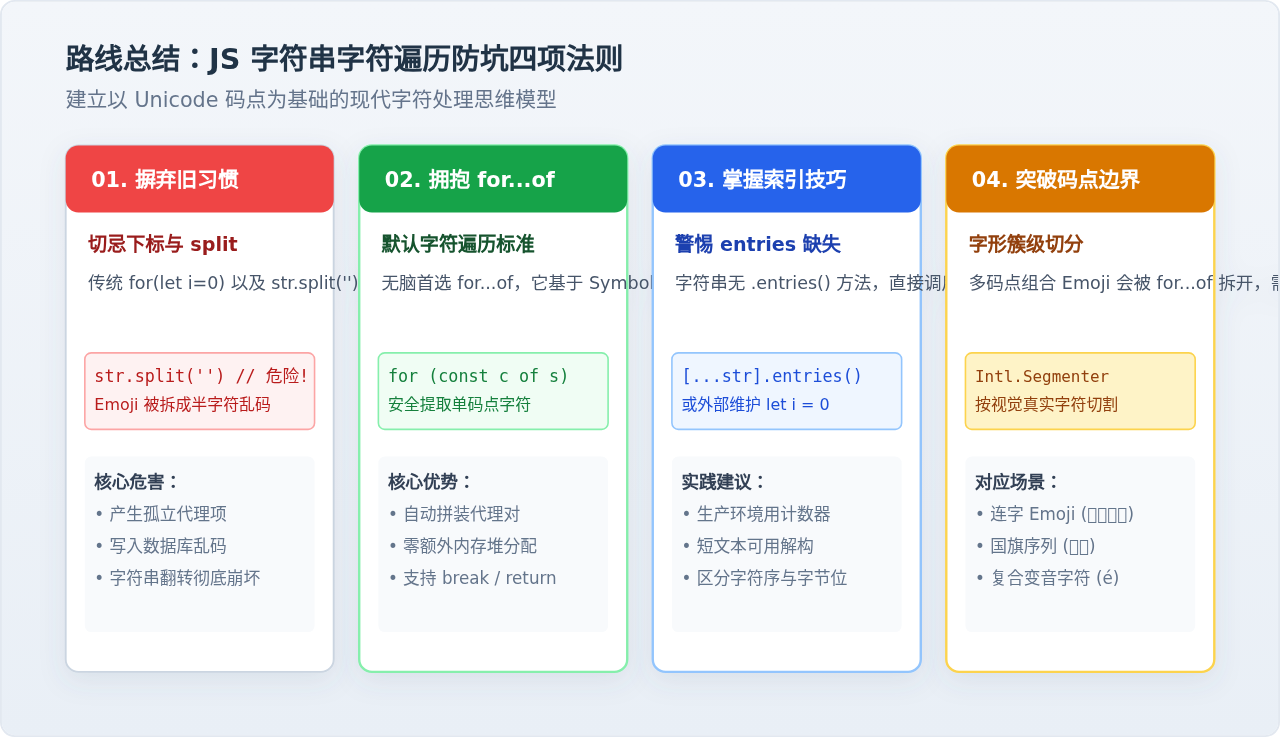
综上所述,在 JavaScript 中遍历字符串字符,最稳妥、规范且性能优异的通用做法就是直接使用 for (const char of str)。它通过 ECMAScript 原生迭代器机制抹平了 UTF-16 底层码元的复杂细节,从根本上杜绝了非 ASCII 字符的截断隐患;遇到复杂字符排版与计数需求时,辅以 Intl.Segmenter 即可构筑健壮的字符串处理链路。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章