
深入讲解JavaScript中生成单个及多个随机字母的基础代码实现方案,对比字符池查表法与ASCII码计算法的底层机制,提供开箱即用的实用代码与避坑指南。

当前位置:首页 > JavaScript 基础 > 正文
JS生成随机字母的基础代码实现
作者:纸飞机
时间:2026-11-19
浏览:341
文章目录
在前端开发或 Node.js 服务端场景中,生成随机字母是一项高频出现的通用基础需求。无论是用于构造图形验证码、生成前端临时占位符、模拟随机测试数据,还是为动态元素分配不重复的临时前缀,都需要简洁可靠的生成机制。实现这一目标的核心本质只有两步:首先借助随机源生成受控范围内的离散整数,其次将该整数映射到目标英文字符。本文将针对“字符池查表法”与“ASCII 编码计算法”两种最基础、最高效的代码实现方式展开详细拆解,帮助读者全面掌握其运行原理、实现代码与避坑要点。
一、理解核心转换流程:从浮点数到离散字符
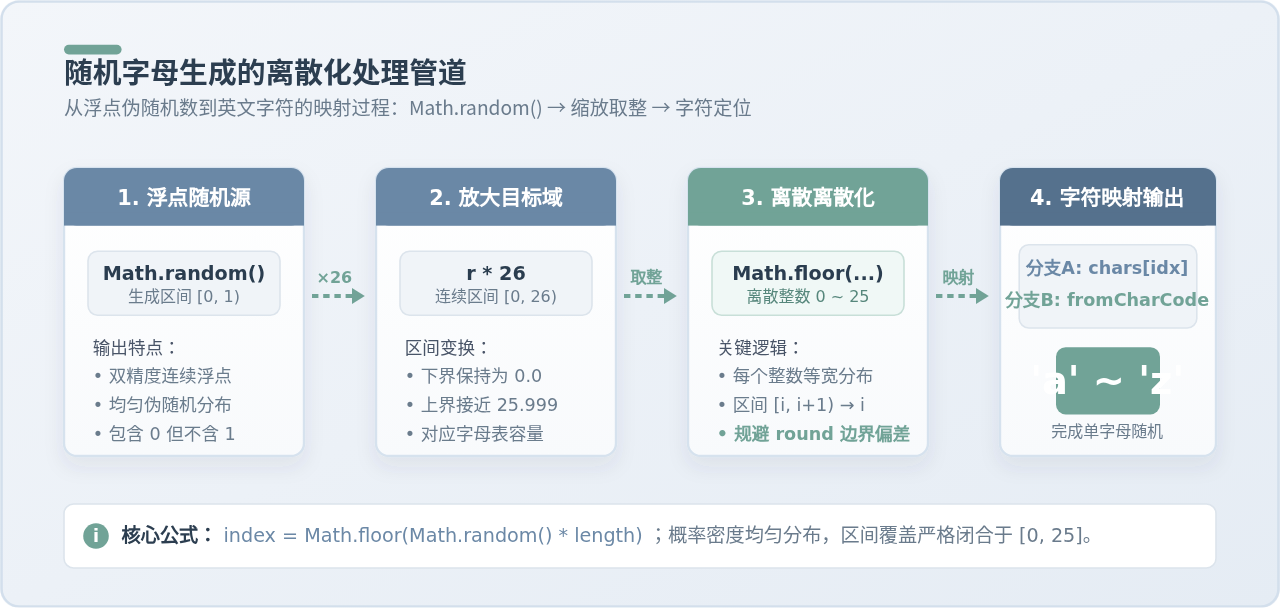
在编写具体代码前,必须理清 JavaScript 原生方法 Math.random() 的输出规律。Math.random() 返回一个伪随机浮点数,其数学区间为 [0, 1)——即大于等于 0 且严格小于 1。
英文基础字母表(如英文字母 a-z)包含 26 个不同字符。为了从连续的浮点数中公平选出一个字母,需要经过三步数学转换:
- 线性放大区间:将
Math.random()乘以字母总量26,取值范围变为[0, 26)。此时最小值为 0.0,最大值无限接近但永远不等于 26.0。 - 向下取整离散化:使用
Math.floor()抹除小数部分。此时[0, 1)的数值转为 0,[1, 2)转为 1……直到[25, 26)转换为 25。整型结果精确、等概率地落入整数区间[0, 25]。 - 字符定位输出:利用得到的索引数字,通过数组/字符串索引查表或字符编码换算,最终得到对应字母。
为什么必须使用 Math.floor 而不能使用 Math.round?
很多初学者会误用 Math.round() 进行四舍五入。如果使用 Math.round(Math.random() * 25),获得 0 的区间仅为 [0, 0.5)(跨度为 0.5),而获得中间数字(例如 1)的区间为 [0.5, 1.5)(跨度为 1.0)。这将导致两端边界数字 0 和 25(即字母 'a' 和 'z')出现的概率只有其它中间字母的一半,从而破坏了随机分布的均匀性。因此,在做随机数离散映射时,必须统一采用 Math.floor() 配合左闭右开区间。
二、方案一:字符池查表法(直观、通用且可定制)
字符池查表法是实际项目中使用最广泛的实现方式。其做法是先将所有允许抽取的字符声明为一个常量字符串,然后将生成的随机整数作为下标从字符串中读取字符。
1. 生成单个小写字母的基础代码
在任意现代浏览器控制台或 Node.js 环境中执行如下代码,即可获取单个随机小写字母:
// 基础实现:生成单个小写字母
function getRandomLowerLetter() {
  const chars = 'abcdefghijklmnopqrstuvwxyz';
  const randomIndex = Math.floor(Math.random() * chars.length);
  return chars[randomIndex];
}

// 运行调用示例
console.log(getRandomLowerLetter()); // 示例输出:"k"
console.log(getRandomLowerLetter()); // 示例输出:"p"
代码中的 chars.length 动态提供了字符池长度(此处为 26)。Math.floor(Math.random() * chars.length) 产出的范围是 0 到 25,直接对应 chars 的合法索引。
2. 字符池模式的扩展:灵活过滤混淆字符与混合大小写
字符池查表法最大的优势在于极高的可扩展性。例如在生成用户人机验证码时,字母 O、o 与数字 0,字母 l、I 与数字 1 极易让用户看错产生输入错误。此时只需在字符池中直接移除这些混淆字符即可,底层算法完全无需调整:
// 进阶应用:排除易混淆字符的字母池
function getReadableRandomLetter() {
  // 已显式剔除容易混淆的 'i', 'l', 'o'
  const readableChars = 'abcdefghjkmnpqrstuvwxyzABCDEFGHJKLMNPQRSTUVWXYZ';
  const randomIndex = Math.floor(Math.random() * readableChars.length);
  return readableChars[randomIndex];
}

console.log(getReadableRandomLetter()); // 示例输出:"M"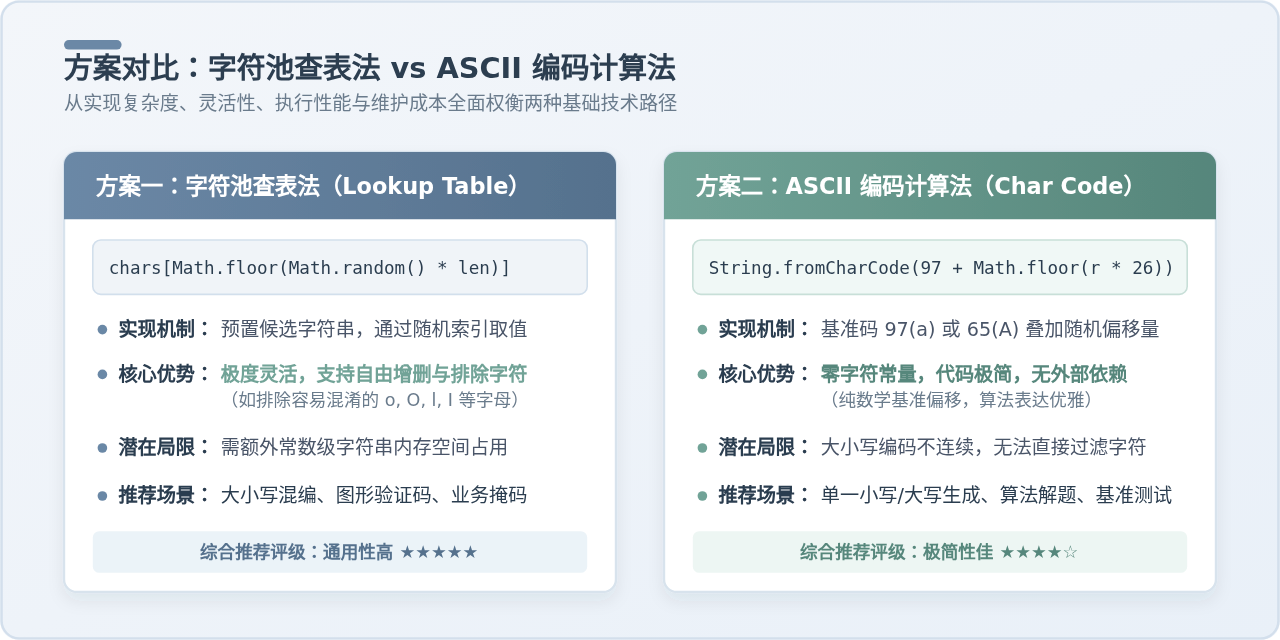
三、方案二:基于 ASCII 码直接计算(零依赖与纯算法实现)
如果业务场景仅需要纯小写字母或纯大写字母,且希望代码更加紧凑、无需在内存中维护字符常量池,可以直接利用 ASCII / Unicode 编码表的连续特性。
1. 字母在 ASCII 表中的编码规律
在 ASCII 字符编码标准中,英文字母的编码值是连续递增的:
- 大写字母
'A'到'Z':编码值从65到90(共 26 个)。 - 小写字母
'a'到'z':编码值从97到122(共 26 个)。
JavaScript 提供了原生方法 String.fromCharCode(code),能够根据传入的数值编码直接转换出对应的字符。
2. 基础代码实现
// 方案 2A:基于 ASCII 码生成单个随机小写字母 (97 ~ 122)
function getCharByAsciiLower() {
  const baseCode = 97; // 'a' 的 ASCII 码
  const offset = Math.floor(Math.random() * 26);
  return String.fromCharCode(baseCode + offset);
}

// 方案 2B:基于 ASCII 码生成单个随机大写字母 (65 ~ 90)
function getCharByAsciiUpper() {
  const baseCode = 65; // 'A' 的 ASCII 码
  const offset = Math.floor(Math.random() * 26);
  return String.fromCharCode(baseCode + offset);
}

console.log(getCharByAsciiLower()); // 示例输出:"e"
console.log(getCharByAsciiUpper()); // 示例输出:"W"
这种方法通过基准码 97 或 65 加上 0 ~ 25 的随机偏移量,直接通过底层字符映射获得结果,执行速度快且代码极短。然而它的局限在于:ASCII 表中大写字母(90 结束)与小写字母(97 开始)之间夹杂着 [、\、]、^、_、` 等 6 个标点符号,编码不连续。若要同时支持大小写混合,就需要做二选一分支判断,写法反而不如字符池查表法简练。
四、生成指定长度的随机字母字符串
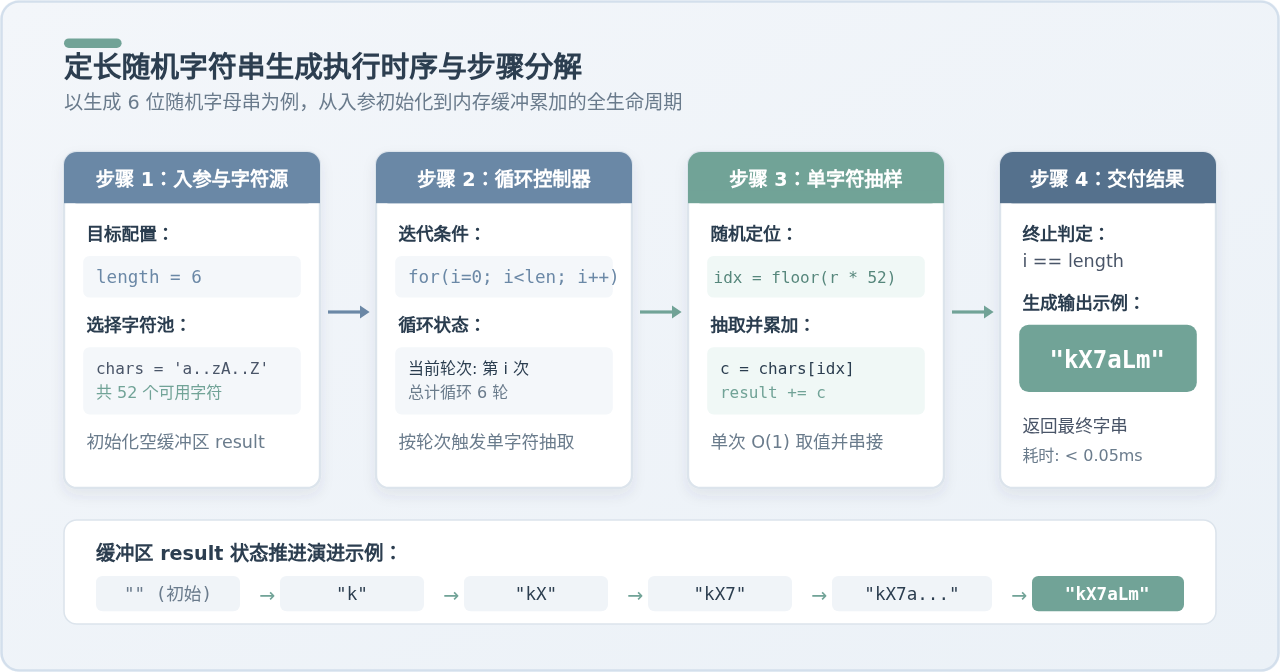
在绝大多数开发需求中,我们需要的是一个定长的随机字符串(例如 6 位验证码、8 位随机文件名后缀)。通过将单字符抽取逻辑放入循环中累加,即可实现多位字母串的拼接。
1. 工业级通用实现:支持长度与模式配置
下面是一个封装完备、无外部依赖的工具函数,支持指定长度,并允许通过参数自由切换纯小写、纯大写或大小写混编模式:
/**
 * 生成指定长度的随机字母字符串
 * @param {number} length - 生成的字符串长度,默认为 8
 * @param {'lower' | 'upper' | 'mixed'} mode - 字母模式,支持 'lower'(小写)、'upper'(大写)、'mixed'(混编)
 * @returns {string} 随机字母字符串
 */
function generateRandomLetters(length = 8, mode = 'lower') {
  // 1. 根据模式准备字符集合
  let charset = 'abcdefghijklmnopqrstuvwxyz';
  if (mode === 'upper') {
    charset = 'ABCDEFGHIJKLMNOPQRSTUVWXYZ';
  } else if (mode === 'mixed') {
    charset = 'abcdefghijklmnopqrstuvwxyzABCDEFGHIJKLMNOPQRSTUVWXYZ';
  }

  // 2. 循环抽取单字符并拼接到结果缓冲区
  let result = '';
  const charsetLength = charset.length;
  for (let i = 0; i < length; i++) {
    const randomIndex = Math.floor(Math.random() * charsetLength);
    result += charset[randomIndex];
  }

  return result;
}

// 验证调用
console.log(generateRandomLetters(6, 'lower')); // 示例输出:"zkmxpt"
console.log(generateRandomLetters(6, 'upper')); // 示例输出:"VBLRJW"
console.log(generateRandomLetters(10, 'mixed')); // 示例输出:"aKjNwPqXmZ"
2. 现代 ES6+ 语法简洁一行流写法
如果希望在局部函数或精简脚本中使用更函数式的语法,可以结合 Array.from() 实现一行流:
// ES6+ 简写形式:使用 Array.from 配合映射回调
const randomLetterStr = (len = 8) =>
  Array.from({ length: len }, () =>
    'abcdefghijklmnopqrstuvwxyz'[Math.floor(Math.random() * 26)]
  ).join('');

console.log(randomLetterStr(5)); // 示例输出:"tuvwa"
五、常见问题与安全避坑要点
在生成随机字母的代码落地到生产环境前,以下两个常见边界问题需要重点关注:
1. 为什么不能用 Math.round() 或 Math.ceil()?
正如前文分析,Math.floor() 保证了每个整数取值的区间长度严格为 1.0。如果使用 Math.ceil(),产生 0 的几率几乎为零(仅当 Math.random() 精确为 0 时才可能),这会导致第一个字符几乎永远抽不到。因此,随机下标计算的标准范式永远是 Math.floor(Math.random() * length)。
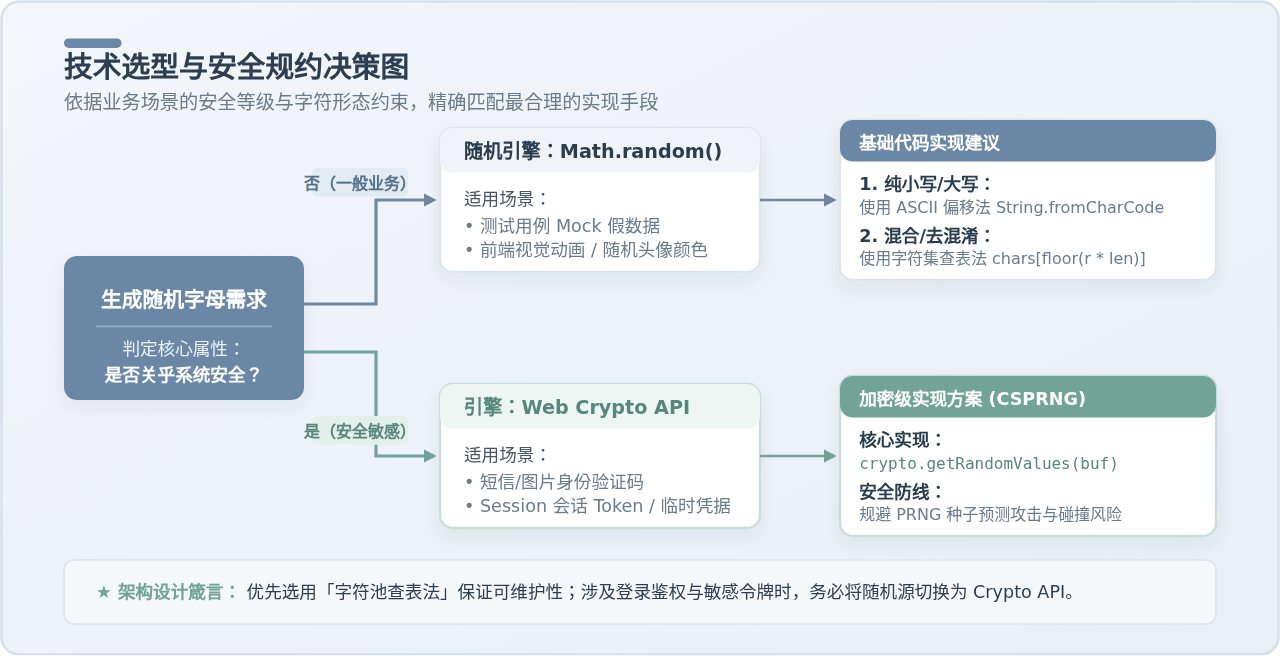
2. 区分业务场景:普通随机与安全加密随机
Math.random() 属于伪随机数生成器(PRNG)。现代 V8 引擎内部采用 xorshift128+ 算法,速度非常快,但在密码学上并不安全。如果攻击者连续观察到足够多的随机输出样本,就有可能反推算法内部状态,从而预测出下一个生成的字母。
因此,在处理以下场景时必须有所区别:
- 允许使用 Math.random() 的场景:前端 UI 动效、测试假数据、日志分组标识符、无需防碰撞的本地组件 ID。
- 严禁使用 Math.random() 的场景:短信验证码、找回密码凭据、用户登录 Session Token、API 访问密钥。
安全敏感场景的替代方案:Web Crypto API
在安全场景下,应使用浏览器及 Node.js 均原生支持的 crypto.getRandomValues()。它由操作系统底层的真随机熵池支持(CSPRNG),不可被数学反推预测:
// 针对安全场景的高强度随机字母生成
function getSecureRandomLetters(length = 16) {
  const chars = 'abcdefghijklmnopqrstuvwxyzABCDEFGHIJKLMNOPQRSTUVWXYZ';
  const array = new Uint32Array(length);
  // 由底层系统加密级伪随机源填充
  window.crypto.getRandomValues(array);

  let result = '';
  for (let i = 0; i < length; i++) {
    result += chars[array[i] % chars.length];
  }
  return result;
}
六、实现总结与选型建议
| 实现方案 | 代码核心 | 主要优势 | 主要限制 | 推荐使用场景 |
|---|---|---|---|---|
| 字符池查表法 | chars[Math.floor(r * len)] |
直观易懂、支持混编、易于剔除混淆字符 | 需要预先定义字符池常量 | 通用业务需求、验证码、可读字符串(首选推荐) |
| ASCII 编码计算法 | String.fromCharCode(97 + offset) |
无需额外常量字符串、内存开销极小 | 大小写编码不连续,字符过滤复杂 | 算法刷题、纯单向字母生成、嵌入式轻量环境 |
| Web Crypto 加密法 | crypto.getRandomValues(buffer) |
具备加密学安全性,不可预测、抗碰撞 | API 稍显冗长,微小性能开销 | 鉴权令牌、敏感验证码、重置密码凭证 |
总体而言,在日常 JavaScript 开发中,字符池查表法是最推荐的默认方案。它不仅逻辑清晰、利于代码审查,而且能够随着业务需求随时增加数字、特殊符号或排除特定歧义字符。只要牢记采用 Math.floor() 确保概率分布均匀,并在安全敏感节点切换至 crypto 引擎,就能稳定高效地满足各类随机字母生成需求。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章