
详细讲解在 JavaScript 中实现字符串数组忽略大小写排序的标准方法。深入分析默认 sort() 机制的成因,提供 localeCompare、Intl.Collator 的标准化代码实现、步骤流程、大数组性能优化及常见边界问题防范。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS字符串排序怎么忽略大小写?
作者:青柠
时间:2026-11-19
浏览:264
文章目录
JavaScript / ECMAScript
实用教程
阅读时间:约 6 分钟
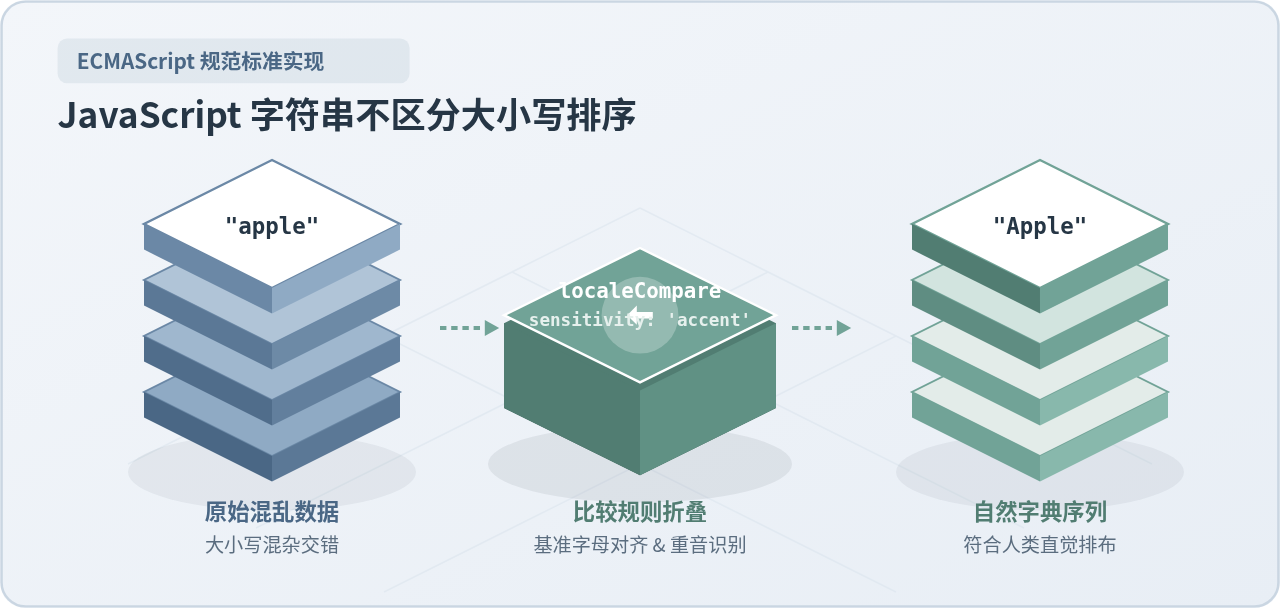
在 JavaScript 中,对包含大小写的字符串数组排序时,最标准且健壮的写法是向排序方法传入自定义比较器,调用
localeCompare 并配置 { sensitivity: 'accent' }。这能将大写和小写字母映射到同一基准权重,直接实现符合人类直觉的字母自然序排序,无需借助多余的字符串转换。
核心一揽子代码:两行搞定排序
如果你希望直接在现有业务中使用,以下两套代码分别适用于“原地修改原数组”与“保持原数组不变”的场景:
1. 保持原数组不变(现代推荐,ES2023)
// 原数组不受任何改动,返回排序后的全新数组
const list = ["banana", "Apple", "cherry", "apple"];

const sorted = list.toSorted((a, b) =>
  a.localeCompare(b, undefined, { sensitivity: 'accent' })
);

console.log(sorted);
// 输出示例: ["apple", "Apple", "banana", "cherry"]
console.log(list);
// 输出示例: ["banana", "Apple", "cherry", "apple"] (原数组维持原貌)
2. 原地修改原数组(兼容旧环境)
// 直接修改 list 数组本身
const list = ["banana", "Apple", "cherry", "apple"];

list.sort((a, b) =>
  a.localeCompare(b, undefined, { sensitivity: 'accent' })
);

console.log(list);
// 输出示例: ["apple", "Apple", "banana", "cherry"]
为什么默认的 sort() 无法忽略大小写?
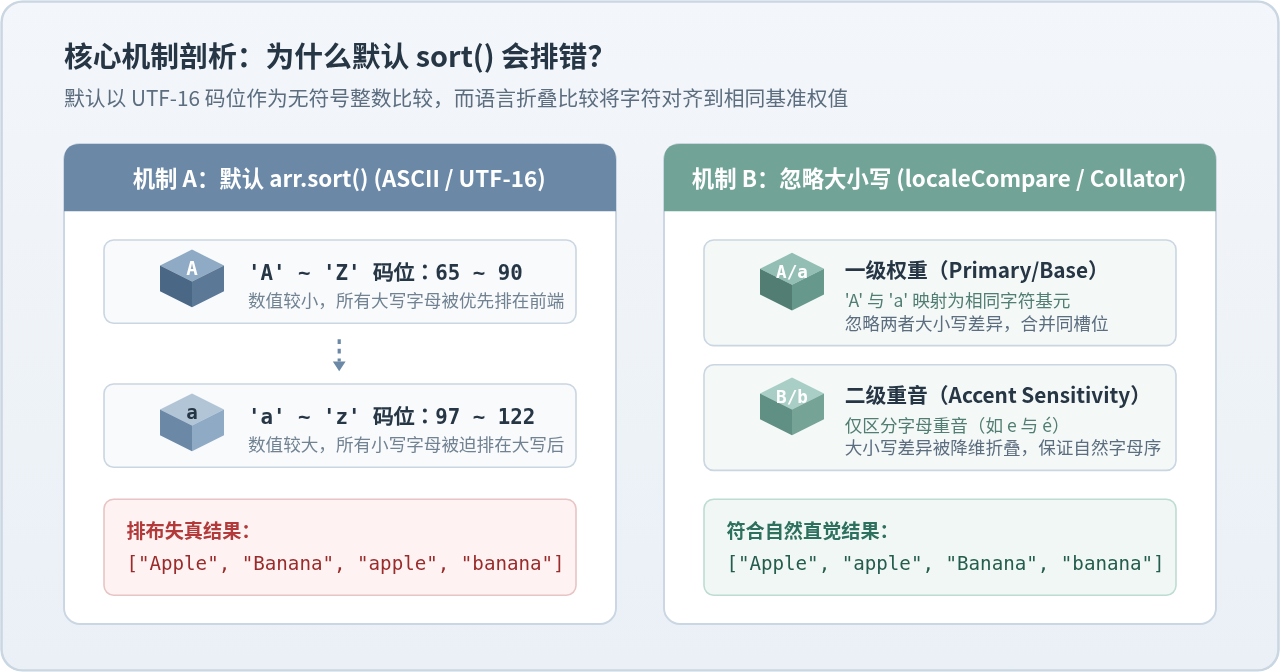
很多初学者会疑惑:为什么调用 list.sort() 时,"Apple" 总是排在 "banana" 前面,甚至排在 "apple" 之前?
这是因为在 JavaScript 的底层规范中,如果不传入比较函数,Array.prototype.sort() 会默认将所有元素转为字符串,并根据各字符的 UTF-16 码位(Code Unit)数值 作为无符号 16 位整数逐位比较:
- 大写英文字母
'A' ~ 'Z'的编码区间是65 ~ 90; - 小写英文字母
'a' ~ 'z'的编码区间是97 ~ 122。
因为 65 小于 97,所以无论单词长度如何,任何以大写字母开头的单词都会排在所有以小写字母开头的单词之前。这就造成了所谓的“大小写字母断层”。
为什么推荐 localeCompare 而非 toLowerCase?
常见的一种替代做法是在比较函数中手动将两个字符串转换为全小写:
// 常见但不完全严谨的写法
list.sort((a, b) => {
  const lowerA = a.toLowerCase();
  const lowerB = b.toLowerCase();
  if (lowerA < lowerB) return -1;
  if (lowerA > lowerB) return 1;
  return 0;
});
虽然这种方法在处理纯 ASCII 英文时看似可用,但在生产环境中并不推荐作为通用方案,主要存在两个明显缺陷:
- 内存与垃圾回收压力:在每次执行比较时,
toLowerCase()都会在内存中开辟空间并生成两个全新的临时字符串。对于 1000 个元素的数组,快速排序或 Timsort 大约会执行数千次比较,频繁创建被丢弃的短生命周期字符串会加重引擎垃圾回收负担。 - 国际化字符与特定语言陷阱:在某些语言环境下(例如土耳其语、德语或带重音的西欧字符),简单的大写转小写规则并不对称。例如土耳其语中字母
I转小写是带点的小写ı,而不是英文字母i;德语双 s(ß)在大小写转换时可能改变字符串长度。而localeCompare依托于 Unicode 排序规则(UCA),能够自然兼容全球字符标准。
深入解析 sensitivity 参数的四个取值
在 a.localeCompare(b, undefined, { sensitivity: '...' }) 中,sensitivity 决定了比对规则的粗细粒度:
'accent':忽略大小写,但区分重音(例如认为a与A相等,但a与á不等)。这是绝大多数“忽略大小写”业务最期望的行为。'base':同时忽略大小写和重音(例如认为a、A、á均处于同一基准层级)。'case':区分大小写,但忽略重音。'variant':全区分(默认值),同时区分字符基准、重音和大小写。
排序实施标准流程
要写出健壮、可维护且符合工程规范的排序代码,建议遵循以下四个关键步骤:
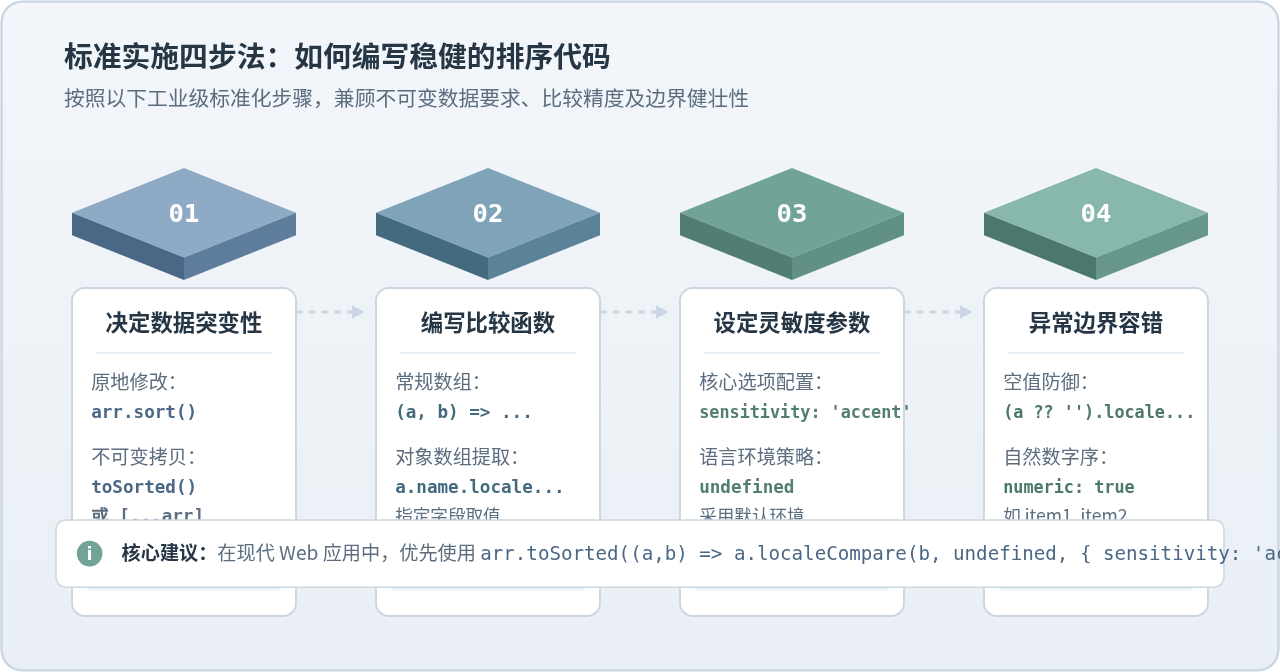
第一步:明确数组修改策略
在现代前端开发(如 React、Vue 等响应式框架)中,直接修改 Props 或 State 中的原数组会破坏单向数据流。如果环境支持 ES2023,优先使用 arr.toSorted();若需兼顾旧版 Node.js 或低版本浏览器,请使用解构运算符浅拷贝后排序:[...arr].sort(...)。
第二步:提取需要比较的字符串字段
实际开发中,数据往往不是扁平的字符串数组,而是对象数组。此时只需从比较入参 a 和 b 中提取对应的属性即可:
const users = [
  { id: 1, name: "bob" },
  { id: 2, name: "Alice" },
  { id: 3, name: "charlie" }
];

const sortedUsers = users.toSorted((a, b) =>
  a.name.localeCompare(b.name, undefined, { sensitivity: 'accent' })
);
// 输出顺序依次为: Alice, bob, charlie
第三步:增加异常值防御保护
在真实业务数据中,某些字符串字段可能为 null、undefined 或数值类型。直接调用 .localeCompare() 会抛出 TypeError: Cannot read properties of undefined 错误。使用空值合并运算符(??)或 String() 强转可以有效规避此问题:
// 健壮的空值防御比较器
const safeSort = (arr) => arr.toSorted((a, b) => {
  const strA = a == null ? '' : String(a);
  const strB = b == null ? '' : String(b);
  return strA.localeCompare(strB, undefined, { sensitivity: 'accent' });
});
大规模数据与高频排序:使用 Intl.Collator 极致提速
当数组元素数量较小(几百条以内)时,直接在回调中调用 a.localeCompare(b, ...) 性能非常充裕。但如果你需要对上万条数据排序,或者该排序函数需要在虚拟长列表滚动中频繁触发,你可能会观察到轻微的掉帧。
其原因在于:每次调用 localeCompare 时,JavaScript 引擎都需要在内部重新解析并校验你传入的配置参数(如 { sensitivity: 'accent' })。在成千上万次迭代中,这个解析开销会被无限放大。
解决方案是预先创建并复用 Intl.Collator 实例:
// 1. 预先创建 Collator 实例(仅初始化一次)
const collator = new Intl.Collator(undefined, { sensitivity: 'accent' });

// 2. 将 collator.compare 作为比较器直接传给 sort
const bigList = ["Zoo", "alpha", "Beta", "apple" /* ... 上万条字符串 */];

// 方式 A:原地排序
bigList.sort(collator.compare);

// 方式 B:不可变排序
const sortedBigList = bigList.toSorted(collator.compare);
在基准测试中,对 50,000 个字符串排序时,复用 Intl.Collator.compare 的耗时通常仅为循环内直接调用 localeCompare 的三分之一甚至四分之一,性能优势非常显著。
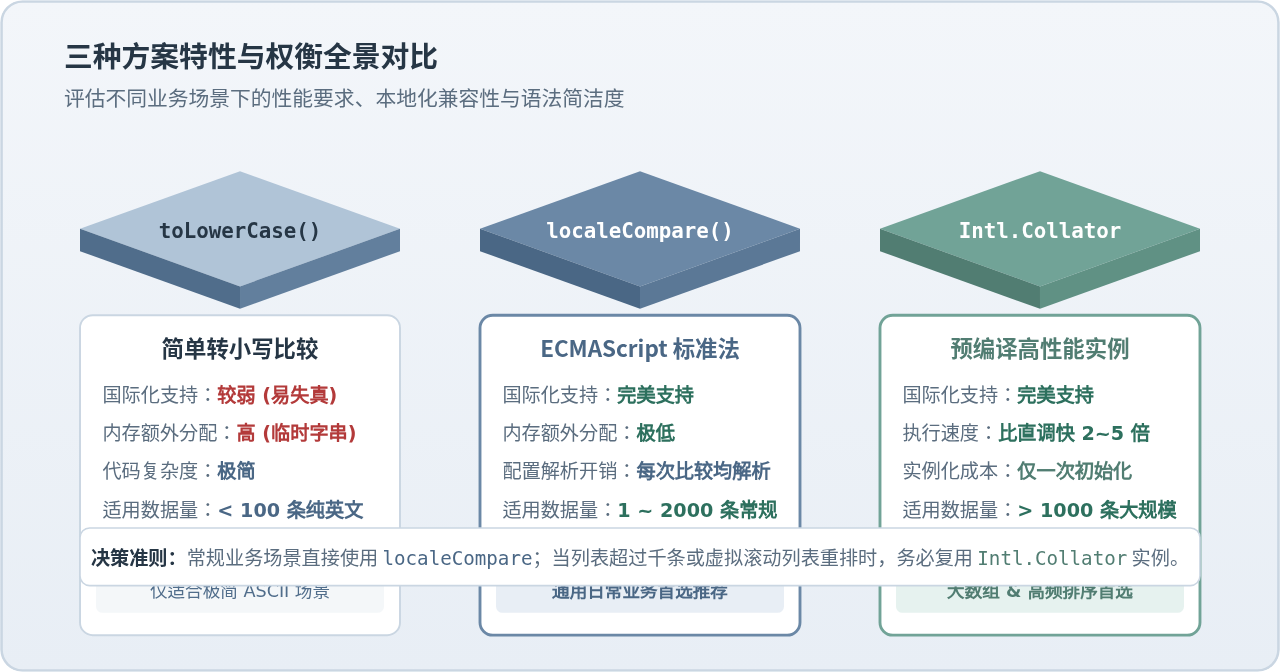
方案特性对比速查表
| 方案名称 | 代码示例 | 国际化正确性 | 内存分配 | 推荐使用场景 |
|---|---|---|---|---|
| toLowerCase | a.toLowerCase().localeCompare(b.toLowerCase()) |
一般(特殊语系易失真) | 每次比较生成新字符串 | 小型、纯 ASCII 简单临时脚本 |
| localeCompare | a.localeCompare(b, undefined, { sensitivity: 'accent' }) |
优(基于 Unicode 标准) | 极低 | 中小型数组(日常业务首选) |
| Intl.Collator | new Intl.Collator(undefined, { sensitivity: 'accent' }).compare |
优(预编译规则配置) | 极低(单例复用) | 海量数据(> 1000条)或高频触发场景 |
进阶需求:包含数字时的自然数排序
在日常业务中,字符串不仅包含大小写,还经常包含序列号,例如 ["file10.txt", "file2.txt", "File1.txt"]。如果只做常规忽略大小写,排出来的顺序会是 "File1.txt"、"file10.txt"、"file2.txt",因为 '1' 小于 '2'。
此时只需在选项中额外追加 numeric: true,即可同时实现忽略大小写与数字自然递增:
const files = ["file10.txt", "File2.txt", "file1.txt"];

files.sort((a, b) => a.localeCompare(b, undefined, {
  sensitivity: 'accent',
  numeric: true
}));

console.log(files);
// 输出示例: ["file1.txt", "File2.txt", "file10.txt"] (1 -> 2 -> 10 自然递增)
选型决策树与总结
针对不同的应用场景,可以通过以下决策路径快速选择最合适的解决方案:
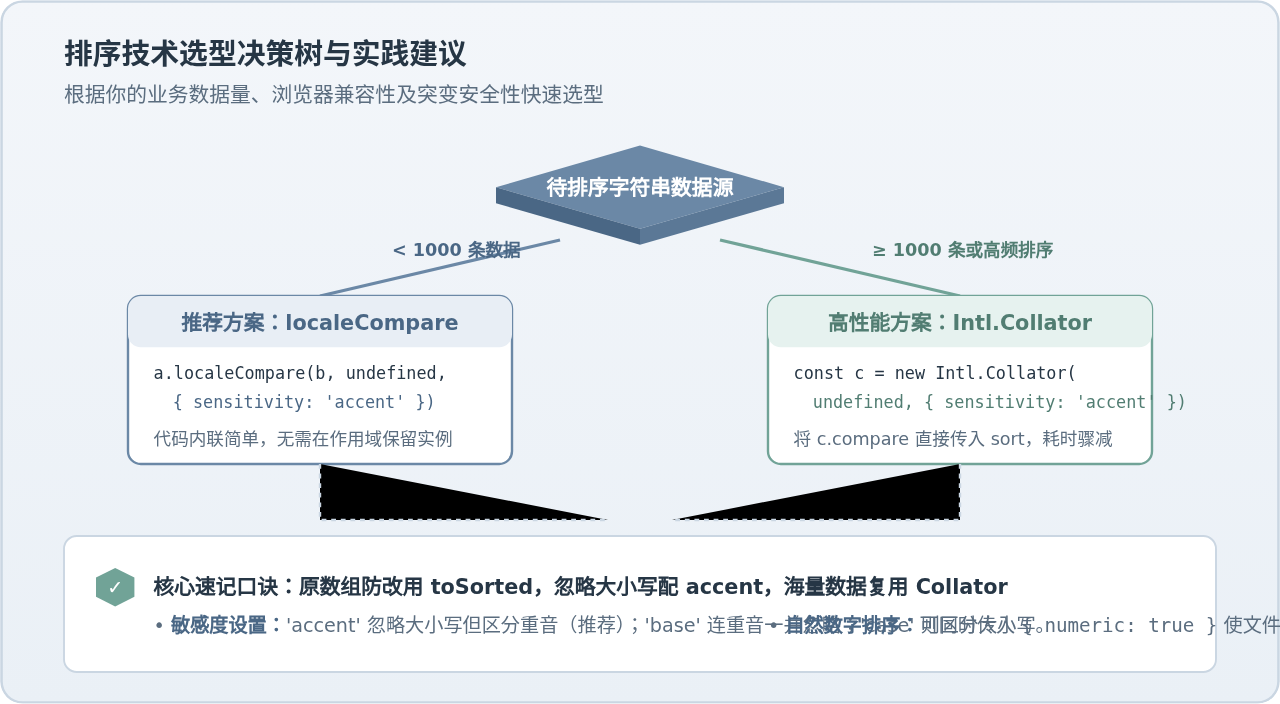
总结来说:
- 对于绝大多数常规中小型前端列表,直接使用
arr.toSorted((a, b) => a.localeCompare(b, undefined, { sensitivity: 'accent' }))是兼顾代码可读性、语言规范性与防副作用的最佳实践。 - 当面对超过千条的大型数据集或高频排序运算时,通过在模块顶层创建单一的
const collator = new Intl.Collator(undefined, { sensitivity: 'accent' })实例并传入collator.compare,可以获得极高的执行效率。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章