
深入解析JavaScript中Array.prototype.unshift()方法的使用细节,包括原地修改机制、返回值特性、多参数与单参数调用的顺序差异、全量索引平移的底层过程与性能考量。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS数组头部添加元素:unshift方法详解与索引变化
作者:小括号
时间:2026-11-19
浏览:116
文章目录
在 JavaScript 中,向数组头部插入新元素最常用的原生方法是
Array.prototype.unshift()。该方法直接在原数组上进行就地修改(In-place),将一个或多个新参数依次置于数组起始位置,同时把数组中所有既有元素整体向后推移对应的位置数,并最终返回插入后数组的新长度。
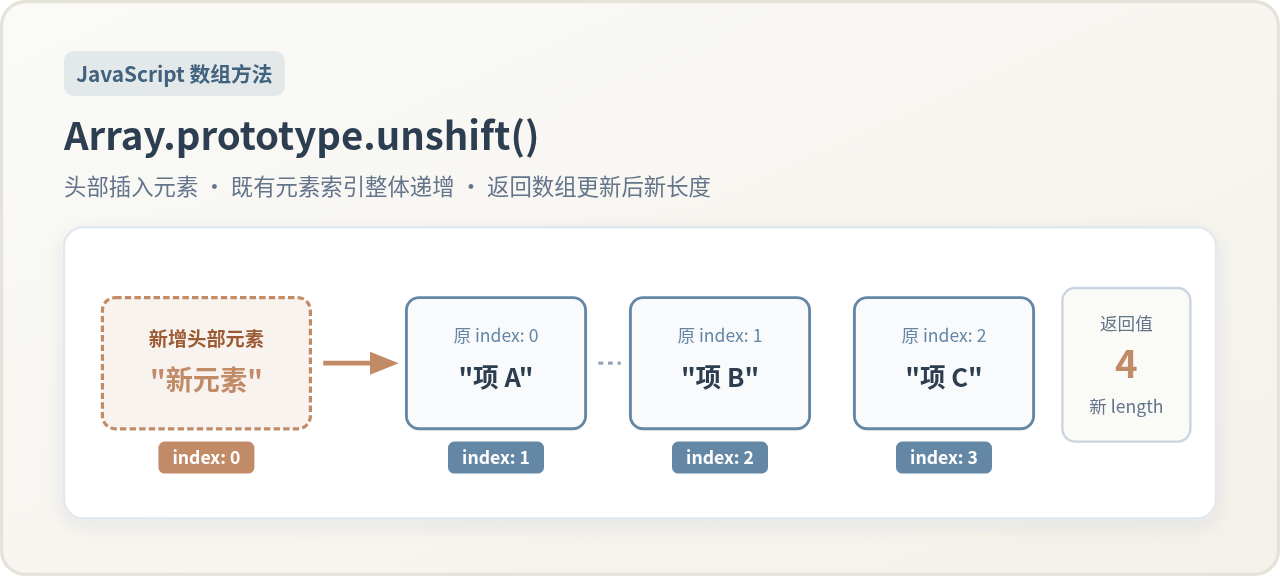
一、unshift 方法的基础语法与核心特征
在日常开发中,我们常常需要维护待办列表、消息通知栈或最近浏览记录等数据结构。当有最新生成的数据到达时,需要将其排在队列的最前方。JavaScript 数组原型上提供的 unshift() 正是为这一操作设计的原生 API。
1. 语法规范与参数
arr.unshift(element1[, ...[, elementN]])
unshift() 可以接收零个或多个参数。如果未传入任何参数,数组内容不会发生变化,方法仅直接返回当前数组的原始 length。传入一个或多个参数时,这些参数将被完整插入到原数组的开头。
2. 关键特征一:直接修改原数组(原地修改)
与 concat() 或 slice() 这类生成新数组副本的非破坏性方法不同,unshift() 属于“变异方法(Mutating Method)”。这意味着调用该方法后,原数组引用的内存空间及其内部元素映射将直接发生变化。如果你的项目遵循函数式编程范式,或者在 React / Redux 这类依赖不可变数据(Immutable Data)进行变更检测的环境中,直接调用 unshift() 可能会破坏浅比较机制,引起隐蔽的渲染异常。
3. 关键特征二:返回值是“新数组的长度”
初学者在使用 unshift() 时最常犯的一个低级失误,就是误以为它会返回修改后的数组本身。实际上,unshift() 的返回值为一个非负整数,代表更新后的数组 length。
// 示例 1:unshift 基本调用与返回值验证
const fruits = ['香蕉', '苹果'];

// 正确接收返回值
const newLength = fruits.unshift('草莓');

console.log(newLength); // 示例输出: 3
console.log(fruits);    // 示例输出: ['草莓', '香蕉', '苹果']

// ⚠️ 错误写法示例:赋值覆盖原数组
let tags = ['Vue', 'React'];
tags = tags.unshift('Angular');
console.log(tags);      // 示例输出: 3 (此时 tags 已经从数组退化成了数字)
二、深入理解全量索引位移过程
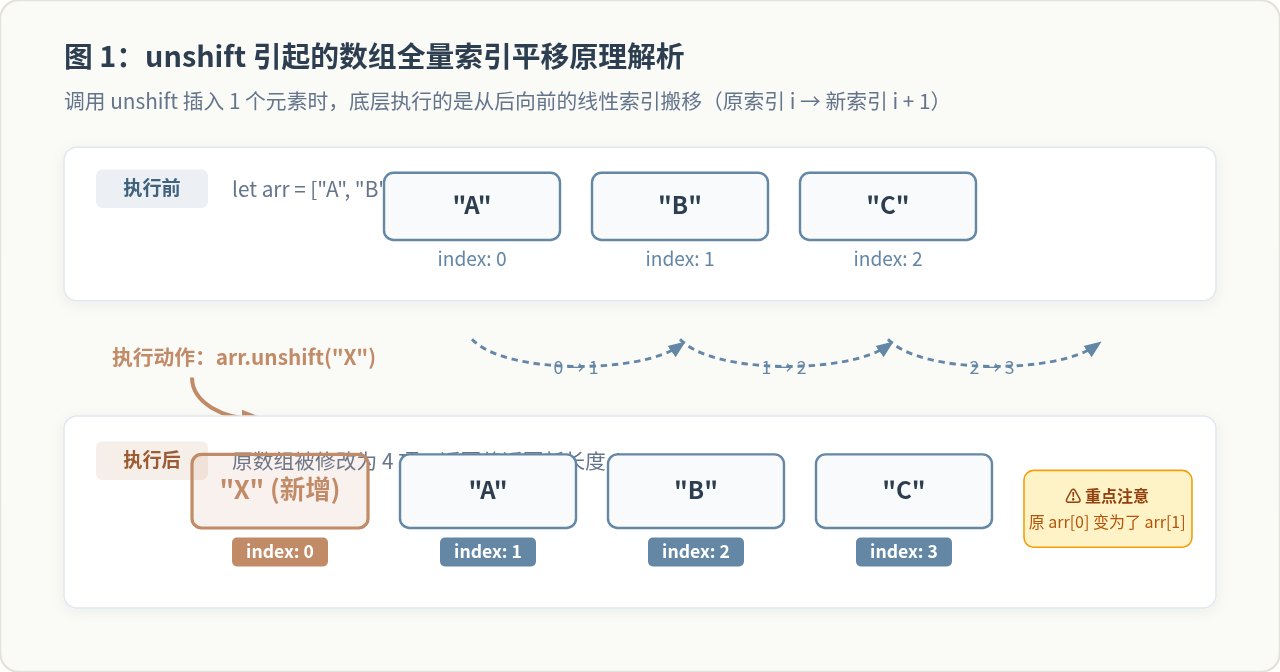
理解 unshift() 的核心在于认清 JavaScript 数组在连续逻辑索引上的重构行为。与向数组末尾添加元素的 push() 不同,头部插入必须腾出开头的物理或逻辑槽位。
1. 索引变化数学规律
假设原数组长度为 $N$,其初始索引区间为 $[0, N-1]$。当我们通过 unshift 插入 $K$ 个新元素时:
- 所有新增的 $K$ 个元素将依次占用 $[0, K-1]$ 的新索引位置;
- 原数组中原本处于索引 $i$ 的任意既有元素,其对应的访问索引全部向后位移为 $i + K$;
- 数组最终的有效索引区间扩展为 $[0, N+K-1]$,数组长度变为 $N + K$。
2. 索引变动对代码逻辑的连锁影响
由于所有旧元素的索引都会递增,因此在以下场景中必须特别谨慎:
- 缓存索引失效:如果在执行
unshift之前保存了某个元素的索引位置(例如const targetIdx = 0;),在unshift执行后,该变量将指向新插入的元素,而不是原先记录的目标元素。 - 正向遍历循环陷阱:在对数组进行正向遍历(如
for (let i = 0; i < arr.length; i++))的过程中,如果在循环体内调用了unshift,会导致当前处理位置后面的元素继续后移,从而使得某些元素被重复遍历或者进入死循环。
三、单元素多次插入 vs 多元素一次性调用的顺序陷阱
unshift() 支持一次性传入多个参数,例如 arr.unshift(item1, item2, item3)。这一设计背后包含着极其重要的操作顺序规范,也是面试和实战开发中高频出现的考察点。
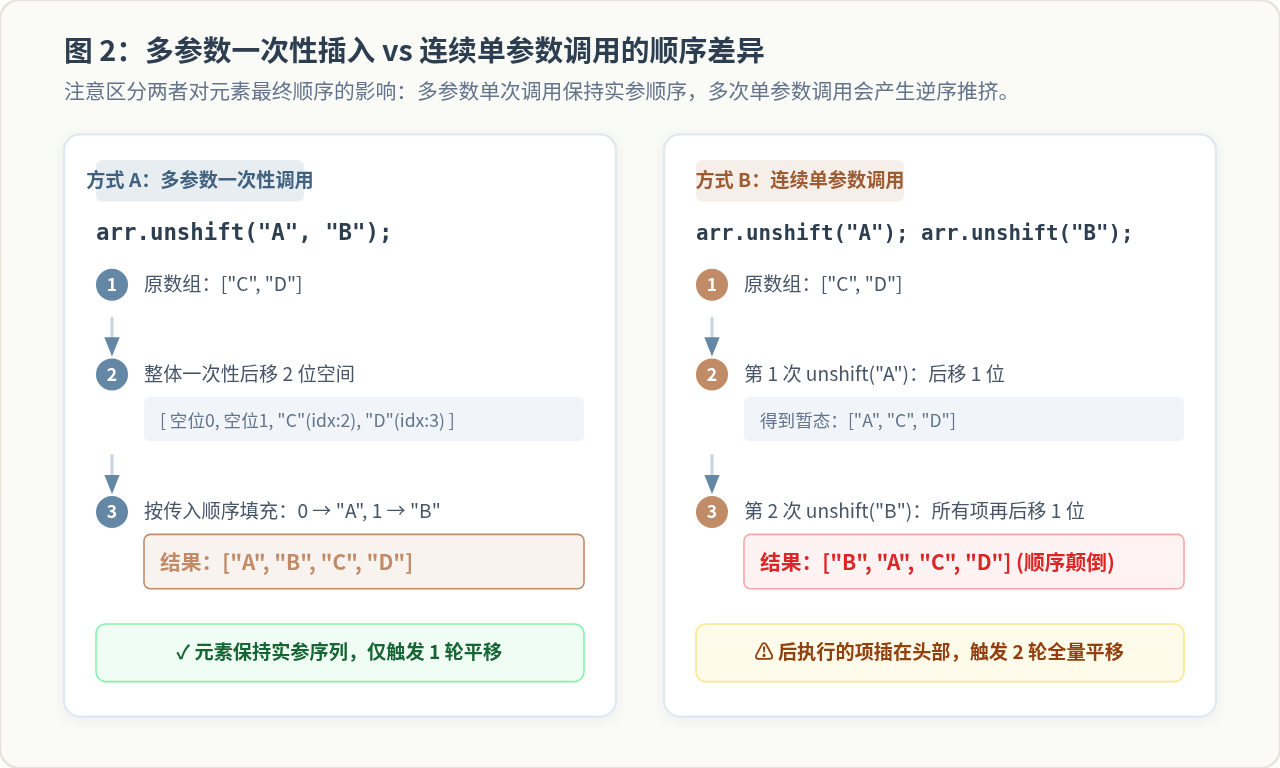
// 示例 2:单参数与多参数插入的执行顺序对比

// 场景 A:多参数一次性调用
const listA = ['C', 'D'];
listA.unshift('A', 'B');
console.log(listA);
// 示例输出: ['A', 'B', 'C', 'D'] —— 严格保持实参列表中 'A' 在前、'B' 在后的书写顺序

// 场景 B:连续多次调用单参数 unshift
const listB = ['C', 'D'];
listB.unshift('A'); // 此时为 ['A', 'C', 'D']
listB.unshift('B'); // 'B' 再次插到最前端,将 'A' 推至第 1 位
console.log(listB);
// 示例输出: ['B', 'A', 'C', 'D'] —— 发生逆序!
⚠️ 机制解析
ECMAScript 标准规范明确规定:当一次性向 unshift() 传入多个参数时,引擎会将原数组中已有元素整体向后挪动参数总数(此处为 2 个位置),然后将这批参数按照它们在实参列表中的自然声明顺序,批量写入空出的 [0] 和 [1] 槽位。因此,参数顺序被完整保留。
相反,如果写成两句独立的 unshift 语句,第二次调用会把第一次调用的结果当成既有数组,再次执行后移,从而使得后执行的参数排在最前面,造成实际顺序的颠倒。
四、底层内存开销与时间复杂度分析
在算法与数据结构层面,操作在数组头部和尾部的成本存在本质差异。在选择数组操作方法时,不能仅仅关注语法的简短,还要预估数据量增长带来的计算开销。
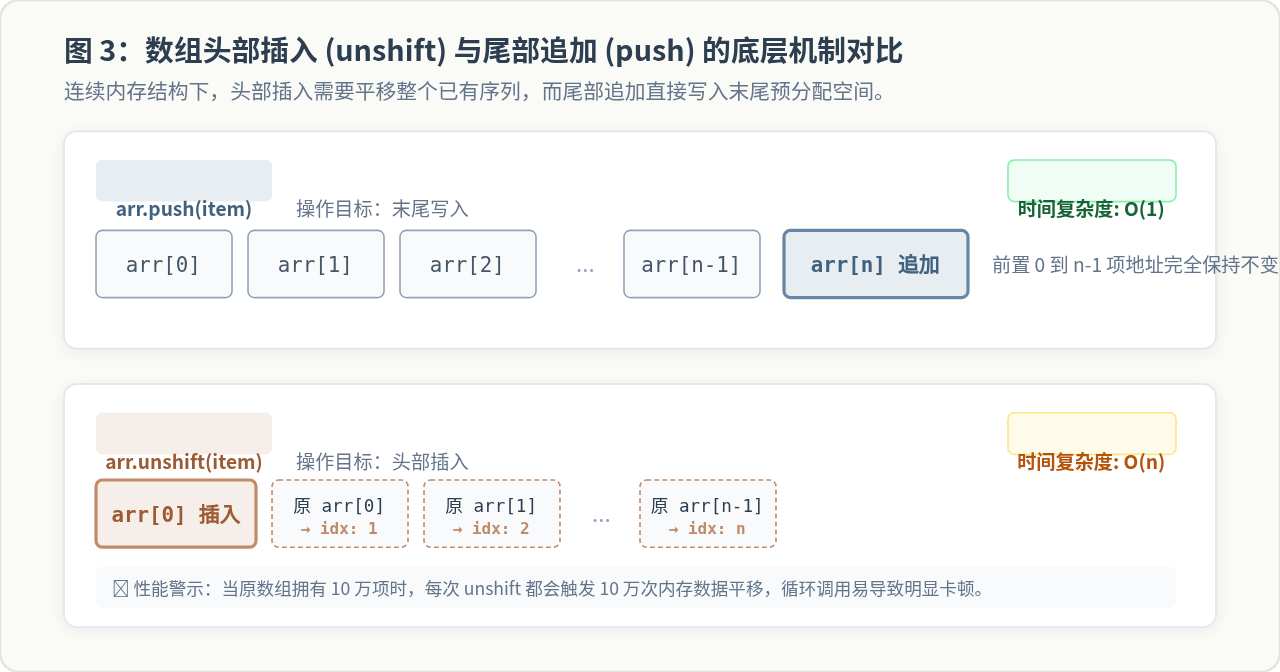
| 操作方法 | 操作位置 | 时间复杂度 | 内存行为 | 大数据量(10万级)表现 |
|---|---|---|---|---|
push(item) |
数组尾部 | $O(1)$ 均摊 | 直接写入连续空间末尾,无需搬动旧数据 | 耗时极短,通常在 1ms 内完成 |
unshift(item) |
数组头部 | $O(N)$ 线性 | 已有的 $N$ 个元素全部需要从后向前平移 1 步 | 随着 $N$ 增大,循环调用容易造成页面严重丢帧或脚本阻塞 |
当数组规模较小时(例如百级以下的数据展示),$O(N)$ 的开销在现代 V8 等高效 JS 引擎的优化下几乎无法被人类感知;然而,如果将 unshift() 放在高频执行的事件循环(例如 WebSocket 消息流处理、高频日志收集)或大数据量(数万至数十万条记录)的队列操作中,每次插入都会触发一整轮内存数据的复制与重映射,累计时间复杂度将飙升至 $O(N^2)$。
五、现代前端开发中的替代方案与选型策略
针对不同业务场景,合理选择头部添加元素的实现手段是保证代码健壮性和性能的关键。
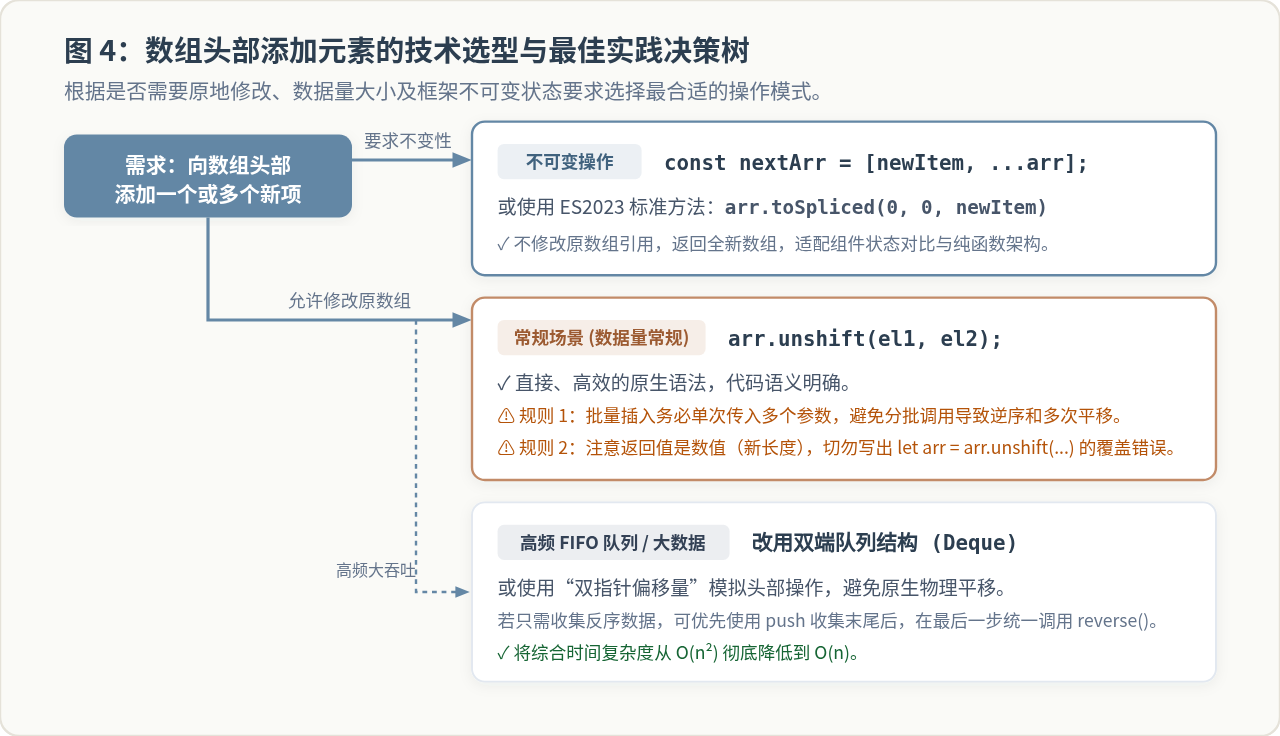
1. 响应式与不可变数据场景:扩展运算符与 toSpliced()
在 Vue 3、React、Svelte 等现代前端框架中,组件的状态更新极度依赖不可变数据更新,以便框架触发细粒度的响应式对比或虚拟 DOM 重新渲染。此时推荐使用以下两种方式:
// 方式 A:ES6 扩展运算符(通用做法)
const originalList = ['Item 2', 'Item 3'];
const updatedList = ['Item 1', ...originalList];
console.log(updatedList); // 示例输出: ['Item 1', 'Item 2', 'Item 3']

// 方式 B:ES2023 Array.prototype.toSpliced()(原生非破坏性方法)
const stateList = ['B', 'C'];
const nextState = stateList.toSpliced(0, 0, 'A');
console.log(nextState); // 示例输出: ['A', 'B', 'C']
console.log(stateList); // 示例输出: ['B', 'C'](原数组毫发无损)
2. 高性能先进先出(FIFO)队列场景
如果业务确实需要实现“先进先出”的队列逻辑,最简单的原生实现通常是 push 进队、shift 出队,或者 unshift 进队、pop 出队。无论哪种组合,头部操作都会带来 $O(N)$ 的搬移成本。
在性能敏感场景下,建议通过以下两种方案规避性能瓶颈:
- 逆向收集 + 统一反转:如果是一组数据需要按逆序最终呈现,可以先用 $O(1)$ 的
push()快速在尾部组装,待全部数据注入完成后,一次性调用arr.reverse()。这能将整体复杂度严格控制在 $O(N)$。 - 使用双指针或双端队列(Deque):通过链表结构或维护头部起始指针(Head Pointer)来模拟出队入队,从而避开物理内存平移。
六、关键知识点总结清单
- 原地修改:
unshift()直接改写原数组,不返回新数组副本。 - 返回值类型:返回的是插入完成后的新数组长度(
number),而非修改后的数组对象。 - 索引全量递增:插入 $K$ 个元素后,数组既有元素索引整体平移 $+K$,需警惕循环体内调用引发的指针漂移。
- 参数顺序保持:单次传入多个参数
unshift(a, b)会完整保留a, b的相对顺序,并仅触发一轮后移;多次独立调用则会产生反序推挤。 - 复杂度考量:时间复杂度为 $O(N)$,对于极大规模数组或高频队列操作,应改用扩展运算符生成新数组,或采用双端队列等专用数据结构。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章