
深入详解JavaScript原地快速排序的实现方法。通过双指针分区法直接在原数组上进行元素交换,无需创建任何辅助数组,将额外堆内存占用降至0,栈空间控制在O(log n),有效降低V8引擎GC压力并大幅提升海量数据排序性能。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS原地快速排序怎么写?双指针法减少内存占用
作者:代码拾荒
时间:2026-11-19
浏览:256
文章目录
JavaScript 核心算法与性能调优
适用场景:高频排序 / 海量数据 / 内存敏感型应用
空间复杂度:O(log n) 仅依赖递归栈
算法类别:原地分治(In-place Divide & Conquer)
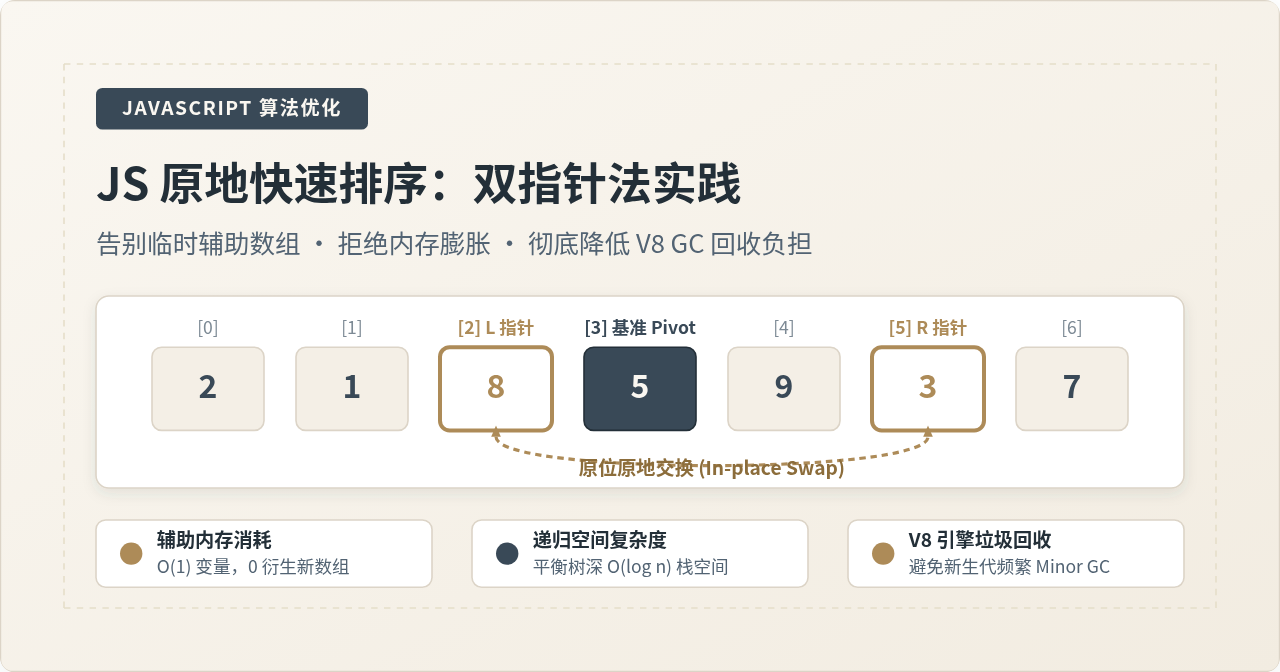
在 JavaScript 中实现快速排序时,不少开发者习惯借助
filter 或多次解构创建新的 left 和 right 数组。这种写法虽然语义直观,但会在每次递归中频繁向堆申请新的数组空间,导致空间复杂度上升至 O(n log n) 并诱发频繁的垃圾回收。原地快速排序(In-place QuickSort)的核心答案在于“双指针分区法”:选定一个基准值(Pivot)后,左右两个指针由外向内扫描,发现不符合大小关系的元素时直接在原数组中执行位置对调(Swap)。这种方法不产生任何中间数组,将额外堆内存占用彻底降为 0,仅需承担 O(log n) 的递归执行栈开销。
一、常规“拷贝版”快排的内存困局
很多前端面试题或初学者教程中,最常见的快速排序实现如下所示:
// 常见但占用大量内存的非原地实现
function naiveQuickSort(arr) {
  if (arr.length <= 1) return arr;
  const pivot = arr[arr.length - 1];
  const left = arr.filter((item, index) => item <= pivot && index < arr.length - 1);
  const right = arr.filter(item => item > pivot);
  return [...naiveQuickSort(left), pivot, ...naiveQuickSort(right)];
}
这段代码通过两次 filter 遍历生成两个独立的子数组,并在递归返回时利用扩展运算符 [...] 重新拼接为一个全新的数组实例。当待排序数组仅有几十项时,运行差异并不明显;但在面对数万乃至数十万项的大数组时,其弊端会迅速显现:
- 堆对象数量暴增:一趟深度为 16 层的递归树,会额外衍生出数万个小数组对象。
- 加剧 V8 垃圾回收(GC)停顿:大量的短生命周期对象填满新生代(New Space),触发高频的 Minor GC(Scavenge 周期)。GC 发生时 JavaScript 主线程会暂停执行,导致页面掉帧或服务端处理卡顿。
- 空间复杂度虚高:额外占用的堆内存高达 O(n log n) 到 O(n),与快速排序原本提倡的高效空间特性背道而驰。
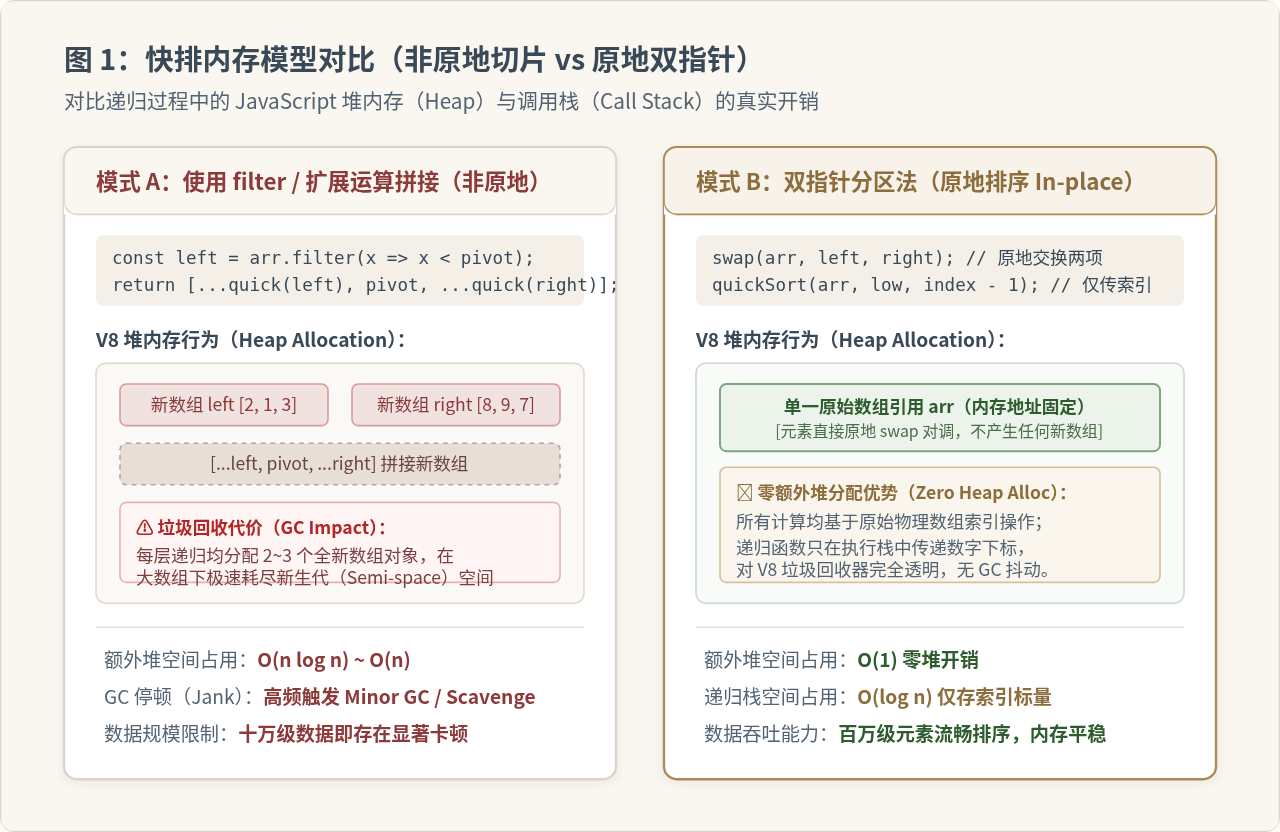
从图 1 可以看出,真正的“原地(In-place)”排序要求所有比较与交换都作用在最初传入的那块连续内存空间上,函数的参数从传递“切片数组”变为传递“区间下标”(low 与 high)。
二、双指针分区法(Partition)的执行机制
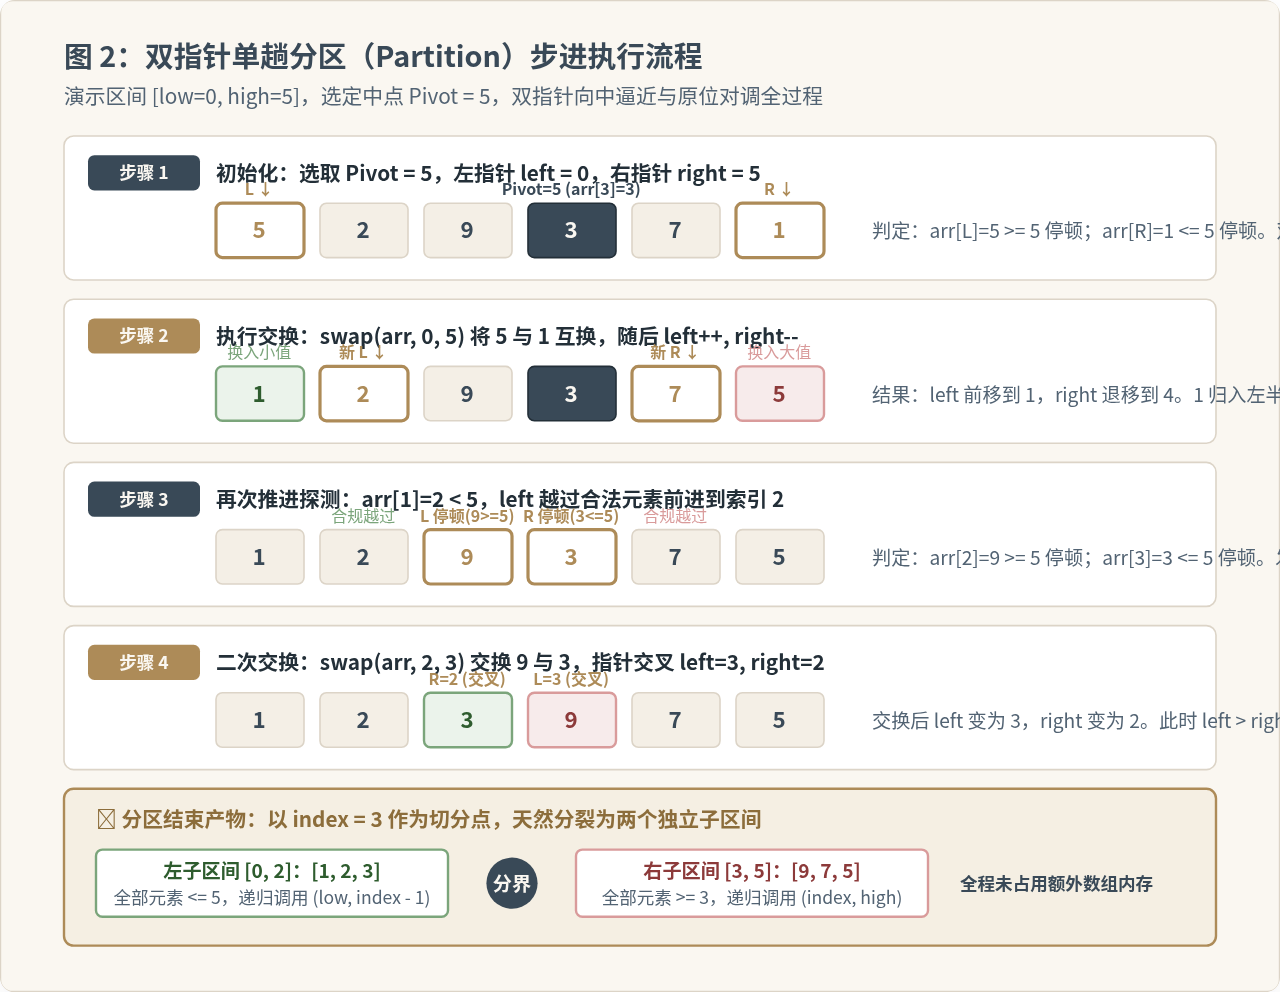
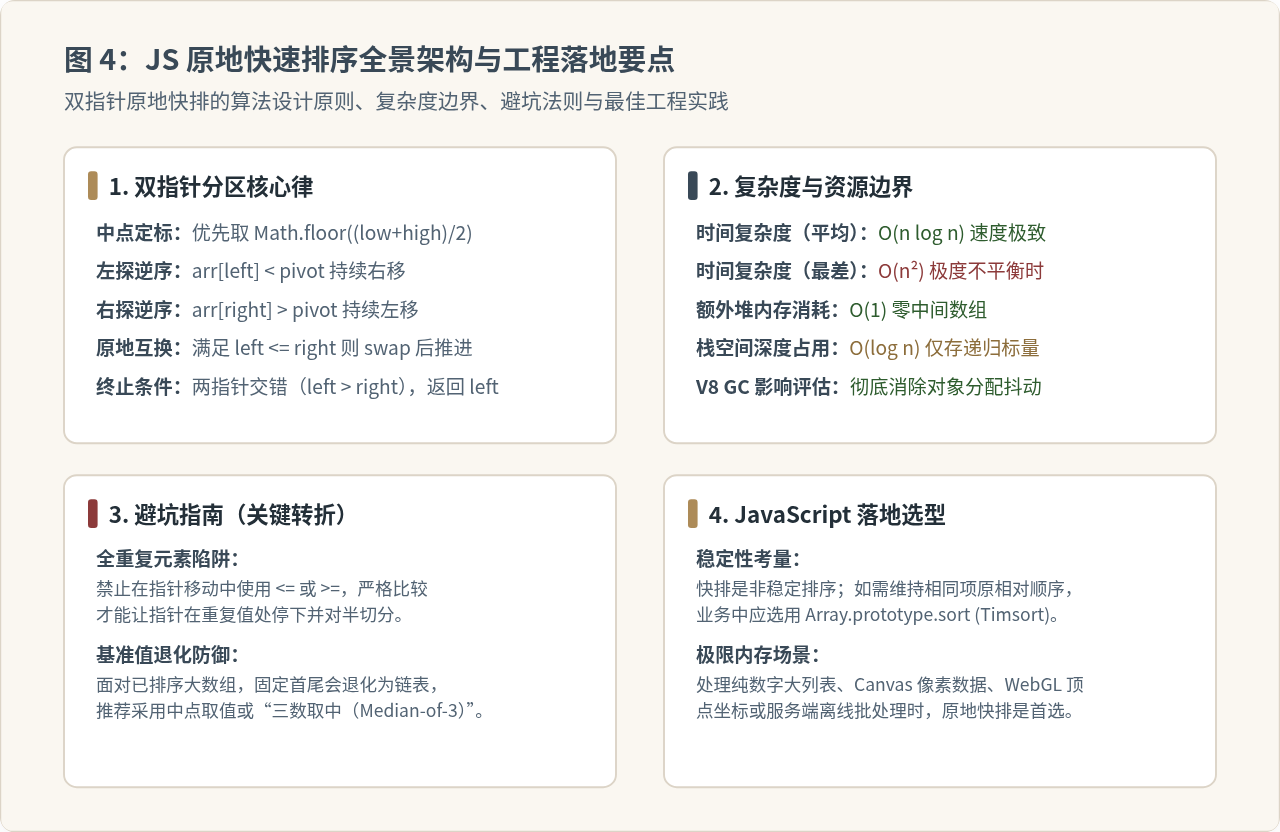
要在原数组上实现原地重排,关键在于单趟分区(Partition)过程。分区的目标非常明确:以基准值(Pivot)为界,将所有小于等于 Pivot 的元素规整到左半侧,所有大于等于 Pivot 的元素规整到右半侧,并返回分界点的索引位置。
双指针移动与交换判定准则
我们采用左右双指针向中间逼近的经典策略:
- 选定基准:在当前区间
[low, high]中取中间元素作为基准值pivot = arr[Math.floor((low + high) / 2)]。 - 左指针右移:
left从low开始右移,当arr[left] < pivot时,说明该元素已经位于正确的一侧,继续left++;一旦遇到arr[left] >= pivot则停顿等待。 - 右指针左移:
right从high开始左移,当arr[right] > pivot时,说明该元素已经在右半侧,继续right--;一旦遇到arr[right] <= pivot则停顿等待。 - 原位交换:若两指针尚未交错(即
left <= right),说明左右两边各发现了一个位置失当的元素,此时直接在原数组中调用swap(arr, left, right)互换它们的值,随后同时推进left++和right--。 - 交错结束:重复上述探测,直到
left > right双指针交错而过。此时返回当前的left索引,作为右半子区间的递归起点。
💡 关键细节:为什么使用 arr[left] < pivot 而非 <= ?
初学者容易写成 while (arr[left] <= pivot)。如果这样写,当数组中存在大量与 pivot 相等的重复值时,指针会持续前进直到区间末尾,造成单侧区间极度偏斜;而使用严格小于(<)则会让指针在遇到重复值时停顿下来并参与交换,从而把重复项较为均匀地摊分到左右两侧,有效保护分区平衡。
三、JavaScript 完整代码实现与逐行拆解
基于上述双指针分区机制,完整且严谨的原地快速排序实现如下:
/**
 * 交换数组中两个指定索引位置的元素(原地操作)
 * @param {Array} arr 目标数组
 * @param {number} i 索引 A
 * @param {number} j 索引 B
 */
function swap(arr, i, j) {
  const temp = arr[i];
  arr[i] = arr[j];
  arr[j] = temp;
}

/**
 * 双指针单趟分区函数
 * @param {Array} arr 目标数组
 * @param {number} low 区间左边界
 * @param {number} high 区间右边界
 * @returns {number} 分界索引(右子区间的起始下标)
 */
function partition(arr, low, high) {
  // 取区间中点值作为基准值 Pivot
  const pivot = arr[Math.floor((low + high) / 2)];
  let left = low;
  let right = high;

  while (left <= right) {
    // 左指针寻找第一个大于等于 pivot 的项
    while (arr[left] < pivot) {
      left++;
    }
    // 右指针寻找第一个小于等于 pivot 的项
    while (arr[right] > pivot) {
      right--;
    }

    // 若指针未交错,交换元素并各自推进一步
    if (left <= right) {
      swap(arr, left, right);
      left++;
      right--;
    }
  }

  return left;
}

/**
 * 原地快速排序主入口
 * @param {Array} arr 待排序数组
 * @param {number} low 起始索引(默认为 0)
 * @param {number} high 结束索引(默认为 length - 1)
 * @returns {Array} 排序后的原数组引用
 */
function quickSort(arr, low = 0, high = arr.length - 1) {
  // 递归基(Base Case):区间元素小于等于 1 个时无需处理
  if (low >= high) return arr;

  // 执行分区并获得右子区间的起始边界
  const index = partition(arr, low, high);

  // 对左半区间 [low, index - 1] 递归执行快排
  if (low < index - 1) {
    quickSort(arr, low, index - 1);
  }

  // 对右半区间 [index, high] 递归执行快排
  if (index < high) {
    quickSort(arr, index, high);
  }

  return arr;
}
测试验证与控制台验证示例
可以在 Node.js 或浏览器 DevTools 控制台中运行以下测试用例:
// 示例 1:一般无序数组测试
const nums1 = [35, 12, 78, 43, 29, 64, 18, 55];
quickSort(nums1);
console.log("排序结果:", nums1);
// 输出: [12, 18, 29, 35, 43, 55, 64, 78]

// 示例 2:全重复元素与逆序数组测试
const nums2 = [5, 5, 5, 1, 2, 2, 9, 0];
quickSort(nums2);
console.log("排序结果:", nums2);
// 输出: [0, 1, 2, 2, 5, 5, 5, 9]
注意看 quickSort(nums1) 调用的结果:原始变量 nums1 的内部元素顺序直接发生了变动,返回的也是 nums1 的引用,全程没有创建任何新的包装数组。
四、递归分治与执行栈生命周期深度解析
虽然我们杜绝了堆上的新数组创建,但递归算法本身仍需要使用 JavaScript 引擎提供的调用栈(Call Stack)来存储每层函数的执行上下文。
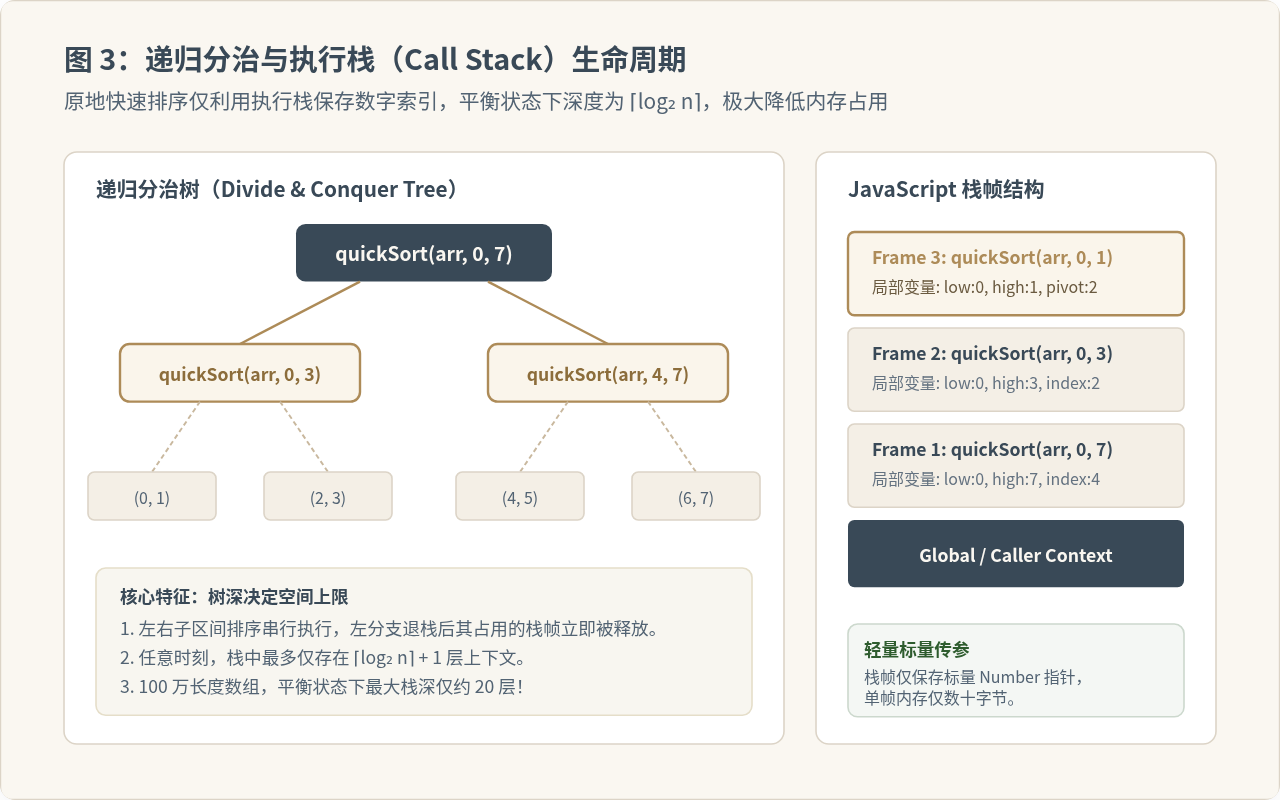
为什么原地快排的空间复杂度被定为 O(log n)?结合图 3 可以得到明确的答案:
- 栈帧内容极其轻量:每层
quickSort调用的上下文内只保存原始数组的引用地址和几个数字标量(low、high、index、left、right),单帧占用仅有几十字节。 - 串行执行与即时退栈:代码先递归左半区间
quickSort(arr, low, index - 1)。当左侧递归完毕后,栈帧会逐层销毁(Pop),随后才开始压入右半区间的栈帧。因此,最大同时存活的栈深度等于分治树的最大高度。 - 平衡状态下的极致深度:对于拥有 1,000,000 项元素的超大数组,在基准值划分较为均衡的情况下,树的高度仅为 ⌈log₂ 10⁶⌉ ≈ 20 层。这意味着在整个排序期间,调用栈内最多只有 20 个轻量栈帧,对系统内存完全无感。
五、关键转折与避坑指南
编写生产可用的原地快速排序,有几个至关重要的陷阱必须规避:
⚠️ 陷阱一:基准值选择导致的时间与空间退化
如果将 pivot 始终固定取首项(arr[low])或尾项(arr[high]),一旦输入本身是一个已经有序或近似有序的数组,每次分区只能剔除 1 个元素,分治树将彻底退化为单支链表。此时时间复杂度飙升至 O(n²),递归栈深度达到 O(n)。在 JavaScript 引擎中,当调用栈深度超过约 10,000 层时,会直接抛出 Uncaught RangeError: Maximum call stack size exceeded。
防范方法:始终采用中点取值 arr[Math.floor((low + high) / 2)],或者在处理大数据集时采用“三数取中法(Median-of-Three)”,即比对首、中、尾三处元素并取中位数作为基准。
陷阱二:无限递归与越界死循环
在 partition 内部,如果 swap 执行后忘记对双指针执行 left++ 和 right--,或者 while (left <= right) 中的等号被遗漏,当遇到 arr[left] === arr[right] === pivot 的特殊情况时,双指针会卡在原地不动,陷入无限循环;另外,外层递归调用如果写成 quickSort(arr, low, index)(漏掉 - 1),也会导致区间无法收缩而栈溢出。
六、性能横向对比与工程选型建议
为了让大家直观了解不同排序方式在 JavaScript 环境中的性能特征,下表总结了三种常见方案的对比:
| 对比维度 | 拷贝版快排(filter/解构) | 双指针原地快排(本文) | 原生 Array.prototype.sort |
|---|---|---|---|
| 额外堆内存 | O(n log n) ~ O(n)(产生大量数组) | O(1)(零中间堆分配) | O(n) 临时缓冲区(Timsort 机制) |
| 栈空间占用 | O(log n) | O(log n) | 底层 C++ 栈实现(无 JS 栈溢出风险) |
| V8 GC 压力 | 极高(新生代迅速填满频繁停顿) | 极低(全程无新增对象) | 低(底层引擎优化) |
| 排序稳定性 | 不稳定(Unstable) | 不稳定(Unstable) | 稳定排序(Stable) |
| 10万量级耗时 | 约 180~450ms(受 GC 影响波动大) | 约 25~45ms(平稳高效) | 约 20~40ms(C++ 编译级优化) |
工程实践选型法则
- 常规业务开发:优先使用原生
Array.prototype.sort()。现代 V8 引擎已经全面采用 Timsort 算法,不仅是稳定排序(保持相同权重对象的原本相对顺序),而且底层以 C++ 高效运行,具备完善的边界防护。 - 高性能密集计算 / 内存受限场景:推荐使用双指针原地快排。例如前端处理百万级 Canvas 离屏像素矩阵、音频频谱数据、WebGL 顶点缓冲区,或者 Node.js 服务端进行批量日志的离线内存排序。在这些场景中,杜绝对象分配、避免触发 GC 停顿是保障系统吞吐量和流畅度的核心命脉。
结语与核心启示
编写高质量 JavaScript 代码不仅要关注逻辑结果的正确性,还要关注底层引擎的运行机制。实现原地快速排序的精髓可以凝练为三点:中点选轴保平衡、双指针交错原位换、切分边界靠栈传。通过双指针原地操作,我们把算法的空间复杂度从受制于堆分配的脆弱状态,提升为受严格对数律保护的稳定状态,这正是算法工程化优化中最具价值的思维转变。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章