
深入剖析JavaScript中Unicode字符因编码形式不同导致===比较失效的底层原因,详细讲解String.prototype.normalize()的NFC、NFD、NFKC、NFKD四种规范化模式及在文本比对、模糊匹配中的实战方案。

当前位置:首页 > JavaScript 基础 > 正文
JS中使用normalize()解决Unicode字符串相等判断问题
作者:木棉
时间:2026-11-18
浏览:625
文章目录
在 JavaScript 中直接使用 === 或 == 判断两个看起来一模一样的字符串时,常常会遇到返回 false 的意外情况。这个现象的根本原因在于 Unicode 规范允许同一个视觉字形通过不同的底层码点序列进行编码,而 JavaScript 引擎严格按照内存中的 UTF-16 码元(Code Unit)逐一对比。要彻底解决这一问题,核心方法是使用 ES6 原生提供的 String.prototype.normalize() 方法,在比较前将两端字符串统一转换为标准的规范化形式(通常使用默认的 NFC 模式:strA.normalize() === strB.normalize())。
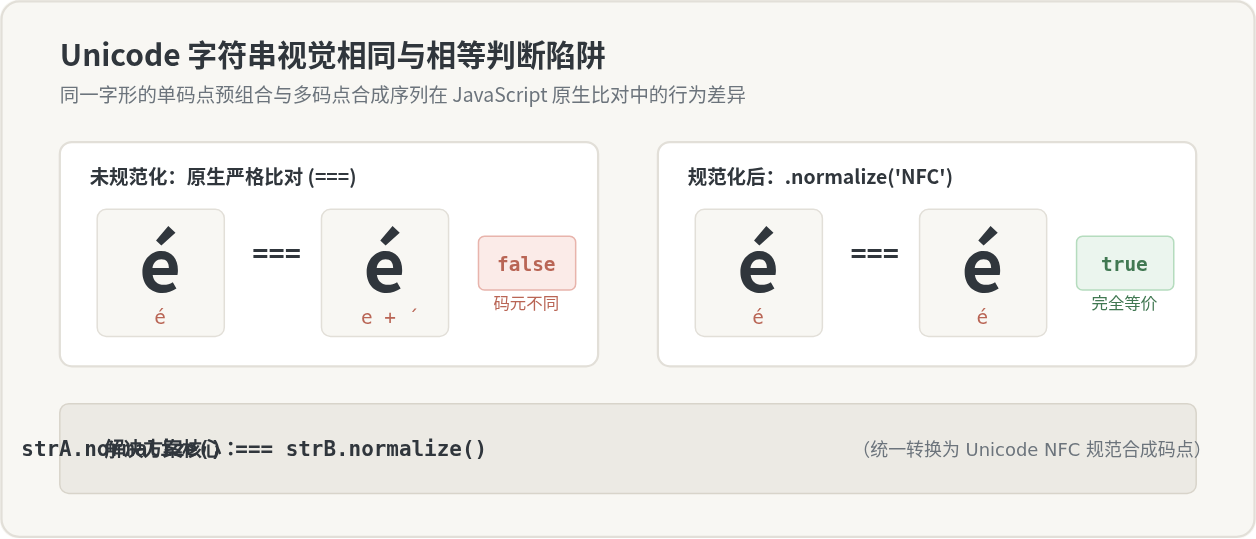
缩略图:Unicode 字符视觉显示与内存存储差异及 normalize() 规范化前后对比
一、现象复现:为什么眼睛看到的“相同”在 JS 中不相等?
在日常开发中,从不同的数据源(例如用户在键盘上输入、从网页复制、或是从 macOS/Linux 文件系统读取文件名)获取文本时,经常会出现视觉字形完全一致,但严格相等比对却返回 false 的情况。
来看下面这段可以直接在控制台运行的最小复现代码:
const str1 = 'é';       // 形式一:预组合字符 "é"
const str2 = 'é';      // 形式二:基字符 "e" + 组合音标 U+0301

console.log(str1);           // 示例输出: "é"
console.log(str2);           // 示例输出: "é"
console.log(str1 === str2);  // 示例输出: false
console.log(str1.length);    // 示例输出: 1
console.log(str2.length); // 示例输出: 2在这段代码中,str1 和 str2 打印到控制台或渲染到页面上时,人眼看到的都是带尖音符的小写字母 é。然而,str1 === str2 的判断结果却是 false,同时 str1.length 为 1,而 str2.length 却为 2。
这是因为 Unicode 提供了两种方式来表示带有重音符号或附加符的字符:
- 预组合字符(Precomposed Character):Unicode 直接为带重音的字符分配了一个单独的码点,例如
U+00E9(LATIN SMALL LETTER E WITH ACUTE)。 - 组合字符序列(Combining Character Sequence):由基础字符加上一个或多个非间距结合修饰字符组成。例如基础拉丁字母
e(U+0065)紧跟结合尖音符(COMBINING ACUTE ACCENT,U+0301)。渲染引擎在排版时会自动将两者合成为同一个可视字符簇(Grapheme Cluster)。
JavaScript 语言规范(ECMA-262)中明确规定,字符串比较是基于底层 UTF-16 码元序列(Code Unit Sequence) 逐位比对的,引擎并不会主动去解析文本的语言学含义或字形合成关系。当两个字符串的码元数量不同、或者相同位置上的码元数值不同时,比较操作便立即返回 false。
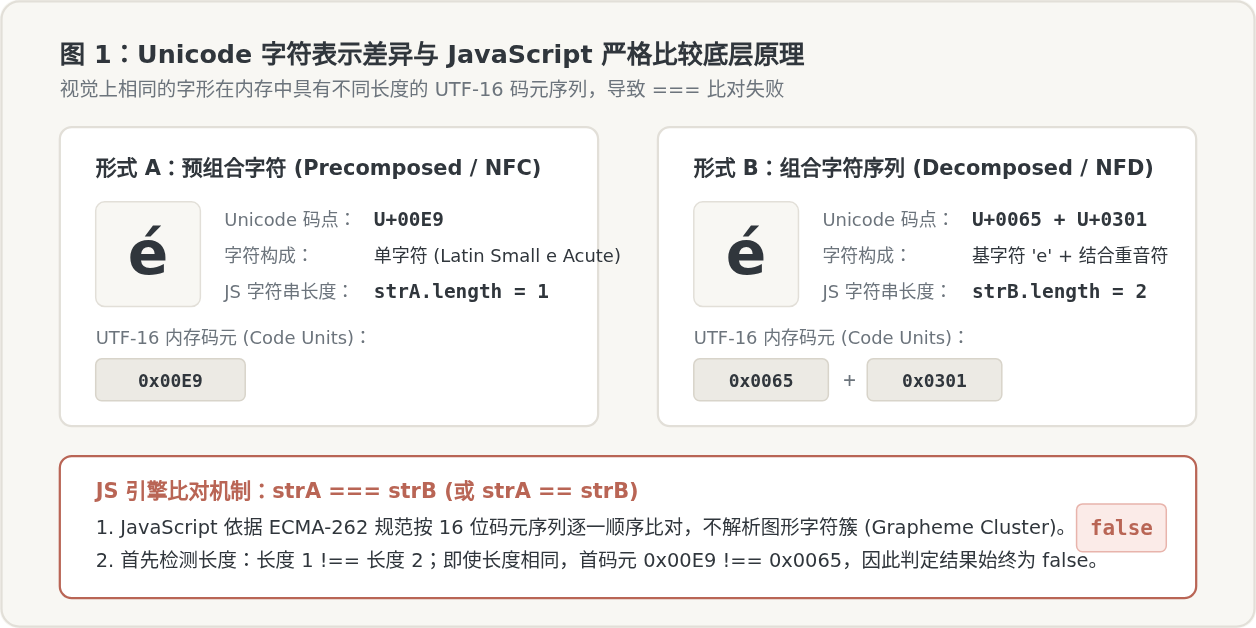
图 1:Unicode 字符表示差异与 JavaScript 严格比较底层原理
二、Unicode 的等价性与 normalize() 的四种形态
为了解决多码点序列与单码点预组合字符之间的对齐问题,Unicode 联盟制定了 Unicode 标准附件 #15(UAX #15: Unicode Normalization Forms)。ECMAScript 2015(ES6)正式引入了 String.prototype.normalize([form]) 方法,允许开发者在运行时将字符串转化为统一的规范化格式。
normalize() 接受一个可选参数 form,指定要使用的规范化形式。若不传参数,默认值为 'NFC'。Unicode 定义了两种“等价”概念和四种标准形态:
1. 规范等价(Canonical Equivalence)与兼容等价(Compatibility Equivalence)
- 规范等价(Canonical):指字符在显示和语义上完全相同,仅仅是编码组织方式不同(例如
é与e + ́,或者符号埃Å与大写字母Å)。规范等价的字符在转换后保持完全可逆或视觉无损。 - 兼容等价(Compatibility):指字符在核心语义上相同,但在纯文本外观、排版格式或附加样式上有差异(例如合字
fi与fi、上标²与普通数字2、全角字符1与半角字符1)。兼容转换会抹平这些格式差异。
2. 四种规范化模式定义
| 模式参数 | 英文全称 | 转换逻辑 | 典型效果与适用场景 |
|---|---|---|---|
'NFC'(默认) |
Normalization Form C (Canonical Composition) | 先进行规范分解,再进行规范合成 | 优先将字符合成为单一预组合码点。字符串长度通常最短,是绝大多数文本比对与存储的通用标准推荐。 |
'NFD' |
Normalization Form D (Canonical Decomposition) | 进行规范分解 | 将预组合字符完全拆开为基字符和独立的音标结合符。常用于提取字根、剥离重音符号或精确字形分析。 |
'NFKC' |
Normalization Form KC (Compatibility Composition) | 先进行兼容分解,再进行规范合成 | 折叠全角字符、合字、排版上标后合成。常用于搜索引擎分词、表单用户输入宽松归一化。 |
'NFKD' |
Normalization Form KD (Compatibility Decomposition) | 进行兼容分解 | 彻底展开所有兼容变体以及附加音标。常用于极端文本清洗和无障碍纯文本提取。 |
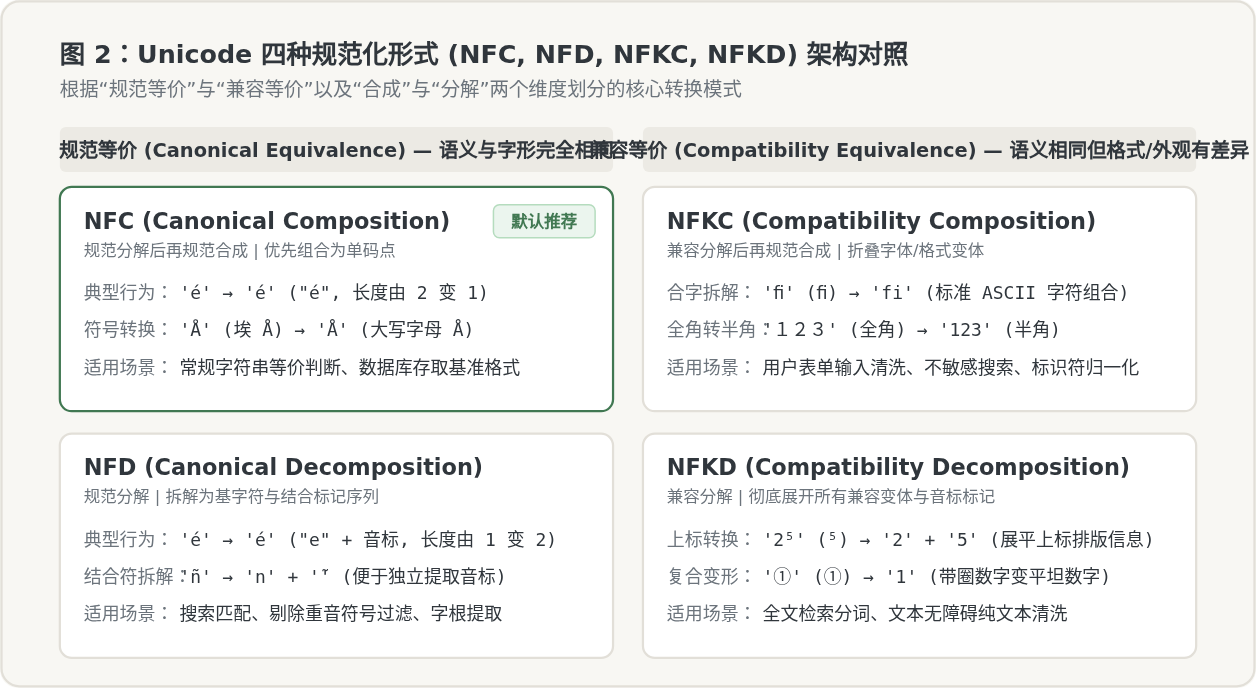
图 2:Unicode 四种规范化形式 (NFC, NFD, NFKC, NFKD) 架构对照
我们通过具体的代码测试这四种模式在处理不同字符时的输出差异:
// 1. 规范等价字符测试 (é)
const nfd_e = 'é';
console.log(nfd_e.normalize('NFC') === 'é');  // 示例输出: true
console.log('é'.normalize('NFD') === nfd_e);  // 示例输出: true

// 2. 合字与连字测试 (fi -> fi)
const ligature = 'fi'; // "fi" 单个合字码点
console.log(ligature.normalize('NFC'));   // 示例输出: "fi" (NFC 保留合字)
console.log(ligature.normalize('NFKC'));  // 示例输出: "fi" (NFKC 展开为标准 f 和 i)

// 3. 全角与半角字符测试
const fullWidth = '123';
console.log(fullWidth.normalize('NFC'));  // 示例输出: "123" (维持全角)
console.log(fullWidth.normalize('NFKC')); // 示例输出: "123" (规范化为半角数字)
三、实战解决方案与生产代码封装
在实际业务代码中,字符串比较的需求通常分为以下三类:严格字形等价判断、忽略音标重音的模糊比对、以及消除全半角格式差异的宽松比对。下面分别给出经过生产验证的封装示例。
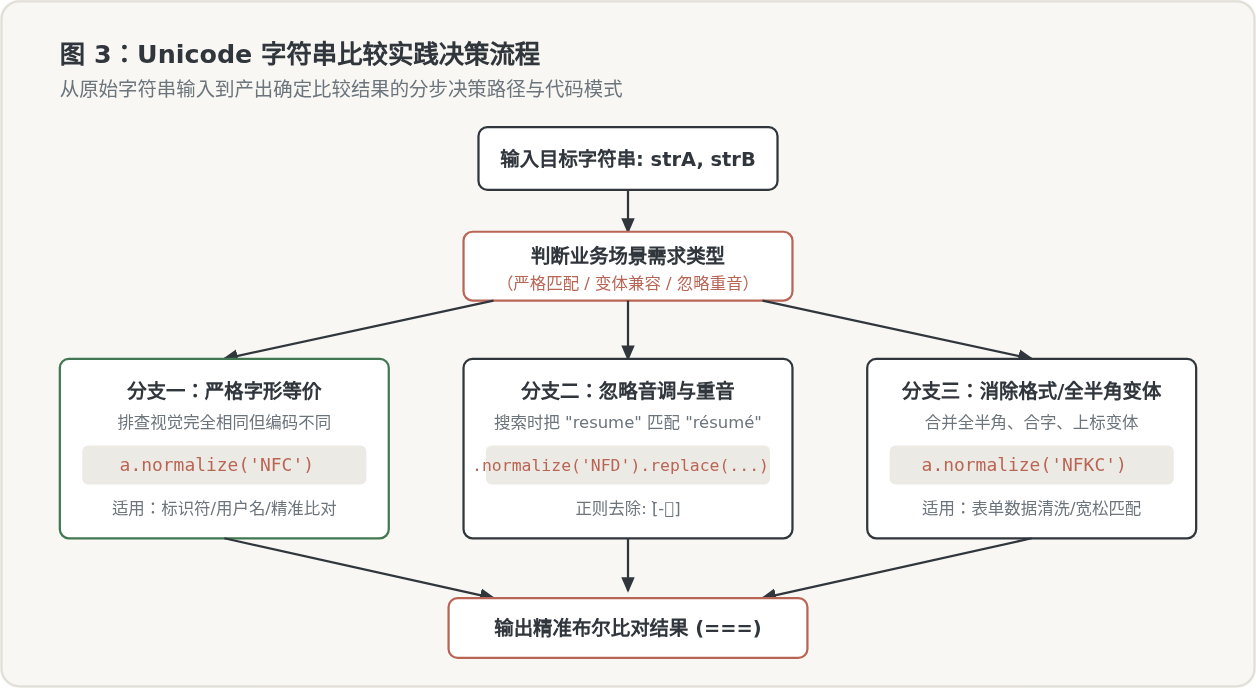
图 3:Unicode 字符串比较实践决策流程
方案 1:严格字形等价比较(推荐通用做法)
在绝大多数业务场景下(如用户账号唯一性校验、商品标题比对、标签排重),我们希望只要字符视觉呈现和语义一致,就判定为相等。此时直接使用 'NFC':
/**
 * 判断两个字符串是否在 Unicode 规范等价意义上严格相等
 * @param {string} a
 * @param {string} b
 * @returns {boolean}
 */
function isCanonicalEqual(a, b) {
  if (typeof a !== 'string' || typeof b !== 'string') {
    return false;
  }
  if (a === b) {
    return true; // 快路径:若内存码元已完全相同,直接返回 true
  }
  return a.normalize('NFC') === b.normalize('NFC');
}

// 验证执行
console.log(isCanonicalEqual('é', 'é')); // 示例输出: true
console.log(isCanonicalEqual('Café', 'Café'));  // 示例输出: true
代码优化细节提醒
在调用 normalize() 之前先执行一次原生的 if (a === b) return true; 是非常实用的性能优化技巧。因为大部分常规 ASCII 字符串或已经同源规范化的数据可以直接通过快速比较命中,从而免去进入 Unicode 查表算法的开销。
方案 2:忽略重音符号/附加符的比对(搜索与联想匹配)
在国际化搜索或联想输入框中,用户往往习惯输入不带重音的英文字母(例如输入 resume 期望能检索出 résumé)。这可以通过 NFD 分解后配合正则移除所有 Mark 结合符来实现:
/**
 * 移除字符串中的所有 Unicode 组合重音标记
 * @param {string} str
 * @returns {string}
 */
function stripDiacritics(str) {
  if (typeof str !== 'string') return '';
  // 1. NFD 将 'é' 拆解为 'e' 与 '́'
  // 2. 正则 [̀-ͯ] 匹配 Unicode 范围内的所有 Combining Diacritical Marks
  return str.normalize('NFD').replace(/[̀-ͯ]/g, '');
}

function isAccentInsensitiveEqual(a, b) {
  return stripDiacritics(a).toLowerCase() === stripDiacritics(b).toLowerCase();
}

// 验证执行
console.log(isAccentInsensitiveEqual('résumé', 'RESUME')); // 示例输出: true
console.log(stripDiacritics('François'));                 // 示例输出: "Francois"
方案 3:宽松兼容等价(清洗表单全角、上标与合字)
当处理来自不可控客户端的输入时,用户可能会在半角文本中夹杂全角英数或特殊符号,此时使用 'NFKC' 可以完成格式归一:
/**
 * 宽松兼容比较:消除全半角、排版格式变体
 */
function isLooseEqual(a, b) {
  return a.normalize('NFKC').trim() === b.normalize('NFKC').trim();
}

console.log(isLooseEqual('ABC123', 'ABC123')); // 示例输出: true
console.log(isLooseEqual('office', 'office'));       // 示例输出: true (合字 ffi 自动折叠为 ffi)
四、关键边界、性能权衡与避坑指南
虽然 normalize() 能够彻底解决编码不一致问题,但在工程实践中必须注意以下限制与边界条件:
1. 警惕 NFKC 对数学公式和专用格式的语义破坏
兼容等价(NFKC / NFKD)是有损转换。例如:
- 上标数字:
'x²'.normalize('NFKC')会变成'x2'。如果业务场景是在线数学答题系统或 LaTeX 渲染器,原本的平方运算语义将被严重篡改。 - 分数字符:
'½'.normalize('NFKC')会变成'1/2'(3 个字符)。 - 带圈数字:
'①'.normalize('NFKC')会变成普通的'1'。
因此,对于通用文本比较,务必优先使用无损的 'NFC',仅在明确需要清洗变体时才使用 'NFKC'。
2. normalize() 不处理大小写折叠(Case Folding)
normalize() 的职责仅限于 Unicode 码点形式的规范化,它不会改变字符的大小写。如果需要同时实现“不区分大小写”和“Unicode 等价”,必须配合 .toLowerCase(),或者推荐使用现代标准国际化 API Intl.Collator:
// 方案 A:normalize + toLowerCase
const eqA = a.normalize('NFC').toLowerCase() === b.normalize('NFC').toLowerCase();

// 方案 B:使用支持敏感度配置的原生 Intl.Collator (推荐用于多语言复杂规则)
const collator = new Intl.Collator(undefined, { sensitivity: 'accent' });
// sensitivity: 'base' 忽略大小写和重音;'accent' 考虑重音但忽略大小写
3. 跨操作系统与文件系统的真实陷阱(macOS vs Linux/Windows)
在 Node.js 服务端或桌面端开发(如 Electron)中,文件路径比对是一个经典重灾区:
- macOS 文件系统(HFS+ / APFS):在向文件系统写入带有音标的 Unicode 文件名时,系统底层通常会自动将其分解为类似 NFD 的格式。
- Linux 及现代 Web 标准:网络请求下发和大部分 Linux 文件系统均采用 NFC 格式。
如果不做规范化处理,在 macOS 上通过 fs.readdirSync() 读取出的文件名与前端 HTTP 接口上传的文件名直接用 === 比对,即使肉眼看完全一致,比对也必然返回 false。在读取文件系统路径后进行 path.normalize('NFC') 是必不可少的防坑步骤。
4. 架构性能考量:入库前规范化 vs 实时比对
normalize() 的底层需要遍历字符并查找 Unicode 组合映射表。虽然单次执行耗时通常在微秒级别,但在高并发服务、大数据量数组过滤或数据库百万级查询时,如果每次比对都在循环内调用 normalize(),会产生显著的 CPU 开销。
最佳架构实践:在数据进入系统(如接收 API 请求、解析用户表单、读取外部文件)的第一时间,将字符串统一调用 .normalize('NFC') 规范化后再存入数据库或状态机。在数据落库后,数据库内部的唯一索引和常规查询便可直接依赖原生的快速匹配,无需在查询阶段付出额外性能代价。
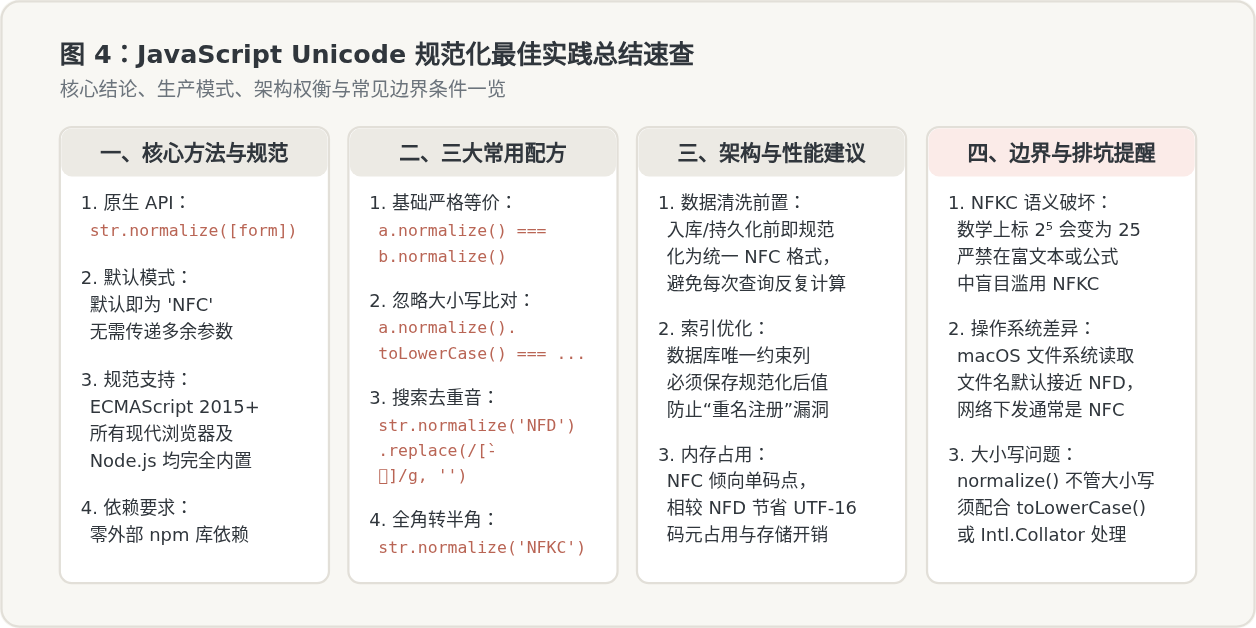
图 4:JavaScript Unicode 规范化最佳实践总结速查
五、总结
在 JavaScript 中进行字符串相等判断时,必须认识到视觉呈现的同一性不等于内存码元的同一性。Unicode 允许单码点预组合(如 é)与多码点序列(如 e + ́)共存,而原生 === 仅比较底层 UTF-16 码元。
借助原生 String.prototype.normalize() 方法,我们可以轻松统一编码结构:常规业务场景推荐统一使用默认的 NFC 模式,搜索过滤可选用 NFD 结合正则剥离音标,表单清洗可按需采用 NFKC。在系统设计上,推行“入库前统一规范化”的原则,能够以最低的性能损耗和最高的可靠性消除 Unicode 比对失效的所有隐患。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章