

深入解析JavaScript中三维数组的遍历机制,全面对比经典三重for循环与ES2019 flat(2)扁平化方法的实现细节、坐标访问能力、内存开销及性能差异,并提供清晰的场景选型指南。
JS怎么遍历三维数组:三重循环与flat方法对比
作者:缓存笔记
时间:2026-11-18
浏览:541
文章目录
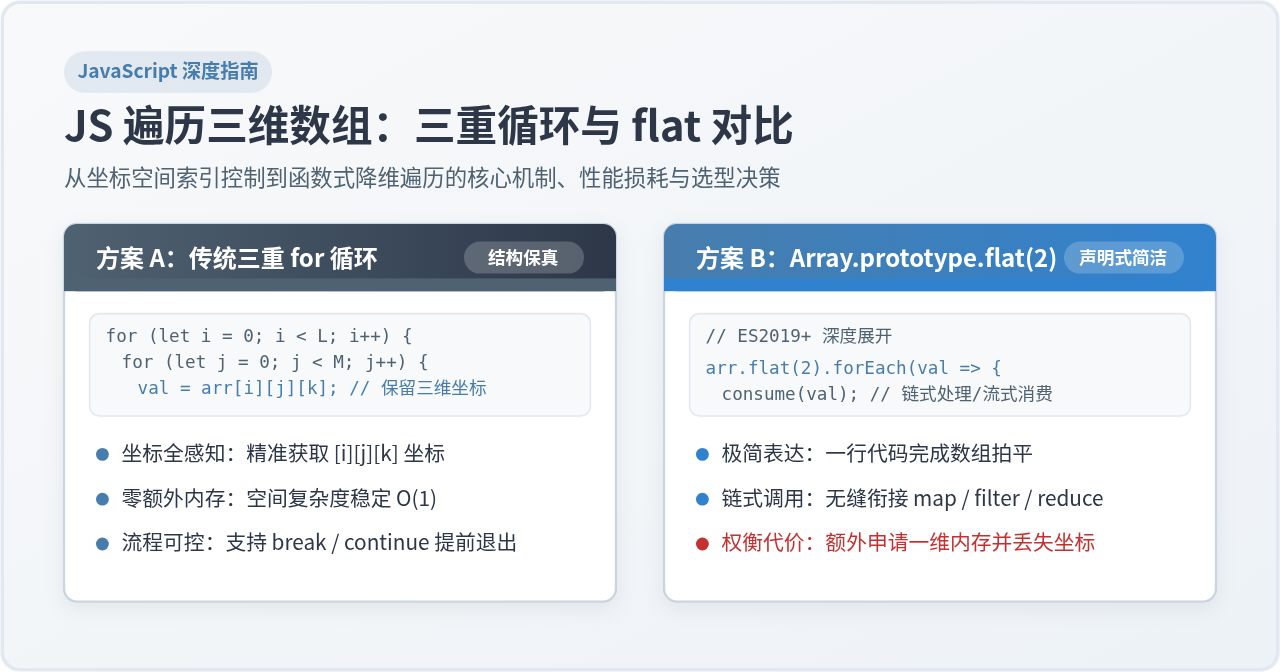
遍历 JavaScript 三维数组的核心在于决定是否保留三维坐标信息:若业务需要精确的深度、行、列索引([i][j][k])或追求极限执行性能与及时中断,经典三重嵌套循环是唯一且高效的选择;若仅需要处理或统计全部元素的值,借助 ES2019 的 Array.prototype.flat(2) 能够通过一行代码完成降维,并无缝衔接 map、filter、reduce 等函数式管道。本文将剖析三维数组的内存逻辑,逐步演示两种核心遍历方式的代码实现,并从坐标追踪、内存开销、中断能力和稀疏处理等关键维度给出明确的对比与选型准则。
一、理解 JavaScript 中的三维数组结构
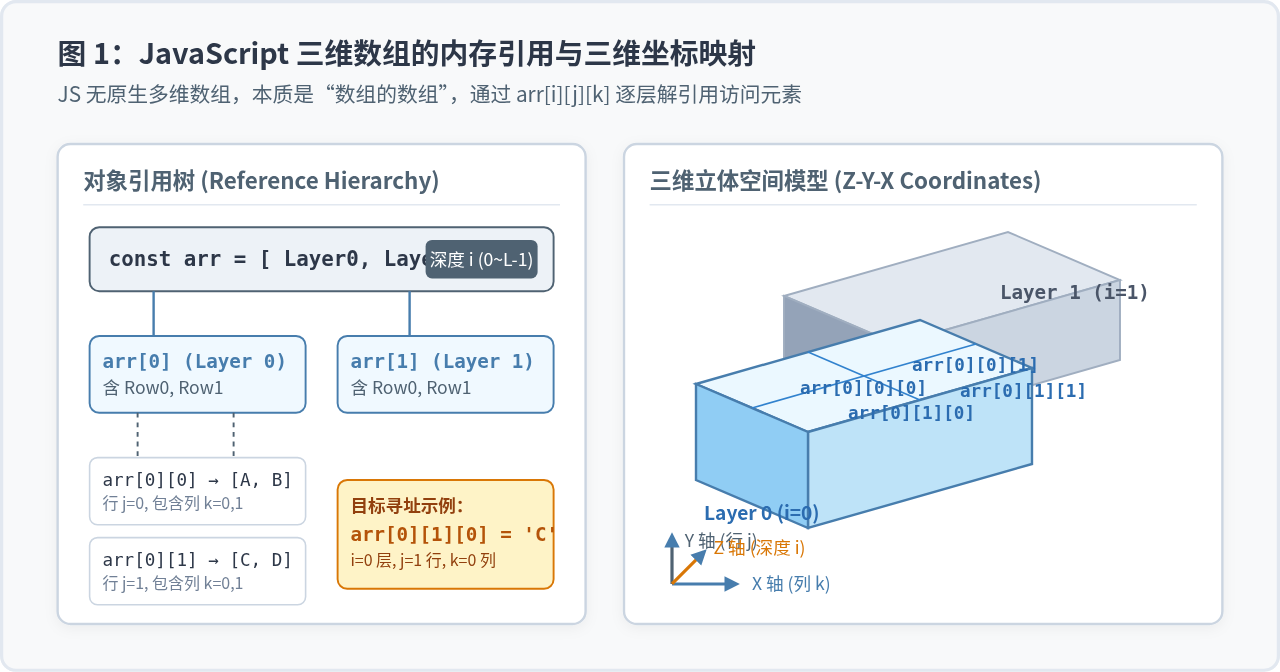
JavaScript 并没有真正意义上的底层多维连续内存矩阵,所谓的三维数组本质上是“元素为二维数组的数组”,即引用嵌套指针结构。一个典型的规整三维数组可以抽象为 arr[层(深度)][行][列],其索引层级由外向内依次展开:
// 定义一个 2层 × 2行 × 3列 的三维数组示例
const cube = [
  // 第 0 层 (i = 0)
  [
    [1, 2, 3],     // 第 0 行 (j = 0): 列 k 为 0, 1, 2
    [4, 5, 6]      // 第 1 行 (j = 1)
  ],
  // 第 1 层 (i = 1)
  [
    [7, 8, 9],     // 第 0 行 (j = 0)
    [10, 11, 12]  // 第 1 行 (j = 1)
  ]
];

// 访问元素示例:获取第 1 层、第 0 行、第 2 列的元素
console.log(cube[1][0][2]); // 输出示例: 9
在内存中,变量 cube 指向最外层包含 2 个元素的对象数组,每个元素又各自指向一个包含二维引用的数组。由于存在这种树状引用关系,当我们在遍历过程中需要精确定位某个数据在空间网格中的位置时,必须依靠这三级索引进行精确定位。
二、方法一:使用三重 for 循环进行层级遍历
三重循环是最经典、最直接的遍历方式。通过外层循环控制深度切片($i$)、中层循环控制行($j$)、内层循环控制列($k$),程序能够严密覆盖立体矩阵中的每一个网格单元。
1. 基础三重 for 循环实现
function traverseByLoops(arr) {
  for (let i = 0; i < arr.length; i++) {
    for (let j = 0; j < arr[i].length; j++) {
      for (let k = 0; k < arr[i][j].length; k++) {
        const val = arr[i][j][k];
        console.log(`坐标 [${i}, ${j}, ${k}] = ${val}`);
      }
    }
  }
}

// 执行示例
traverseByLoops(cube);
// 示例输出片段:
// 坐标 [0, 0, 0] = 1
// 坐标 [0, 0, 1] = 2
// ...
// 坐标 [1, 1, 2] = 12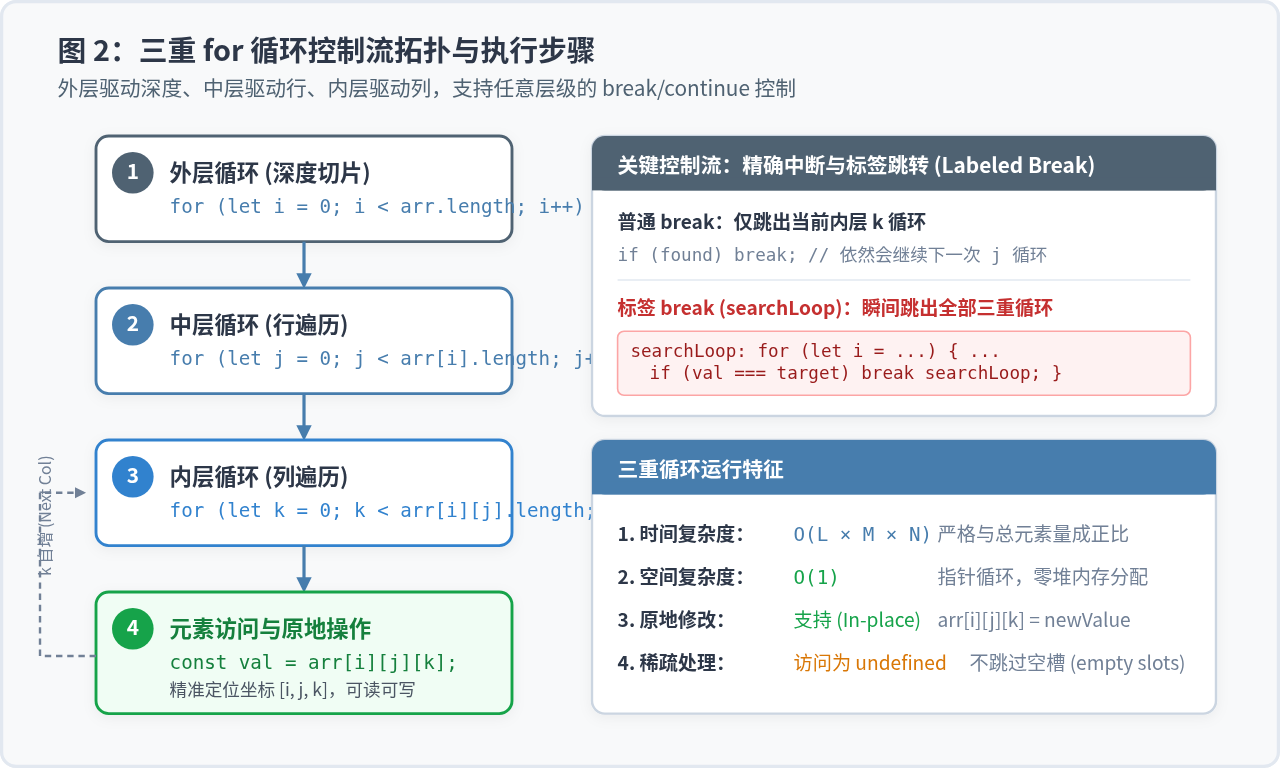
2. 循环控制优势:带标签的提前中断(Labeled Break)
在实际业务中,遍历三维数组往往是为了查找某个符合条件的特定元素或边界状态。如果使用高阶迭代器,通常很难在中途立刻终止深层嵌套;而使用传统 for 循环,配合 标签语句(Label Statement),可以在命中条件时瞬间跳出整整三层循环,避免不必要的冗余计算:
// 寻找目标数值并返回其精确的三维坐标
function findCoordinate(arr, target) {
  let resultCoord = null;

  // 定义最外层循环的标签
  searchLoop:
  for (let i = 0; i < arr.length; i++) {
    for (let j = 0; j < arr[i].length; j++) {
      for (let k = 0; k < arr[i][j].length; k++) {
        if (arr[i][j][k] === target) {
          resultCoord = { i, j, k };
          // 立即跳出全部三重循环,不消耗多余算力
          break searchLoop;
        }
      }
    }
  }

  return resultCoord;
}

const pos = findCoordinate(cube, 5);
console.log(pos); // 示例输出: { i: 0, j: 1, k: 1 }
提示:如果不需要索引下标,也可以使用现代 JavaScript 的
for...of 语句组织三重嵌套,语法稍显清爽,但本质上依然是三次迭代展开,同样支持普通的 break 逐层跳出或函数内部直接 return。
三、方法二:使用 Array.prototype.flat(2) 扁平化遍历
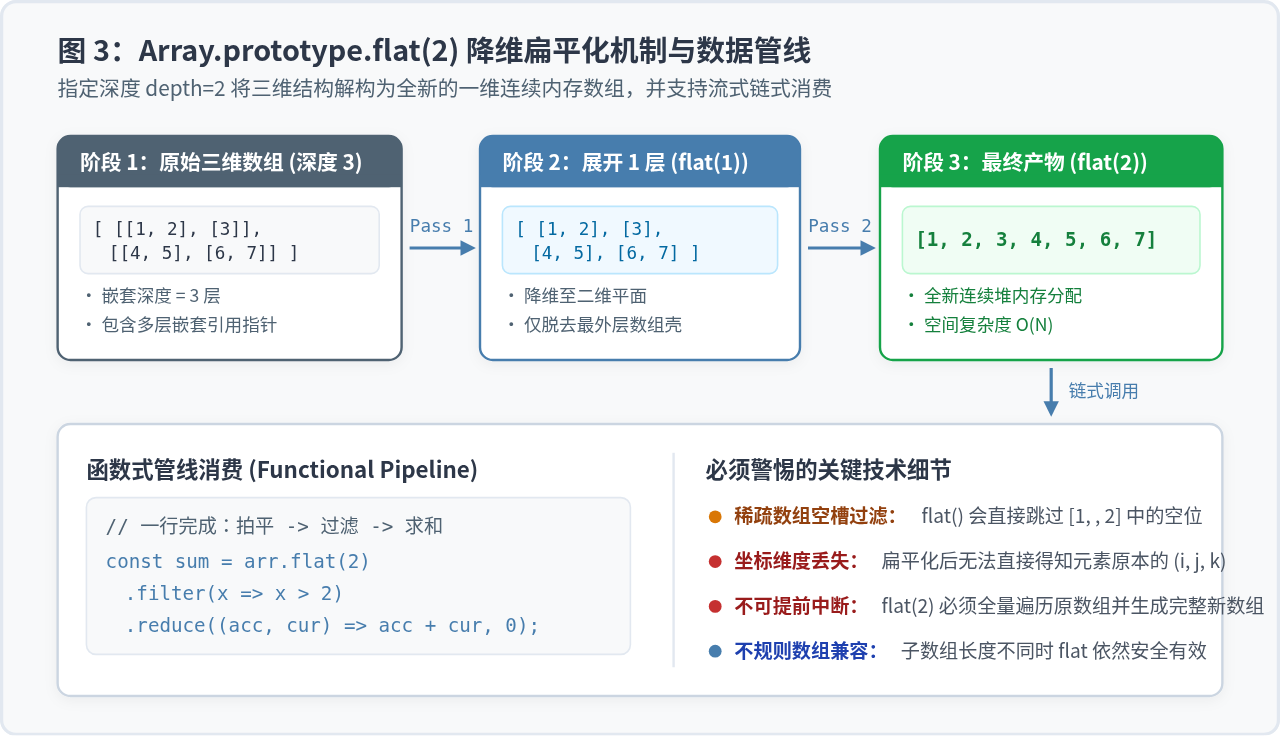
从 ECMAScript 2019 (ES10) 开始,JavaScript 原生引入了 Array.prototype.flat() 方法。该方法能够按照指定的深度递归遍历数组,并将所有元素合并为一个新的一维数组返回。
1. 为什么参数必须是 2?
flat() 方法默认的递归深度为 1。对于三维数组而言:
cube.flat(1):仅展开最外层深度,得到的是包含二维数组的数组;cube.flat(2):递归展开两层,将三维数组彻底拍平为纯粹的单一维度数组;cube.flat(Infinity):无视具体的嵌套层数,统一展开至一维。如果三维数组的某些局部存在更深的不均匀嵌套,传Infinity能确保绝对平整。
2. flat(2) 配合流式消费示例
将三维数组拍平后,我们可以直接通过 forEach 进行遍历,或无缝衔接函数式数组方法:
// 1. 基础扁平化遍历
const flatList = cube.flat(2);
flatList.forEach((val, index) => {
  console.log(`第 ${index} 项值: ${val}`);
});

// 2. 链式聚合统计:求大于 5 的所有奇数的平方和
const aggregateSum = cube
  .flat(2)
  .filter(n => n > 5 && n % 2 !== 0)
  .map(n => n * n)
  .reduce((sum, val) => sum + val, 0);

console.log(aggregateSum); // 示例输出: 7^2 (49) + 9^2 (81) + 11^2 (121) = 251
注意事项:稀疏数组(Sparse Array)的静默过滤
flat() 在执行降维时,会自动忽略数组中的空槽(empty slots),而普通的 for (let i = 0...) 循环则会忠实地访问到空槽并返回 undefined。例如 [ [[1, , 3]] ].flat(2) 的结果为 [1, 3],原有的空槽直接被剔除。如果在业务中空槽包含占位含义,需特别留意此特性。
四、核心差异深度对比:性能、内存与控制能力
虽然两种方案都能完成“访问到每一个数据”的目标,但在计算机底层与工程架构上,两者体现出了完全不同的设计取舍。
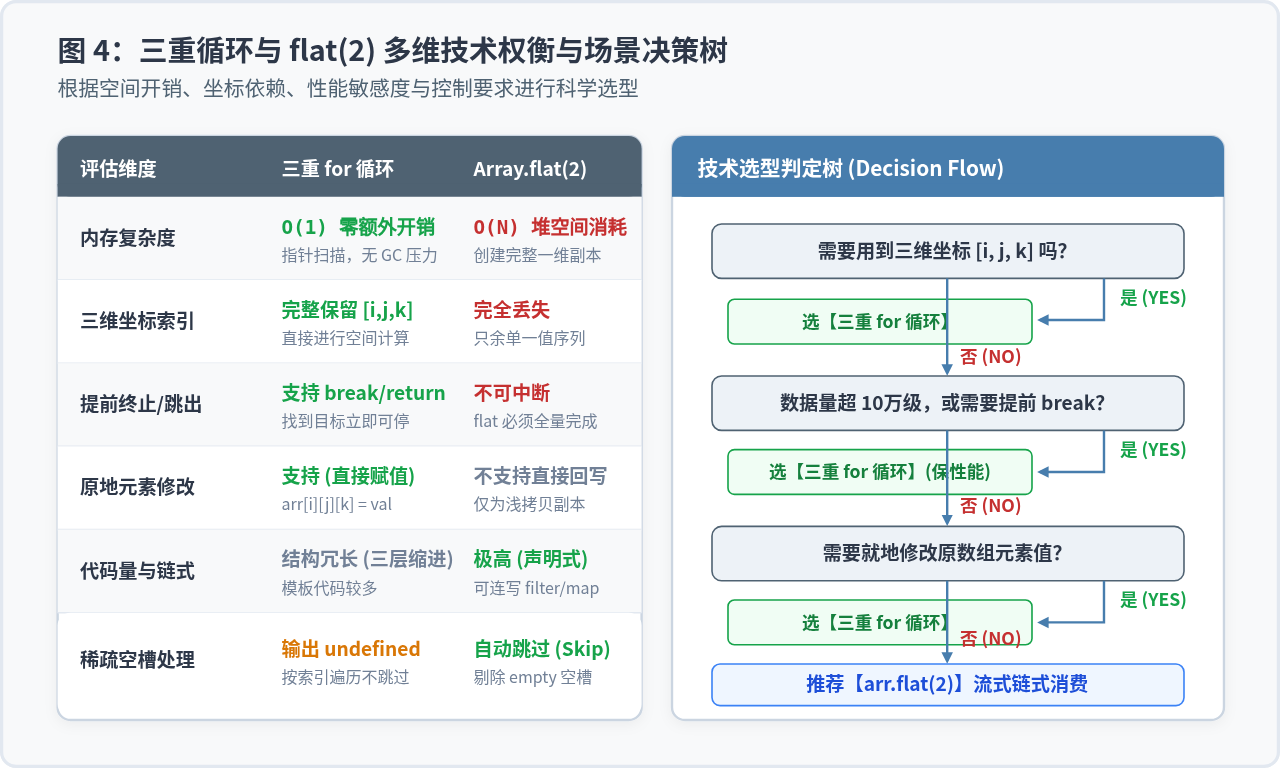
1. 内存与垃圾回收(GC)开销
传统三重 for 循环是在原数组的堆内存上进行索引偏移访问,在遍历期间除了局部数字变量 i, j, k 之外,额外空间复杂度为 $O(1)$。无论是 100 个元素还是 1,000,000 个元素,都不会造成额外的内存申请。
相反,arr.flat(2) 会在底层立即分配一个连续的全新数组实例,并将所有末级元素逐一压入新数组,空间复杂度为 $O(N)$($N$ 为三维数组内所有元素的总和)。当三维数组较大(如医学切片影像矩阵、3D体素网格数据)时,flat(2) 会瞬时激增堆内存占用,随后引发 V8 引擎频繁的垃圾回收(GC Minor/Major Sweep),容易造成界面的偶发性掉帧或卡顿。
2. 坐标感知与原地写操作(In-place Mutation)
- 三重循环:在每一层迭代体中,当前元素的立体坐标
[i, j, k]始终清晰可见;同时可以直接执行arr[i][j][k] = newVal实现原地修改,不产生新内存。 - flat(2):元素被抽取并排列进一维数组后,所有的层级与空间结构信息全部消失。虽然
forEach提供了回调索引,但那只是一维线性序号,无法反推出非规整(不规则长宽深)数组的原始三维位置;且修改拍平后的数组对原多维数组毫无影响。
3. 执行控制力(短路与中断)
flat(2) 在调用发生的瞬间,必须全量、完整地遍历完原始三维数组的所有深层节点,才能生成最终的一维数组。即使你后续使用的是能提前跳出的 some 或 find,在调用 flat(2) 的那一刻,全量开销已经不可逆地发生。而三重循环可以在找到目标的那一毫秒通过 break 立即终止全部计算,这在千万级数据检索场景中往往存在数十倍的性能差距。
| 对比维度 | 三重 for 循环 | Array.prototype.flat(2) |
|---|---|---|
| 语法简洁度 | 嵌套三层,模板代码稍显冗长 | 一行代码声明,支持函数式链式调用 |
| 额外空间复杂度 | O(1) 仅栈变量 | O(N) 创建全新一维连续堆数组 |
| 三维坐标感知 | 天然具备 [i][j][k] 空间上下文 |
完全丢失,仅保留单值流 |
| 原地修改能力 | 支持直接赋值修改源数据 | 不支持直接映射回写 |
| 提前退出能力 | 完美支持 break 标签跳出 |
拍平阶段无法中断,强制全量扫描 |
| 稀疏数组空槽 | 正常按索引访问,读取为 undefined |
自动忽略跳过空槽(empty) |
五、实际场景选型建议与避坑指南
综合上述技术特性,在实际的前端与 Node.js 业务开发中,可以依照以下准则清晰选型:
1. 优先采用【三重 for 循环】的场景
- 空间网格与几何计算:例如三维坐标系空间计算、俄罗斯方块/三维魔方/体素地图渲染、三维热力图生成。这类场景中数据的空间相对位置(上下左右前后)直接依赖
i, j, k坐标参与公式运算。 - 目标检索与早期中断:例如在 3D 矩阵中排查第一个碰撞点、查找第一个异常值或进行有效性校验。三重循环配合
break能够实现毫秒级短路返回。 - 大规模高频运算:在游戏主循环、Canvas 粒子渲染、数据科学算法中,需要极致性能且避免 GC 压力时,三重嵌套循环是唯一的低级优化选择。
- 就地更新状态:需要将立体网格中满足条件的元素原地重置或覆写时。
2. 优先采用【flat(2) 扁平化】的场景
- 数据汇总与纯值统计:只需要计算数组所有数字的总和、求平均值、提取去重后的类别标签、校验是否包含某个值等,无需关注元素具体在哪一层哪一行。
- 业务层数据清洗与管道处理:在管理后台或常规 Web 页面中,数组规模仅在几百至几千项以内,追求代码的简洁可读、维护性高,更偏向声明式函数式代码。
- 自动剔除脏数据中的空槽:利用
flat()天然跳过稀疏空槽的特性,对松散的三维数组进行紧凑化规整。
代码规范小结:在不需要三维坐标且数据量可控的日常业务中,果断使用
arr.flat(2).forEach(...) 提升团队代码可读性;在涉及坐标、原地更新、巨大规模或查找中断的核心逻辑中,坚决保留 三重 for 循环,以获得最高的执行效率与精准控制力。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章