
本文详细介绍在JavaScript中根据条件批量修改数组元素的常用方案,深入解析map不可变更新与forEach就地修改的区别、对象浅拷贝陷阱及性能权衡,提供可直接复用的完整示例与选型指南。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS中怎么根据条件批量修改数组元素?
作者:青柠
时间:2026-11-18
浏览:407
文章目录
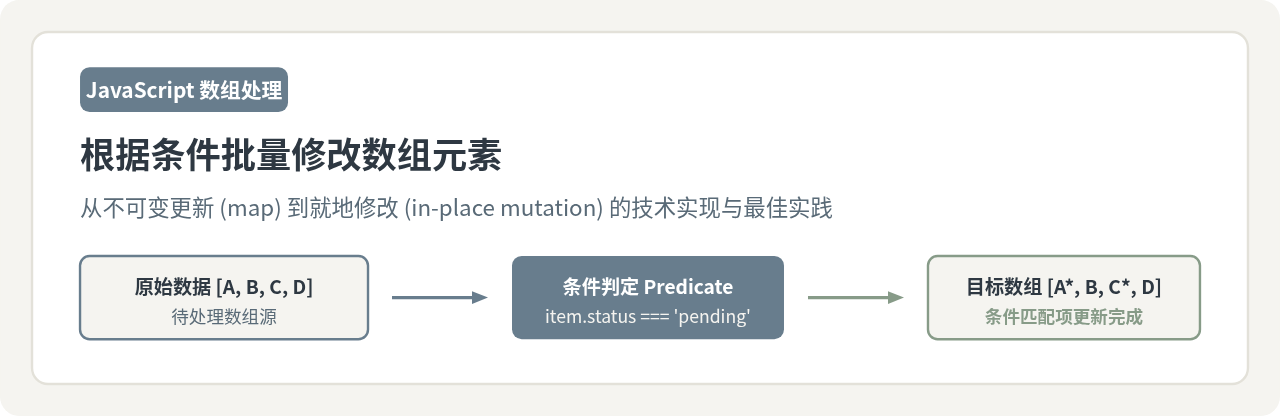
在 JavaScript 中批量修改数组元素,核心方法主要分为两类:一是不可变更新(推荐方式),利用 Array.prototype.map() 遍历并在满足条件时返回修改后的新元素或新对象,生成一个不破坏原数组的新数组;二是就地修改(变异操作),通过 for...of、普通 for 循环或 forEach() 直接修改原数组中的元素或其属性。这两种做法在现代前端开发中的定位截然不同,选型的关键在于是否需要保留原数据引用以及是否处于响应式状态管理中。
一、使用 map() 产生新数组(不可变更新)
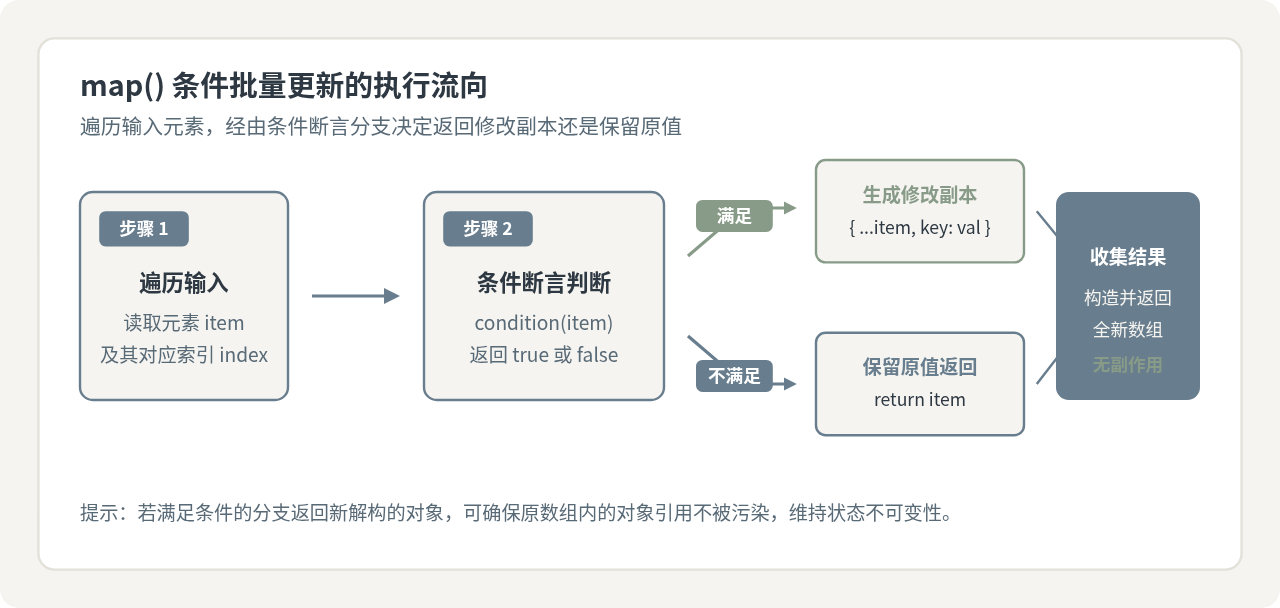
不可变更新是指在更新数据时不直接修改原数组,而是创建一个包含新值的新数组。这种方式符合函数式编程规范,是 React、Vue 等现代框架中状态更新的黄金准则。
1. 基础值类型数组的批量修改
对于数字、字符串或布尔值构成的基础类型数组,只需在 map() 的回调函数中使用三元表达式或条件分支,满足条件时返回新值,不满足时直接返回原元素:
// 示例场景:将所有低于 60 分的成绩统一批量调整为 60 分
const scores = [45, 78, 59, 90, 82, 30];

// 执行条件批量修改
const adjustedScores = scores.map(score => (score < 60 ? 60 : score));

console.log("原数组保持未变:", scores);
// 示例输出: [45, 78, 59, 90, 82, 30]

console.log("批量修改后的新数组:", adjustedScores);
// 示例输出: [60, 78, 60, 90, 82, 60]
2. 对象数组的批量修改
在实际业务中,数组通常由对象组成。此时务必使用对象展开运算符(Object Spread ...item)构造一个全新的对象副本,避免意外修改原始对象。
// 示例场景:将角色为 'guest' 的用户状态批量激活为 active: true
const users = [
  { id: 1, name: "张三", role: "guest", active: false },
  { id: 2, name: "李四", role: "member", active: false },
  { id: 3, name: "王五", role: "guest", active: false }
];

// 条件更新:仅对 role === 'guest' 的项展开并覆盖 active
const updatedUsers = users.map(user => {
  if (user.role === "guest") {
    return { ...user, active: true };
  }
  return user;
});

console.log("更新后新数组:", updatedUsers);
// 示例输出:
// [
//   { id: 1, name: "张三", role: "guest", active: true },
//   { id: 2, name: "李四", role: "member", active: false },
//   { id: 3, name: "王五", role: "guest", active: true }
// ]
二、使用循环就地修改(变异更新)
就地修改(In-place mutation)直接在原始数组的内存空间中修改数据。当面对数十万条超大数据集,或者内存极度受限且明确需要维护原始数组变量引用时,可使用循环来实现。
1. 对象属性的就地更新
修改对象内部属性时,可以使用简洁的 for...of 循环,逐项判断并修改属性:
// 示例场景:检查库存,将所有库存为 0 的商品批量下架
const inventory = [
  { id: 101, name: "机械键盘", stock: 0, available: true },
  { id: 102, name: "无线鼠标", stock: 15, available: true },
  { id: 103, name: "电竞显示器", stock: 0, available: true }
];

for (const item of inventory) {
  if (item.stock === 0) {
    item.available = false; // 直接修改对象引用属性
  }
}

console.log("原数组已被直接修改:", inventory);
// 示例输出:
// [
//   { id: 101, name: "机械键盘", stock: 0, available: false },
//   { id: 102, name: "无线鼠标", stock: 15, available: true },
//   { id: 103, name: "电竞显示器", stock: 0, available: false }
// ]
⚠️ 注意:基础值类型不能使用 for...of 直接赋值
如果数组存储的是数字或字符串,for (let item of list) { if (...) item = newVal } 只能修改局部临时变量 item,无法修改原数组元素。修改基础类型数组必须使用传统下标访问:for (let i = 0; i < list.length; i++) { list[i] = newVal }。
三、两种方式的核心差异与影响
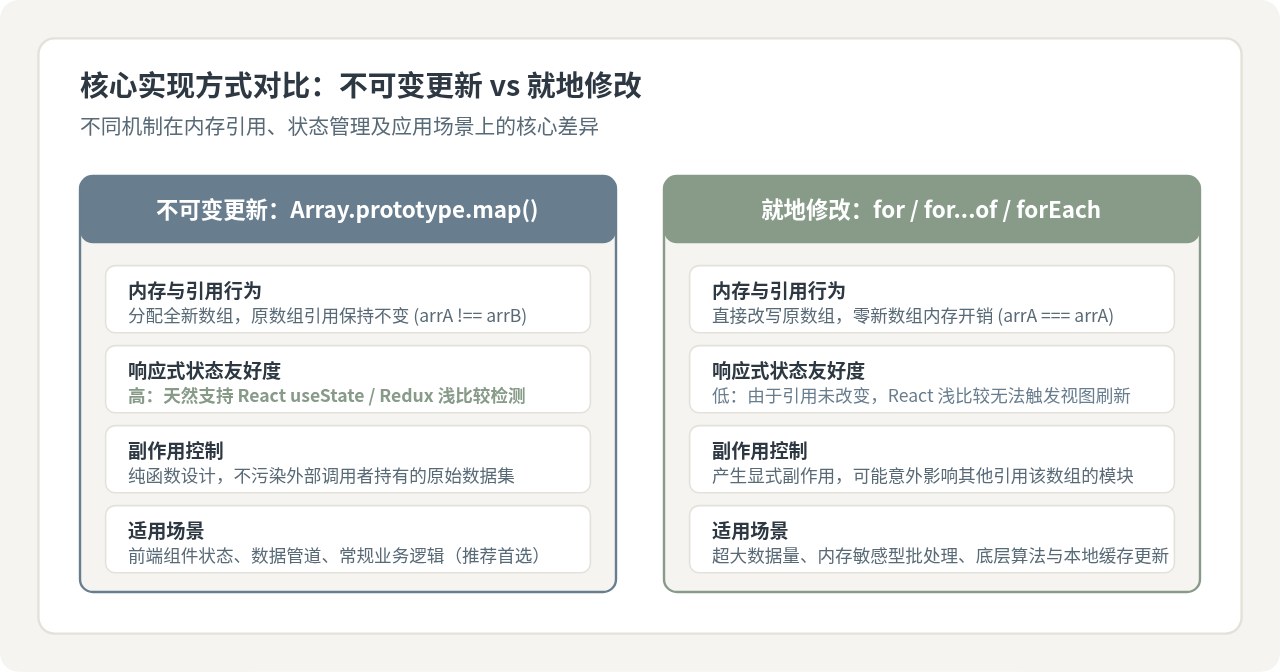
为了在实际开发中做出恰当的技术决策,下表在一致的业务条件下对比了 map() 与就地循环的关键差异:
| 对比维度 | 不可变更新 (map) | 就地修改 (for / forEach) |
|---|---|---|
| 内存分配 | 分配一个全新数组容器,未修改元素共享引用 | 零额外内存开销,直接复用原数组及内存结构 |
| 原数组引用 | 原数组保持不变 (arrOld !== arrNew) |
原数组本身被改动 (arrOld === arrOld) |
| 响应式框架适配 | 天然适配 React、Vue、Redux 的浅比较触发重新渲染 | 由于原数组地址未变,React 等状态检测机制可能静默失效 |
| 函数副作用 | 纯函数无副作用,便于代码测试与时间旅行调试 | 存在副作用,可能引起其他持有该引用的模块发生预期外异常 |
四、常见误区与深浅拷贝陷阱
1. 误区一:在 map 中直接修改对象属性
许多初学者在使用 map() 时会写出如下代码:
// ❌ 错误示范:表面上生成了新数组,实则污染了原对象
const updated = list.map(item => {
  if (item.status === 'pending') {
    item.status = 'done'; // 严重错误:直接修改了原对象的属性!
  }
  return item;
});
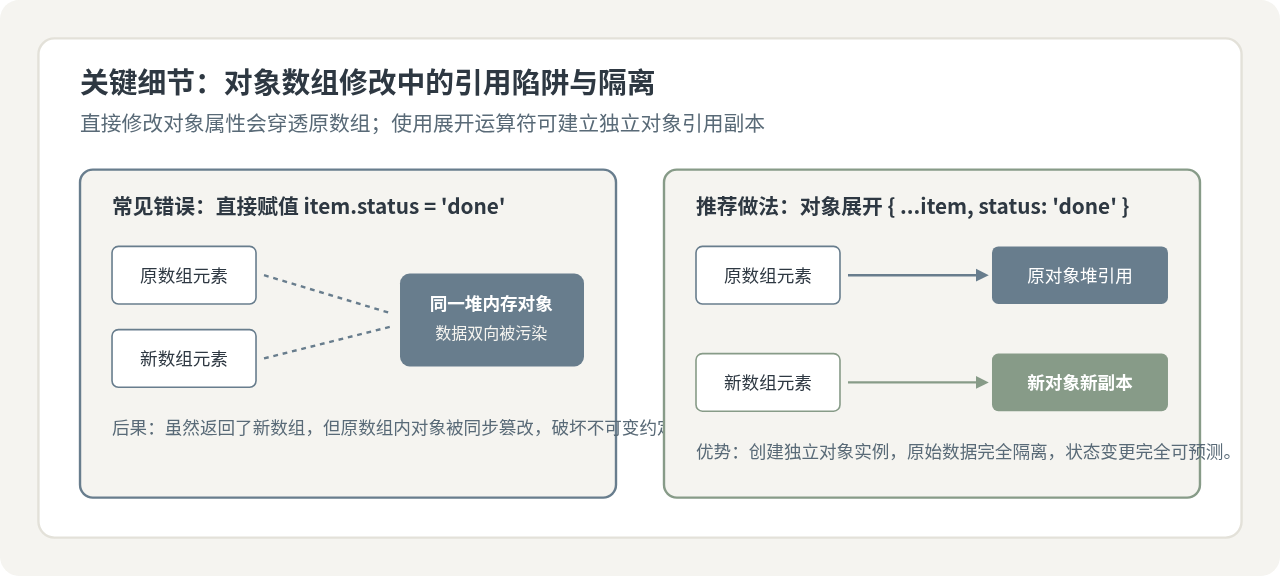
虽然 updated 是一个新数组,但其中每个满足条件的元素与 list 中的元素指向堆内存中的同一个对象。一旦修改了 item.status,原始数组中的数据也同步被改变了,完全失去了不可变数据的安全性。
2. 误区二:多层嵌套对象的浅拷贝失效
使用对象展开运算符 { ...item, status: 'done' } 只能浅拷贝第一层属性。如果对象内部包含嵌套对象(例如 item.meta.counter),修改该深层属性依然会影响原数据。对于多层结构,需要采用层级展开:
// 对深层属性进行不可变更新
const updated = list.map(item => {
  if (item.id === targetId) {
    return {
      ...item,
      meta: {
        ...item.meta,
        counter: item.meta.counter + 1
      }
    };
  }
  return item;
});
3. 误区三:误用 filter() 执行批量修改
filter() 的职责是根据判定条件筛选出元素(改变数组长度),其回调函数应返回布尔值。不要在 filter() 内部去修改元素属性,这违背了方法的设计语义,会导致代码可读性和可维护性大幅下降。
五、选型决策指南与最佳实践
在日常 JavaScript 开发中,可以根据以下三条准则迅速决定使用哪种批量修改方案:
- 前端视图状态更新:只要涉及 React 状态(
useState)、Vue 计算属性或 Vuex/Pinia 状态,统一使用map()配合展开运算符返回新对象。 - 后端数据清洗与管线流转:优先采用
map()链式调用,保持各个处理阶段的数据独立性与纯函数特性。 - 性能临界区与海量数据批处理:若数据量达到几十万级别,且内存占用敏感、无需保留历史快照,使用常规
for循环进行就地修改。
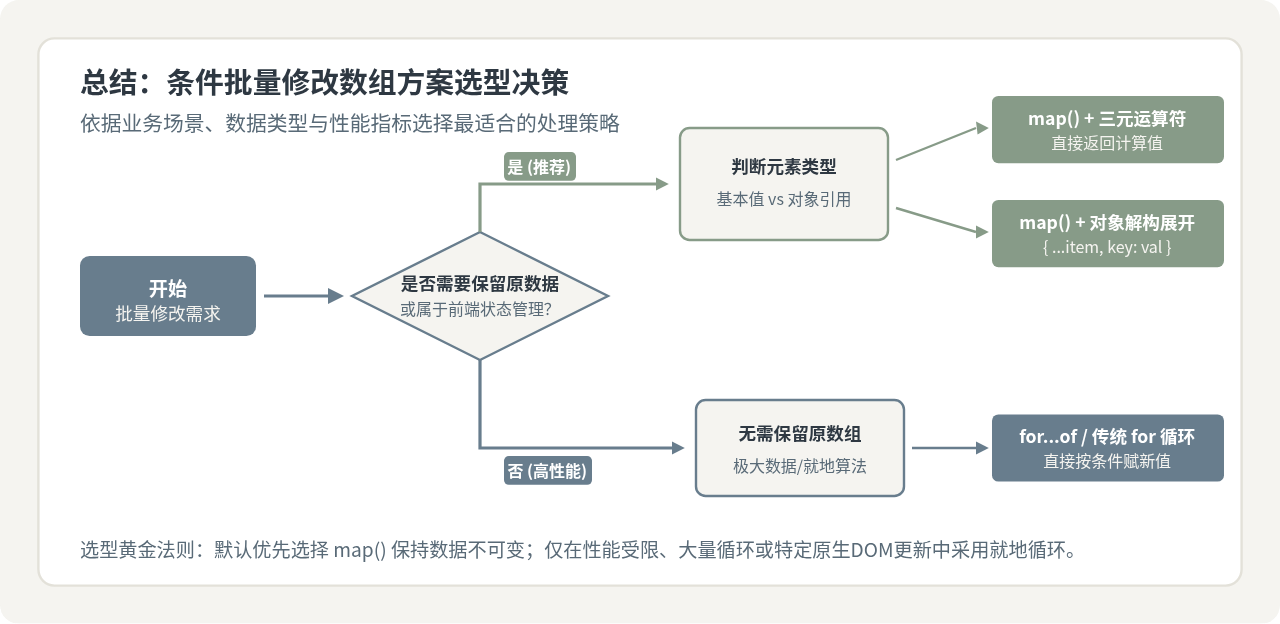
💡 总结速记
日常业务开发:无脑选 map + 对象展开 { ...item, key: val };高性能大批量算法:就地 for 循环按索引更新。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章