

详细讲解在现代浏览器中使用原生DOMParser将XML字符串转换为XMLDocument文档对象,并通过querySelector、getElementsByTagName、textContent及getAttribute精确提取节点文本与属性值的完整流程与避坑指南。
JavaScript使用DOMParser解析XML字符串并提取节点值
作者:窗边听雨
时间:2026-11-18
浏览:391
文章目录
Web 原生 API
DOMParser
XML 解析
运行环境:现代主流浏览器 / 前端运行环境
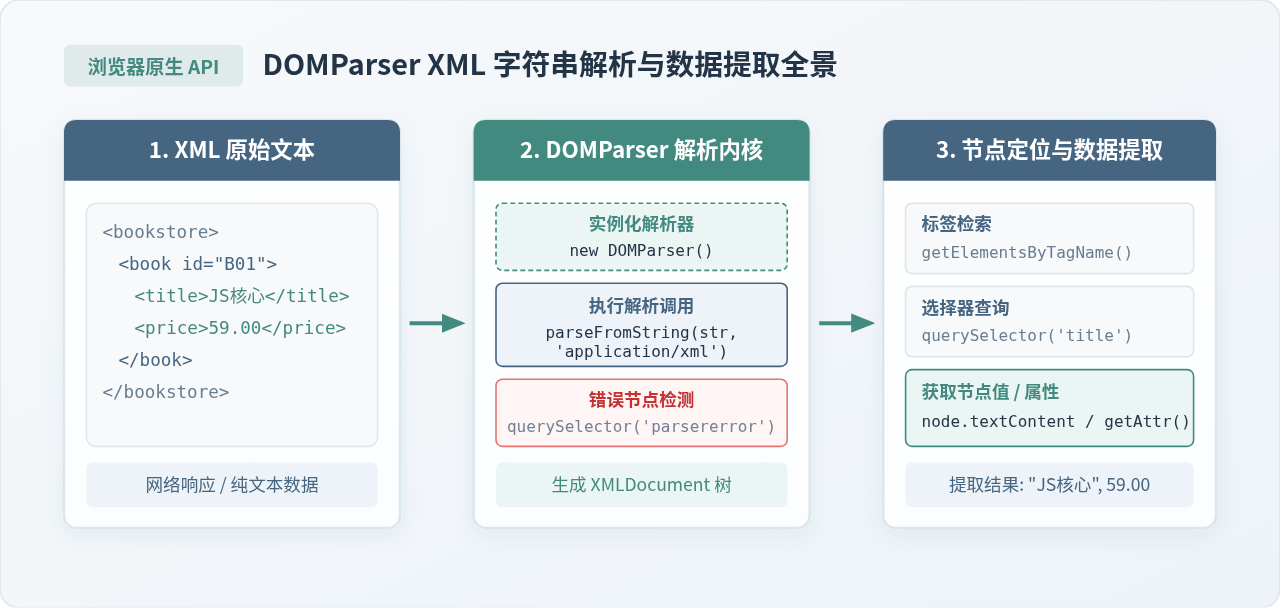
在前端或浏览器端 JavaScript 开发中,将一段 XML 格式的文本字符串转换为可遍历的结构化数据,最直接且标准的原生方案是使用 DOMParser 对象的 parseFromString() 方法。它将 XML 字符串实时解析为符合 W3C 标准的 XMLDocument 文档对象,随后开发者可以直接调用 querySelector、getElementsByTagName、textContent 以及 getAttribute 等 DOM API 精确读取所需节点文本与属性。
一、DOMParser 的基本使用流程
DOMParser 是浏览器原生提供的内置构造函数,不需要引入第三方依赖包。其核心流程分为三步:实例化解析器、调用 parseFromString 将字符串转为 XML 树、然后检索节点取值。
1. 实例化与参数说明
创建解析器非常轻量,通过构造函数直接实例化即可:
// 1. 创建 DOMParser 实例
const parser = new DOMParser();

// 2. 将 XML 字符串解析为 XMLDocument 对象
const xmlDoc = parser.parseFromString(xmlString, 'application/xml');
parseFromString(str, mimeType) 接收两个必选参数:
- str:待解析的原始 XML 字符串。
- mimeType:指定文档解析类型。解析标准 XML 时,应传入
'application/xml'或'text/xml'。二者在现代浏览器中均启用 XML 严谨解析引擎。
2. 简单提取示例
假设从服务端接口或本地获得了一段关于图书信息的 XML 文本:
const xmlText = `
  <bookstore>
    <book id="bk001">
      <title>JavaScript高级程序设计</title>
      <author>马特</author>
      <price>109.00</price>
    </book>
  </bookstore>
`;

const parser = new DOMParser();
const xmlDoc = parser.parseFromString(xmlText, 'application/xml');

// 提取单个标签文本
const title = xmlDoc.querySelector('title').textContent;
const price = xmlDoc.querySelector('price').textContent;

// 提取节点属性
const bookId = xmlDoc.querySelector('book').getAttribute('id');

console.log('书名:', title);  // 输出: 书名: JavaScript高级程序设计
console.log('价格:', price);  // 输出: 价格: 109.00
console.log('编号:', bookId); // 输出: 编号: bk001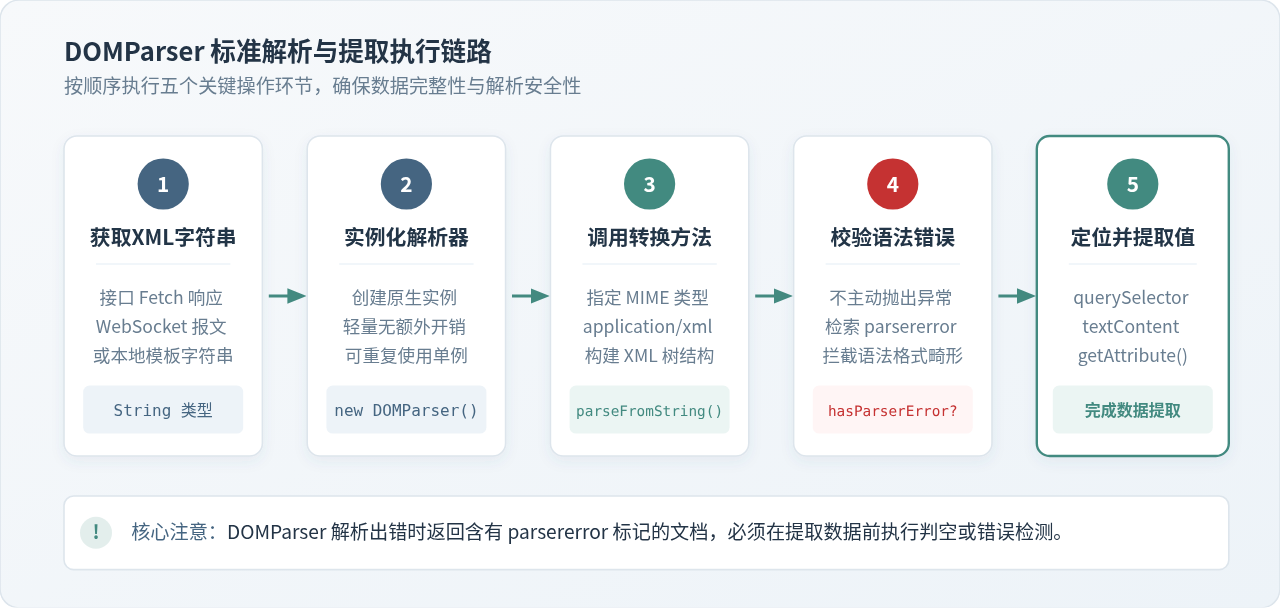
二、关键防御机制:解析错误捕获 (parsererror)
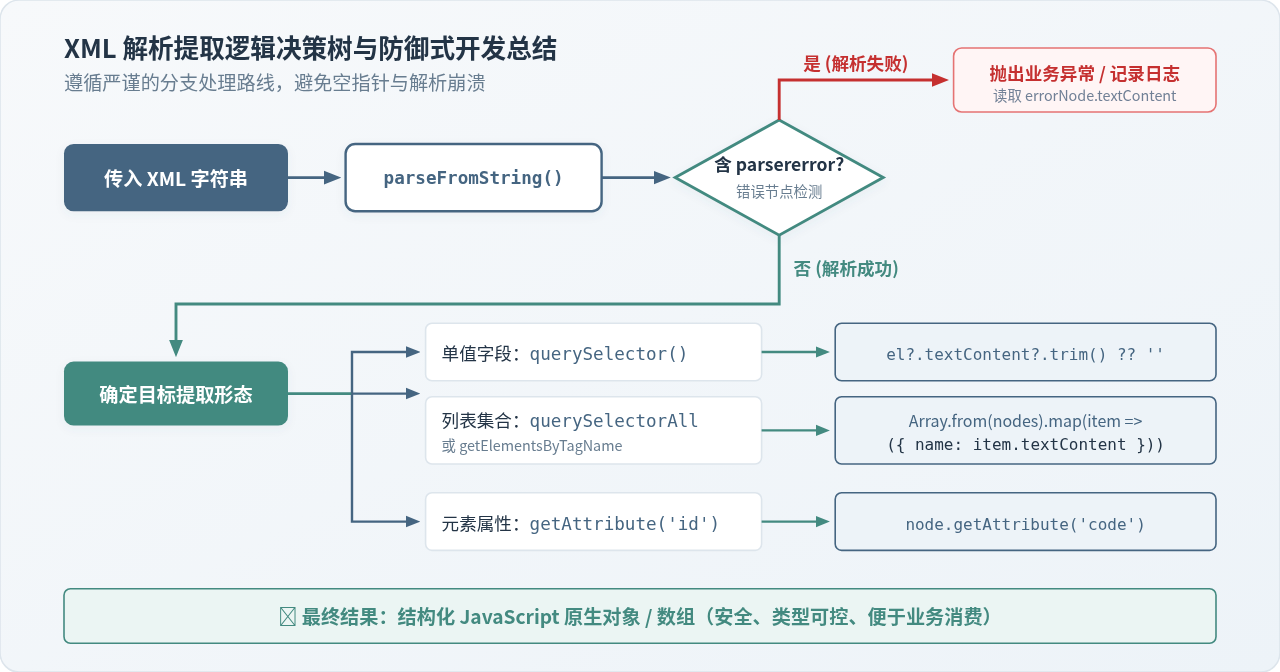
这是使用 DOMParser 时最容易踩坑的细节:当传入的 XML 字符串存在语法错误(如缺少闭合标签、非法字符)时,parseFromString() 并不会像 JSON.parse() 那样主动抛出 JavaScript 异常!
浏览器会生成一个包含 <parsererror> 标签的特殊 XMLDocument。因此,仅用 try...catch 包裹代码无法捕获 XML 语法错误,必须在获取文档后主动检索是否存在 parsererror 节点。
⚠️ 语法错误检测规范
在任何提取操作执行前,务必对 parsererror 进行检查,防止在畸形数据上继续提取导致不可预期的空指针异常或读取到脏数据。
稳健的防御性检测写法如下:
function parseXMLSafe(xmlString) {
  const parser = new DOMParser();
  const xmlDoc = parser.parseFromString(xmlString, 'application/xml');

  // 检索 parsererror 节点
  const errorNode = xmlDoc.querySelector('parsererror');
  if (errorNode) {
    throw new Error('XML 解析失败: ' + errorNode.textContent);
  }

  return xmlDoc;
}

// 验证测试:缺少闭合标签的错误 XML
try {
  const malformedXml = '<root><title>测试标题</root>';
  parseXMLSafe(malformedXml);
} catch (err) {
  console.error(err.message); // 正确捕获到语法解析错误
}
三、XML 节点定位与数据提取的常用方法
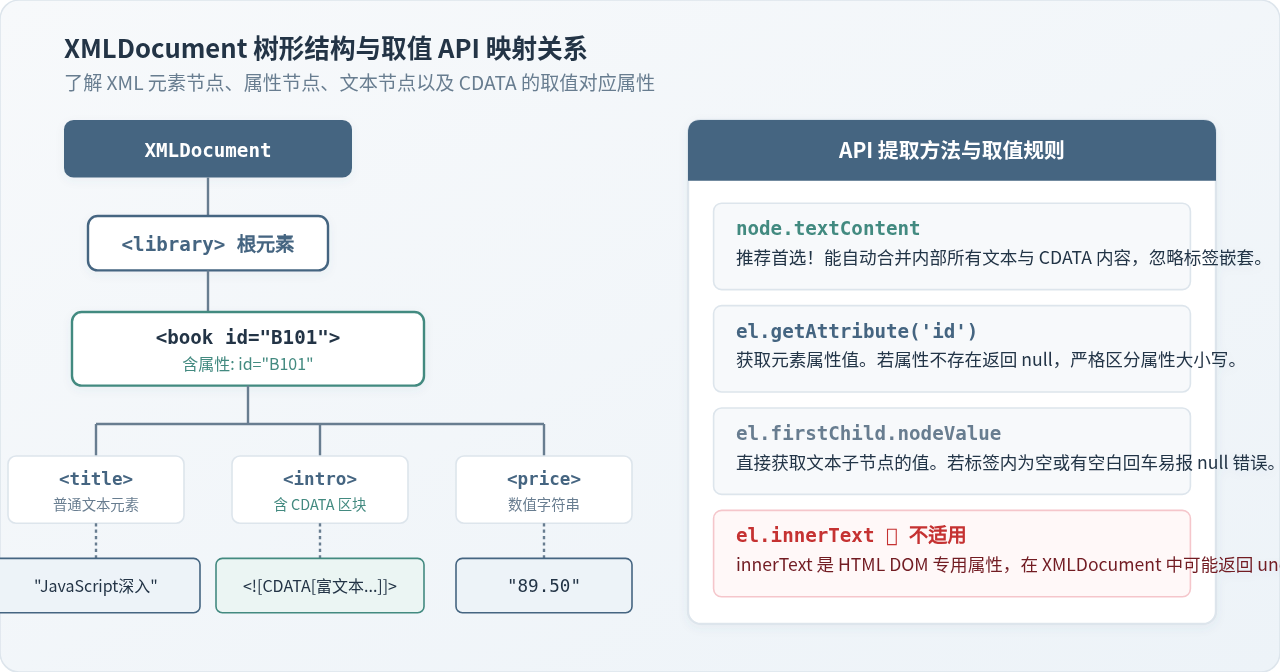
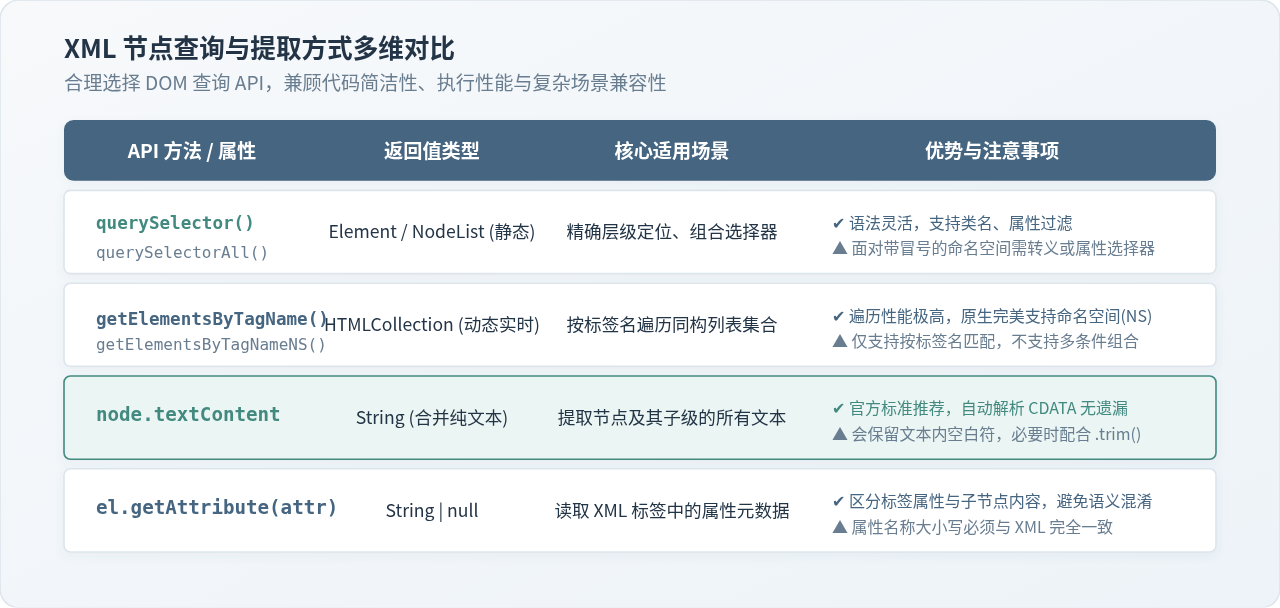
DOMParser 解析出的 XMLDocument 遵循 W3C DOM Core 规范,支持大部分标准的 DOM 查找与取值属性。理解不同方法之间的差异,有助于根据数据结构选择最高效的代码实现。
1. 提取节点文本:为什么首选 textContent?
在 DOM 树中,提取标签内的文字主要有以下几种选择:
-
node.textContent(强烈推荐):返回该节点及其所有子节点的文本内容组合。无论标签内部是普通纯文本,还是包裹在<![CDATA[ ... ]]>区域中的特殊字符,textContent都会自动提取并合并,不会漏掉 CDATA 内容。 -
node.firstChild.nodeValue:仅用于获取文本子节点本身的值。如果标签内部为空(如<title></title>),firstChild为null,此时访问nodeValue会抛出TypeError: Cannot read properties of null。 -
node.innerText(不推荐):这是 HTML 渲染引擎专用的样式感知属性。在纯XMLDocument环境下,它未被严格标准化,部分浏览器内核中直接返回undefined。
2. 获取节点属性值:getAttribute()
当数据保存在标签属性中时(例如 <user id="101" role="admin" />),通过 element.getAttribute('attrName') 读取。
const userNode = xmlDoc.querySelector('user');
const userId = userNode.getAttribute('id');       // "101"
const userRole = userNode.getAttribute('role');   // "admin"
const nonExistent = userNode.getAttribute('foo'); // null
需要注意:XML 严格区分大小写,getAttribute('role') 与 getAttribute('Role') 是两个完全不同的属性。
3. 查询单节点与列表节点:querySelector 与 getElementsByTagName
针对单一节点,使用 querySelector('tag') 最为直观;针对需要遍历的多条同类记录,推荐使用 getElementsByTagName('tag') 或 querySelectorAll('tag'):
// 批量遍历示例
const itemNodes = xmlDoc.getElementsByTagName('item');

for (let i = 0; i < itemNodes.length; i++) {
  const item = itemNodes[i];
  const name = item.getElementsByTagName('name')[0]?.textContent;
  console.log(`第 ${i + 1} 项:`, name);
}
四、完整工程实践示例:解析复杂 XML 并转为 JS 对象
在真实业务场景中,XML 通常包含重复列表、多层嵌套、属性元数据以及 CDATA 富文本。下面提供一个封装完善、带校验的完整数据提取函数:
/**
 * 解析商品目录 XML 字符串并转换为 JavaScript 对象数组
 * @param {string} xmlString - 原始 XML 报文
 * @returns {Array<Object>} 提取后的结构化数组
 */
function parseProductCatalog(xmlString) {
  if (!xmlString || typeof xmlString !== 'string') {
    throw new TypeError('必须传入非空的 XML 字符串');
  }

  const parser = new DOMParser();
  const xmlDoc = parser.parseFromString(xmlString, 'application/xml');

  // 1. 语法检查
  const parseError = xmlDoc.querySelector('parsererror');
  if (parseError) {
    throw new Error('XML 语法错误: ' + parseError.textContent.trim());
  }

  // 2. 获取根容器与商品项列表
  const productNodes = xmlDoc.querySelectorAll('products > product');
  const results = [];

  // 3. 遍历提取字段
  productNodes.forEach((node) => {
    // 提取属性
    const sku = node.getAttribute('sku') || '';
    const status = node.getAttribute('status') || 'normal';

    // 提取子元素文本并安全过滤前后空白
    const name = node.querySelector('name')?.textContent?.trim() || '';
    const priceText = node.querySelector('price')?.textContent?.trim() || '0';
    const description = node.querySelector('description')?.textContent?.trim() || '';

    // 提取多标签分类列表
    const tagElements = node.querySelectorAll('tags > tag');
    const tags = Array.from(tagElements).map(tag => tag.textContent.trim());

    results.push({
      sku,
      status,
      name,
      price: parseFloat(priceText),
      description,
      tags
    });
  });

  return results;
}

// 模拟待解析的复杂 XML 字符串
const sampleXML = `<?xml version="1.0" encoding="UTF-8"?>
<catalog>
  <products>
    <product sku="PROD-901" status="active">
      <name>4K 随身录音笔</name>
      <price>399.00</price>
      <description><![CDATA[支持 <AI智能降噪> 与实时转写,续航约 18 小时。]]></description>
      <tags>
        <tag>音频硬件</tag>
        <tag>办公配件</tag>
      </tags>
    </product>
    <product sku="PROD-902" status="out_of_stock">
      <name>人体工学机械键盘</name>
      <price>529.50</price>
      <description><![CDATA[热插拔轴体,支持三模连接。]]></description>
      <tags>
        <tag>电脑外设</tag>
      </tags>
    </product>
  </products>
</catalog>`;

// 执行解析与提取
const productList = parseProductCatalog(sampleXML);
console.log('解析完成,提取到的结构化数据:', productList);
执行结果说明:
// productList 数组提取结果示例
[
  {
    sku: "PROD-901",
    status: "active",
    name: "4K 随身录音笔",
    price: 399,
    description: "支持 <AI智能降噪> 与实时转写,续航约 18 小时。",
    tags: ["音频硬件", "办公配件"]
  },
  {
    sku: "PROD-902",
    status: "out_of_stock",
    name: "人体工学机械键盘",
    price: 529.5,
    description: "热插拔轴体,支持三模连接。",
    tags: ["电脑外设"]
  }
]
五、常见问题与注意事项
| 易错环节 | 具体表现与成因 | 解决方案与规范做法 |
|---|---|---|
| 命名空间前缀 | 标签带冒号(如 <media:content>)时,直接用 querySelector('media:content') 会报 CSS 语法选择器错误。 |
使用 getElementsByTagNameNS(),或者转义冒号 querySelector('media\\:content'),亦可用属性选择器 querySelector('*[local-name()="content"]')。 |
| Node.js 运行环境差异 | 在服务端 Node.js 环境中执行 new DOMParser() 会报错 ReferenceError: DOMParser is not defined。 |
DOMParser 属于 Web API。在 Node.js 中需引入开源库 @xmldom/xmldom 或使用 fast-xml-parser。 |
| 大小写敏感性 | XML 标签严格区分大小写。写成 querySelector('Title') 无法命中 <title>。 |
保持查询选择器与原 XML 中的标签、属性大小写完全一致。 |
| 空节点与空白字符 | 格式化后的 XML 常含有回车换行与空格,直接读取 childNodes[0] 往往得到换行文本节点。 |
统一使用 children 代替 childNodes,或使用 textContent.trim() 忽略无用缩进与空白。 |
总结而言,使用 DOMParser 解析 XML 字符串的关键在于“先校验 parsererror,再提取 textContent”。掌握标准 DOM 选择器的使用,配合属性读取与安全链式调用(可选链操作符 ?.),即可在浏览器端稳定、高效地提取任何结构化 XML 数据。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章