
深入讲解在JavaScript中解析HTML表格并将表头自动映射为对象键的实现方案,涵盖基础提取方法、空白字符清洗、重名与空表头容错、合并单元格应对策略及完整工具函数。

当前位置:首页 > JavaScript DOM 与事件 > 正文
JS提取表格数据时怎么自动匹配表头作为Key
作者:流萤
时间:2026-11-18
浏览:242
文章目录
分类:前端开发 / 数据处理
环境:浏览器 DOM API / ES6+
阅读时间:约 7 分钟
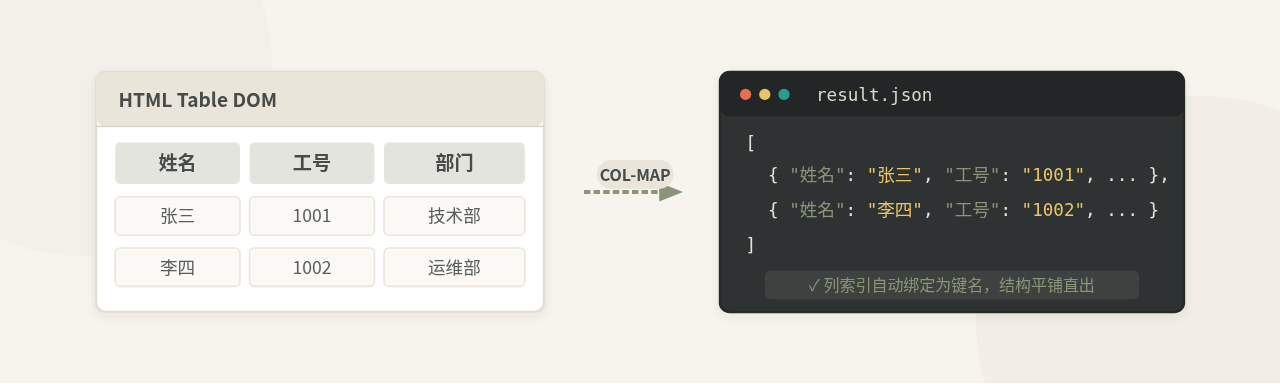
在 JavaScript 中提取 HTML 表格数据并转换为对象数组,核心思路分为两步:先提取表头单元格文本并清理多余空白作为键名数组(Keys),再遍历每行数据单元格(Cells),依列索引下标一一配对构成结构化对象。本文将针对这一具体场景,给出标准实现代码,并深入剖析空白换行、重名空表头及合并单元格等边界异常的处理方案。
一、核心思路:两阶段映射机制
前端网页中的表格(<table>)本质上是由行(<tr>)与格(<th>/<td>)构成的二维网状结构。当我们希望将其转换为便于前端渲染、图表分析或提交给后端接口的结构化 JSON(即对象数组 Array<Object>)时,关键就在于确立“列索引(Column Index)”与“属性键(Object Key)”之间的对应关系。
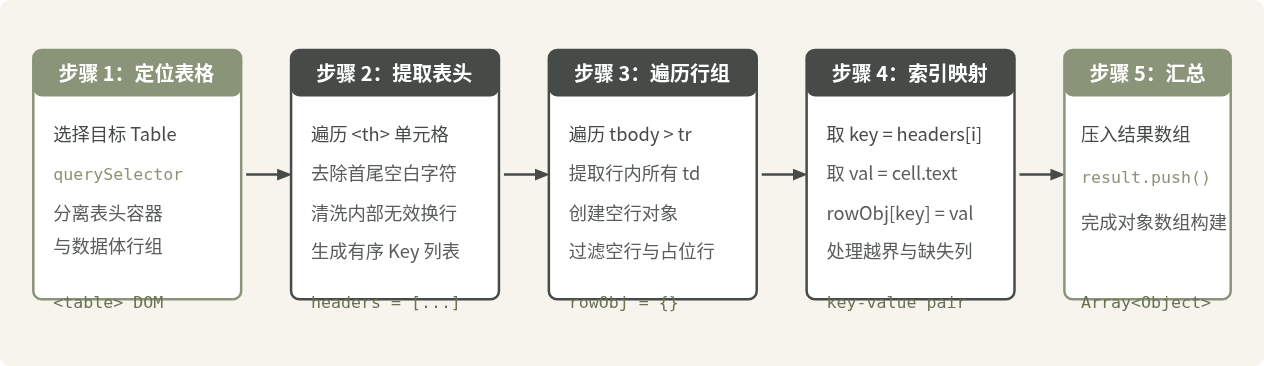
在提取过程中,程序并不需要感知每列具体代表什么业务含义,而是执行一个确定性的管道:
- 扫描表头(Header Scanning): 定位
<thead>内的所有<th>单元格(或表格首行的单元格),提取其文本内容,清洗修剪后存为键名数组keys,例如["姓名", "工号", "部门"]。 - 逐行对齐(Row Iteration): 定位
<tbody>内的每行<tr>,获取其包含的<td>集合。 - 下标注值(Index Matching): 遍历行内各单元格,将当前单元格的下标
colIndex对应的keys[colIndex]作为属性键,单元格文本作为属性值,组合出本行的单条数据对象。
二、基础实现代码:标准表格提取
面对结构规范(具备标准 <thead> 与 <tbody>、且无单元格跨列合并)的常规数据表格,使用现代原生 JavaScript(ES6)仅需十余行代码即可快速完成提取。
1. 目标 HTML 表格结构示例
<table id="employeeTable">
  <thead>
    <tr>
      <th>姓名</th>
      <th>工号</th>
      <th>部门</th>
      <th>入职年份</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>张三</td>
      <td>1001</td>
      <td>技术研发部</td>
      <td>2021</td>
    </tr>
    <tr>
      <td>李四</td>
      <td>1002</td>
      <td>系统运维部</td>
      <td>2023</td>
    </tr>
  </tbody>
</table>
2. 原生 JavaScript 提取逻辑
代码中,我们通过 Array.from() 将 DOM 返回的类数组 NodeList 转换为真正的数组,从而能够灵活调用 .map() 和 .reduce() 组合数据:
function extractTableData(tableSelector) {
  const table = typeof tableSelector === 'string'
    ? document.querySelector(tableSelector)
    : tableSelector;

  if (!table) return [];

  // 1. 自动提取表头,提取文本并清理首尾多余空格
  const headerCells = table.querySelectorAll('thead th');
  const headers = Array.from(headerCells).map(th => th.textContent.trim());

  // 2. 遍历每一条数据行
  const rows = table.querySelectorAll('tbody tr');
  const result = Array.from(rows).map(row => {
    const cells = row.querySelectorAll('td');
    const rowObject = {};

    // 3. 将列下标与表头 Key 进行自动匹配
    cells.forEach((cell, index) => {
      const key = headers[index] || `col_${index}`;
      rowObject[key] = cell.textContent.trim();
    });

    return rowObject;
  });

  return result;
}

// 执行提取
const data = extractTableData('#employeeTable');
console.table(data);
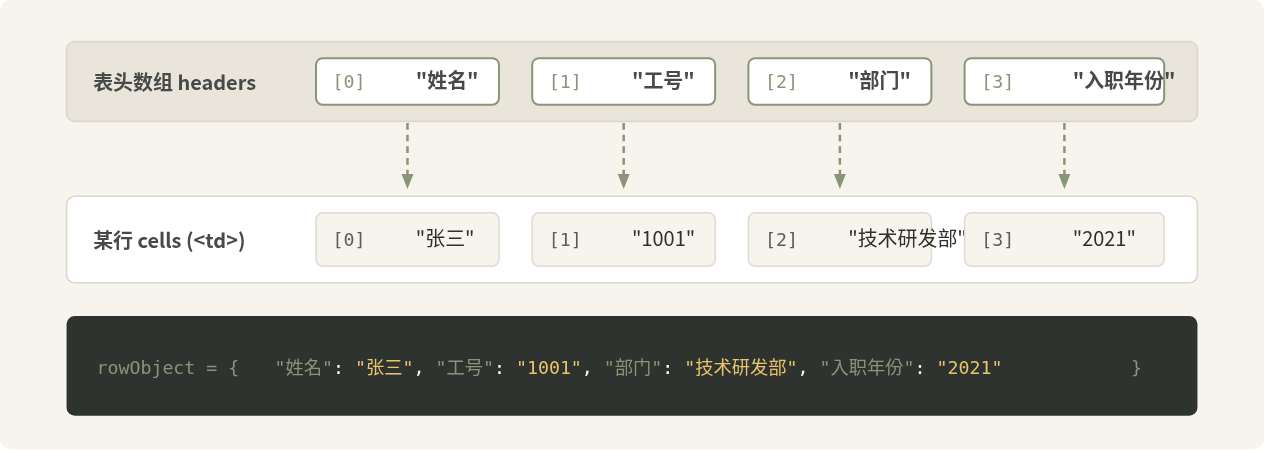
在控制台中执行上述代码,得到的 data 即为自动匹配表头的标准数组对象:
// 示例控制台输出:
[
  { "姓名": "张三", "工号": "1001", "部门": "技术研发部", "入职年份": "2021" },
  { "姓名": "李四", "工号": "1002", "部门": "系统运维部", "入职年份": "2023" }
]
三、实践辨析:那些看似合理却容易踩坑的写法
基础写法在处理教科书般的 Demo 表格时很顺畅,但在真实业务网页(如第三方报表系统、后台管理系统、爬虫提取场景)中,直接执行往往会遇到各种数据错位或属性丢失。以下梳理几个最典型的认知误区与修正方案。
1. 误区一:直接使用 th.innerText 还是 th.textContent?
很多开发者习惯直接取 th.innerText,这在大多数情况下看似正常,但两者有关键区别:
innerText会触发重排(Reflow):innerText依赖浏览器的页面排版与样式计算,它会忽略隐藏元素(如设置了display: none的过滤标签),但在遍历大型表格时,频繁读取innerText会造成明显的性能卡顿。textContent保留内部换行与缩进:textContent性能极高且通用,但如果 HTML 模板源码排版为:
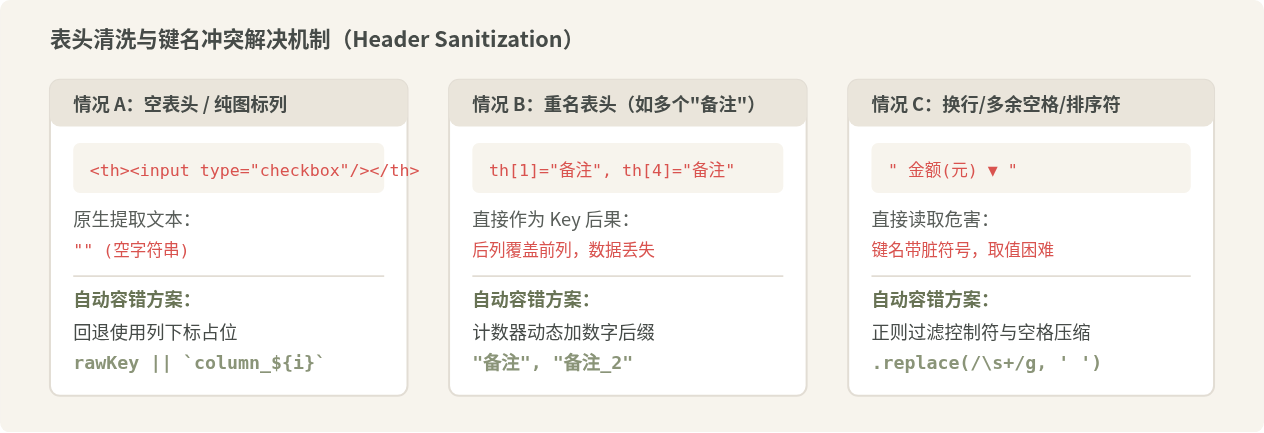
直接读取<th> 用户名称 <span class="sort-icon">▲</span> </th>textContent会得到" 用户名称 ▲ "。如果直接当成 Key,后续访问row["用户名称"]就会报undefined。- 修正做法: 使用
textContent保证性能,但必须配合正则清洗掉内部排序图标与压缩多余空白:th.textContent.replace(/\s+/g, ' ').trim(),若表头包含排序箭头等无关子节点,可优先仅获取文本节点或使用选择器排除。
2. 误区二:认为表格一定有 <thead>
很多由旧系统或 Markdown 生成器转换而来的表格并没有 <thead> 标签,所有的行都直接放在 <table> 或 <tbody> 下,表头仅仅是第一行 <tr>(里面可能是 <th> 也可能是 <td>)。
如果写死 table.querySelectorAll('thead th'),在无 thead 的表格上会直接取到空数组,导致后续所有数据行都被赋上了 col_0、col_1 甚至无法生成 Key。
修正逻辑: 优先查找 thead tr,若不存在,则以首行 table.rows[0] 作为表头行,提取其中的单元格;之后遍历数据行时从第二行(索引为 1)开始。
3. 误区三:忽略重名表头与空表头
现实中的表格经常存在最后一列为“操作”(包含“编辑”、“删除”按钮),或者某些列只有勾选框而表头文本为空;甚至有的业务表格不同列都叫“备注”或“金额”。
- 空表头(Empty Header): 如果单元格文本为空字符串
"",直接作为 Key 会产生{ "": "编辑" }这样极不规范的对象属性。 - 重名表头(Duplicate Header): JavaScript 对象的 Key 是唯一的。如果有两个表头都叫“金额”,后面的列值会直接覆盖前面的列值,导致前面的数据无声丢失。
四、工业级健壮方案:完整实现函数
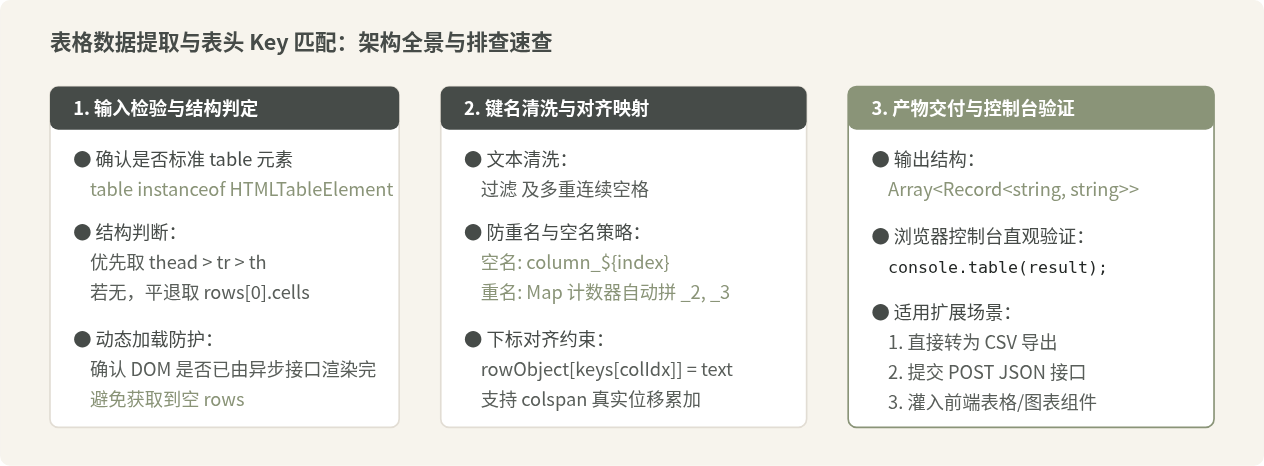
为了让代码能够在实际各类复杂网页中直接稳定运行,我们可以编写一个更加完善的工具函数 tableToJSON(tableElement, options)。它具备自动识别表头行位置、重名自动防冲突后缀、空值安全回退以及行单元格越界保护能力。
/**
 * 将 HTML 表格安全提取为对象数组,自动将表头映射为 Key
 * @param {HTMLTableElement|string} tableSelector 表格 DOM 节点或选择器
 * @param {Object} [options] 可选配置项
 * @param {boolean} [options.cleanKeys=true] 是否自动清理键名中的换行与首尾空白
 * @param {string} [options.fallbackPrefix='column'] 空表头时的替补前缀
 * @returns {Array<Object>}
 */
function tableToJSON(tableSelector, options = {}) {
  const {
    cleanKeys = true,
    fallbackPrefix = 'column'
  } = options;

  const table = typeof tableSelector === 'string'
    ? document.querySelector(tableSelector)
    : tableSelector;

  if (!table || !(table instanceof HTMLTableElement)) {
    console.warn('[tableToJSON] 未找到有效表格元素');
    return [];
  }

  // 1. 确定表头行与数据行
  let headerRow = null;
  const dataRows = [];

  const thead = table.querySelector('thead');
  if (thead) {
    headerRow = thead.querySelector('tr');
    // 如果有 tbody,则提取 tbody 内的行;否则取 thead 后的兄弟 tr
    const tbody = table.querySelector('tbody');
    const trList = tbody ? tbody.querySelectorAll('tr') : table.querySelectorAll('tr');
    trList.forEach(tr => {
      if (tr !== headerRow) dataRows.push(tr);
    });
  } else {
    // 无 thead 结构时,取全表第 1 行为表头,剩余行为数据行
    const allRows = Array.from(table.rows);
    if (allRows.length === 0) return [];
    headerRow = allRows[0];
    dataRows.push(...allRows.slice(1));
  }

  if (!headerRow) return [];

  // 2. 提取并清洗表头生成唯一 Keys
  const headerCells = Array.from(headerRow.cells);
  const keyCounter = new Map(); // 用于处理重名表头
  const keys = headerCells.map((cell, index) => {
    let rawText = cell.textContent || '';
    if (cleanKeys) {
      // 去除多余控制字符、将多个换行或空格收拢为一个单空格并 trim
      rawText = rawText.replace(/[
	]+/g, ' ').replace(/\s+/g, ' ').trim();
    }

    // 若表头纯空,回退为前缀加下标,例如 column_0
    let keyName = rawText.length > 0 ? rawText : `${fallbackPrefix}_${index}`;

    // 处理重名冲突:若已存在相同 key,自动递增后缀
    if (keyCounter.has(keyName)) {
      const count = keyCounter.get(keyName) + 1;
      keyCounter.set(keyName, count);
      keyName = `${keyName}_${count}`;
    } else {
      keyCounter.set(keyName, 1);
    }

    return keyName;
  });

  // 3. 逐行遍历组装对象
  const result = [];
  dataRows.forEach(row => {
    const cells = Array.from(row.cells);
    // 过滤掉包含非数据提示(如纯空行、加载占位)的无效 tr
    if (cells.length === 0) return;

    const rowObj = {};
    cells.forEach((cell, colIndex) => {
      // 若当前行单元格数量超出表头长度,以 fallbackPrefix 补齐
      const key = keys[colIndex] || `${fallbackPrefix}_${colIndex}`;
      let cellText = cell.textContent || '';
      if (cleanKeys) {
        cellText = cellText.replace(/[
	]+/g, ' ').replace(/\s+/g, ' ').trim();
      }
      rowObj[key] = cellText;
    });

    result.push(rowObj);
  });

  return result;
}
参数说明与适用范围:
该函数直接接收页面内的原生
<table> 元素或 CSS 选择器字符串。通过 row.cells 属性直接读取,相比 querySelectorAll('td') 更符合 DOM 原生表格结构标准,并且自动兼顾无 thead 的扁平表格场景。
五、进阶场景:合并单元格(Colspan)怎么办?
当遇到具有 colspan 属性的合并单元格时,初学者最容易产生疑问:“为什么此时通过下标直接映射会发生整行数据错位?”
原因在于:在 HTML DOM 中,一个设置了 colspan="2" 的单元格在行内只占用一个 <td> 节点对象。如果第一列合并了 2 列,该行实际只有 3 个 <td> 元素,其 cells[1] 实际上对应的是表头的第 3 列(索引 2)。如果仍简单通过 keys[colIndex] 配对,从第 2 个单元格开始全部都会“向左抢占”,产生大面积列错位。
解决跨列合并的核心原则是:将合并单元格在逻辑上“展开”为其所占跨度的真实列索引偏移量。
// 考虑 colspan 的真实偏移量映射思路片段
let logicalColIndex = 0;
cells.forEach(cell => {
  const span = parseInt(cell.getAttribute('colspan') || '1', 10);
  const key = keys[logicalColIndex] || `col_${logicalColIndex}`;
  rowObj[key] = cell.textContent.trim();

  // 如果当前单元格跨越了多列,后续如果需要记录占位,可填充空字符串或跳过索引
  logicalColIndex += span;
});
六、验证结果与操作指引
完成代码编写后,可在 Chrome、Edge 或 Firefox 等浏览器的开发者工具(F12)中进行验证:
- 打开包含目标表格的网页,按
F12打开“控制台”(Console)。 - 将第四节提供的
tableToJSON函数复制并粘贴进控制台中按回车。 - 在控制台输入:
const result = tableToJSON('table'); // 若有具体 ID 可写 '#your-table-id' console.table(result); -
观察控制台输出的表格视图:表头列应清晰完整,每一行数据与表头准确对齐,无
undefined属性名或前后数据错位即可确认提取成功。
总结
在 JavaScript 中自动提取表格数据并关联表头为 Key,本质是将表头单元格的线性序列与每行单元格的列索引建立一一对应的映射关系。在实际工程落地时,重点不在于简单的 .map() 遍历,而在于针对空白换行清理、无 thead 结构兼容、重名与空表头容错这三类异常做足预防。掌握了这套标准的双阶段清洗与对齐逻辑,即可在面对任意复杂的静态或动态网页表格时,稳定准确地提取出可信赖的结构化 JSON 数据。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章