
深入讲解 JavaScript 中 Map.prototype.entries() 的运行原理与实战用法。包含 for...of 解构、手动 next() 迭代、数组链式处理等完整可执行代码示例,配合 4 幅专业内联架构与流程图,全方位解析遍历特性与工程避坑指南。

当前位置:首页 > JavaScript 基础 > 正文
JS Map.entries()遍历获取键值对的完整示例
作者:木棉
时间:2026-11-18
浏览:553
文章目录
核心概述:在 JavaScript ES6+ 开发中,
Map.prototype.entries() 返回一个专门用于迭代 Map 集合的迭代器对象(MapIterator)。该迭代器每次步进都会严格按照插入顺序,产出一个形如 [key, value] 的二元数组。无论键是字符串、数值,还是复杂的对象引用,使用 for...of 搭配解构赋值或通过 next() 手工步进,均能安全、高效地同时提取键和值。
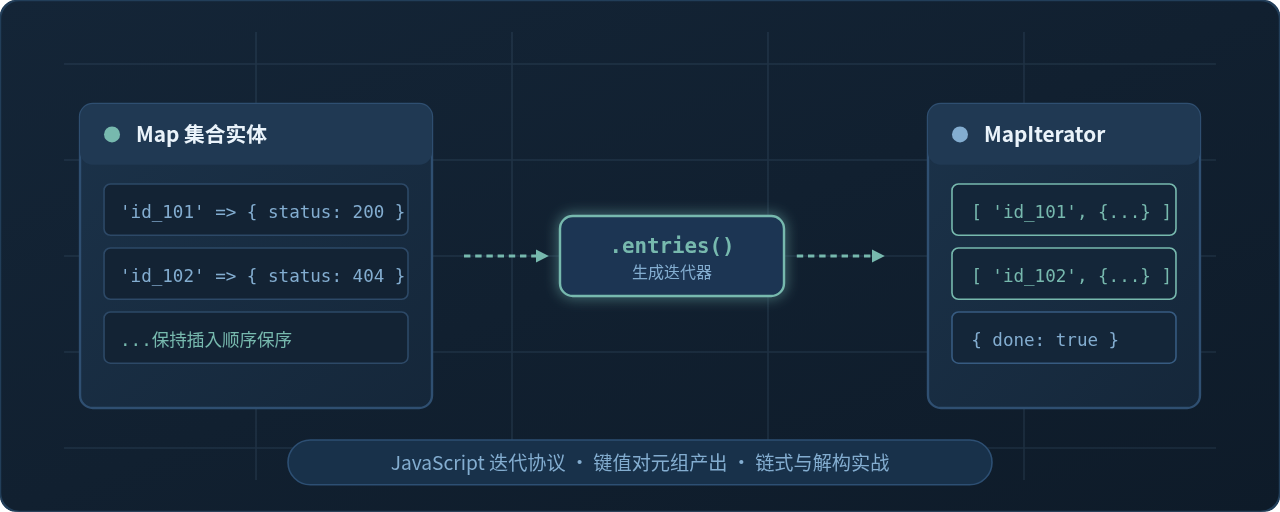
缩略图概览:Map 集合通过 entries() 产出有序键值对流
一、Map.prototype.entries() 的工作机制与结构
在传统的普通 JavaScript 对象(Object)中,键名只能是字符串或 Symbol,且属性遍历无法完全保障插入顺序。ES6 引入的 Map 集合彻底解决了这一痛点:它内部维护了基于插入顺序的双向链表索引,支持将任意数据类型(包括原始值、DOM 节点、对象实例乃至函数)作为键。
调用 myMap.entries() 不会复制底层数据生成新的大数组,而是轻量级地创建一个实现了 Iterable 与 Iterator 规范的 MapIterator 实例。其核心特征如下:
- 元素形态固定:每次产出的
value属性恒为两元数组[key, value],第 0 位是键,第 1 位是对应的值。 - 严格保序:产出次序与各条目首次调用
map.set(key, val)写入的先后顺序严格一致。即使后续使用相同的键覆盖更新值,也不会重置其在迭代序列中的次序。 - 惰性求值(Lazy Evaluation):迭代器仅在被消费者读取(例如调用
.next()或由for...of循环驱动)时才计算并移向下一个元素,因此内存开销极小。
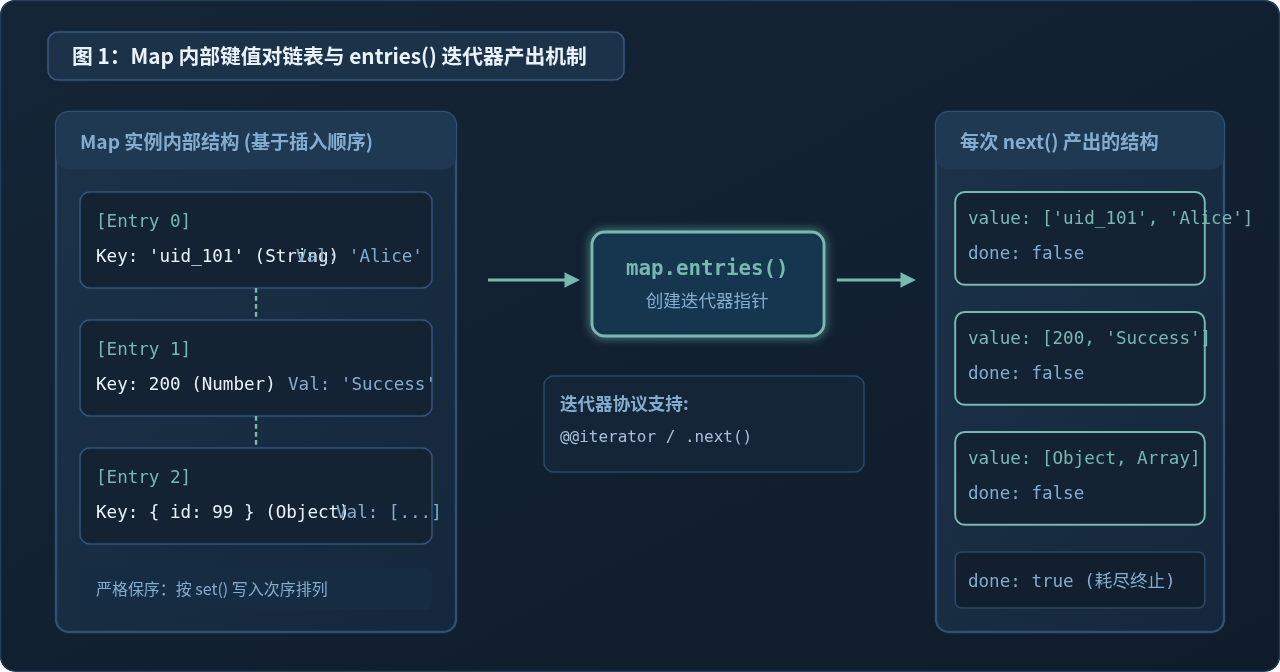
图 1:Map 内部键值对链表存储与 entries() 迭代器产出机制示意图
二、核心用法一:for...of 搭配解构赋值(首选标准写法)
在日常业务开发中,最推荐、最直观的写法是将 entries() 迭代器放入 for...of 循环中,并在声明语句中直接利用 ES6 数组解构赋值 [key, value] 提取变量。这种方式语法干净,且天生支持 break、continue 与异步操作。
完整示例代码
// 1. 初始化包含多种类型键的 Map 集合
const routeCache = new Map();

// 添加不同类型的键值对
routeCache.set('/api/v1/users', { status: 200, latency: 45 });
routeCache.set(404, { error: 'Not Found', count: 12 });

const configRef = { env: 'production' };
routeCache.set(configRef, { cacheTTL: 3600 });

// 2. 使用 for...of 结合解构赋值遍历 map.entries()
console.log('--- 开始遍历 Map.entries() ---');
for (const [key, val] of routeCache.entries()) {
  // 根据键的不同类型打印展示
  if (typeof key === 'object') {
    console.log(`[对象键] env=${key.env} => TTL: ${val.cacheTTL}s`);
  } else {
    console.log(`[常规键] key: ${key} => val:`, val);
  }
}
console.log('--- 遍历结束 ---');
示例输出 (Console Output)
--- 开始遍历 Map.entries() ---[常规键] key: /api/v1/users => val: { status: 200, latency: 45 }
[常规键] key: 404 => val: { error: 'Not Found', count: 12 }
[对象键] env=production => TTL: 3600s
--- 遍历结束 ---
语法糖延伸:在 ECMAScript 规范中,
Map.prototype[Symbol.iterator] 的默认实现即为 entries()。这意味着 for (const [key, value] of routeCache) 与 for (const [key, value] of routeCache.entries()) 在运行期等价。然而在团队协作和复杂业务中,显式书写 .entries() 语义更加清晰明确,能有效降低代码阅读者的理解负担。
三、核心用法二:手动调用 next() 逐步迭代(细粒度流控)
当需要在特定事件触发、分页步进、状态机切换或实现分批微任务处理时,for...of 的全自动连续消费无法满足需求。此时可以直接调用迭代器的 .next() 方法,手工掌控读取节奏。
每次调用 iterator.next() 都会返回一个包含两个属性的纯对象:
value:当前步的[key, value]数组;当遍历耗尽时为undefined。done:布尔值,false表示后续仍有元素,true表示迭代器已耗尽。
完整示例代码
const taskQueue = new Map([
  ['TASK_01', '数据清洗'],
  ['TASK_02', '生成图表'],
  ['TASK_03', '发送汇报邮件']
]);

// 获取 entries 迭代器实例
const taskIterator = taskQueue.entries();

// 逐步拉取前两个任务
const firstItem = taskIterator.next();
console.log('第 1 次步进状态:', firstItem.done);
const [taskKey1, taskName1] = firstItem.value;
console.log(`执行任务 -> 键: ${taskKey1}, 名称: ${taskName1}`);

const secondItem = taskIterator.next();
const [taskKey2, taskName2] = secondItem.value;
console.log(`执行任务 -> 键: ${taskKey2}, 名称: ${taskName2}`);

// 使用 while 循环处理剩余的全部任务
console.log('--- 循环处理剩余队列 ---');
let current = taskIterator.next();
while (!current.done) {
  const [key, value] = current.value;
  console.log(`[剩余处理] ${key}: ${value}`);
  current = taskIterator.next();
}

// 验证迭代器耗尽状态
console.log('最终状态 check:', taskIterator.next());
示例输出 (Console Output)
第 1 次步进状态: false执行任务 -> 键: TASK_01, 名称: 数据清洗
执行任务 -> 键: TASK_02, 名称: 生成图表
--- 循环处理剩余队列 ---
[剩余处理] TASK_03: 发送汇报邮件
最终状态 check: { value: undefined, done: true }
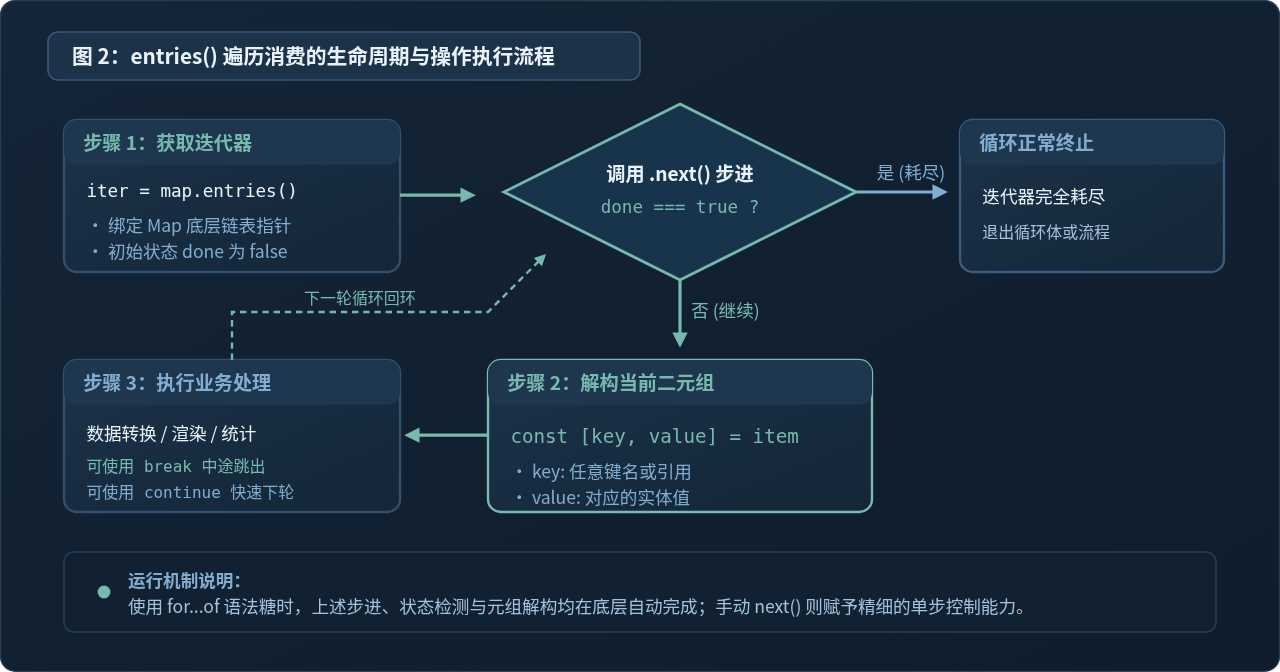
图 2:entries() 迭代器生命周期判定与操作执行流程图
四、核心用法三:转为数组进行链式高阶处理
由于 entries() 返回的是一个标准迭代器,我们可以通过 ES6 扩展运算符([...map.entries()])或 Array.from(map.entries()) 瞬间将其转化为二维数组 [[k1, v1], [k2, v2], ...]。这使得我们可以利用 Array.prototype 上丰富的函数式方法(如 filter、map、reduce、sort),处理完成后还能无缝转回新 Map。
完整示例代码
// 原始商品评分映射表 (ID => Score)
const productScores = new Map([
  ['prod_A', 92],
  ['prod_B', 68],
  ['prod_C', 85],
  ['prod_D', 74],
  ['prod_E', 96]
]);

// 1. 将 entries 转换为数组,筛选出得分 >= 85 的高质量商品,并按得分降序排序
const highScoresArray = [...productScores.entries()]
  .filter(([id, score]) => score >= 85)
  .sort((a, b) => b[1] - a[1]);

console.log('筛选并排序后的二维数组:', highScoresArray);

// 2. 重新转为新的 Map 实例
const topTierMap = new Map(highScoresArray);
console.log('Top Tier Map 大小:', topTierMap.size);

// 3. 遍历输出新 Map 的最终内容
for (const [id, score] of topTierMap.entries()) {
  console.log(`优选评级 -> 商品: ${id}, 分数: ${score}`);
}
示例输出 (Console Output)
筛选并排序后的二维数组: [ [ 'prod_E', 96 ], [ 'prod_A', 92 ], [ 'prod_C', 85 ] ]Top Tier Map 大小: 3
优选评级 -> 商品: prod_E, 分数: 96
优选评级 -> 商品: prod_A, 分数: 92
优选评级 -> 商品: prod_C, 分数: 85
五、横向对比:Map 的四大遍历方法选型矩阵
Map 提供了 entries()、keys()、values() 以及 forEach() 四种内置遍历方案。不同方案在返回值形式、执行效率和流程控制能力上存在关键差异:
| 遍历方法 | 返回值类型 | 产出数据格式 | 支持 break/return | 支持异步 await 串行 | 典型适用场景 |
|---|---|---|---|---|---|
| map.entries() | MapIterator | [key, value] 二元组 |
完美支持 | 支持 (搭配 for...of) | 必须同时读取键和值;需要中断或流式处理 |
| map.keys() | MapIterator | key 单值 |
完美支持 | 支持 (搭配 for...of) | 仅需要验证键白名单、键名收集 |
| map.values() | MapIterator | value 单值 |
完美支持 | 支持 (搭配 for...of) | 总和聚合计算、列表渲染,不关心主键 |
| map.forEach() | undefined | 回调 (value, key, map) |
不支持 (抛异常才能停) | 无法阻断外部主流程 | 纯粹的无中断副作用遍历,注重函数式风格 |
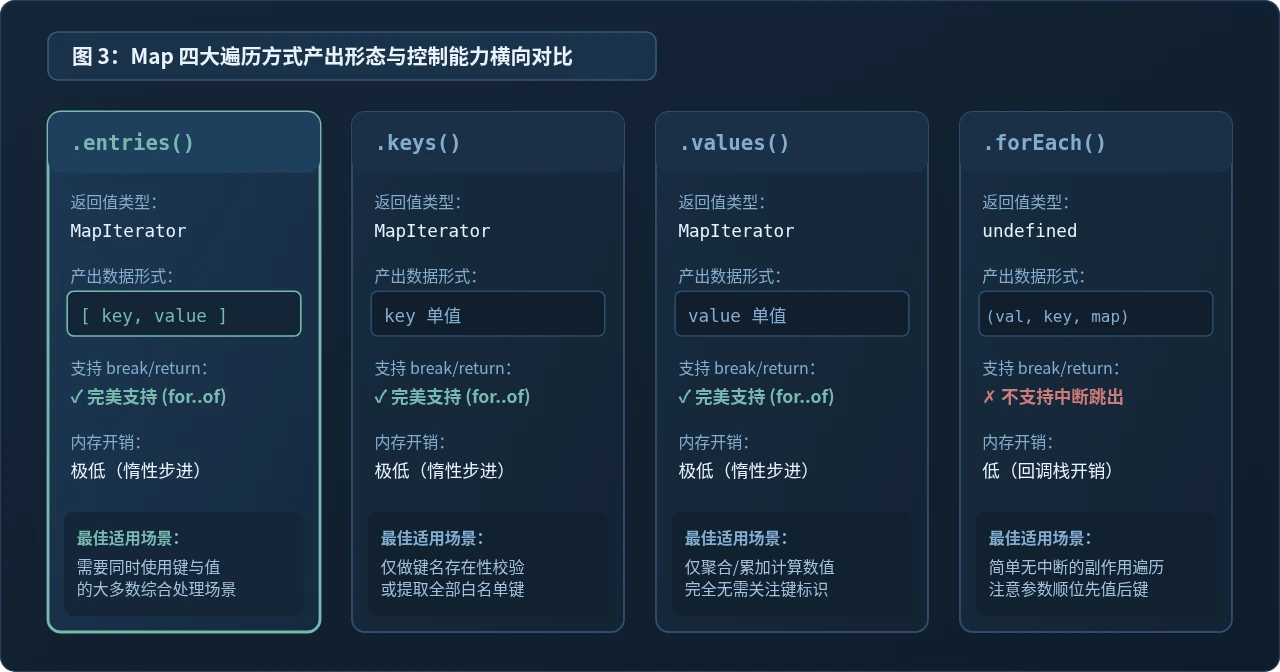
图 3:Map 四大遍历方式产出形态与控制能力横向对比图
六、工程实践中的关键边界与避坑指南
1. 陷阱:迭代器的一次性消费(Exhaustion)
迭代器内部维护着单向移动的指针状态。一旦迭代器被消费完毕(即 done === true),它无法倒回或重置。如果将同一个迭代器变量传递给第二个循环,第二个循环将直接跳过退出:
const dataset = new Map([['x', 1], ['y', 2]]);
const sharedIter = dataset.entries();

// 第一次遍历:正常输出全部 2 项
for (const [k, v] of sharedIter) {
  console.log('第一次消费:', k, v);
}

// 第二次遍历:sharedIter 已处于耗尽状态,无任何输出!
for (const [k, v] of sharedIter) {
  console.log('第二次消费:', k, v); // 永远不会执行
}

// 正确做法:每次消费均重新调用 dataset.entries() 创建新迭代器
for (const [k, v] of dataset.entries()) {
  console.log('全新迭代器消费:', k, v); // 正常输出
}
2. 陷阱:遍历期间增删改(Live Mutation)与死循环风险
ECMAScript 规范明确规定:Map 的迭代器是对底层集合的实时视图(Live View)。如果在遍历过程中对当前 Map 执行 set() 或 delete(),迭代器会感知这些变化:
- 动态追加:如果在遍历过程中
set了一个尚未存在的新键,该键会在后续的遍历中被正常访问到。如果循环内无条件追加新项,将导致永久死循环并最终造成内存溢出。 - 动态删除:如果删除了尚未被迭代器访问到的键,该键将不会被后续循环产出;如果删除的是已经访问过的键,对迭代过程无影响。
- 值覆盖更新:修改已访问或未访问键的
value,由于键在链表中的顺序不变,迭代器访问该键时获取到的是实时的最新值。
// 防范实时遍历修改导致异常的策略:快照隔离
const liveMap = new Map([['a', 10], ['b', 20]]);

// 错误做法演示(概念性风险):
// for (const [k, v] of liveMap.entries()) {
//    liveMap.set(k + '_new', v * 2); // 危险:循环将无休止增加新节点!
// }

// 安全防范方案:在遍历前先创建静态数组快照
for (const [k, v] of [...liveMap.entries()]) {
  liveMap.set(`${k}_v2`, v * 10); // 安全,循环只严格执行 2 次
}
console.log('安全增量扩容后的 Map 长度:', liveMap.size); // 4
警惕复合对象键解构命名冲突:如果
Map 的键是一个普通对象或自身也是数组,在解构 const [key, value] = entry 时,请确保变量命名语义明确,避免混淆;如果需要深层解构对象键内部的属性,可以使用 const [{ id, type }, value] = entry 语法。
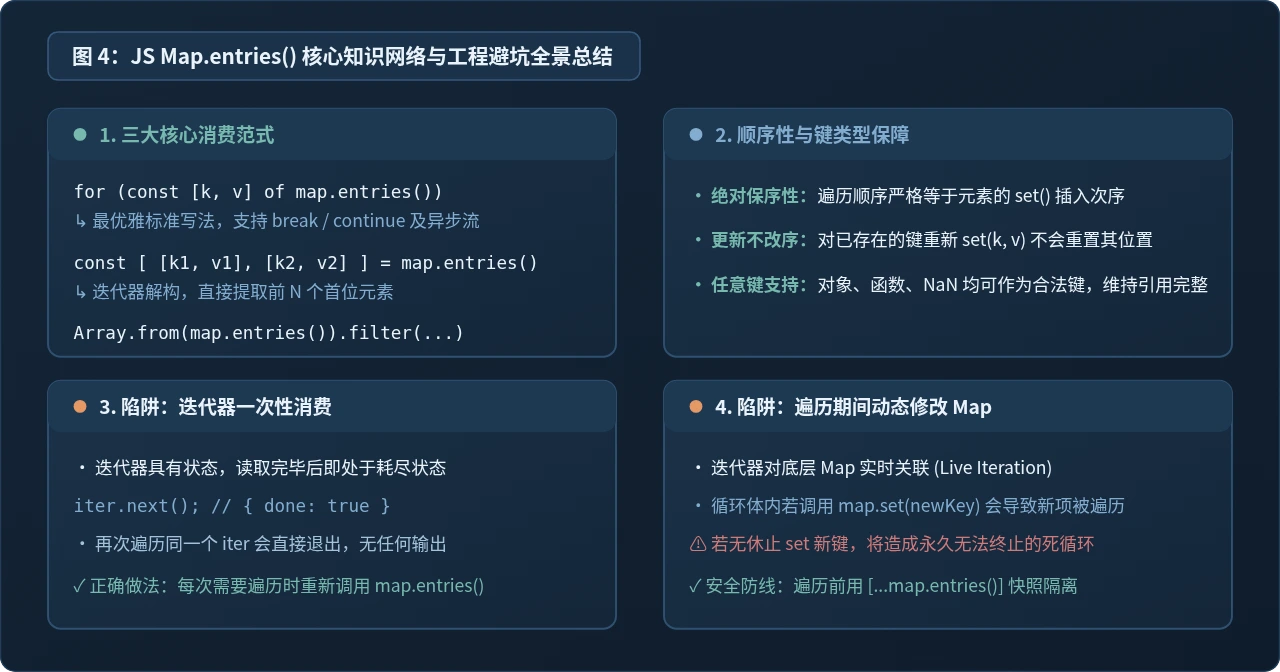
图 4:JS Map.entries() 核心实战技巧与避坑全景总结
七、总结与最佳实践建议
在 JavaScript 中遍历 Map 获取键值对时,请遵循以下工程原则:
- 绝大多数常规场景:统一采用
for (const [key, value] of myMap.entries())。它在执行速度、语法可读性、错误排查以及break/continue流程控制上均具显著优势。 - 微任务限流与批处理场景:获取
const iter = myMap.entries()并结合iter.next()编写步进调度函数,利用迭代器的暂停能力实现轻量级控制。 - 多重聚合与链式函数式编程:通过
Array.from(myMap.entries())转换后再调用filter/map/reduce,但请注意在大数据集(例如包含数十万项条目)下,预先转换为全量数组会产生额外的内存分配开销,应权衡流式遍历与全量转换。 - 并发与数据安全:若在迭代周期内存在异步回调或多方修改,牢记
MapIterator是实时关联的特性,必要时通过解构快照隔离操作,避免遍历脏数据或引发死循环。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章