
深入解析JavaScript中Array.prototype.sort()方法的语法规范、底层字典序与Timsort排序机制,并系统讲解数值、多字段、区域敏感自定义比较器的设计原则与高频避坑要点。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JavaScript数组sort()方法详解:语法、原理与自定义比较器
作者:青柠
时间:2026-11-17
浏览:334
文章目录
分类:前端开发 / JavaScript核心规范
适用标准:ECMAScript 2019+ / ESNext
阅读耗时:约 8 分钟
在 JavaScript 中,对数组执行
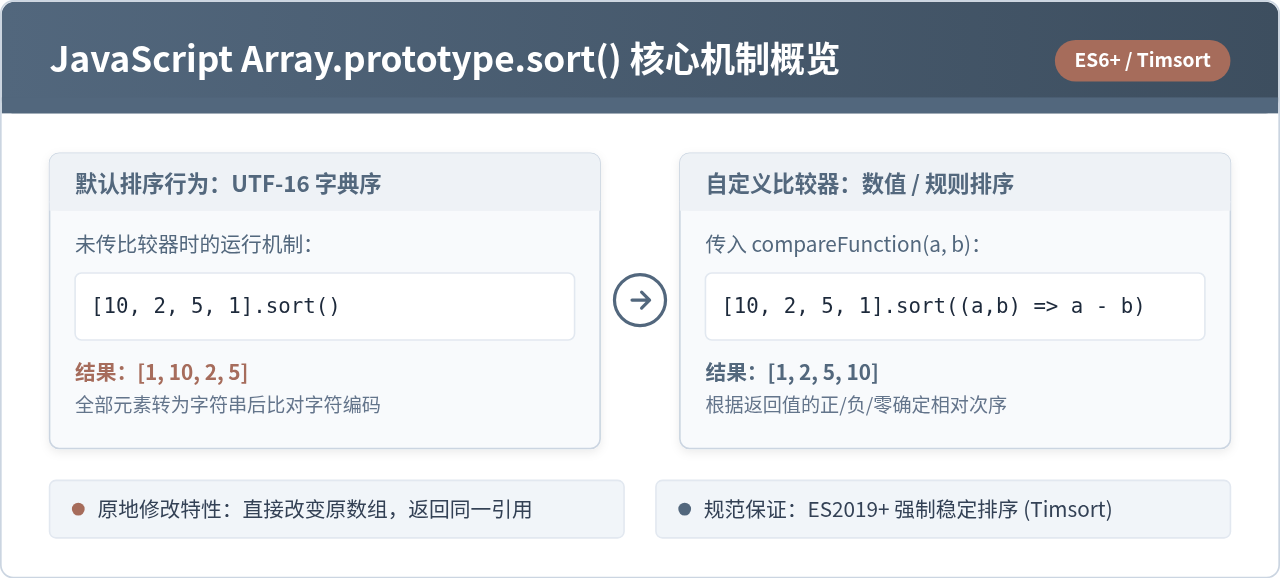
[10, 2, 5, 1].sort() 会得到 [1, 10, 2, 5],这一反直觉的结果源自 Array.prototype.sort() 的默认行为:如果不传比较参数,它会将所有非 undefined 元素强制转换为字符串,并按照 UTF-16 代码单元值序列进行升序排序。同时,该方法具备原地(in-place)突变特性,会直接修改原数组并返回该数组的引用。要完成正确的数值大小排序、复合对象多条件排序或符合人类语言习惯的文字排序,关键在于理解并实现自定义比较器(Comparator)。本文将从基础语法特征、引擎底层机制、比较函数契约规则到高频避坑实践,系统拆解这一高频方法的每个关键细节。
一、基础语法与内存变更特性
Array.prototype.sort() 的基本调用语法如下:
// 语法签名
arr.sort([compareFunction])

// 参数说明:
// compareFunction (可选):用于定义排序顺序的比较函数。
// 返回值:
// 经过排序后的原数组本身(同一内存引用)。
关于 sort() 的调用行为,存在三个核心规范特征:
-
原地修改(Mutating In-Place)与同一引用返回:调用
sort()并不会分配新数组,它直接在原有内存空间内重新调整元素排列,返回的结果就是调用者本身的内存指针(arr.sort(...) === arr结果为true)。在 React、Vue 等倡导不可变数据(Immutable Data)的状态管理体系中,直接在原始状态数组上调用sort()会引发隐蔽的状态污染或视图更新丢失。 -
纯函数替代方案:如果希望保持原数组不变并获得排序副本,传统写法是在排序前进行浅拷贝:
[...arr].sort(...)或arr.slice().sort(...)。而在现代标准 ECMAScript 2023 (ES14) 中,官方原生引入了非破坏性方法arr.toSorted(...),它接受与sort相同的比较器参数,但始终返回一个全新的浅拷贝排好序的数组。 -
undefined元素与稀疏数组空洞的特殊归宿:在 JavaScript 排序规范中,所有的undefined元素无论自定义比较器如何编写,最终都会被自动移至数组末尾;且它们绝对不会被传入自定义比较函数中执行计算。稀疏数组(如通过new Array(3)创建的包含空洞的数组)中的空槽也会被视作undefined并集中归整至尾部。
// 示例:原地修改与 ES2023 toSorted 对比
const original = [3, 1, 2];

// 破坏性排序:原数组被更改
const mutated = original.sort((a, b) => a - b);
console.log("原数组 original:", original); // 示例输出: [1, 2, 3]
console.log("引用是否相同:", mutated === original); // 示例输出: true

// 非破坏性替代(现代标准):
const baseList = [3, 1, 2];
const safeSorted = baseList.toSorted((a, b) => a - b);
console.log("baseList 保持原样:", baseList); // 示例输出: [3, 1, 2]
console.log("safeSorted 获得独立新副本:", safeSorted); // 示例输出: [1, 2, 3]
二、底层机制:默认字典序与现代 Timsort 算法
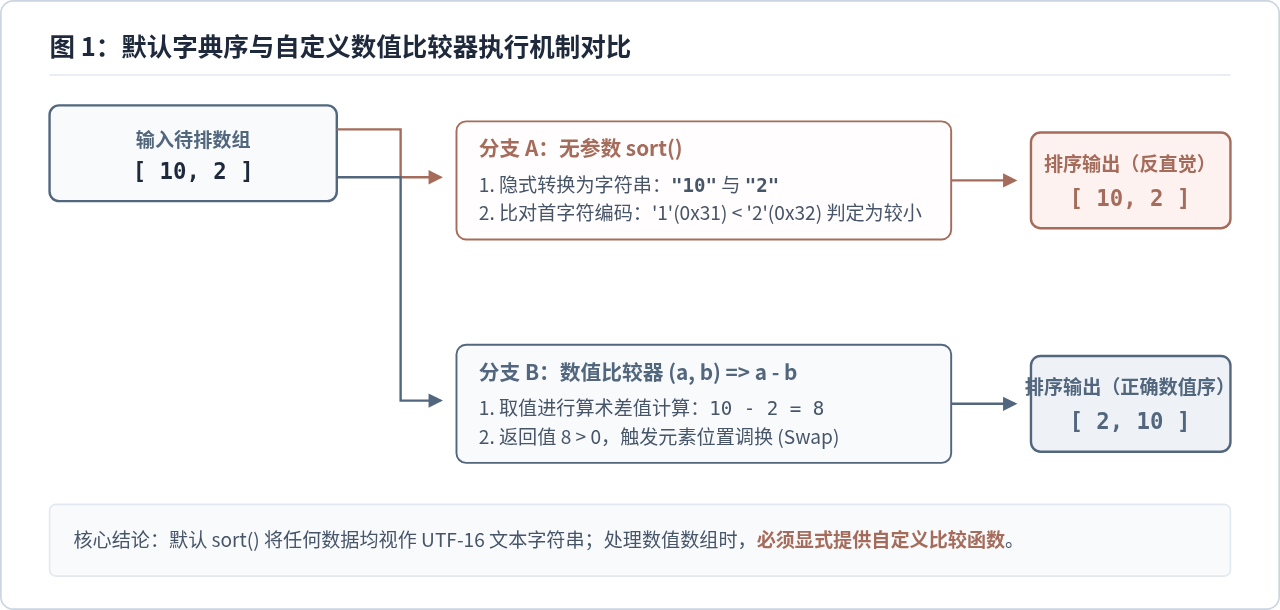
为什么无参调用 sort() 时,数字 10 会排在 2 之前?原因在于 ECMAScript 规范规定:当省略比较器时,引擎会遍历元素并执行抽象操作 ToString(element),随后对比两个字符串的 UTF-16 代码单元(Code Units)序数。
在 UTF-16 编码表中,字符 "1" 的码点是 0x0031(十进制 49),而字符 "2" 的码点是 0x0032(十进制 50)。因为 49 < 50,所以字符串 "10" 在字典序中被判定为排在 "2" 之前。这一机制在处理纯英文单词升序时符合直觉,但面对数字、布尔值或复杂对象时会产生严重偏离。
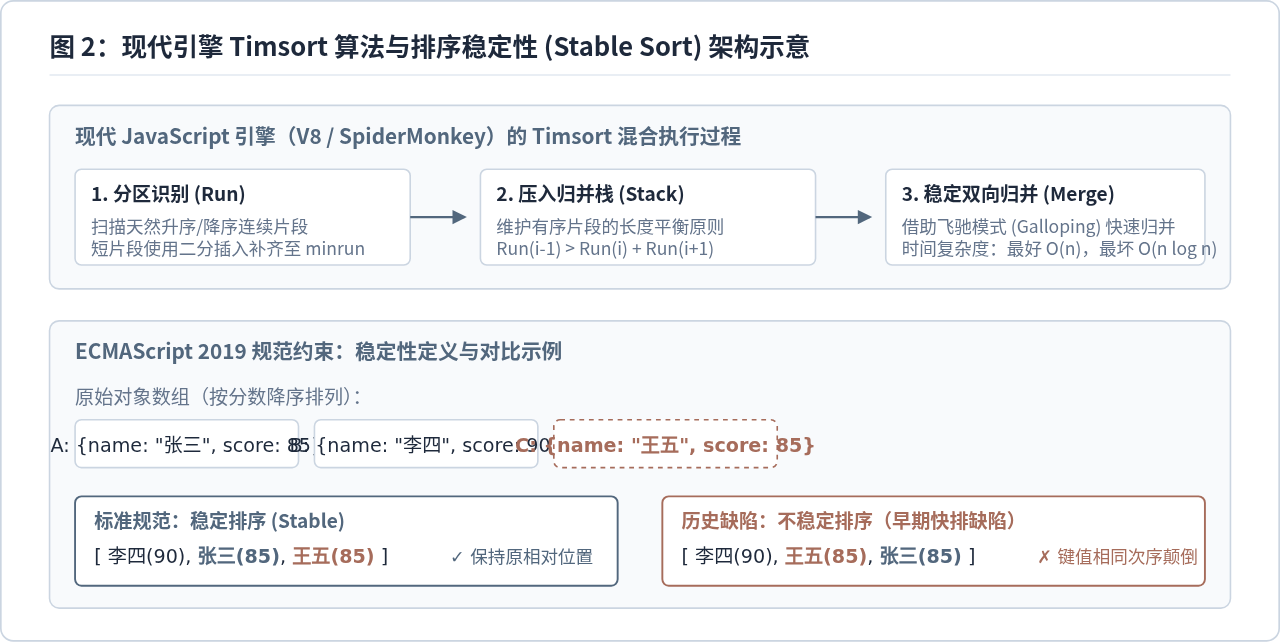
在具体排序算法层面,早期的 JavaScript 引擎并无严格标准约束。例如旧版 V8 引擎在数组长度小于等于 10 时使用插入排序(Insertion Sort),在长数组时切换到快速排序(Quicksort)。但这带来了一个长年困扰开发者的缺陷:旧版快排属于不稳定排序(Unstable Sort),即两个排序权值相等的元素,其原始的先后次序在排序后可能会被随机打乱。
从 ECMAScript 2019 (ES10) 开始,语言规范正式将 Array.prototype.sort 强制规范为稳定排序(Stable Sort)。现代主流浏览器及 Node.js 引擎(如 V8、SpiderMonkey、JavaScriptCore)全面统一采用了 Timsort 算法。
Timsort 是一种源自现实工程数据特征的高效自适应混合算法:
- 它首先扫描数组中已经自然存在的连续升序或降序子序列(称为 Run)。
- 如果 Run 的长度低于设定的阈值(minrun),则通过二分插入排序将其扩充至合适长度。
- 最后将各 Run 压入管理栈,并在满足特定平衡条件时执行二路稳定归并。这使得 Timsort 在面对现实中几乎已局部有序的业务数据时,能够逼近线性时间复杂度 O(n),最差情况下也严格保证 O(n log n)。
三、自定义比较器(Comparator)的数学契约与实现
自定义比较器是一个接收两个待比较元素 (a, b) 的纯函数。引擎会根据该函数的返回值符号来决定元素在排序序列中的前后位置:
| 比较器返回值条件 | 元素相对次序判定 | 排位结果说明 |
|---|---|---|
compareFn(a, b) < 0 |
a 的权值小于 b |
a 排在 b 前面(升序) |
compareFn(a, b) > 0 |
a 的权值大于 b |
b 排在 a 前面(降序或调换) |
compareFn(a, b) === 0 |
a 与 b 权值相等 |
在 ES2019+ 稳定排序保证下,保持原数组中的相对顺序不变 |
1. 数值升序与降序
对于常规有限数字数组,最简明的写法是直接利用算术减法:
const numbers = [40, 100, 1, 5, 25, 10];

// 数值升序(从小到大):a - b
numbers.sort((a, b) => a - b);
console.log("数值升序:", numbers);
// 示例输出: [1, 5, 10, 25, 40, 100]

// 数值降序(从大到小):b - a
numbers.sort((a, b) => b - a);
console.log("数值降序:", numbers);
// 示例输出: [100, 40, 25, 10, 5, 1]
深度注意:减法溢出与 NaN 陷阱
减法表达式
1. 极值运算溢出(例如涉及
2. 当数组中混入
减法表达式
a - b 虽然简便,但在两个特殊场景下会失效:1. 极值运算溢出(例如涉及
Number.MAX_VALUE 与极小负数相减可能超出安全范围,或者涉及 BigInt 类型时与 Number 混用会报错);2. 当数组中混入
NaN 时,任何数字与 NaN 相减都返回 NaN,在比较逻辑中会被视作 0,直接打破全序关系,引发排序混乱。若需极度严谨,可采用显式分支判断:
// 工业级严格比较器(避免减法溢出与 NaN 破坏)
function safeNumericCompare(a, b) {
  if (Number.isNaN(a)) return 1;  // NaN 统一沉底
  if (Number.isNaN(b)) return -1;
  if (a < b) return -1;
  if (a > b) return 1;
  return 0;
}
2. 字符串与多语言区域排序 (localeCompare)
如果直接使用默认方式排序字符串,英文字符的大写 "Z"(ASCII 90)会排在小写 "a"(ASCII 97)前面,而且非 ASCII 字符(如中文汉字)仅能按 Unicode 码点排列,无法实现符合人类常识的汉语拼音字母排序。
正确的做法是调用字符串的 String.prototype.localeCompare() 方法:
const fruits = ["Banana", "apple", "cherry", "Date"];

// 区分大小写不合理的默认排序
console.log([...fruits].sort());
// 示例输出: ["Banana", "Date", "apple", "cherry"](大写在前)

// 使用 localeCompare 忽略大小写升序
const naturalAlpha = [...fruits].sort((a, b) => a.localeCompare(b, undefined, { sensitivity: 'base' }));
console.log(naturalAlpha);
// 示例输出: ["apple", "Banana", "cherry", "Date"]

// 中文汉字按拼音首字母排序
const cities = ["北京", "上海", "广州", "深圳", "成都", "杭州"];
cities.sort((a, b) => a.localeCompare(b, 'zh-Hans-CN'));
console.log("汉字拼音升序:", cities);
// 示例输出: ["北京", "成都", "广州", "杭州", "上海", "深圳"] (B -> C -> G -> H -> S -> S)
3. 对象数组多字段级联排序
在业务数据表格或列表中,经常需要实现“优先按部门升序,部门相同按绩效降序,若仍相同则按入职时间升序”这种复合多级排序。由于比较器支持短路逻辑,可以利用逻辑或运算符 || 极其优雅地串联多个优先级:
const employees = [
  { id: 101, dept: "研发部", score: 88, joinYear: 2021 },
  { id: 102, dept: "市场部", score: 95, joinYear: 2020 },
  { id: 103, dept: "研发部", score: 95, joinYear: 2019 },
  { id: 104, dept: "研发部", score: 88, joinYear: 2018 },
  { id: 105, dept: "市场部", score: 91, joinYear: 2022 }
];

// 多级级联排序逻辑
employees.sort((a, b) => {
  // 优先级 1:部门名称字典序升序
  const deptDiff = a.dept.localeCompare(b.dept, 'zh-Hans-CN');
  if (deptDiff !== 0) return deptDiff;

  // 优先级 2:绩效分数降序(从高到低)
  const scoreDiff = b.score - a.score;
  if (scoreDiff !== 0) return scoreDiff;

  // 优先级 3:入职年份升序(老员工在前)
  return a.joinYear - b.joinYear;
});

console.log("复合排序结果:", employees);
// 示例输出:
// [
//   { id: 102, dept: '市场部', score: 95, joinYear: 2020 },
//   { id: 105, dept: '市场部', score: 91, joinYear: 2022 },
//   { id: 103, dept: '研发部', score: 95, joinYear: 2019 },
//   { id: 104, dept: '研发部', score: 88, joinYear: 2018 },
//   { id: 101, dept: '研发部', score: 88, joinYear: 2021 }
// ]
四、编写自定义比较器的规范操作流程
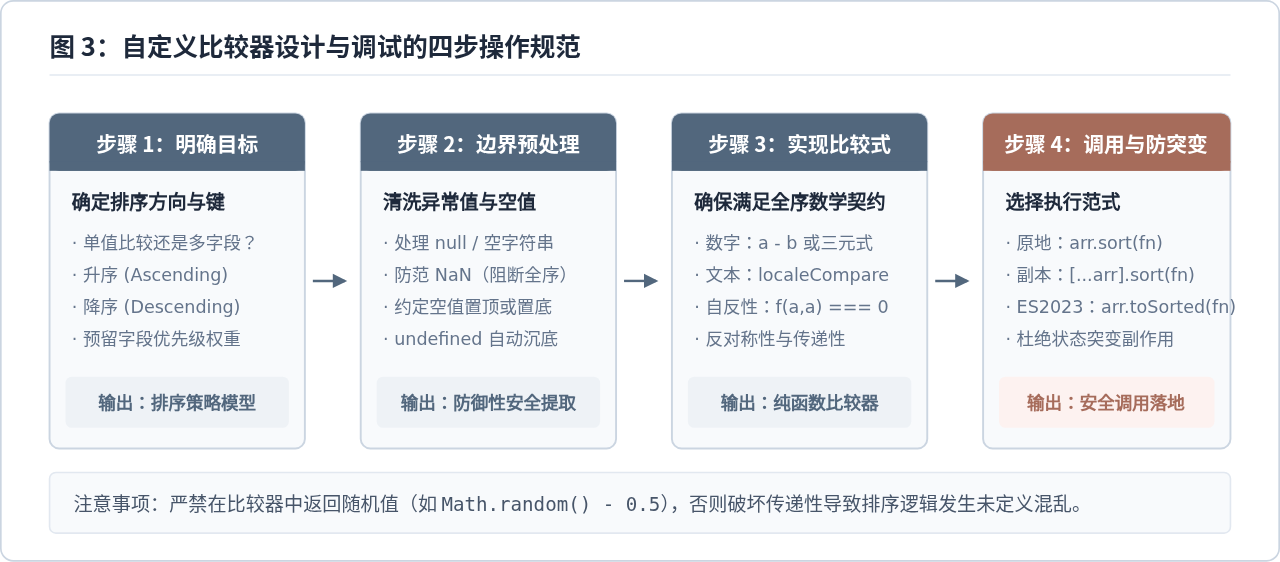
在实际工程开发中,编写一个健壮、高效且具备防御性的比较器,应遵循以下四个标准操作环节:
-
第一步:明确排序目标与优先级模型
梳理参与排序的数据结构。清晰拆解是单一基础类型、嵌套对象特定属性,还是依赖动态配置的多字段级联。确立各个维度的升降序要求。 -
第二步:边界值防御与空值预处理
在访问对象属性前,需防范目标对象为null或undefined的情形;同时明确业务对缺失值的容忍度——例如在表格展示中,通常需要明确规定“空数据统一排在最前”还是“统一沉底”。 -
第三步:严格遵守数学全序关系(Total Order)
ECMAScript 规范要求自定义比较函数必须满足严格弱序(Strict Weak Ordering)。如果违反以下公理,引擎内部排序状态机将产生混乱:- 自反性(Reflexivity):
compareFn(a, a) === 0; - 反对称性(Antisymmetry):若
compareFn(a, b) > 0,则必有compareFn(b, a) < 0; - 传递性(Transitivity):若
compareFn(a, b) > 0且compareFn(b, c) > 0,则必有compareFn(a, c) > 0。
- 自反性(Reflexivity):
-
第四步:选定调用范式并杜绝状态污染
在应用层评估当前调用是否允许突变原数组。若在数据流(如 Redux reducer、Vue computed、Pinia getter)中,必须优先使用arr.toSorted(compareFn)或[...arr].sort(compareFn),避免破坏上游数据源。
五、常见误区与高频踩坑排查
误区 1:使用 () => Math.random() - 0.5 进行数组随机打乱(Shuffle)
网络上经常流传一种简写数组乱序的技巧:arr.sort(() => Math.random() - 0.5)。这种做法是完全错误且不可靠的。
因为该回调函数的输出结果具有完全的随机性,破坏了比较器必须具备的“反对称性”和“传递性”(前一刻判定 a < b,后一刻比较时可能判定 b < a)。在 Timsort 这类基于已有序片段识别的高级算法中,这种随机性会导致大量比较被跳过,最终洗牌结果呈现极高概率的分布倾斜与分布偏差。
正确解决方案:实现经典的 Fisher-Yates(Knuth)洗牌算法:
// 正确且均匀的数组随机洗牌算法(时间复杂度 O(n))
function shuffleArray(array) {
  const result = [...array];
  for (let i = result.length - 1; i > 0; i--) {
    const j = Math.floor(Math.random() * (i + 1));
    [result[i], result[j]] = [result[j], result[i]]; // 原地解构交换
  }
  return result;
}
误区 2:在比较器中返回布尔值(Boolean)
初学者容易写出类似 arr.sort((a, b) => a > b) 的代码。因为 JavaScript 中 true 转为数字是 1,而 false 转为数字是 0,这样的比较器永远只能返回 1 或 0,完全缺失了负数(-1)这种关键状态。
当比较器无法返回负数时,引擎无法判断“a 应当排在 b 之前”的逻辑,排序结果往往错漏百出或完全无序。比较器必须明确返回三态数值:负数、正数或零。
六、核心要点总结与速查清单
最后,将 Array.prototype.sort() 的关键知识脉络归纳如下速查图谱:
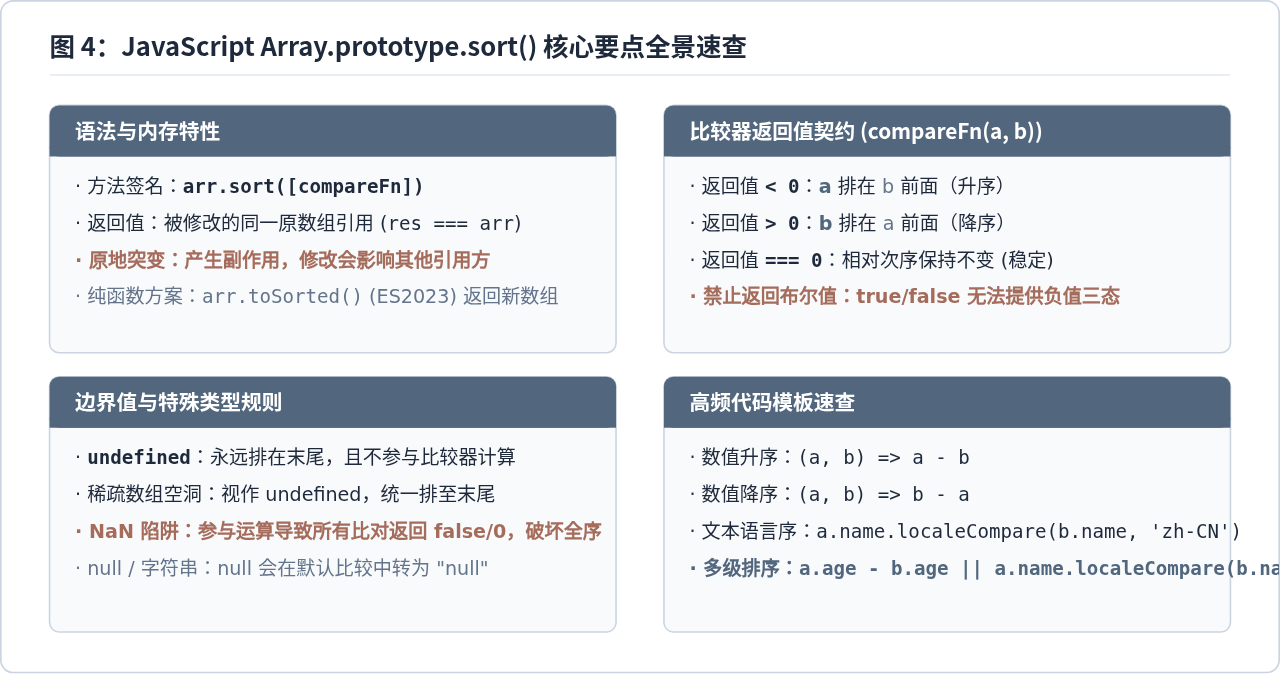
总结使用要点:
- 对纯字符串做自然语言排序,使用
(a, b) => a.localeCompare(b, 'zh-Hans-CN'); - 对数值数组排序,始终显式声明
(a, b) => a - b(升序)或(a, b) => b - a(降序),永远不要依赖默认的无参sort(); - 牢记
sort()的原地破坏性,需要只读操作时换用toSorted()或浅拷贝拓展运算符; - 确保自定义比较器是无副作用的纯函数,并严格遵守全序关系的自反、反对称与传递公理。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章