
深入解析JavaScript大小写敏感机制对标识符解析与内存寻址的影响,系统梳理camelCase与PascalCase的应用边界、命名推导决策流程、缩略词处理与工程化落地最佳实践。

当前位置:首页 > JavaScript 代码规范与重构 > 正文
基于JavaScript大小写敏感的命名规范:camelCase与PascalCase最佳实践
作者:纸飞机
时间:2026-11-16
浏览:334
文章目录
规范类型:ECMAScript 标识符工程实践
核心范式:camelCase / PascalCase
代码质量:静态检查与协作统一
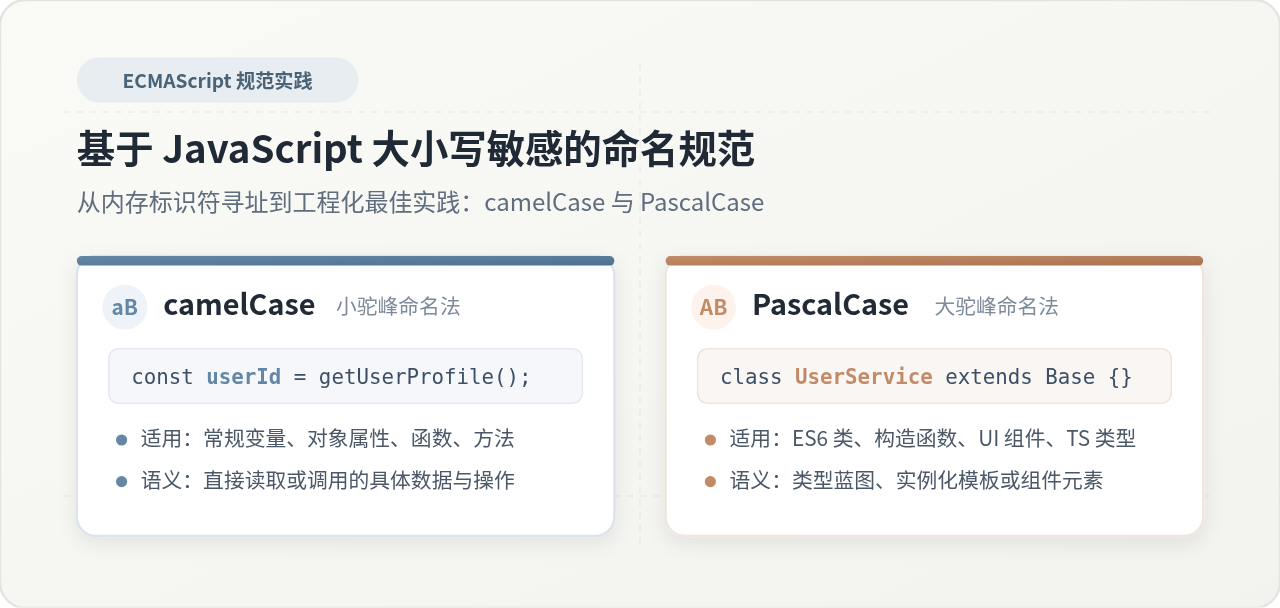
JavaScript 是一门严格区分大小写的编程语言。在引擎内部,标识符的每一个字符都精确参与哈希寻址与内存环境记录匹配,这意味着 userAge、UserAge 与 USERAGE 会被底层引擎视为三个毫无关联的独立实体。在现代大型项目与团队协作中,大小写混淆极易引发未定义取值(undefined)、空指针报错或意外的全局污染。为了从语法表达层规避这些隐患,前端工业界确立了分工清晰的双核心命名范式:camelCase(小驼峰命名法)用于承载具体数据运算与可调用的常规实体;而 PascalCase(大驼峰命名法)专用于表达类型模板、构造工厂与抽象组件。本文将深入大小写敏感的底层逻辑,系统梳理两大范式的应用边界、推导模型与工程化约束实践。
一、JavaScript 大小写敏感性的底层机制与高频踩坑
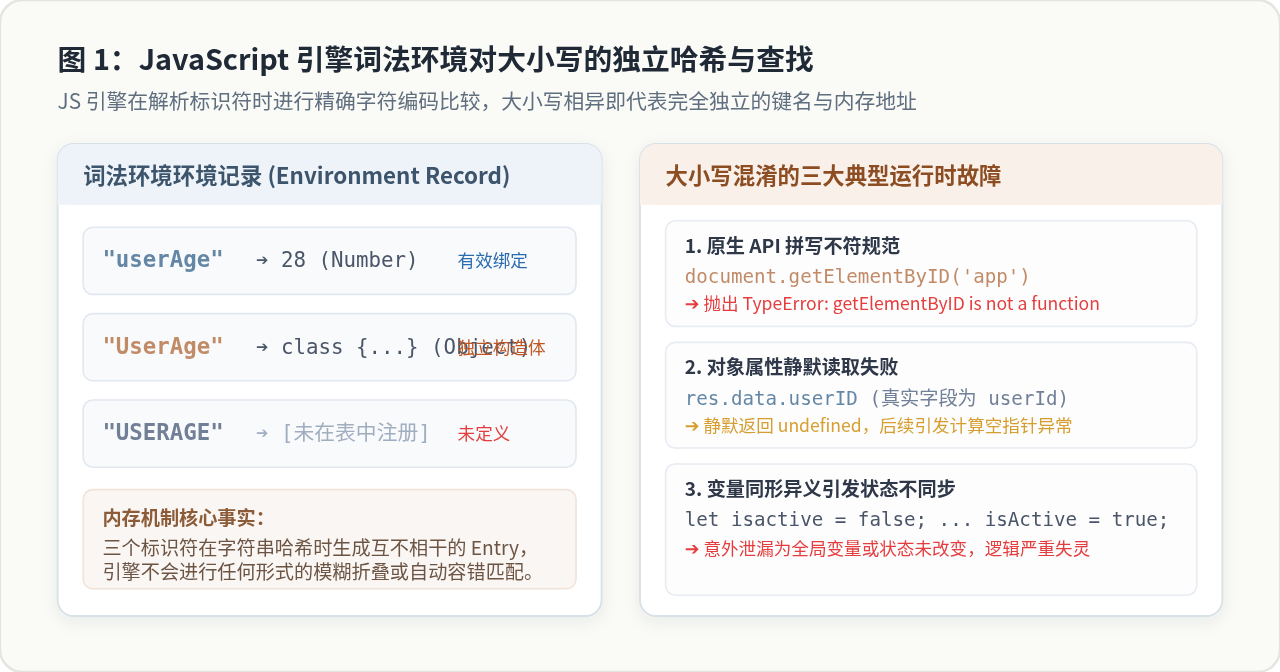
要建立稳固的命名习惯,首先需要从引擎执行层面理解为什么大小写绝不可混淆。ECMAScript 规范在词法分析阶段对标识符(IdentifierName)采用了基于 Unicode 码点的精确字符匹配。无论是在词法环境(Lexical Environment)的“环境记录项(Environment Record)”中,还是在普通 JavaScript 对象的哈希字典中,标识符字符串的大小写差异都会直接映射为不同的内存键名。
这种机制决定了引擎不会提供任何隐式拼写容错。如果大小写书写不一致,往往会导致以下三类典型缺陷:
- DOM 与内置 API 拼写不符导致 TypeError:原生 Web API 广泛采用小驼峰规范。例如将
document.getElementById()错误书写为document.getElementByID()时,由于对象属性查找失败,返回值为undefined,紧接着的括号调用会立即抛出TypeError: document.getElementByID is not a function。 - 数据对象属性访问静默失效:读取后端接口或复杂对象时,如果将属性
response.data.userId误写为response.data.userid或response.data.userID,程序不会报错中断,而是静默产生undefined。当后续业务对该字段执行解构或数字运算时,极易诱发级联逻辑崩塌。 - 变量声明同形异义引发状态脱节:在未开启严格模式或作用域嵌套较深的场景下,若声明了
let isAuthorized = false,却在某个条件分支中赋值给isauthorized = true,不仅原状态完全没有被修改,还可能在非严格模式下意外泄漏并绑定至全局对象。
注意:运行时错误排查要点
当控制台提示某个方法 is not a function 或变量属性为 undefined 时,应优先比对调用的属性标识符与原型链或数据源的字母大小写,而非盲目重构业务逻辑。
二、camelCase(小驼峰)的规范定义与适用场景
camelCase(小驼峰命名法)的规则是:首个单词全部小写,从第二个单词开始,每个单词的首字母大写,词与词之间无连接符(例如 userRoleList)。在语义心智上,camelCase 表达的是“具体执行的载体与直接使用的数据”,调用者拿到该标识符时,预期是直接读取其值或直接执行该方法,而不需要通过 new 关键字实例化。
1. 常规局部变量与运行时不可变引用
凡是在函数体、模块内部用于存储计算结果、状态数据或运行时引用的变量,均必须采用 camelCase:
// 示例代码:常规数据与引用变量声明
const maxRetryAttempts = 3;
let currentRecordCount = 0;
const activeSessionToken = "session_tk_8921";
执行输出(示例)
console.log(maxRetryAttempts); // 输出: 3
2. 常规函数、箭头函数与方法调用
函数与方法代表动作或流程,通常采用“动词 + 名词”的组合形式,并统一以小驼峰书写:
// 示例代码:常规业务函数定义
function fetchUserProfile(userId) {
  return api.get(`/users/${userId}`);
}

const calculateDiscountRate = (originalPrice, couponValue) => {
  return Math.max(0, (originalPrice - couponValue) / originalPrice);
};
3. 对象属性与参数解构
自定义配置对象、实体数据载体的字段键名均使用 camelCase,以保证在解构时具有一致的代码形态:
// 示例代码:配置对象与函数传参解构
const networkConfig = {
  timeoutMs: 5000,
  autoRetry: true,
  headersList: ["Authorization", "X-Client-Id"]
};

function sendData({ timeoutMs, autoRetry }) {
  // 统一使用小驼峰解构,避免属性名拼写分歧
  return `Timeout: ${timeoutMs}, Retry: ${autoRetry}`;
}
4. 布尔型状态标志
布尔值推荐使用 is、has、can、should 作为前缀,明确表明其为判断标志:
isModalVisible(弹窗是否可见)hasAdminPermission(是否具备管理员权限)canSubmitForm(是否满足提交条件)
三、PascalCase(大驼峰)的规范定义与面向对象/组件化实践
PascalCase(大驼峰命名法)的规则是:每一个单词的首字母均大写,词间无连接符(例如 UserProfileCard)。在设计心智上,PascalCase 表达的是“类型抽象、构造蓝图与组件单元”。当开发者看到 PascalCase 命名的实体时,明确知道它代表一个可以实例化、被继承的类,或者是在视图渲染树中挂载的 UI 组件。
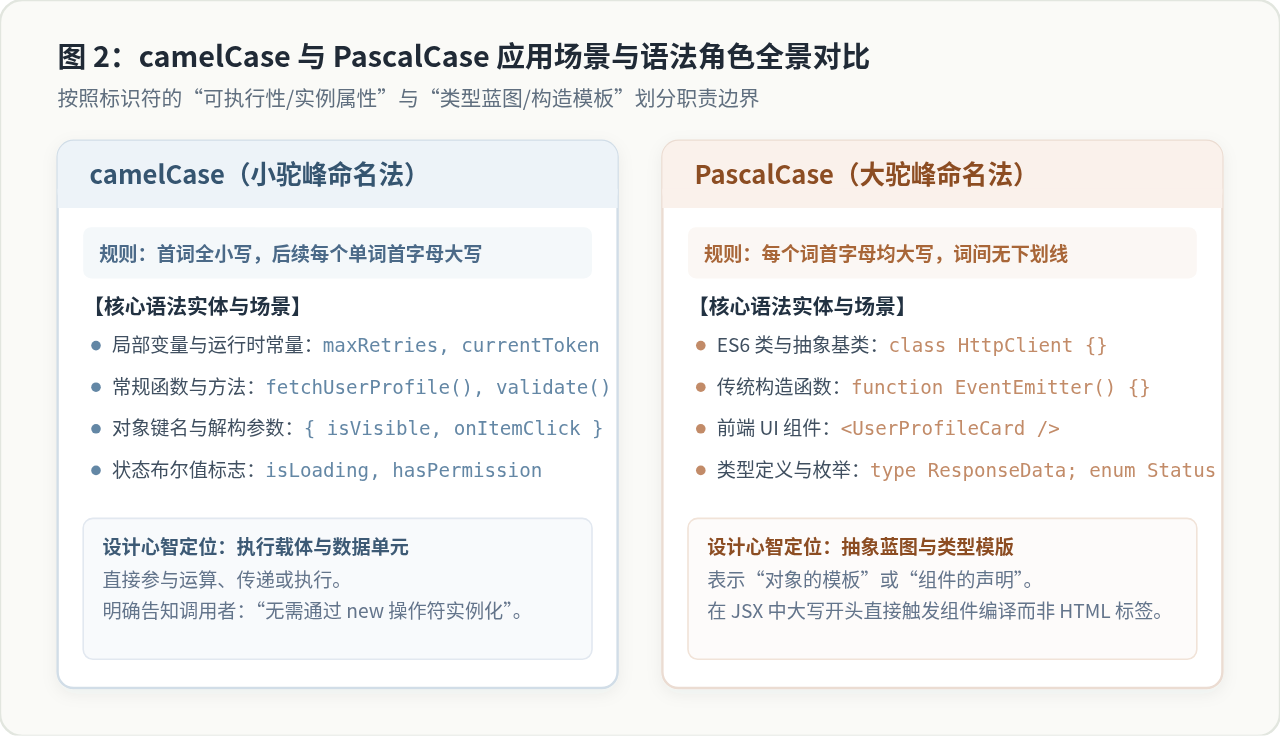
1. ES6 类(Class)与传统构造函数
JavaScript 通过 class 关键字或构造函数创建具有独立原型链的实例对象。规范强制要求此类标识符使用 PascalCase:
// 示例代码:ES6 类与构造工厂声明
class PaymentGatewayService {
  constructor(config) {
    this.merchantId = config.merchantId;
  }

  processTransaction(amount) {
    return `Processed ${amount} for merchant ${this.merchantId}`;
  }
}

// 实例对象必须回归 camelCase
const paymentService = new PaymentGatewayService({ merchantId: "M_1024" });
执行输出(示例)
console.log(paymentService.processTransaction(100)); // 输出: Processed 100 for merchant M_1024
2. 前端框架中的 UI 组件(React / Vue / Svelte)
在 React JSX 编译器(如 Babel 或 SWC)的转译逻辑中,大小写决定了编译目标:
- 以小写字母开头的标签(如
<div />、<span />)被判定为原生 HTML 元素,编译为React.createElement('div')。 - 以大写字母开头的标签(如
<UserAvatar />)被判定为组件构造函数或渲染函数,编译为React.createElement(UserAvatar)。
若将自定义组件写为小写(如 <userAvatar />),React 会尝试在当前 HTML 命名空间查找同名自定义标签,由于浏览器并不存在该原生元素,页面将静默渲染失效或输出控制台警告。
// 示例代码:React 组件声明与属性解构
function OrderSummaryCard({ orderId, totalAmount, onConfirm }) {
  return (
    <div className="summary-container">
      <h3>订单号:{orderId}</h3>
      <p>应付金额:{totalAmount}</p>
      <button onClick={onConfirm}>立即支付</button>
    </div>
  );
}
3. TypeScript 类型别名、接口与枚举
在结合 TypeScript 编写现代前端代码时,类型声明文件是抽象结构的代表,统一采用 PascalCase:
// 示例代码:TypeScript 接口与枚举定义
interface UserProfile {
  userId: string;
  displayName: string;
  isVipMember: boolean;
}

enum RequestStatus {
  Pending = "PENDING",
  Fulfilled = "FULFILLED",
  Rejected = "REJECTED"
}
四、标识符命名推导与决策流程
在日常编写代码时,开发者每遇到一个新变量、函数或类声明,都可以按照固定的推导步骤做出无歧义的选择。这一推导过程将抽象的语义意图转化为具体的书写范式:
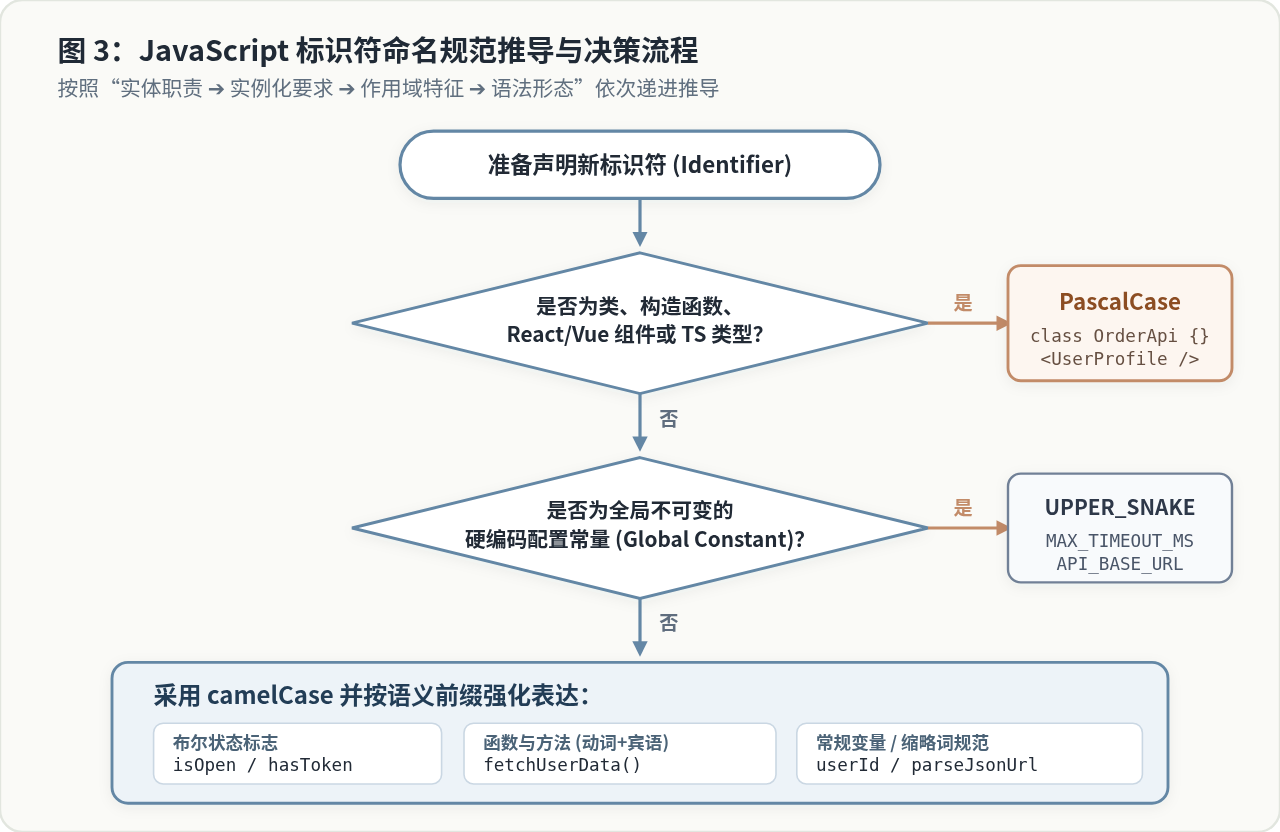
- 步骤一:评估实体是否代表蓝图、构造器或视图组件:
若该实体需要使用
new关键字实例化(如 Class、构造函数),或者作为 JSX/TSX 树中的独立组件节点,或者属于 TS 类型/接口声明,直接使用 PascalCase。 - 步骤二:评估变量是否属于只读且全局不可变的纯硬编码常量:
若变量声明于模块全局顶层,值在编译前已完全固化(例如
MAX_CACHE_EXPIRY = 86400、API_DEFAULT_TIMEOUT = 5000),使用 UPPER_SNAKE_CASE(全大写下划线);若虽然使用了const声明,但属于函数内部运算、或者引用了复杂对象实例(如const currentUser = getCurrentUser()),依然属于普通变量,回归使用 camelCase。 - 步骤三:针对常规实体应用 camelCase 并附加语义修饰:
对布尔变量附加
is / has / can / should前缀;对方法和操作附加动词(如handleSelect、formatCurrency);对于常规属性保持简洁明确的名词结构(如pageIndex、itemsPerPage)。
五、边界条件与特殊场景最佳实践
1. 连续缩略词(Acronyms)的一致性处理
关于连续缩略词(如 HTTP、URL、ID、XML、JSON),由于不同开发者的习惯差异,极易出现 parseXML 与 parseXml、userID 与 userId 的混用,这在大小写敏感的 JavaScript 中是致命的错误诱因。
| 场景类别 | 推荐写法(推荐视为普通单词) | 应避免的混用形态 | 设计考量与收益 |
|---|---|---|---|
| 小驼峰(camelCase) | userId, fetchHttpData, parseJson |
userID, fetchHTTPData, parseJSON |
避免连续大写导致单词边界模糊,如 XMLHTTPRequest 极易拼错。 |
| 大驼峰(PascalCase) | HttpClient, JsonParser, XmlReader |
HTTPClient, JSONParser, XMLReader |
遵循现代风格指南(如 Google / Airbnb),保证每个词仅首字母大写。 |
2. 后端 API 接口字段与前端 camelCase 的适配转换
许多后端语言(如 Python、Go、PHP)在数据库和 REST 接口中习惯使用 snake_case(例如 user_id、created_at)。若将下划线字段直接渗透进前端各层组件中,会导致前端代码风格割裂,并容易在解构或拼写转换时出现疏漏。
// 示例代码:在网络边界完成命名范式适配
async function getUserOrder(orderId) {
  const rawResponse = await fetch(`/api/orders/${orderId}`);
  const data = await rawResponse.json();

  // 推荐实践:在数据入境的第一时间进行属性解构映射
  return {
    orderId: data.order_id,
    createdAt: new Date(data.created_at),
    userAddress: data.shipping_address
  };
}
3. 原生私有字段与特殊属性
ES2022 已经正式支持原生私有属性与私有方法,其前缀为 # 符号。在命名私有成员时,符号之后仍应严格遵循 camelCase 规范,严禁使用下划线等陈旧伪私有写法:
// 示例代码:ES2022 原生私有字段规范
class TokenManager {
  #secretKey;
  #expiresAt;

  constructor(secretKey, lifespanMs) {
    this.#secretKey = secretKey;
    this.#expiresAt = Date.now() + lifespanMs;
  }

  isTokenValid() {
    return Date.now() < this.#expiresAt;
  }
}
六、工程落地与协作约束总结
保证大型团队中大小写规范一致性的有效方式,是“将约定沉淀为静态规则与自动化流水线”。单纯依靠人工 Code Review 难以彻底根除拼写习惯的偶发漂移。
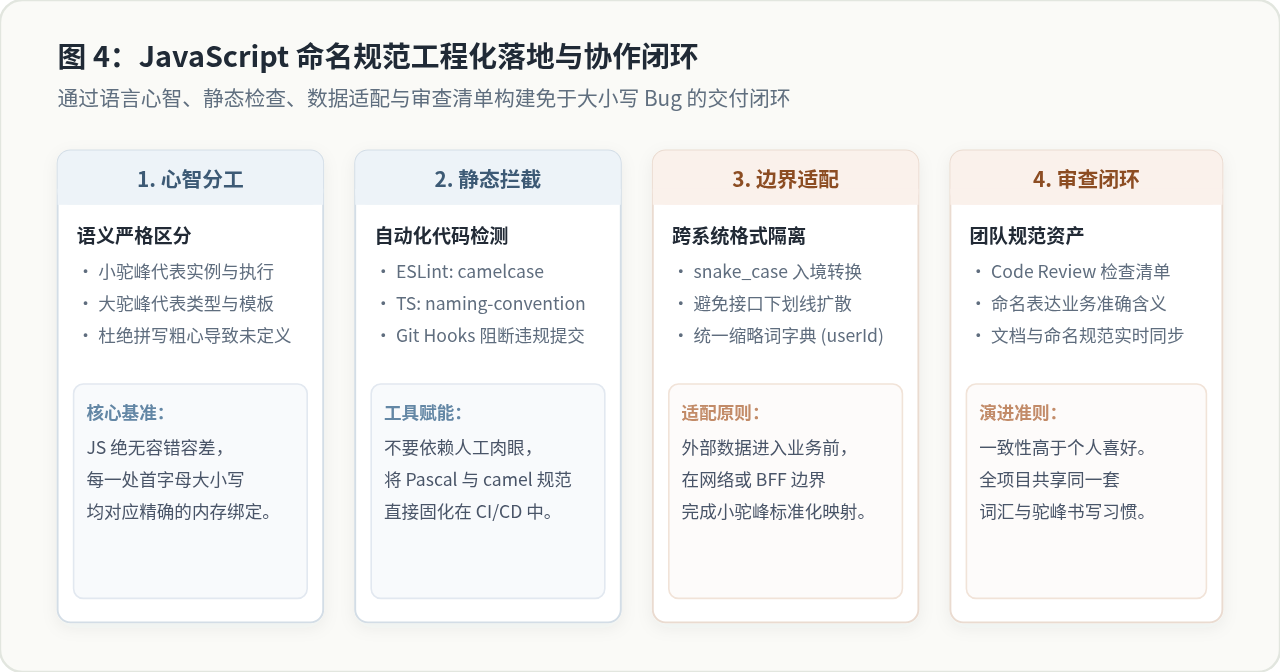
1. ESLint 与 TypeScript 规则配置
在项目中启用 camelcase 或针对 TypeScript 的 @typescript-eslint/naming-convention 规则,能够在代码保存或预提交时自动标红违规命名:
// .eslintrc.js 配置片段示例
module.exports = {
  rules: {
    "camelcase": ["error", { "properties": "always", "ignoreDestructuring": false }],
    "@typescript-eslint/naming-convention": [
      "error",
      { "selector": "variable", "format": ["camelCase", "UPPER_CASE"] },
      { "selector": "function", "format": ["camelCase", "PascalCase"] },
      { "selector": "typeLike", "format": ["PascalCase"] }
    ]
  }
};
2. 团队交付的核心原则
- 确定性先于灵活性:对于缩略词与外部数据格式,团队必须统一维护标准命名词典,避免一人一种风格。
- 前置边界隔离:数据层在进入业务代码前统一完成
camelCase转换,使业务组件内保持纯粹的语言一致性。 - 防御性编码验证:在无法保证外部键名大小写绝对统一的极端场景(如接收不可控的第三方 Webhook 数据),采用大小写不敏感的工具函数进行提取保护,防止直接访问未定义属性导致进程中断。
遵循上述规范,能够让 JavaScript 的严格大小写特性从潜在的“运行时隐患”转变为表达程序架构意图的“清晰语法工具”,显著提升系统的可维护性与协作效率。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章