
系统梳理JavaScript数组常用方法清单,详细讲解遍历、筛选、变形、增删、查找与聚合等核心方法的语法定义、参数用法、返回值、是否改变原数组(可变性)以及典型实战示例。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JavaScript数组常用方法清单与语法详解
作者:异步漫步
时间:2026-11-16
浏览:218
文章目录
假设你正在处理一份电商管理后台的商品列表:你需要过滤出所有上架状态的商品、计算它们的折扣后总金额,并将结果按照销量降序排列。在 JavaScript 中,实现这一流程可以通过多种不同的方式完成。如果误用了原地修改数组的方法,可能会在不知不觉中修改组件内部状态引发隐蔽 Bug;如果选用了低效的多层循环,又会拖慢页面的响应速度。清晰掌握数组内置方法的分类、参数细节、返回值以及可变性(是否改变原数组),是编写稳定、高性能前端与 Node.js 应用程序的基本功。
本文整理了现代 JavaScript(包含 ECMAScript 核心规范及 ES2023 实用新特性)中高频使用的数组方法清单。内容围绕方法的语法规则、参数作用、是否改变原数组、典型用法与常见陷阱展开,帮助你在实际开发中准确选型、高效编码。
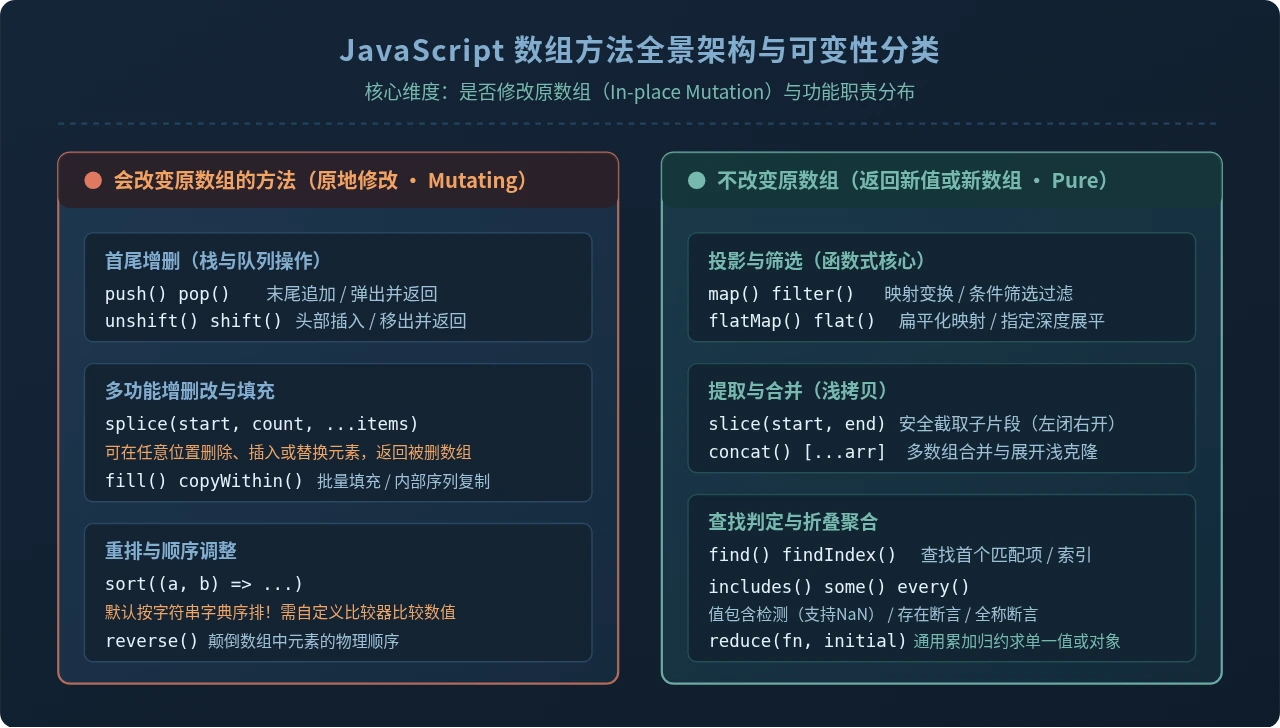
一、高频方法速查清单:可变性与核心返回值
在使用任何数组方法前,最重要的一条判断标准是:该方法是原地修改原数组(Mutating / In-place),还是返回全新数组或值(Non-mutating / Pure)。在 React、Vue 等倡导单向数据流与不可变状态(Immutability)的框架中,错误的原地修改会导致界面无法触发重新渲染或引发竞态 Bug。
| 方法名称 | 主要用途 | 是否改变原数组 | 返回值类型 |
|---|---|---|---|
push() / pop() |
末尾追加元素 / 弹出末尾元素 | 改变 原地修改 | 新长度 (number) / 被弹出元素 |
unshift() / shift() |
头部插入元素 / 移出头部元素 | 改变 原地修改 | 新长度 (number) / 被移出元素 |
splice() |
在指定位置删除、插入或替换元素 | 改变 原地修改 | 被删除元素组成的数组 |
sort() / reverse() |
对数组元素进行排序 / 反转顺序 | 改变 原地修改 | 修改后的原数组引用 |
slice() |
截取指定区间的子数组(浅拷贝) | 不改变 纯函数 | 截取出的新数组 |
concat() |
合并两个或多个数组 | 不改变 纯函数 | 合并后的新数组 |
map() |
按回调函数一对一映射变换各元素 | 不改变 纯函数 | 等长的新数组 |
filter() |
保留断言函数返回 true 的所有元素 | 不改变 纯函数 | 过滤后的新数组 |
find() / findIndex() |
查找第一个满足条件的元素 / 其索引 | 不改变 纯函数 | 目标元素(或 undefined)/ 索引(或 -1) |
some() / every() |
检查是否至少有一项 / 全部项满足条件 | 不改变 纯函数 | 布尔值 (boolean) |
reduce() |
将数组累积折叠为一个最终值 | 不改变 纯函数 | 累加器的最终结果 |
toSorted() / toSpliced() |
ES2023:安全排序与切片替换 | 不改变 纯函数 | 操作后的新数组副本 |
二、增删与结构操作方法
结构操作方法常用于栈(LIFO)与队列(FIFO)数据结构的实现,以及指定区间的元素调整。
1. 栈与队列基础:push、pop、unshift、shift
arr.push(...elements):向数组末尾追加一个或多个元素,返回数组的新长度。arr.pop():移除并返回数组末尾的最后一个元素;若数组为空,返回undefined。arr.unshift(...elements):向数组头部插入一个或多个元素,返回数组的新长度。注意:头部插入会移动后续所有元素的内存索引,在万级以上数据规模时性能明显逊于push。arr.shift():移除并返回数组的第一个元素;若数组为空,返回undefined。
const stack = [10, 20];
stack.push(30);       // stack 变为 [10, 20, 30],返回 3
const last = stack.pop(); // last 为 30,stack 变为 [10, 20]

const queue = ['B', 'C'];
queue.unshift('A');   // queue 变为 ['A', 'B', 'C'],返回 3
const first = queue.shift(); // first 为 'A',queue 变为 ['B', 'C']
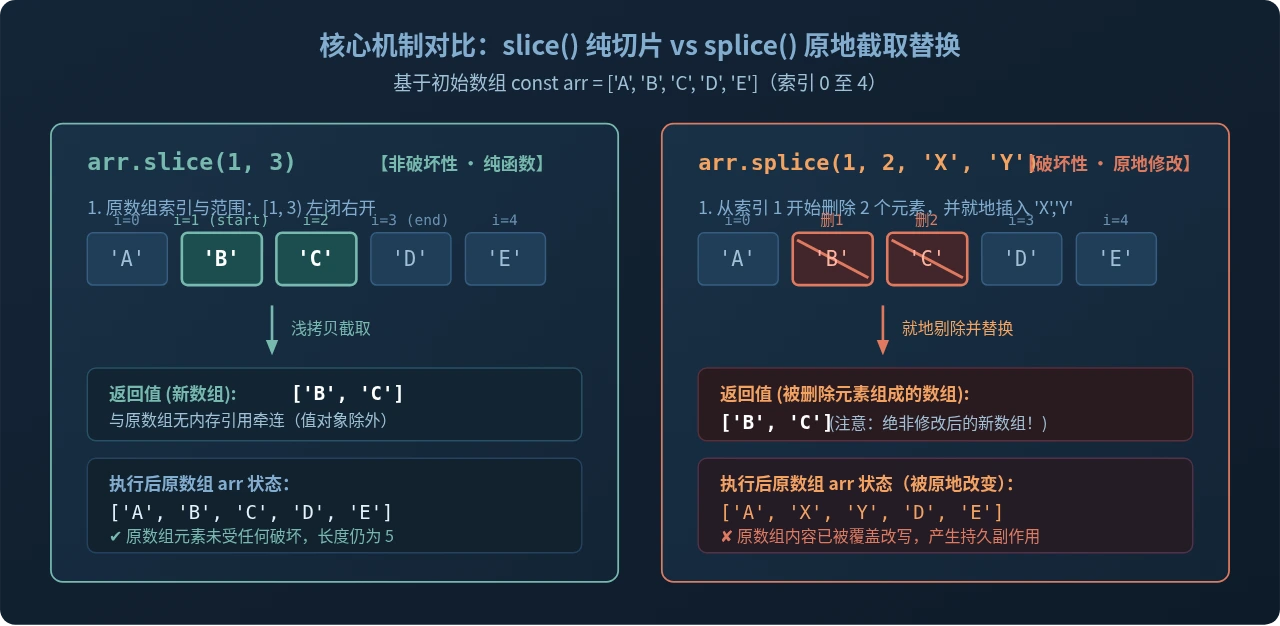
2. slice():非破坏性切片提取
语法:arr.slice(start, end)
slice 从原数组提取指定范围的元素返回一个新数组。提取区间遵循“左闭右开”规则,包含 start 索引处的元素,但不包含 end 索引处的元素。若参数为负数,表示从末尾倒数计算索引。该方法执行的是浅拷贝(Shallow Copy),原数组完全不受影响。
3. splice():多功能原地破坏性替换
语法:arr.splice(start, deleteCount, ...items)
splice 是 JavaScript 数组中最灵活但也最容易出错的方法。它会在 start 索引处直接删除 deleteCount 个元素,并就地插入后续传入的 items。注意:它的返回值是被删除的元素集合,而不是修改后的原数组。
// 1. slice: 原数组不变,安全截取
const fruits = ['Apple', 'Banana', 'Cherry', 'Date'];
const sliced = fruits.slice(1, 3);
// sliced => ['Banana', 'Cherry']
// fruits => ['Apple', 'Banana', 'Cherry', 'Date'] (原数组未变)

// 2. splice: 原地修改,返回被删元素
const removed = fruits.splice(1, 2, 'Blueberry', 'Citron');
// removed => ['Banana', 'Cherry'] (被删除的项)
// fruits => ['Apple', 'Blueberry', 'Citron', 'Date'] (原数组已被破坏性改写)易错警示:许多初学者常写出 const updated = arr.splice(...),误以为 updated 接收到的是修改后的新数组,结果得到了被删除项组成的列表,导致下游业务逻辑完全错误。
三、迭代与转换方法:函数式数据处理
现代前端开发中,数据流通常以纯函数的形式流转。以下方法均接收回调函数作为参数,回调函数标准签名通常为 (element, index, array) => { ... }。
1. forEach():执行副作用遍历
forEach() 用于按顺序遍历数组的每一个元素并执行传入的逻辑。它的返回值始终为 undefined。由于无法中途使用 break 或 return 跳出循环,若需要提前终止遍历,应使用常规的 for...of 循环或判定方法 some()。
2. map():一对一投影映射
map() 会为数组中的每个元素调用一次回调函数,并将每次调用的返回值按序放入一个新数组中返回。新数组与原数组长度严格一致,适合用于字段提取、格式化与数据模型转换。
3. filter():条件断言过滤
filter() 会根据回调函数返回的真假值(Truthiness)决定是否保留该元素。只有当回调返回 true(或真值)时,当前项才会被收入新数组中返回。若所有项均不满足条件,则返回空数组 []。
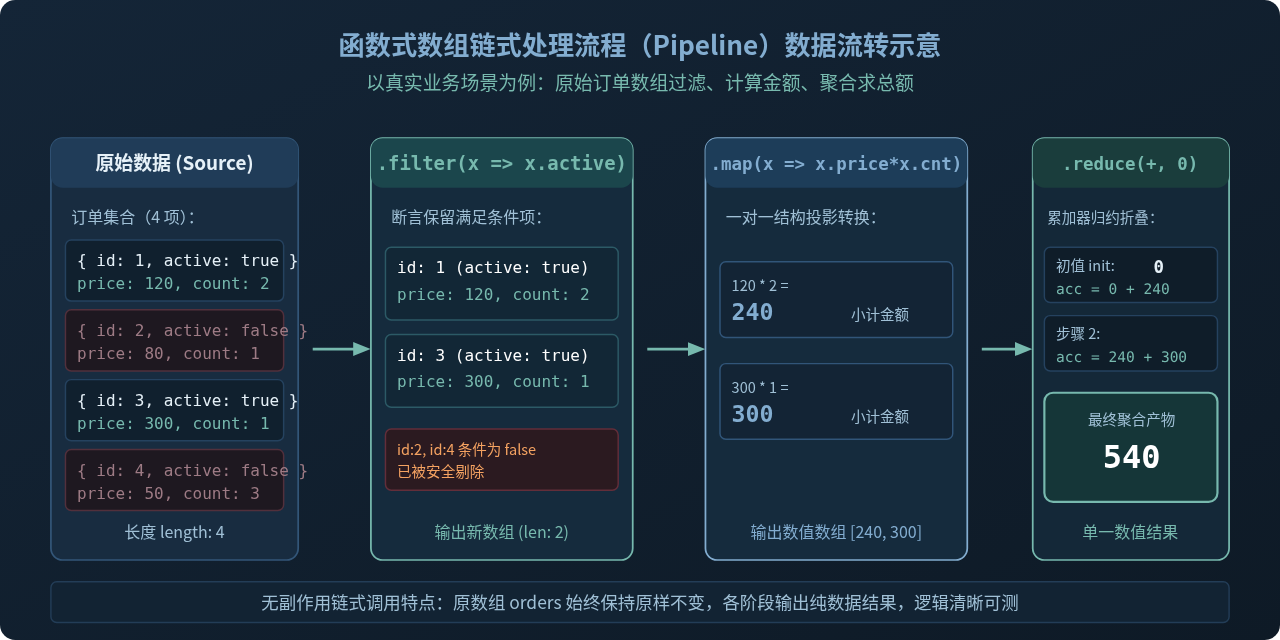
// 示例:将符合条件的订单计算小计金额,并求出合计总额
const orders = [
  { id: 101, name: '键盘', price: 299, count: 2, paid: true },
  { id: 102, name: '鼠标', price: 99,  count: 1, paid: false },
  { id: 103, name: '显示器', price: 1200, count: 1, paid: true }
];

const totalRevenue = orders
  .filter(order => order.paid)                      // 1. 过滤已支付订单 (2 项)
  .map(order => order.price * order.count)          // 2. 转换为小计金额 [598, 1200]
  .reduce((acc, subtotal) => acc + subtotal, 0);    // 3. 聚合累加求总额 => 1798

// 输出示例:
// totalRevenue => 1798
// orders 原始数组完全未受破坏
四、查找与条件判定方法
在数组中检索元素时,选择专门的判定方法不仅语义清晰,还能借助底层引擎的短路求值机制(Short-circuiting)提升性能。
1. find() 与 findIndex()
find(predicate):按顺序查找,返回第一个使断言函数返回真值的元素;若未找到,返回undefined。findIndex(predicate):返回第一个满足条件的元素所在索引;若未找到,返回-1。
2. includes() 与 indexOf() 的关键区别
在判断数组中是否存在某个原始值(如字符串、数字)时:
indexOf(val)使用严格全等(===)进行比较,返回匹配的索引或-1。但它无法识别NaN([NaN].indexOf(NaN)返回-1)。includes(val)遵循SameValueZero比较算法,能正确识别NaN([NaN].includes(NaN)返回true),且直接返回简洁的布尔值。
3. some() 与 every():逻辑断言
some(predicate):存在量词判定。只要数组中有至少一个元素满足条件就立即返回true并中断后续遍历;全不满足返回false。every(predicate):全称量词判定。只有当所有元素均满足条件时才返回true;一旦遇到不满足的项,立即短路返回false。
五、排序与聚合折叠方法
1. sort() 的陷阱与安全用法
arr.sort() 是原地修改方法。极其重要的一点:在未提供比较函数时,sort() 默认将所有元素转为字符串后按 UTF-16 码点字典序排序。这会导致数字排序出现经典的违背直觉现象:
const nums = [10, 5, 20, 100];
nums.sort();
// 结果为: [10, 100, 20, 5],因为按字符串比较时 '100' 在 '20' 和 '5' 前面!

// 正确做法:必须传入数值比较器
nums.sort((a, b) => a - b); // 升序: [5, 10, 20, 100]
nums.sort((a, b) => b - a); // 降序: [100, 20, 10, 5]
现代语法提示 (ES2023):如果希望排序时不破坏原数组,可以使用全新的纯函数方法 arr.toSorted((a, b) => a - b)。它会直接返回一个排好序的新数组副本,原数组保持不变。
2. reduce():全能聚合工具
语法:arr.reduce((accumulator, currentValue, currentIndex, array) => { ... }, initialValue)
reduce 是处理数据汇总、多维扁平化以及对象分组的最强大工具。使用 reduce 时有两条至关重要的实践原则:
- 始终显式指定
initialValue:如果省略初始值,数组的第一项将被直接作为accumulator,遍历会从第二项(索引 1)开始。在处理空数组或对象数组时,省略初始值会抛出TypeError: Reduce of empty array with no initial value。 - 保持累加器的类型纯净:累加器可以是数值、对象、Map 或新数组,在每一次迭代末尾务必显式返回累加器对象。
// 实例:将人员数组按照部门归类聚合为对象字典
const staff = [
  { name: 'Alice', dept: '研发' },
  { name: 'Bob', dept: '设计' },
  { name: 'Charlie', dept: '研发' }
];

const grouped = staff.reduce((acc, person) => {
  const key = person.dept;
  if (!acc[key]) {
    acc[key] = [];
  }
  acc[key].push(person.name);
  return acc;
}, {}); // 显式提供空对象 {} 作为 initialValue

// 输出示例:
// grouped => { "研发": ["Alice", "Charlie"], "设计": ["Bob"] }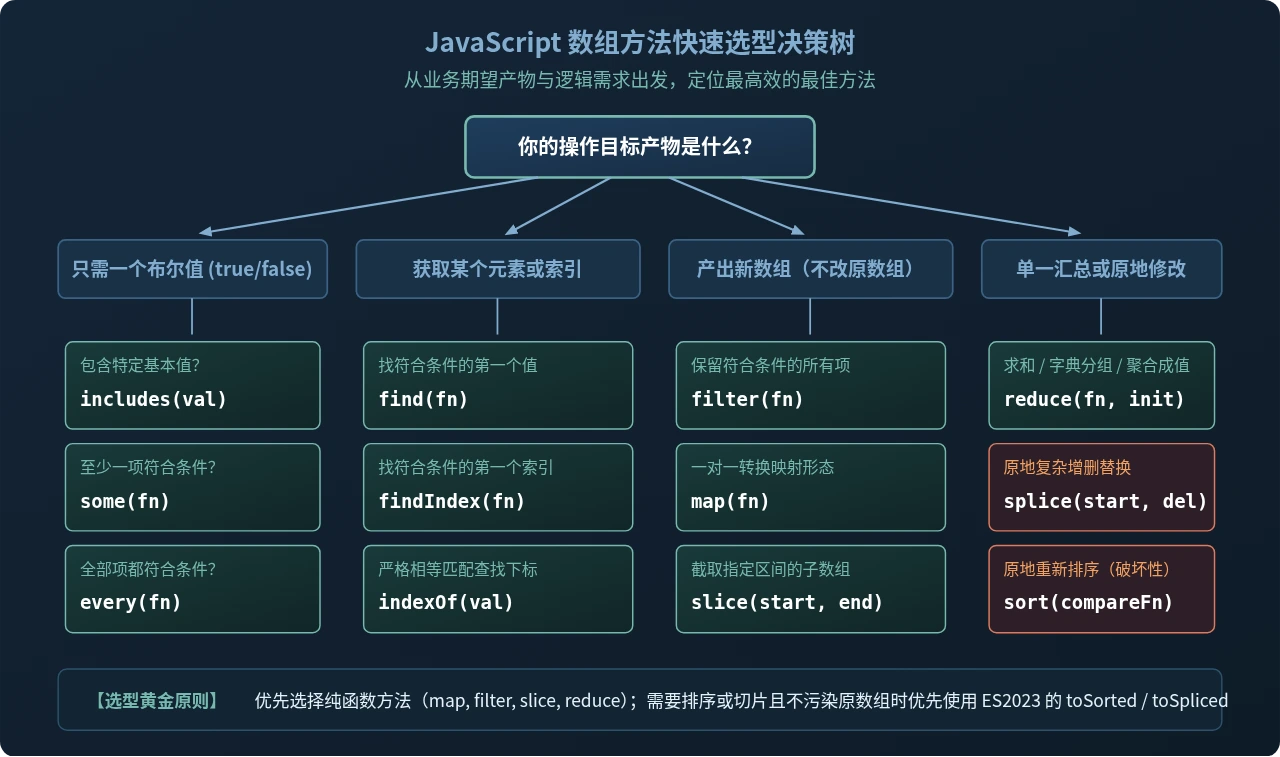
六、实践总结与性能选型建议
在日常业务编码中,选择正确的数组方法不仅使意图明确,还能避免很多性能与状态管理层面的隐藏隐患:
- 优先使用不可变方法:在处理 UI 组件状态时,优先采用
map、filter、slice、toSorted等纯方法,避免调用splice、push、sort造成隐蔽的原地修改。 - 查找元素适可而止:如果只需要检查元素是否存在,用
some()或includes()比filter().length > 0更高效,因为前者在找到首个匹配时会立即短路跳出循环,而后者必须完整遍历整个数组。 - 避免在大数组循环中嵌套检索:在包含 $N$ 个元素的数组
filter内部调用另一个大小为 $M$ 的数组的includes,会导致 $O(N \times M)$ 的双层遍历。处理大规模数据时,应先将检索集合转为new Set(),利用哈希表的 $O(1)$ 查找复杂度将总耗时缩减至 $O(N + M)$。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章