
详细讲解在JavaScript中批量获取当前网页所有图片src地址的具体实现方法,包含基础代码、绝对路径与相对路径差异对比、懒加载图片处理、去重与格式化输出及浏览器控制台直接执行技巧。

当前位置:首页 > JavaScript DOM 与事件 > 正文
JS批量获取页面所有图片src地址的代码实现
作者:流萤
时间:2026-11-16
浏览:223
文章目录
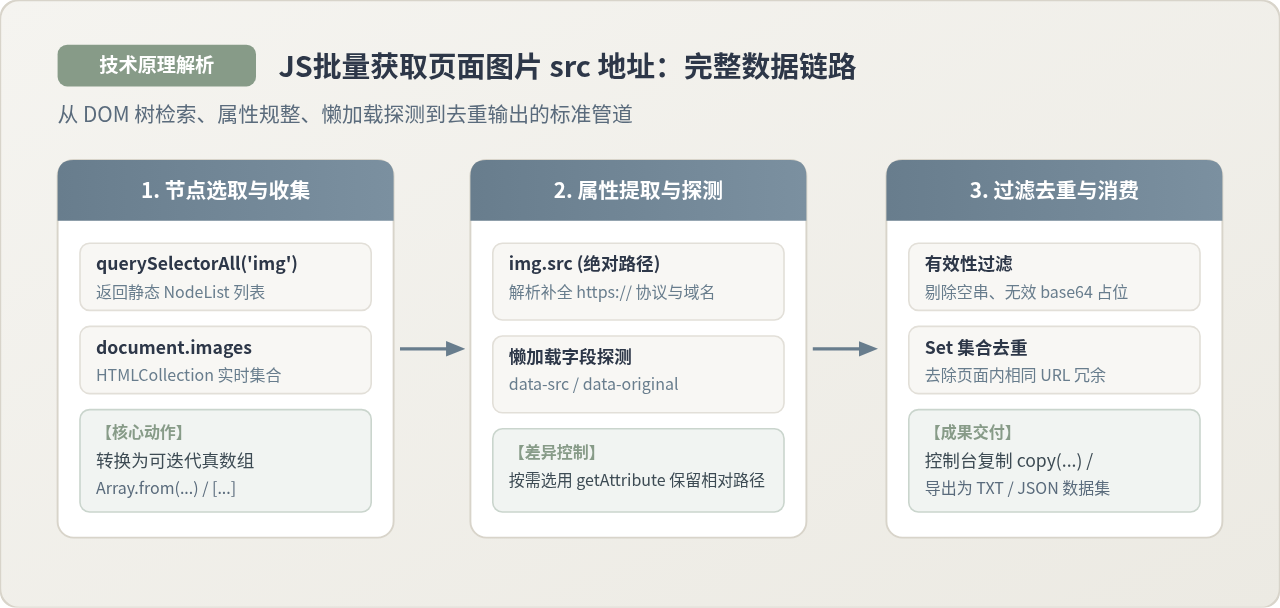
在前端数据采集、页面素材归档或资源排查场景中,快速提取当前网页中的所有图片链接是一项基础而实用的操作。本文提供在浏览器环境使用原生 JavaScript 批量提取全部图片地址的完整方案,从最直接的控制台单行代码、img.src 与 getAttribute('src') 的解析差异对比,到兼顾现代网页懒加载(data-src)的通用脚本封装与数据导出。
一、最简实现:浏览器控制台单行提取
如果仅需要临时导出当前可见网页的所有图片链接,无需编写复杂的扩展程序或后端爬虫,直接在浏览器的开发者工具中执行一行脚本即可完成。
核心思路是先通过 document.querySelectorAll('img') 获取文档中所有图片节点,再利用数组的映射方法提取每张图片的 src 属性,最后使用 Set 进行去重过滤:
// 基础一行代码:提取并去除重复地址与空链接
const images = [...new Set(Array.from(document.querySelectorAll('img'), img => img.src))].filter(Boolean);

console.log(images);
在这段代码中:
document.querySelectorAll('img'):在整个文档 DOM 树中检索所有<img>标签,返回静态的NodeList集合。Array.from(nodeList, mapFn):将类数组的NodeList转为标准数组,并直接在第二个参数中传入映射函数,读取每个节点的img.src属性。new Set(...)与展开运算符[...]:自动剔除页面中多次复用的重复图片地址(如相同的头像、装饰图标等)。.filter(Boolean):过滤掉未设置地址或路径为空字符串的无效元素。
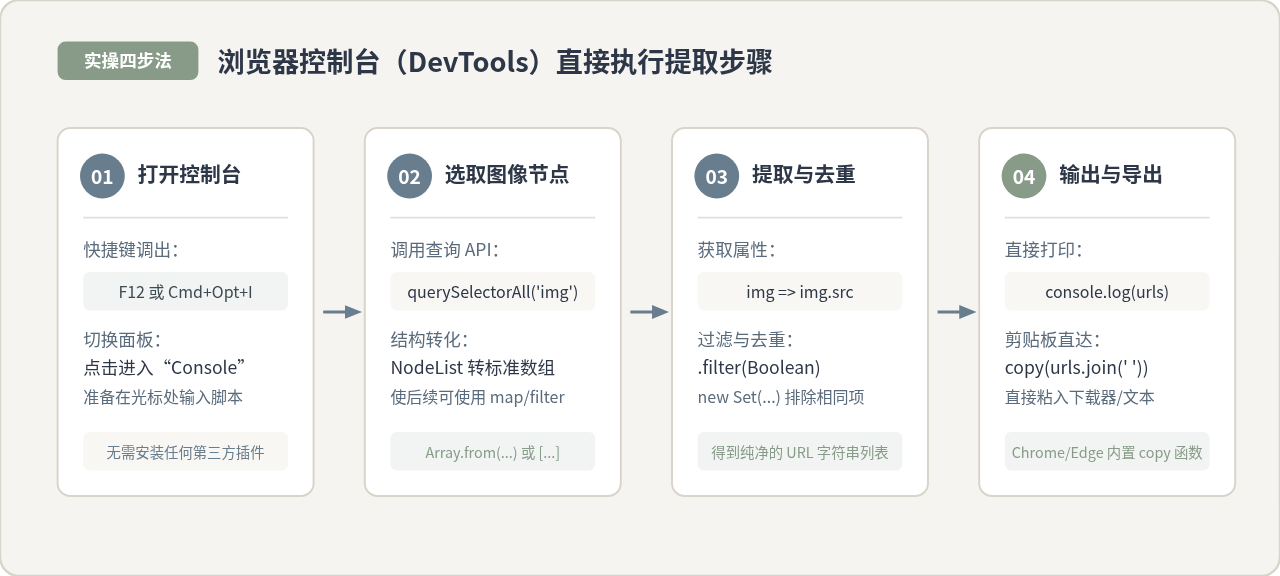
控制台快捷复制技巧:在 Chrome、Edge 或 Firefox 控制台中,执行
copy(images.join('
'))
,可以直接将换行分隔的全部图片链接直接复制到系统剪贴板中,随后可直接粘贴至迅雷、Aria2 或文本编辑器中。
二、关键差异对比:img.src 与 img.getAttribute('src')
在编写提取脚本时,获取图片地址主要有两种写法:直接访问 DOM 对象的 img.src 属性,或者调用 img.getAttribute('src') 方法。尽管两者在大多数绝对路径图片上表现看似一致,但在处理相对路径或缺失属性时,存在本质性的底层差异。
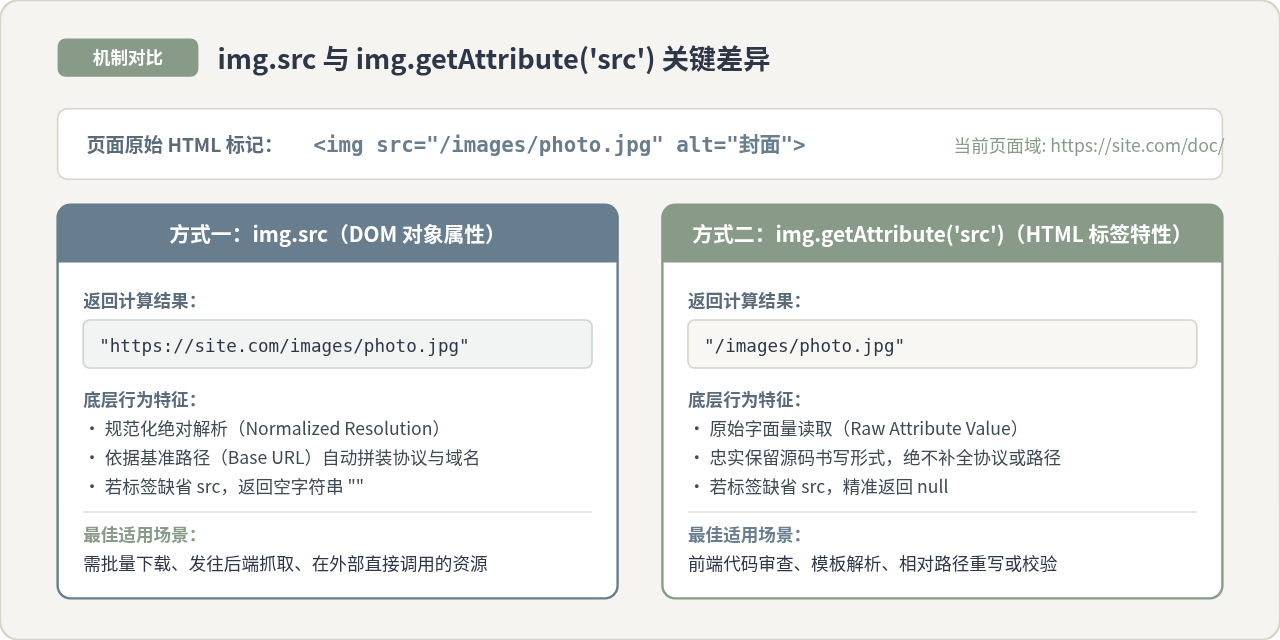
为了准确说明这种差异,假设当前网页的网址为 https://example.com/blog/article.html,页面源码中包含如下三个图片标签:
<!-- 示例 HTML 片段 -->
<img id="pic1" src="/static/images/logo.png">
<img id="pic2" src="../avatar.jpg">
<img id="pic3">
在相同条件下,分别使用两种方式读取这三个元素:
| 测试元素 | 调用方式:img.src | 调用方式:img.getAttribute('src') | 核心差异解释 |
|---|---|---|---|
#pic1 (根相对路径) |
"https://example.com/static/images/logo.png" |
"/static/images/logo.png" |
img.src 依据当前站点主机自动解析并补全了协议和域名;而 getAttribute 仅返回 HTML 源码中的原始字面量。 |
#pic2 (相对路径) |
"https://example.com/avatar.jpg" |
"../avatar.jpg" |
img.src 结合当前路径解析了 .. 层级并规范化;getAttribute 保留原样相对符号。 |
#pic3 (未声明 src) |
"" (空字符串) |
null |
DOM 属性反射规范要求未定义时回退为空字符串;属性获取接口未找到该特性时严格返回 null。 |
这种差异为何至关重要?
差异的根源在于两者所属的标准规范不同:img.src 属于 HTML 规范中对 HTMLImageElement 的 IDL 属性反射,浏览器会自动调用 URL 解析器,将相对路径转化为规范化的绝对 URL;而 getAttribute('src') 属于 DOM Level 1 基础方法,它的唯一职责是返回对应 HTML 标签上所书写的属性纯文本内容。
因此在选择时遵循明确原则:
- 必须使用
img.src的场景:用于下载图片、传给外部程序、发送 HTTP 请求,或者需要脱离当前网页直接访问该资源。因为相对路径离开当前网页的上下文后将无法独立寻址。 - 使用
getAttribute('src')的场景:代码质量分析、模板解析、批量替换相对路径,或者需要严格判断 HTML 源码中是否书写了src属性(根据是否为null进行区分)。
三、进阶应对:现代网页懒加载(Lazy Loading)提取
在主流电商、新闻或图库网站中,许多图片为了节省带宽和提升首屏性能,普遍采用了懒加载机制。未滚动到可视区域内的图片,其 src 往往是一个 1x1 像素的透明 base64 占位图或空占位符,真正的图片 URL 存储在诸如 data-src、data-original、data-lazy 或 srcset 等自定义属性中。
如果直接提取 img.src,读者常会发现提取出来的大量地址是重复的 data:image/gif;base64,... 或透明图片。解决这一问题的关键在于建立“多属性降级探测(Fallback)机制”。
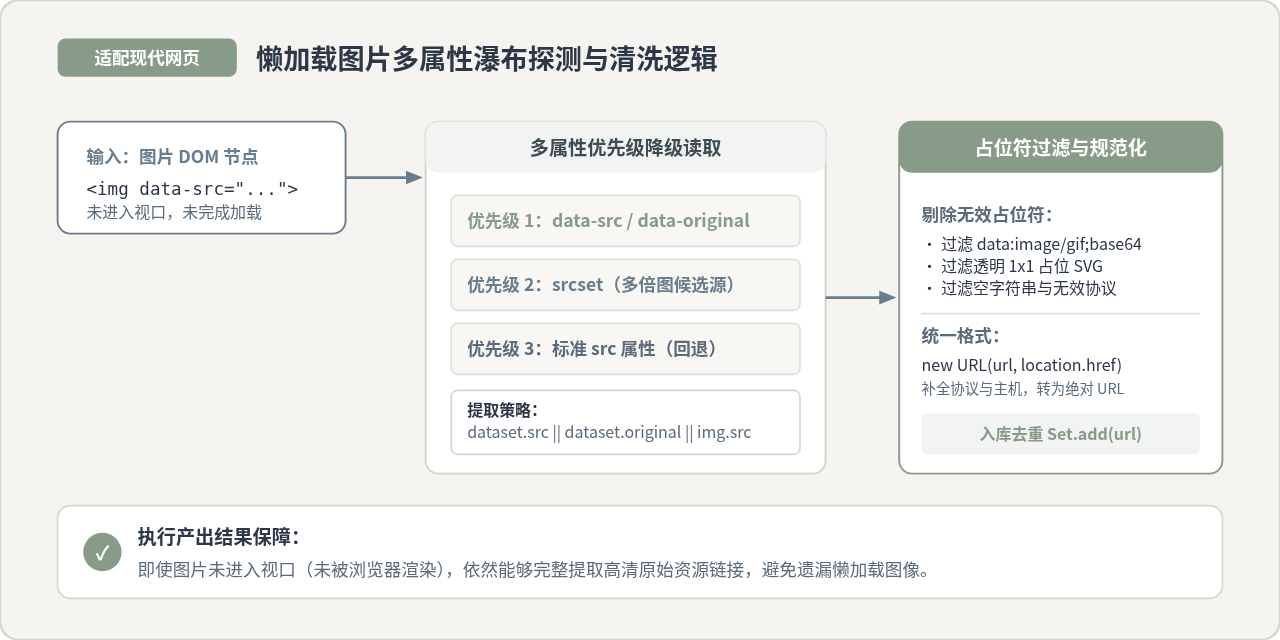
以下是针对懒加载页面的适配提取函数,它会依次检查常见的懒加载属性,若未命中再回退到 src,同时对相对路径进行标准化补全,并剔除无效的 base64 占位图:
function getRealImageUrl(img) {
  // 1. 常见懒加载自定义属性探测列表
  const lazyKeys = ['src', 'original', 'lazy', 'actualsrc', 'url'];
  let candidate = null;

  // 优先在 dataset 中查找常见键名
  for (const key of lazyKeys) {
    if (img.dataset && img.dataset[key]) {
      candidate = img.dataset[key].trim();
      break;
    }
  }

  // 2. 若 dataset 未命中,读取常规 getAttribute
  if (!candidate) {
    candidate = img.getAttribute('data-src') ||
                img.getAttribute('data-original') ||
                img.getAttribute('src');
  }

  // 3. 过滤透明占位图或空值
  if (!candidate || candidate.startsWith('data:image/svg+xml') || candidate.startsWith('data:image/gif')) {
    // 若原 src 确实是有效图片,则降级使用完整 img.src,否则弃用
    candidate = img.src && !img.src.startsWith('data:') ? img.src : null;
  }

  if (!candidate) return null;

  // 4. 将提取出的相对路径统一补全为绝对 URL
  try {
    return new URL(candidate, window.location.href).href;
  } catch (e) {
    return candidate;
  }
}
四、完整工程实现:通用封装与数据导出
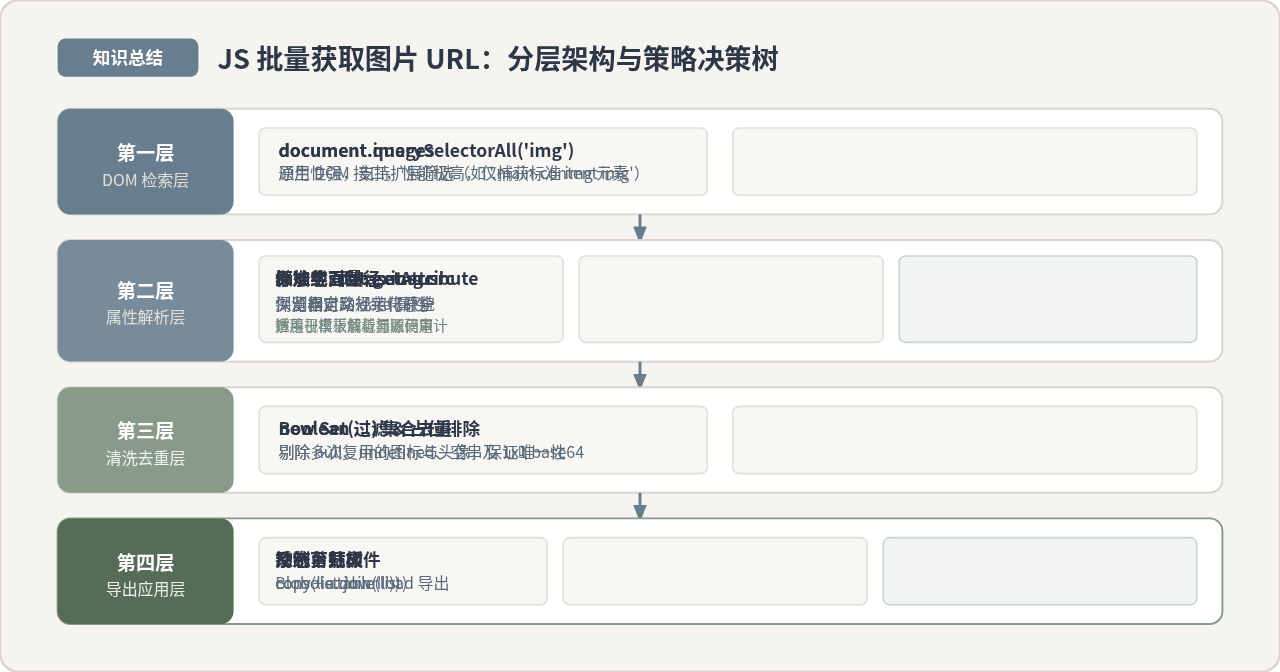
为了满足不同的提取需求,我们可以将上述逻辑整合成一个功能完备的提取工具函数 getAllPageImages。该函数支持传入配置参数,控制是否包含懒加载、是否去重,并内置一键导出为文本文件的功能。
/**
 * 批量提取当前页面所有图片地址
 * @param {Object} options
 * @param {boolean} options.unique - 是否自动去重(默认 true)
 * @param {boolean} options.includeLazy - 是否扫描 data-* 懒加载属性(默认 true)
 * @param {boolean} options.filterBase64 - 是否剔除 base64 占位符(默认 true)
 * @returns {string[]} 图片地址数组
 */
function getAllPageImages(options = {}) {
  const {
    unique = true,
    includeLazy = true,
    filterBase64 = true
  } = options;

  const imgElements = Array.from(document.querySelectorAll('img'));
  const urlList = [];

  imgElements.forEach(img => {
    let targetUrl = '';

    if (includeLazy) {
      // 提取懒加载字段
      const ds = img.dataset || {};
      targetUrl = ds.src || ds.original || ds.lazy || ds.url ||
                  img.getAttribute('data-src') ||
                  img.getAttribute('data-original') ||
                  img.src;
    } else {
      targetUrl = img.src;
    }

    if (!targetUrl) return;
    targetUrl = targetUrl.trim();

    // 剔除 base64 占位图
    if (filterBase64 && targetUrl.startsWith('data:')) {
      return;
    }

    // 标准化为绝对路径
    try {
      targetUrl = new URL(targetUrl, window.location.href).href;
    } catch (err) {
      // 保持原样
    }

    urlList.push(targetUrl);
  });

  // 去重处理
  const result = unique ? Array.from(new Set(urlList)) : urlList;

  console.log(`[完成] 共成功提取到 ${result.length} 张有效图片地址。`);
  return result;
}

/**
 * 辅助工具:将提取到的链接数组导出为本地文本文件
 * @param {string[]} urls
 * @param {string} filename
 */
function downloadUrlsAsFile(urls, filename = 'page_images.txt') {
  const blob = new Blob([urls.join('\n')], { type: 'text/plain;charset=utf-8' });
  const link = document.createElement('a');
  link.href = URL.createObjectURL(blob);
  link.download = filename;
  document.body.appendChild(link);
  link.click();
  document.body.removeChild(link);
  URL.revokeObjectURL(link.href);
}

// 执行提取并直接下载
const allImages = getAllPageImages();
// downloadUrlsAsFile(allImages);
五、注意事项与常见边界排查
在实际网页中应用上述代码时,读者可能会遇到若干特殊边界,需要根据具体情况进行针对性处理:
1. 单页应用(SPA)与无限滚动页面
在使用 Vue、React 等构建的单页应用或含有无限向下滚动(Infinite Scroll)的页面中,未进入视口的 DOM 节点可能根本尚未被挂载到页面上。此时脚本只能提取到当前已渲染的图片。如果需要提取整篇长列表,应先平滑滚动到页面底部,待网络请求加载完毕后,再在控制台执行提取。
2. CSS 背景图片(background-image)的限制
document.querySelectorAll('img') 只能获取 HTML 中的 <img> 标签。如果网页中的部分大图或图标是通过 CSS 属性 background-image: url(...) 呈现的,常规图片选择器无法覆盖。若需同时抓取背景图,可通过遍历所有带有内联样式的元素进行正则匹配提取:
// 补充:提取所有带内联 CSS 背景图的地址
const bgImages = Array.from(document.querySelectorAll('*'))
  .map(el => window.getComputedStyle(el).backgroundImage)
  .filter(bg => bg && bg !== 'none' && bg.startsWith('url('))
  .map(bg => bg.replace(/^url\(['"]?/, '').replace(/['"]?\)$/, ''));

console.log('背景图数量:', bgImages.length);
3. 跨域 iframe 与权限边界
如果图片嵌套在其他域名的 <iframe> 内部,受浏览器同源策略(Same-Origin Policy)限制,父页面的 JavaScript 无法直接穿透访问跨域 iframe 的内部 DOM 结构。如需提取此类图片,需在开发者工具的上下文切换下拉框中,将执行环境切换至该 iframe 的域,然后再运行脚本。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章