

深入对比 JavaScript 本地缓存方案:localStorage、sessionStorage 与 IndexedDB 的存储上限、底层机制、线程影响、事务支持与代码实操,并提供生产环境选型决策指南。
JS本地缓存选型:localStorage、sessionStorage与IndexedDB的区别
作者:沉舟
时间:2026-11-16
浏览:562
文章目录
在现代 Web 应用架构中,合理的客户端数据缓存能够显著降低后端接口负载并提升交互响应速度。面对
localStorage、sessionStorage 与 IndexedDB 这三种最核心的浏览器原生存储方案,最清晰直接的选型原则是:若需要跨页面持久保存轻量键值(如用户登录凭据、主题配置),选用 localStorage;若数据仅供当前单标签页会话临时流转(如多步骤表单草稿、独立筛选状态),选用 sessionStorage;而当数据规模超过 5MB、需要存储结构化对象/二进制 Blob,或对主线程执行性能有苛刻要求时,必须选用支持异步与事务特性的 IndexedDB。
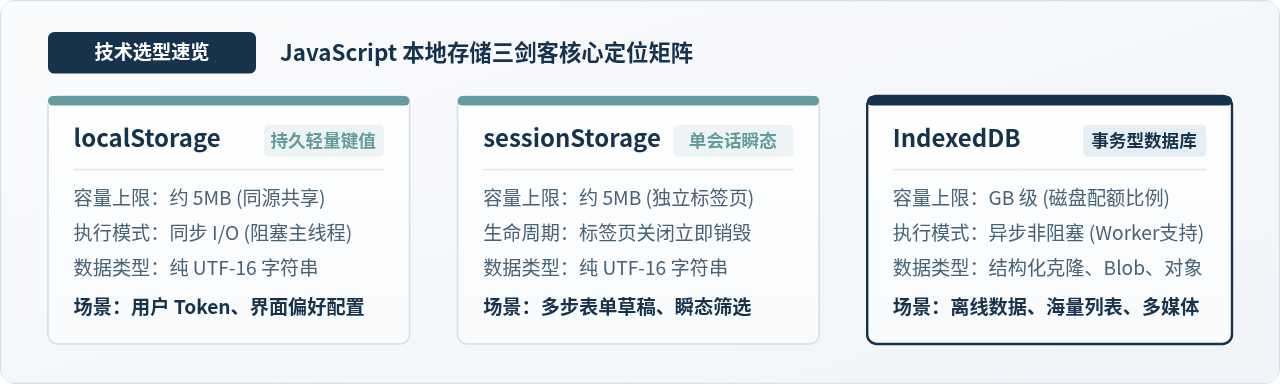
一、核心参数与底层存储机制的本质差异
许多前端开发者在做存储选型时,往往只关注“容量有多大”或“能不能持久保存”,却忽视了底层 I/O 模型对网页渲染性能的决定性影响。localStorage 与 sessionStorage 属于 Web Storage 规范,而 IndexedDB 则是一套完整的事务型 NoSQL 数据库系统,二者在底层设计上存在根本性的代际差异。
| 对比维度 | localStorage | sessionStorage | IndexedDB |
|---|---|---|---|
| 数据模型 | 纯键值对 (Key-Value) | 纯键值对 (Key-Value) | 对象仓库 (Object Store),键值/索引文档 |
| 存储格式 | 仅限 UTF-16 纯文本字符串 | 仅限 UTF-16 纯文本字符串 | 结构化克隆算法(对象、数组、Blob、File、TypedArray) |
| I/O 模式 | 同步阻塞 (Sync I/O) | 同步阻塞 (Sync I/O) | 异步非阻塞 (Async I/O / Promise / Worker) |
| 典型容量上限 | 约 5MB (按同源域计) | 约 5MB (按同源单标签页计) | 磁盘可用空间的 20%~80% (几十MB至数百GB) |
| 生命周期 | 持久存在,除非主动清理 | 标签页或窗口关闭后立即销毁 | 持久存在,受浏览器配额管理机制控制 |
| 作用域与隔离 | 同源共享(同协议、同域名、同端口) | 同源且限定单标签页(顶级窗口隔离) | 同源共享(跨标签页、跨 Web Worker 共享) |
| 事务支持 | 无事务机制(无法回滚) | 无事务机制(无法回滚) | 完整 ACID 事务保证,异常自动安全回滚 |
这其中最核心的性能分水岭在于“同步 I/O”与“异步 I/O”。在单线程的 JavaScript 运行环境中,只要调用 localStorage.getItem() 或 setItem(),主线程就会被迫暂停,同步等待底层操作系统完成磁盘或内存映射读取。一旦缓存的 JSON 字符串较大(例如达到 2MB~5MB),频繁的读写与 JSON.parse 序列化将直接导致掉帧,甚至造成页面的明显卡顿。
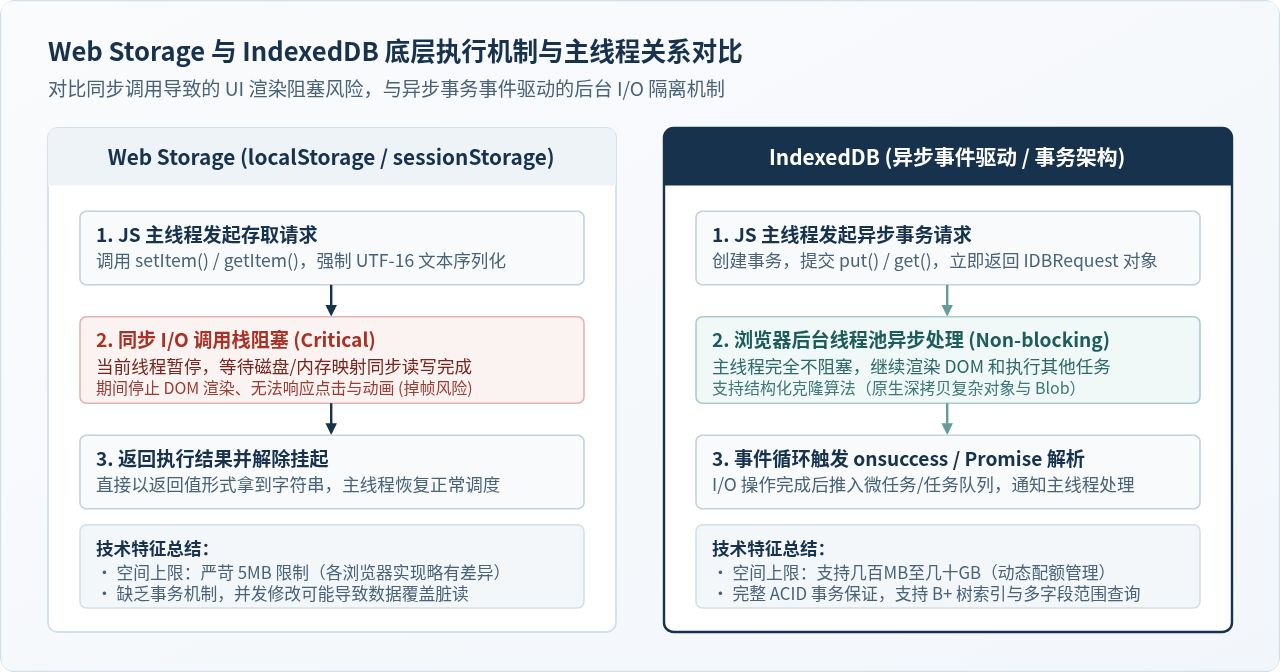
二、Web Storage 实战:localStorage 与 sessionStorage 的使用边界
Web Storage 最大的优势在于 API 极其简单,没有复杂的初始化与连接流程。但其看似简易的表面下,隐藏着几个容易引发生产故障的关键边界。
1. 作用域与标签页隔离规则
localStorage 严格遵循浏览器的同源策略(Same-Origin Policy)。同一个源下的所有窗口、Iframe、标签页均共享同一份 localStorage 数据。一个窗口修改了数据,其他同源窗口可以通过监听 window.addEventListener('storage', callback) 实时捕获改动。
而 sessionStorage 的隔离更为严格:即使两个标签页打开的是完全相同的 URL,它们的 sessionStorage 也是互相独立的。唯一的继承例外是:通过 window.open() 或 <a target="_blank"> 打开的新标签页会复制一份父页面的 sessionStorage 快照,但复制完成后的两份数据完全解耦,后续的任何读写互不影响。
2. 数据类型强转与序列化陷阱
Web Storage 的所有 key 和 value 都会被无条件强制转换为字符串。如果直接将 JavaScript 对象或数字传入,会发生隐式类型转换:
// 错误示例:隐式类型转换陷阱
localStorage.setItem('user_info', { name: 'Alice', age: 25 });
console.log(localStorage.getItem('user_info')); // 输出 "[object Object]",原始数据彻底丢失

localStorage.setItem('is_active', false);
console.log(Boolean(localStorage.getItem('is_active'))); // 输出 true!因为 "false" 是非空字符串
因此,对于复合对象必须配合 JSON.stringify() 与 JSON.parse() 使用,并且要在业务代码中封装严密的防崩溃解析逻辑。
3. 防御 QuotaExceededError 与存储过期封装
当 localStorage 写入量超过浏览器配额限制(通常为 5MB)或者在移动端低存储空间环境下,会抛出非捕获异常 QuotaExceededError。如果未做 try...catch 保护,将直接阻断后续代码执行。此外,Web Storage 原生并不支持过期失效时间(TTL)。
在生产环境中,推荐使用统一的工具类进行防抖与防御封装:
// 生产级 localStorage 封装:支持 TTL 过期淘汰与异常捕获
class SafeLocalStorage {
  /**
   * 写入缓存并设定有效期
   * @param {string} key 键名
   * @param {any} value 任意可序列化对象
   * @param {number} ttlMs 有效期毫秒数,默认 0 表示永久
   */
  static set(key, value, ttlMs = 0) {
    const payload = {
      data: value,
      expireAt: ttlMs > 0 ? Date.now() + ttlMs : null
    };
    try {
      localStorage.setItem(key, JSON.stringify(payload));
      return true;
    } catch (err) {
      // 捕获 QuotaExceededError 或隐私模式禁用异常
      console.warn(`[SafeLocalStorage] 写入失败 (Key: ${key}):`, err.message);
      return false;
    }
  }

  /**
   * 读取缓存,自动校验是否过期
   * @param {string} key 键名
   * @returns {any|null} 原始值或 null
   */
  static get(key) {
    try {
      const raw = localStorage.getItem(key);
      if (!raw) return null;
      const parsed = JSON.parse(raw);
      if (parsed.expireAt && Date.now() > parsed.expireAt) {
        // 已过期,主动触发清理
        localStorage.removeItem(key);
        return null;
      }
      return parsed.data;
    } catch (err) {
      console.warn(`[SafeLocalStorage] 读取解析异常 (Key: ${key}):`, err.message);
      return null;
    }
  }

  static remove(key) {
    try {
      localStorage.removeItem(key);
    } catch (err) {
      console.warn(`[SafeLocalStorage] 删除异常:`, err.message);
    }
  }
}

// 执行示例
SafeLocalStorage.set('auth_token', 'Bearer eyJhbGciOi...', 2 * 60 * 60 * 1000); // 2小时有效期
const token = SafeLocalStorage.get('auth_token');
三、IndexedDB 核心架构与实操规范
当应用需要离线处理成千上万条记录、存储用户上传的原生图片/音视频 Blob,或者需要根据多字段进行高速索引过滤时,Web Storage 无法胜任,必须接入 IndexedDB。
IndexedDB 采用的是对象仓库(Object Store)架构,而不是关系型数据库中的表(Table)。它原生支持结构化克隆算法,无需做 JSON.stringify,可以直接存储复杂树形对象、ArrayBuffer、Blob 等二进制原生结构。
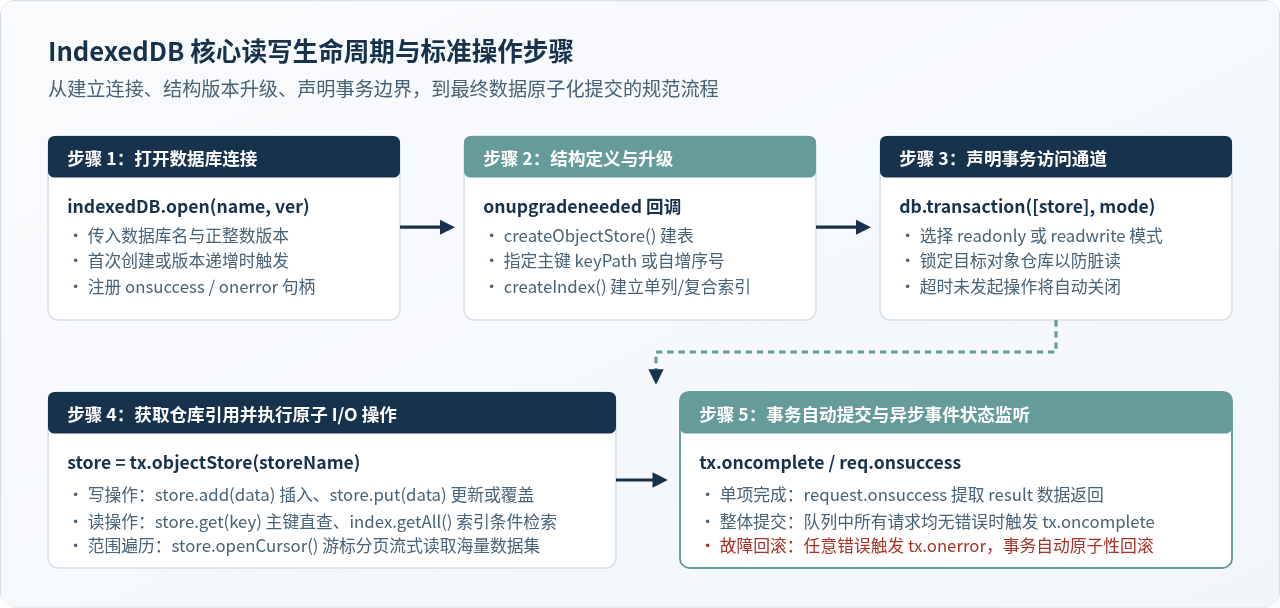
IndexedDB 完整端到端操作示例
为了直观掌握 IndexedDB 的运行逻辑,下面提供一个包含“创建数据库、定义索引、批量插入、条件索引查询”的完整原生 JavaScript 封装示例:
// IndexedDB 原生标准操作封装示例
class DocumentStore {
  constructor(dbName = 'AppOfflineDB', version = 1) {
    this.dbName = dbName;
    this.version = version;
    this.db = null;
  }

  // 步骤 1 & 2:打开连接并在升级事件中建立结构与索引
  init() {
    return new Promise((resolve, reject) => {
      const request = window.indexedDB.open(this.dbName, this.version);

      request.onupgradeneeded = (event) => {
        const db = event.target.result;
        // 如果对象仓库不存在,则新建
        if (!db.objectStoreNames.contains('documents')) {
          // 以 id 作为主键路径,keyPath 支持自增或显式字段
          const store = db.createObjectStore('documents', { keyPath: 'id' });
          // 建立索引:支持按分类 category 与更新时间 updatedAt 检索
          store.createIndex('idx_category', 'category', { unique: false });
          store.createIndex('idx_updatedAt', 'updatedAt', { unique: false });
        }
      };

      request.onsuccess = (event) => {
        this.db = event.target.result;
        resolve(this.db);
      };

      request.onerror = (event) => {
        reject(event.target.error);
      };
    });
  }

  // 步骤 3 & 4 & 5:在事务中执行原子读写
  saveDocument(doc) {
    return new Promise((resolve, reject) => {
      // 开启读写事务
      const tx = this.db.transaction(['documents'], 'readwrite');
      const store = tx.objectStore('documents');

      // 执行写入(原生保存复杂对象与二进制属性)
      const req = store.put(doc);

      req.onsuccess = () => resolve(req.result);
      req.onerror = () => reject(req.error);

      // 监听事务整体完成与异常回滚
      tx.onabort = () => reject(new Error('IndexedDB 事务异常中止并已回滚'));
    });
  }

  // 通过索引进行高性能范围检索
  getByCategory(category) {
    return new Promise((resolve, reject) => {
      const tx = this.db.transaction(['documents'], 'readonly');
      const store = tx.objectStore('documents');
      const index = store.index('idx_category');

      // 使用索引查询该分类下的全部匹配记录
      const req = index.getAll(category);
      req.onsuccess = () => resolve(req.result);
      req.onerror = () => reject(req.error);
    });
  }
}

// 执行验证
(async () => {
  const docDB = new DocumentStore();
  await docDB.init();

  // 插入包含富文本与更新时间的离线文档
  await docDB.saveDocument({
    id: 'doc_1001',
    title: '系统架构演进规划',
    category: 'tech_spec',
    content: '大型分布式系统的客户端缓存层设计...',
    updatedAt: Date.now()
  });

  // 高效按索引检索
  const results = await docDB.getByCategory('tech_spec');
  console.log('索引检索命中数量:', results.length);
})();
四、选型决策路径:面对具体场景如何取舍
在面对实际开发需求时,开发者可以根据“数据体积”、“生命周期要求”以及“检索与并发特征”三项核心判据,快速定位最优解。
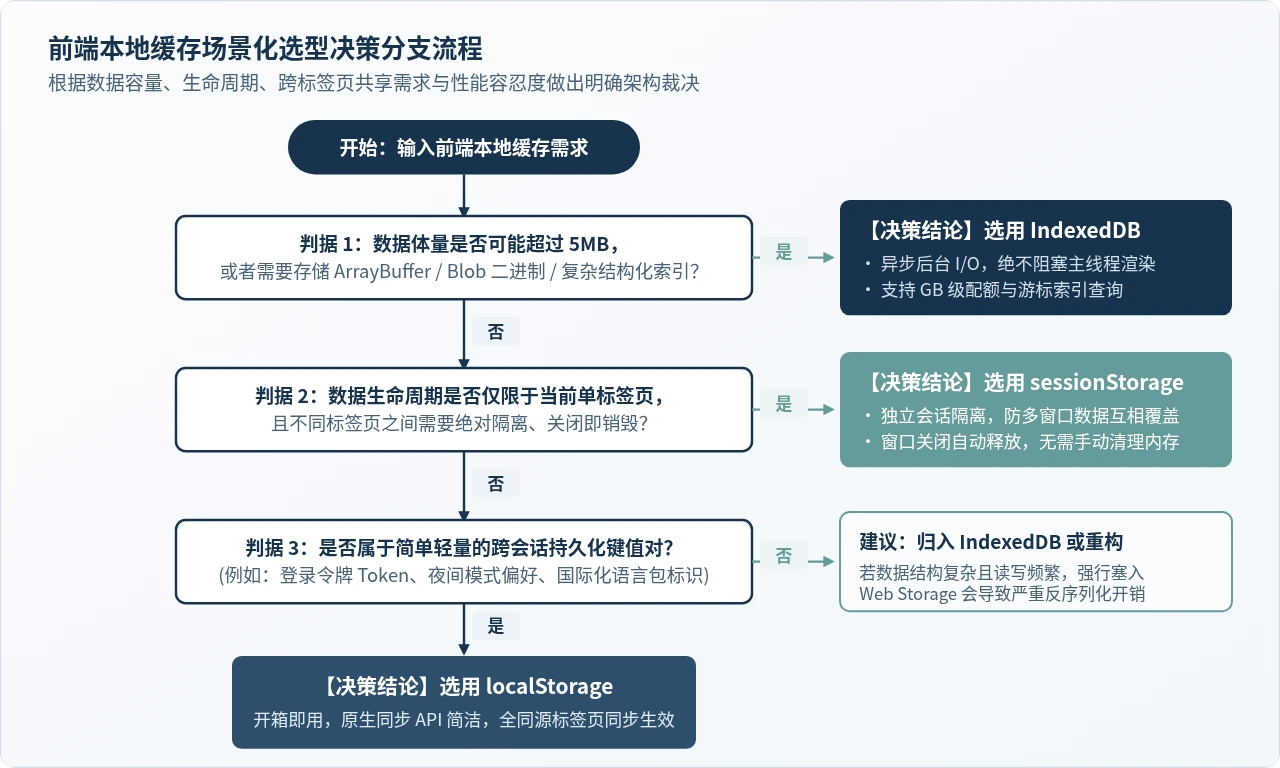
真实业务场景与方案映射
-
场景一:用户认证凭证(Access Token / Refresh Token)
首选推荐:HttpOnly Cookie(最高安全级别);前端存储首选localStorage。
解释:Token 需要跨越用户在同源下打开的多个标签页保持登录态,若存入sessionStorage,用户新开标签页即提示未登录,体验极差。需要注意防范 XSS 攻击对localStorage的窃取。 -
场景二:多步骤注册/长表单填写的草稿自动保存
首选推荐:sessionStorage。
解释:用户在同一个标签页内填写步骤一、步骤二,若意外刷新页面,从sessionStorage恢复数据即可保证输入不丢失;同时,如果用户在新标签页打开同一个表单并发填写另一份内容,独立的sessionStorage能天然避免多窗口草稿互相覆盖错乱。 -
场景三:富文本/Markdown 编辑器的本地离线灾备
首选推荐:IndexedDB。
解释:长篇文档内容体积不可预估,通常还伴随着每隔数秒的自动快照。若使用localStorage,高频写入几十KB甚至上百KB的字符串会不断触发主线程阻塞,导致打字卡顿;而 IndexedDB 的异步写入与几十MB以上容量保障完全免除了后顾之忧。 -
场景四:离线 PWA 应用与接口大批量数据缓存(如通讯录、商品字典)
首选推荐:IndexedDB。
解释:数据量通常在数万条以上,且需要按照拼音首字母、部门分类等维度模糊匹配与排序。IndexedDB 提供了原生 B+ 树索引和游标(Cursor),能在毫秒级完成过滤,而无需一次性把全部数据拉到内存中执行filter()。
五、生产环境避坑与技术边界总结
⚠️ 生产环境重要警示:
- 隐身模式(Private Browsing)限制:在部分移动端浏览器(如旧版 Safari 隐身模式)下,
localStorage.setItem会直接抛出异常;现代浏览器在隐身模式下虽允许写入,但关闭隐身窗口时所有localStorage、sessionStorage与IndexedDB均会被彻底物理擦除。 - 多版本升级阻塞(VersionChange Blocked):IndexedDB 在执行版本递增升级时,若其他同源标签页仍保持旧版连接未关闭,升级请求会被永久挂起。生产代码必须在连接实例上监听
db.onversionchange = () => db.close(),主动释放旧连接。 - 存储配额查询与主动清理:当使用 IndexedDB 缓存大文件时,应使用现代浏览器提供的
navigator.storage.estimate()API 实时监测配额使用百分比,并配合 LRU(最近最少使用)算法实现主动丢弃。
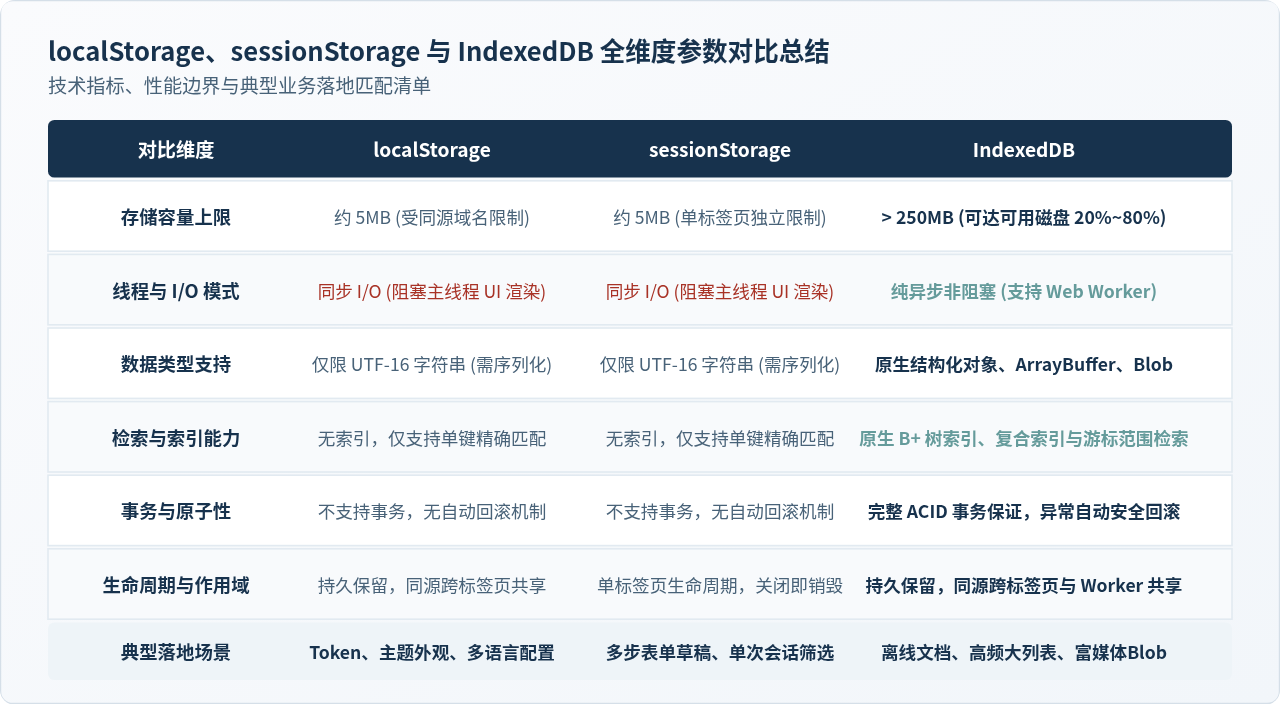
六、总结与选型自查清单
综上所述,前端本地存储没有绝对的优劣之分,关键在于能否与具体的业务数据特征相匹配:
- 如果是简单文本、体积很小(< 50KB)、需要同源全窗口持久共享,使用
localStorage最直接高效。 - 如果是单标签页内的瞬态操作流、避免多标签页冲突、关闭即焚,使用
sessionStorage最安全省心。 - 只要涉及数据体量较大(> 5MB)、复杂对象结构、索引检索、大文件二进制存储或高频异步写入,果断拥抱
IndexedDB。
在实际工程架构中,推荐对存储访问层进行统一抽象与门面封装(Facade Pattern),使上层业务逻辑与具体底层引擎解耦,从而在应对未来架构调整或多端适配时具备充分的弹性。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章