
深入解析JavaScript中replace方法结合回调函数的高级实战用法,详解参数传递机制、捕获组解构、动态模板替换、命名格式转换及单位计算等真实场景与避坑指南。

当前位置:首页 > JavaScript 基础 > 正文
JS replace回调函数实战:根据匹配内容动态生成替换文本
作者:闭包旅人
时间:2026-11-16
浏览:610
文章目录
在 JavaScript 中,
String.prototype.replace() 不仅仅能做固定字符串替换。当替换内容需要根据匹配到的具体文本、捕获分组甚至外部数据动态计算时,传入一个replacer 回调函数是最直接、高效的手段。本文将详细剖析其运行机制、参数传递体系,并通过四个典型场景带你掌握动态替换的精髓。
一、为什么需要 replacer 回调函数?
在日常开发中,我们最常用的是静态替换形式:str.replace("a", "b") 或利用正则捕获组重排:str.replace(/(\w+)-(\w+)/, "$2-$1")。然而,静态替换存在天然局限:它只能“机械搬运”已有的文本,无法执行任何运行时逻辑。
设想以下几种典型需求:
- 将匹配到的小写英文字母转为对应的大写字母(如将
hello-world转为helloWorld)。 - 匹配模板中的
{{userId}},并从一个全局字典或响应对象中提取对应的实际姓名。 - 将匹配到的像素数值
16px动态除以 16 并追加单位rem。 - 对匹配到的手机号码进行动态脱敏掩码,保留前三后四,中间根据长度补全星号。
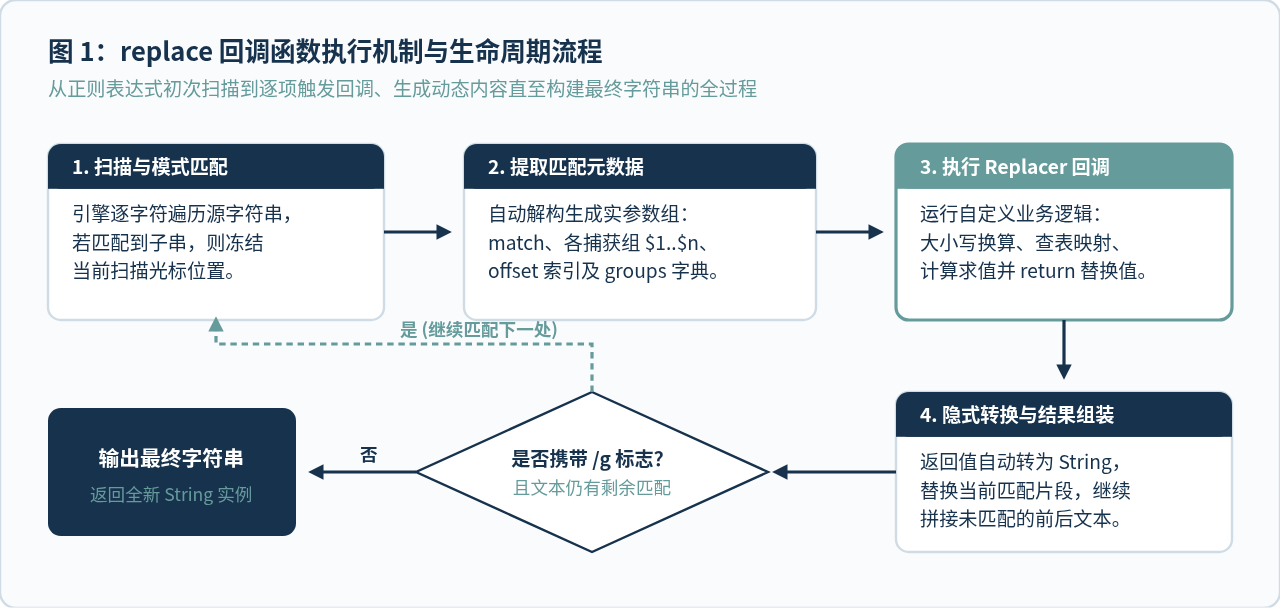
这些需求必须在替换时进行算法运算、条件判断或大小写换算。replace 方法允许将第二个参数设置为一个回调函数。每当正则表达式在源文本中匹配成功一次,该回调函数就会被自动执行,而函数的返回值将作为替换后的文本被精确嵌入到原位置。
二、深入拆解回调函数的参数体系
想要随心所欲地控制动态替换,关键在于摸透 JavaScript 引擎向回调函数注入的形参序列。许多初学者容易困惑:为什么有时回调函数的第二个参数是 offset,有时却是 $1?
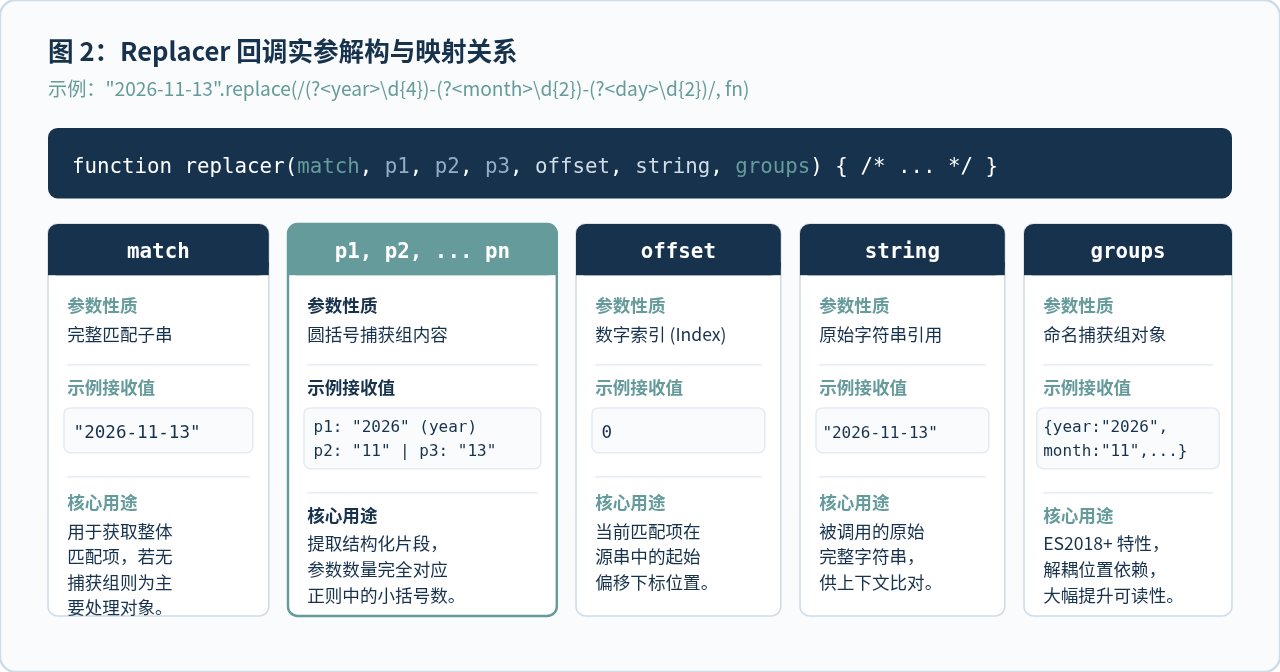
其根本原因在于:回调函数接收的参数数量是动态的,完全取决于传入的正则表达式中包含了几个捕获括号(Capturing Group)。完整的形参签名如下:
str.replace(regexp, function(match, p1, p2, /* ..., */ pn, offset, string, groups) {
  // 必须返回一个值作为替换结果
  return replacement;
});
各项参数的具体含义与定位规则如下:
match:本次正则匹配到的完整子串。p1, p2, ... pn:与正则表达式中从左往右各个圆括号(...)一一对应的捕获组内容。如果正则表达式中没有捕获组,则不会出现这些参数。offset:当前匹配子串在源字符串string中的起始索引下标(数字类型,从 0 开始)。string:调用replace的原始完整字符串。groups(ES2018+):如果正则表达式中使用了命名捕获组(如(?<name>...)),则该参数为一个对象,键为组名,值为匹配子串;若未定义任何命名捕获组,此参数通常为undefined。
参数定义技巧:利用剩余参数或解构简化书写
如果你只关心其中的某一个捕获组或最后的 groups 对象,且捕获组数量较多时,可以在 ES6+ 中借助展开运算符或直接提取最后一个参数:
// 仅使用 match 与解构命名捕获组
const text = "2026-11-13";
const reg = /(?<year>\d{4})-(?<month>\d{2})-(?<day>\d{2})/;

const formatted = text.replace(reg, (...args) => {
  const groups = args[args.length - 1]; // 始终获取最后的 groups 命名组对象
  return `${groups.year}年${groups.month}月${groups.day}日`;
});
console.log(formatted); // "2026年11月13日"
三、高频实战场景与核心代码实现
场景 1:驼峰命名与短横线命名(kebab-case)双向转换
前端处理样式属性(如 CSS 变量与 JS 属性)时,经常需要将 background-color 转换为 backgroundColor,或反向转换。通过回调函数中的 toUpperCase() 或 toLowerCase() 即可几行代码搞定。
// 1. 短横线转小驼峰 (kebab-case -> camelCase)
function kebabToCamel(str) {
  // 匹配破折号及其后面的第一个字符
  return str.replace(/-([a-z])/g, (match, letter) => {
    return letter.toUpperCase();
  });
}

console.log(kebabToCamel("border-top-left-radius")); // "borderTopLeftRadius"

// 2. 小驼峰转短横线 (camelCase -> kebab-case)
function camelToKebab(str) {
  // 匹配所有大写字母
  return str.replace(/([A-Z])/g, (match, letter) => {
    return "-" + letter.toLowerCase();
  });
}

console.log(camelToKebab("fontSizeAndLineHeight")); // "font-size-and-line-height"
场景 2:轻量级微型模板渲染引擎
在很多无须引入大型模板库的轻量级场景下,我们只需要将字符串中的占位符(如 {{username}})动态映射为业务数据对象的值。结合 replace 回调函数可以在 10 行代码内实现安全渲染。
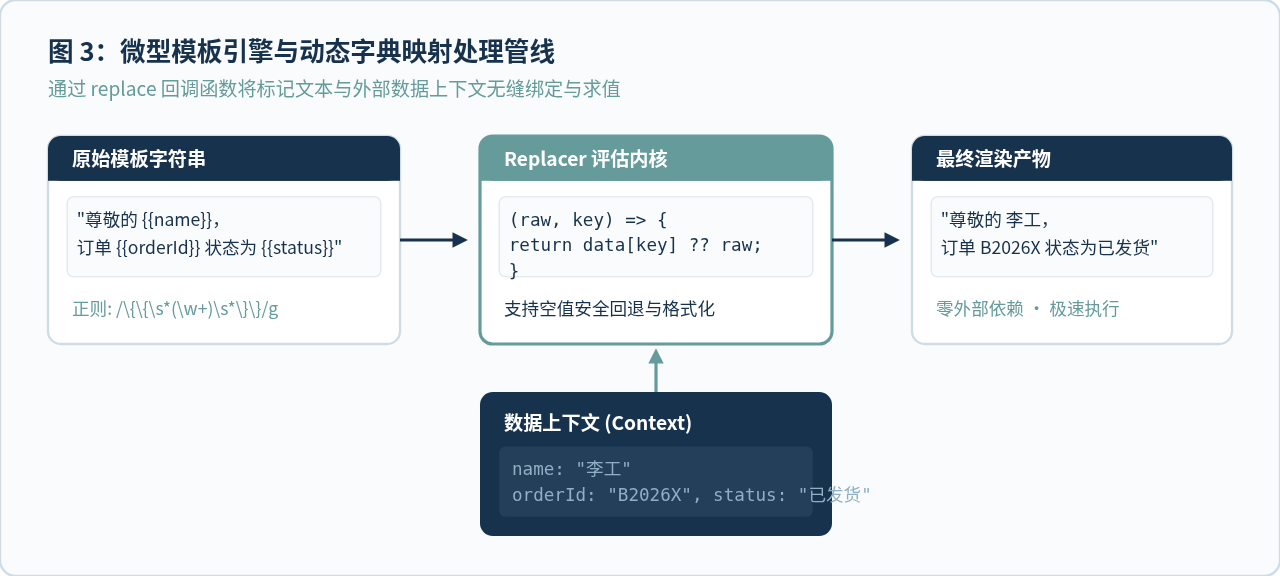
function renderTemplate(template, data) {
  // 匹配 {{ key }},捕获中间的键名并自动忽略周围的空白字符
  return template.replace(/\{\{\s*([a-zA-Z0-9_$]+)\s*\}\}/g, (match, key) => {
    // 关键点:若数据中存在对应属性则返回,不存在则保留原始占位符或返回空字符串
    return key in data ? String(data[key]) : match;
  });
}

const template = "您好,{{ userName }}!您的订单 {{ orderId }} 正在配送中,运费为 {{ shippingFee }} 元。";
const data = {
  userName: "张工程师",
  orderId: "ORD-20261113-902",
  shippingFee: 0
};

console.log(renderTemplate(template, data));
// 输出: "您好,张工程师!您的订单 ORD-20261113-902 正在配送中,运费为 0 元。"
场景 3:敏感字段动态脱敏(支持多规则按需处理)
当页面或日志需要隐藏身份证号、手机号等敏感信息时,往往需要根据匹配到的内容长度动态生成相应数量的掩码星号 *。
function maskPhoneNumbers(content) {
  // 匹配国内常见的 11 位手机号:前三位 + 中间四位 + 后四位
  const phoneReg = /(1[3-9]\d)(\d{4})(\d{4})/g;

  return content.replace(phoneReg, (match, prefix, middle, suffix) => {
    // 动态生成中段掩码
    const mask = "*".repeat(middle.length);
    return `${prefix}${mask}${suffix}`;
  });
}

const logText = "用户A联系方式为 13812345678,备用号码 15998765432。";
console.log(maskPhoneNumbers(logText));
// 输出: "用户A联系方式为 138****5678,备用号码 159****5432。"
场景 4:文本内数值计算与单位动态换算
在自动化构建工具或 CSS 预处理脚本中,常需要解析样式代码中的尺寸值。例如将固定像素(px)按根字号比例自动换算为响应式单位(rem):
function pxToRem(cssContent, baseFontSize = 16) {
  // 匹配所有浮点数或整数后紧跟 px 的写法
  const pxReg = /(\d+(?:\.\d+)?)px/g;

  return cssContent.replace(pxReg, (match, numStr) => {
    const num = parseFloat(numStr);
    // 保留合理小数位并除以基础字号
    const remValue = (num / baseFontSize).toFixed(4);
    // 去除末尾无意义的 0
    return `${parseFloat(remValue)}rem`;
  });
}

const sampleCss = "margin: 24px 16px; font-size: 14px; line-height: 28px;";
console.log(pxToRem(sampleCss, 16));
// 输出: "margin: 1.5rem 1rem; font-size: 0.875rem; line-height: 1.75rem;"
四、静态替换 vs 回调替换:技术选型与差异
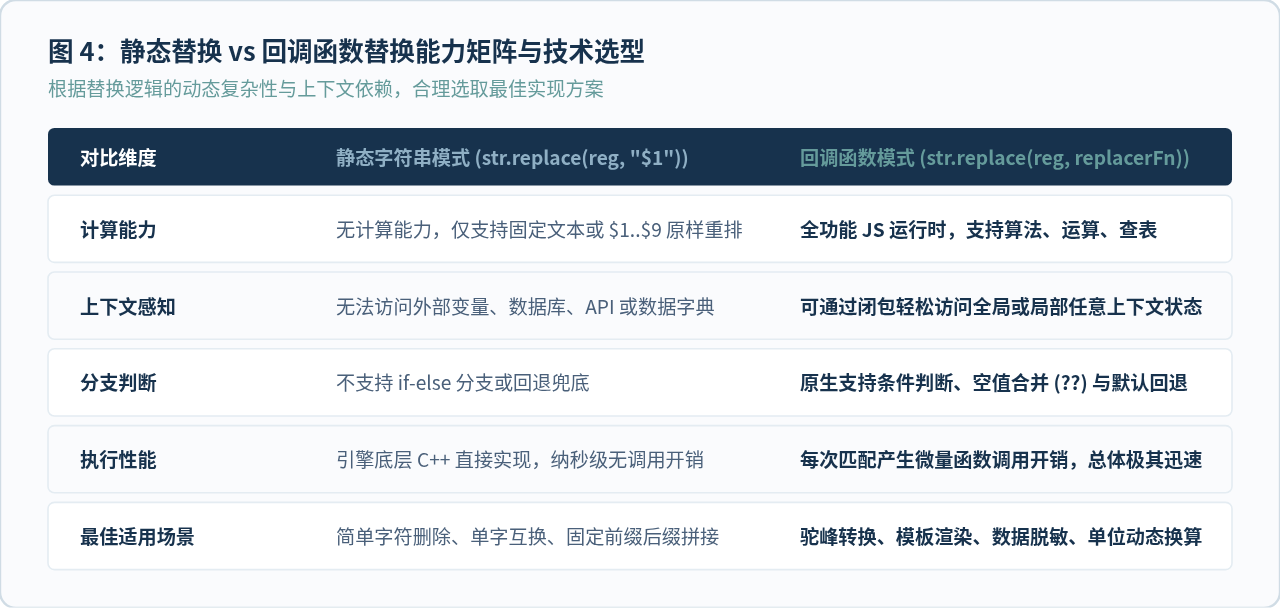
尽管回调函数极为强大,但并不意味着所有替换都应优先使用回调函数。对于单纯的字符替换或位置翻转,静态字符串模式由引擎底层直接处理,性能更高且语义精简。理解二者的能力边界,有助于在架构设计中做出恰当的技术选型。
五、实战避坑与关键注意事项
⚠️ 注意事项一:务必检查正则表达式的全局标志 /g
这是开发者最常犯的错误。在 str.replace(reg, replacer) 中,如果正则表达式未附带全局修饰符 g,即便文本中有 10 处匹配,回调函数也仅会触发一次,其余匹配项将原封不动保留。如果你希望全量替换,请确保写成 /pattern/g,或在现代浏览器中使用 str.replaceAll()(注意:replaceAll 若使用正则必须携带 g 标志,否则会抛出 TypeError 异常)。
⚠️ 注意事项二:警惕隐式类型转换(特别是返回数字或 undefined)
回调函数的返回值会被 JavaScript 引擎强制调用 String() 转为字符串。需要格外注意以下两点:
- 若忘记写
return语句,函数默认返回undefined,此时匹配位置会被直接替换成英文字符串"undefined",而非保留原样! - 若需要对匹配内容不做修改,应显式
return match;。 - 若返回数字
0,会被正确转为"0",但需防止利用||逻辑或导致假值误判。推荐使用空值合并运算符??。
性能优化:避免在循环中重复编译正则与创建函数
如果需要在处理大批量文本(如遍历几万条表格行)时调用 replace,应将正则表达式提取到外层作用域预编译,并将 replacer 函数声明为纯函数,避免在每次循环中产生不必要的闭包分配与垃圾回收压力:
// 推荐做法:正则与处理函数单例化
const TOKEN_REG = /\[([A-Z_]+)\]/g;
const DICT = { USER: "张三", ROLE: "管理员" };

function tokenReplacer(match, key) {
  return DICT[key] ?? match;
}

function processList(items) {
  return items.map(item => item.content.replace(TOKEN_REG, tokenReplacer));
}
六、总结
replace 的回调函数模式为 JavaScript 字符串处理赋予了完整的运行时编程能力。理解了“实参数量随捕获组动态伸缩”这一核心机制后,无论是开发轻量模板解析、动态单位换算、大小写转化还是复杂文本脱敏,都能以极具可读性和维护性的方式高效达成目标。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章